ARTICLE · 1387793
Agent 读 PDF 其实需要 skill
把论文、标准、合同、扫描件和带表格的截图放进项目文件夹,让 Agent 当资料库用,是很多人现在的做法。
然后你会发现它读不动。双栏论文读出来左一句右一句,扫描件读完是空的,表格里的数字对不上行列。
多数人的第一反应是换个更强的模型。试过就知道没用。Agent 读 PDF 靠的不是模型本身,而是它手里有没有对应的技能。
这里说的 skill,就是 Agent 能调用的一类能力包。Claude Code 里叫 skill,别的客户端可能管它叫工具或插件,指的是同一件事。
这句话值得单独说一遍:Agent 不会自己读 PDF。
先说结论:
Agent 读 PDF 需要技能。模型本身不负责解析版式。 技能有很多,大部分人不知道有哪些,也不知道该装哪个。 装错了不会报错。OCR 认不准,正文、表格和数据就悄悄漏掉。 docarbiter 给这些技能加了一根指挥棒。先探测,再选工具,不行就换。
下面讲三件事:为什么需要技能,为什么装了还是读不对,指挥棒补在哪一层。
Agent 不会自己读 PDF
模型看到的是文本,PDF 里存的是坐标和字体。
中间要有人把版式还原成文字。这件事模型自己做不了,得靠工具。
坏法有四种,彼此独立:
没有文字层。扫描件就是一张图,抽出来是空的。 字体没有对照表。有些 PDF 的字体不带字符映射,抽出来是一堆符号。 阅读顺序要重建。双栏的左右栏在同一高度,按 y 轴取字就会左一句右一句。 表格结构要还原。合并表头、多行单元格,网格不清楚,拆出来就是错位。
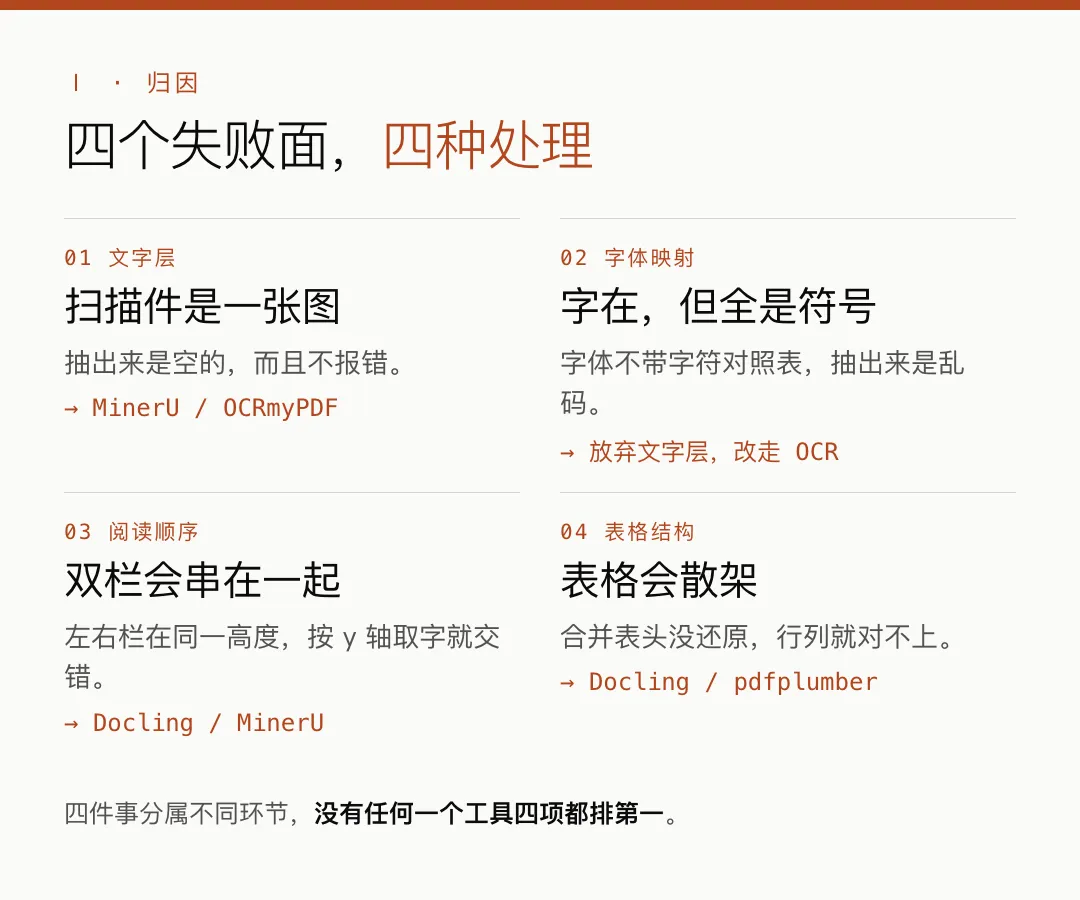
这四件事在技术上分属不同环节:OCR、字体解码、版面分析、表格结构识别。所以不存在一个工具四项都排第一的情况。
装错了不会报错,只会漏
最麻烦的失败是安静的。
扫描件跑错了工具,得到的是空文件,程序不报错。双栏读串了,句子仍然通顺,只是顺序不对。表格拆歪了,数字还在,行列关系没了。
OCR 出错时,最先坏的是数字和符号。而这两样恰好是结论所在。
更隐蔽的是隐藏文字层。有些扫描件自带一层厂商做的 OCR 文字,字体名类似 HiddenHorzOCR。普通工具读得到,输出看起来干净,其实是错的。我在一份 168 页的论文里见过,二萜酚被读成二秸酚,原产于被读成原产千。
还有自定义编码。有份标准的标题 BJS 202102 被读成犅犑犛202102,每个字都是合法汉字,错误率看起来接近零,但内容已经不是原来的意思了。
写综述的时候引用错一个数,或者漏掉半页,代价比装错工具大得多。这类错误不会当场暴露,往往要等到回头核对原文才发现。
所以选工具这件事,不能靠试。
工具很多,但没人指挥
GitHub 上能读 PDF 的开源项目,随便一个都有几万星。
问题不在数量,在三个地方。
你不知道有哪些。搜索出来一堆名字,看不出区别。
你不知道该装哪个。每个项目的 README 都说自己效果好,而它们擅长的部分其实是错开的。
你装了三四个之后,它们开始在 harness 里打架。三个技能都说自己能读 PDF,Agent 按 description 挑,今天挑 A,明天挑 B,同一份文件两次结果不同。读坏了各自重试,没有统一的降级。装到第三个,依赖还会冲突:OCRmyPDF 17.14 要 Pillow 13 以上,MinerU 的 gradio 要 Pillow 13 以下,两个装不进同一个环境。
这是分工问题,不是能力问题。
给这些技能一根指挥棒
它站在文件和工具中间,只做判断。
docarbiter 做三件事:
探测。看这份文件有没有可用的文字层、是什么语言、哪些页是扫描页。 路由。按文件类型、语言和你要的产出,选一个主工具。 降级。结果不行就换下一个,并说明这次为什么换。
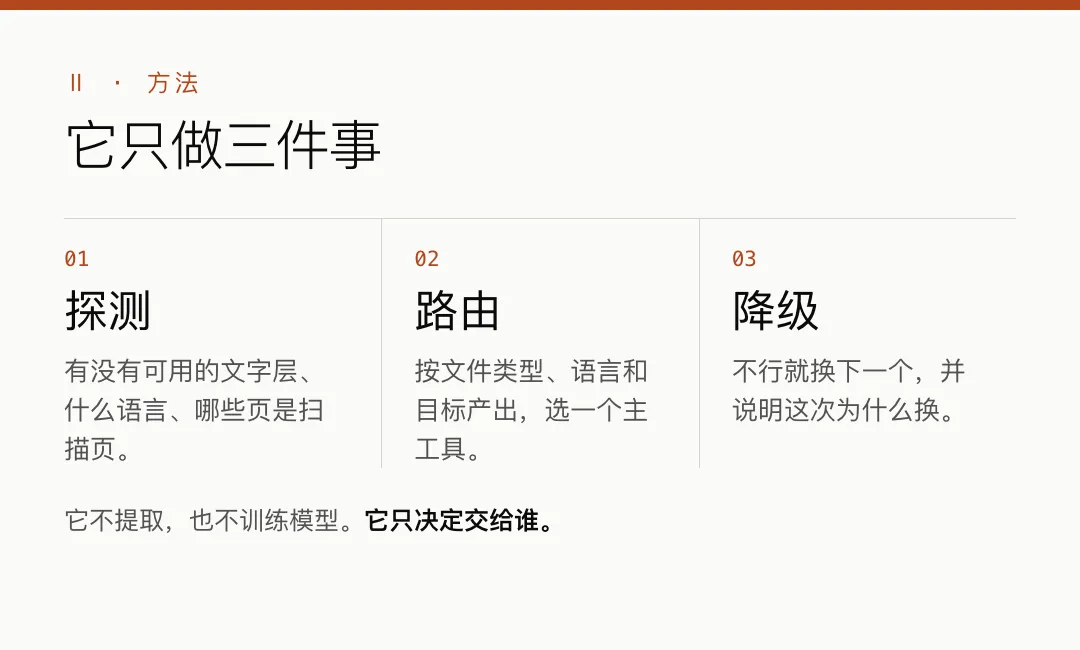
它不做的三件事也一样重要。它不提取,OCR 和版面分析都由底层工具完成。它不训练模型,仓库里没有权重。它不保证结果,每一步可查可换可复核,但不承诺一次就完美。
换句话说,那些高星工具是乐手,docarbiter 是那根指挥棒。
18 个工具,默认只装 8 个
工具是别人的,组合方式是我的。
登记在册 18 个,都是别人的开源项目,许可证各不相同。默认只装 8 个核心工具。
另外 10 个按需安装。PaddleOCR、Marker、olmOCR、Unstructured 属于 extra。Tesseract、Surya、pypdf、pdfminer.six、qpdf、Camelot 属于 optional。
为什么默认只装 8 个?每多装一个,冲突概率就上升。上面那个 Pillow 版本冲突就是例子。
版权归各自作者,许可证是 MIT、Apache-2.0、MPL-2.0、GPL 这类开源许可。docarbiter 本身是 MIT,不分发上游的代码和模型,只写调用方式和版本锁定。
一次调用长什么样
不用看懂命令,看最后三行就行。
python3 -I scripts/route.py paper.pdf --goal manuscriptprobe: status=usable language=zh chars=616 bad_ratio=0.00%route: intended=mineru selected=mineru goal=manuscriptreason: clean paragraphs, headings, and page anchorscommand: mineru-doc paper.pdf --pages all -o out.mdfallback: docling, liteparse
意思是:这份 PDF 有文字、是中文、你要成稿,所以用 MinerU;如果效果不好,下一步换 Docling。
每次调用都会留下这几行。可以贴进日志,也可以写进论文的方法附录。
用了之后
变的是稳定,不是速度。
以前是凭感觉挑工具,读坏了各自重试,下次结果又不一样。现在先判类型,再查规则表,换工具要说明理由。
三个你能直接检查的结果:
同一个文件,每次走到同一个工具。 每次换工具,都有依据。 18 个工具的名字,不需要记住。
证据与边界
样本小,就说样本小。
先看提取质量。5 篇真实双栏论文,对照独立来源的 PMC JATS 或 ar5iv 全文,算全文 CER,也就是字符错误率。3 个真实表格页,分别是 WS/T 578.1 第 8 页、GB 28050 第 6 页、GB 2760 第 13 页,逐个单元格算 CER。真竖排重跑,Docling 26.67%,MinerU 29.52%,没有工具能免人工复核。
再看判断质量。v0.1.3 用 63 份中文 PDF 做了一次路由审计,其中 43 篇期刊论文和学位论文,20 份标准和规范。这一轮修掉了三个真实问题:语言判断改用中文字符占比,不再比绝对数量;能识别隐藏文字层并重新 OCR;能识别自定义编码并转到 MinerU。
这是路由审计,不是精度基准,不能拿来当准确率。
手写、印章、低分辨率扫描目前仍然没解决。Windows 没有验证。extra 工具这次没有安装,也没做基准。
版本也是锁死的。v0.1.4 把 Docling 升到 2.150.1,liteparse 升到 2.19.0,自测 32 项全过。MinerU 停在 4.1.7,因为 4.2.x 的服务端路径没验证。OCRmyPDF 停在 17.12.1,因为 17.14.x 要 Pillow 13 以上,和 MinerU 冲突。
没验证过的路径,不进默认链。
不会写代码也能装
把网址发给 Agent,说一句话。
不用打开终端。对你的 Agent 说:
你可以这样说:帮我安装并配置 docarbiter,地址是 github.com/ChemistryBus/docarbiter。装完检查一下缺哪些工具,不要读取我的文档内容。
它会先问你是否允许,然后跑 bootstrap.sh,最后用 doctor.sh 报缺哪些工具。缺什么就再说一句,让它把缺的装上。
装完怎么用:把文件放进项目,用中文说要做什么,比如把这篇文章转成 Markdown,保留标题和页码。它自己决定用哪个工具。
想手动装:
git clone https://github.com/ChemistryBus/docarbiter.gitcd docarbiter && ./scripts/install.sh --profile core./scripts/doctor.sh --check-conflicts
只想先试试、不装也行。clone 之后跑 route.py,它只输出判断,不做提取,也不会动你的文档。
成本与适用
免费,本地,但不是所有人都需要。
docarbiter 开源免费,MIT 许可。所有解析都在本机跑,没有服务端,不上传文档。默认 8 个工具用 CPU 就够,不需要显卡。extra 工具有的依赖 GPU,有的要下几 GB 模型,按需再装。
不适合谁:
已经有一套稳定文档流水线的人,够用就别多套一层。 想要 SaaS、不想碰本地环境的人,它不是。 指望它解决手写、印章、低质量扫描的人,它做不到。 只用 Office 文件、从不碰 PDF 的人,Docling 一个就够了。
docarbiter 是个人开源项目,不是哪家公司的产品。它不抓数据,也不训练模型。
结尾
模型会越来越强,但把版式还原成文本这一步不会自动消失。它需要工具,而工具需要有人决定谁上场。
高星工具解决的是能不能读。指挥棒解决的是读得对不对、下次还对不对。
https://github.com/ChemistryBus/docarbiter
如果它对你有用,点个 star 就是最大的支持。