ARTICLE · 1387792
公众号文章批量下载PDF文献
点击蓝字 关注我们
做科研的日常大概是这样:早上刷到一篇公众号解读,标题很对味;想读原文,于是复制标题 → 搜 DOI → 打开出版社页面 → 登录 → 点下载。等 PDF 落盘,五六分钟过去了,思路也断了。
如果这一周攒了十几篇呢?组会前想补课、写综述想一次捞全、开题想确认某个方向的最新进展——光是把 PDF 找齐,就能耗掉半天。
文献下载器
这个工具只做一件事,但做得比较彻底:把公众号里提到的论文,批量变成你硬盘上的 PDF,并且按规范命名。
贴进去(一行一个),它逐篇打开文章、认出这篇解读讲的是哪一篇论文,再把全文下回来,存成序号_作者_年份_标题.pdf。一周的推送攒到周末,一次贴进去批量下载。
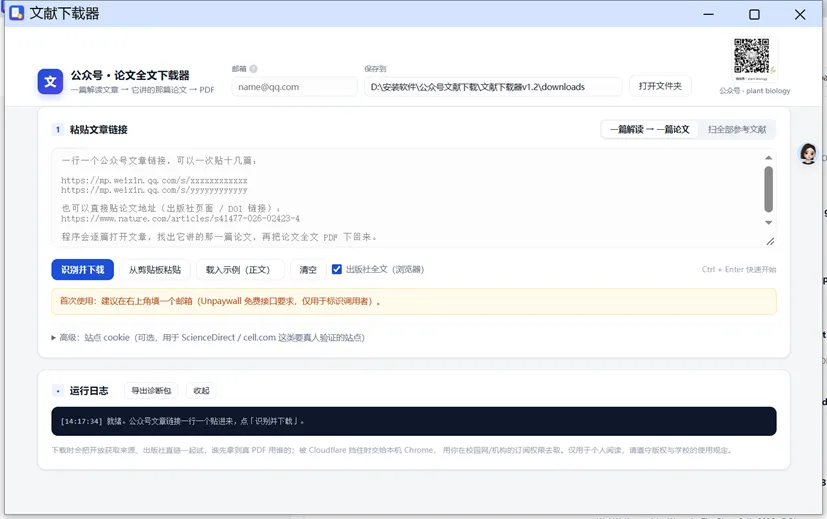
▲ 粘链接 → 识别 →下载,就这三步
它具体省下哪几段时间
· 找原文的时间:不用再复制标题去搜、去出版社页面里翻 PDF 入口;
· 确认是哪一篇的时间:识别结果里带着期刊、年份、DOI 和来源,能核对;有多个候选时可以「换一篇」,不是硬猜;
· 重命名归档的时间:文件按「序号_作者_年份_标题」命名,另附一份「下载报告.csv」,对账、导进文献管理软件都方便;
实测:7 篇公众号文章,识别出 7 篇论文,全部下载完成,两分钟左右。
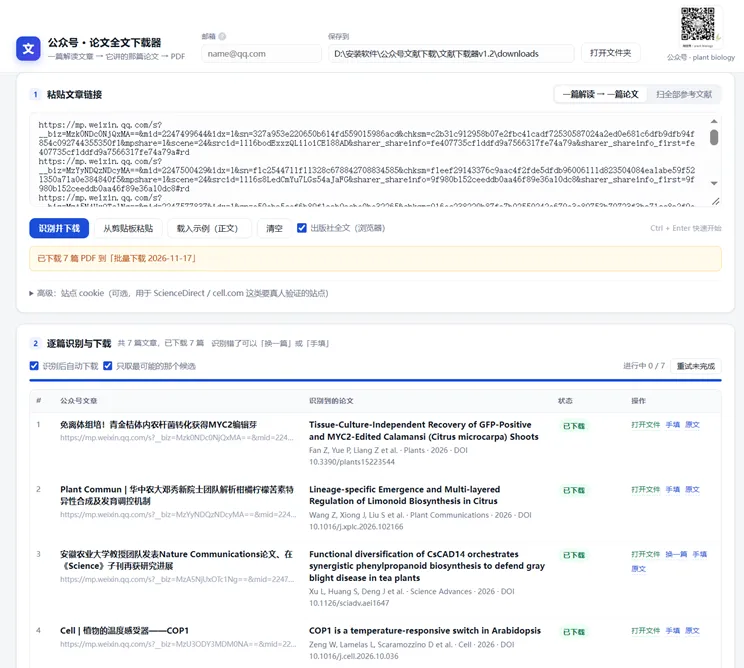 ▲ 一次贴 7 篇公众号文章,识别出 7 篇论文,全部已下载
用起来就三步
1. 双击 文献下载器v1.2.exe,把链接粘进窗口(一行一个,十几篇也行);
2. 点「识别并下载」,看进度条走完;
3. 打开downloads 文件夹,PDF 已经按序号排好了。
第一次用建议在右上角填一个邮箱(Unpaywall 免费接口要求,只用于标识调用者,填一次就记住)。除了公众号链接,也能直接贴 DOI、出版社页面地址,或者把一篇文章的参考文献整段丢进去,它会把能识别的一条条列出来,你再挑要下的。
「能不能下到全文」,说清楚
它会依次尝试:开放获取 → 出版社直链 → 本机浏览器(走你校园网/机构订阅的权限)。所以能不能拿到全文,取决于你所在单位订了什么,它不绕过付费墙。
ScienceDirect、Cell 这类要「验证您是真人」的站点,程序会自己弹出浏览器:你点一次「下载 PDF」,文件会自动收进来并改好名字。
全部本地运行:稿件、DOI、下载记录都不上传;诊断包里也会剔除 cookie 和邮箱。
三个小提示
· 要人机验证的站点:在弹出的浏览器里点一次「下载 PDF」即可,同类站点之后会记住;
· 版权:仅用于个人阅读与科研,请遵守版权与学校的使用规定;
· 下不下来:点界面下方「导出诊断包」,把 zip 发到 plant_biology@163.com,以便在下一版本改进。
获取方式
Windows版,免安装,约9 MB,双击即用。
下载方式:在公众号后台回复关键词「文献下载器」获取下载链接。
解压后双击 文献下载器v1.2.exe 就能用(exe 要和 _internal 文件夹放在一起)。
微信号丨plant biology