ARTICLE · 1400241
19 万星的文档转换器 一行命令把 PDF 喂给模型
markitdown:微软出品,把一切转成 Markdown
模型读不了 PDF,这件事到今天还得靠人手动搬。
我上一轮试过:把一份 HTML 丢给 markitdown,出来的 Markdown 结构一点没丢,表格还在。
仓库 193,607 星,微软出品,2024-11-13 建仓,到现在还在维护。
这篇讲它怎么用、我实测到的样子,以及它做不到的地方——包括这次重写时我连装都没装上。
01一、它解决的是「喂料」问题
仓库是 microsoft/markitdown,完整地址 https://github.com/microsoft/markitdown 。193,607 star、14,524 fork,2024-11-13 创建,最近推送 2026-10-28。
它做的事很单一:把各种格式的文档转成 Markdown。PDF、Word、PPT、Excel、HTML、CSV、JSON、XML、ZIP、图片、音频、EPUB 都在范围内。
为什么是 Markdown 而不是纯文本?因为标题层级、列表、表格这些结构对模型有用。纯文本会把一份带表的报告压成一坨,模型就得靠猜重新还原结构。
为什么是微软做这个?因为这是 RAG 链路上最脏的一段活。文档格式几十种,每一种都有自己的历史包袱,而大厂内部要处理的文档量又极大——做出来顺手开源,比自己维护一套内部工具划算。这类项目通常不惊艳,但活得久。
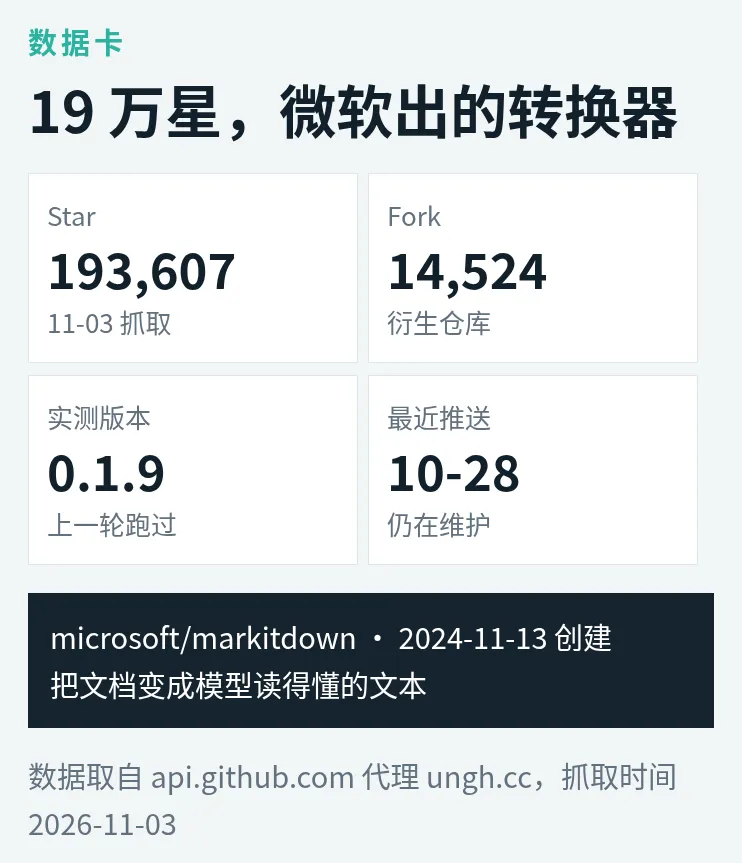
图 1:markitdown 的关键数据,取自 api.github.com(经 ungh.cc 代理),2026-11-03 抓取,作者自绘
数据
193,607 star / 14,524 fork / 2024-11-13 创建 / 最近推送 2026-10-28(抓取于 2026-11-03)
转出来的东西长什么样?
02二、我实测过的转换效果
上一轮我在这台机器上装了 0.1.9,写了一份带 h1、段落、无序列表、表格的测试 HTML,跑出来是这个样子:标题保住、列表保住、表格也保住了。
这就是它比「复制粘贴进对话框」强的地方——结构是被解析出来的,不是被丢掉的。
但要说清楚:这次重写我没能重跑。pip 装 [all] 依赖时卡在一个叫 magika 的大轮子上,镜像连续超时,命令直接失败。所以上面的对照图是上一轮的结果,不是刚刚跑的。这一点我必须写明白。
支持范围值得单独说一下:Office 三件套(docx、pptx、xlsx)、PDF、EPUB、HTML、CSV/JSON/XML、ZIP(会递归进去逐个转)、以及图片和音频。图片和音频走的是「描述成文字」的路子,需要额外依赖,质量取决于模型能力,不是它的强项。
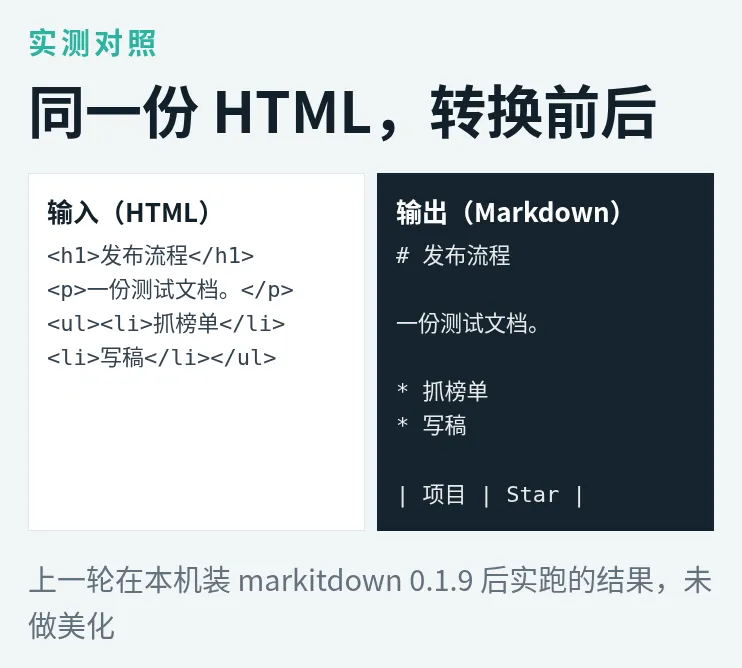
图 2:HTML 转 Markdown 的前后对照,上一轮在本机实跑 0.1.9 的结果,作者自绘
实测记录
上一轮:pip install markitdown → 0.1.9,HTML→MD 结构完整。本次:pip install 'markitdown[all]' 在 magika 轮子下载处超时失败。
用法简单到有点不像微软的东西。
03三、一行装,一行转
装:pip install 'markitdown[all]'。转:markitdown 报告.pdf > 报告.md,或者 -o 指定输出。cat 报告.pdf | markitdown 也能吃管道。
不想装全套就按需装:pip install 'markitdown[pdf,docx,pptx]'。这一点在带宽紧张或者镜像慢的时候很关键——[all] 会把 OCR、音频、各种解析器全拉下来,几百兆。
它同时提供 Python 接口,可以塞进 RAG 的预处理管道。插件机制允许你自定义转换器,比如接自己的格式。
除了命令行,它还有 Python 接口,可以直接塞进预处理管道:读文件、拿 Markdown 字符串、再切块入库,一步到位。要写自定义转换器,它留了插件机制——注册一个处理某类文件的函数即可,不用改源码。
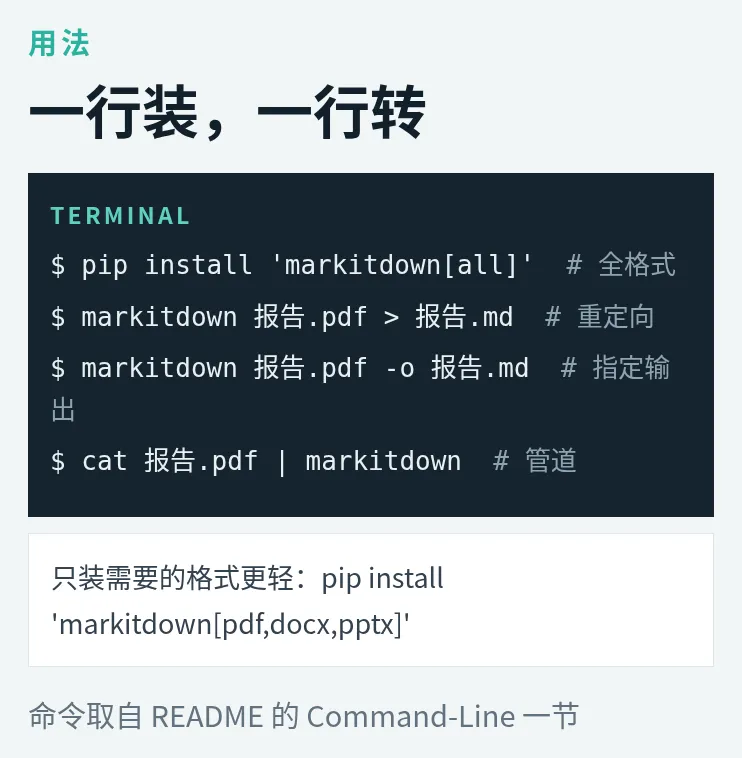
图 3:命令行用法,取自 README 的 Command-Line 一节,作者自绘
经验
如果只是要把 PDF 转文本喂模型,装 [pdf] 就够;[all] 里的 OCR 依赖对中文扫描件帮助有限,反而拖慢安装。
它做不到的事,也得说清楚。
04四、四个坑
第一,复杂版式会失真。双栏论文、带批注的合同、嵌套很深的表格,转出来顺序会乱。这不是它的 bug,是 PDF 本身不带语义——它只能靠位置猜结构。
第二,扫描件要 OCR,而 OCR 质量取决于图。清晰的印刷体还行,手写、低分辨率、带水印的基本没救。
第三,安装体积。这次我就是被 [all] 卡住的:依赖里有个 magika 的轮子,镜像超时就直接失败。生产环境建议锁版本 + 预装依赖,别在流水线里现装。
第四,转换不等于理解。它把文档变成文本,但有没有抓住重点、表格里的数字对不对,还得你自己核。我见过转出来表格列错位、数字串行的情况。
再补一条容易踩的:编码。中文文档如果不是 UTF-8(比如老的 GBK 表格),转出来可能是乱码,而不是报错。批量转之前先抽两份看看,比转完一千份再发现要好。
还有一个现实问题:量。单份转换很快,但一千份 PDF 是另一个故事——每份都要解析、有时要起 OCR,CPU 吃满不说,失败的那几份还得单独重跑。我的做法是先在管道里加一道「转换结果长度异常就报警」的检查,空文件或只有几十个字符的,八成是解析失败,别直接入库,否则检索出来的全是垃圾片段。
复杂版式(双栏、嵌套表)会失真
扫描件靠 OCR,质量看原图
[all] 依赖重,本次安装即失败
转完必须人工核对表格与数字
适合谁
要把一批文档灌进知识库、或者天天和 PDF 打交道的团队。偶尔转一份文件,用在线工具更快。
你手上那堆 PDF,有多少其实只是没人愿意手动搬?
我猜不少。搬一次的成本不高,搬一百次就值得写条管道。
这类工具不惊艳,但它把一件重复劳动变成了一个命令。
真正该花时间的,是转完之后核对——那部分它替不了你。
顺带一提:它转出来的 Markdown 可以直接进版本库。我把项目里的文档全转了一遍,之后改稿有 diff 可看,比对着 Word 的修订模式舒服得多,也不怕格式在传阅中走样。
技术开源社