 夜雨聆风
目录 / CONTENTS
01 为什么 AI 自查通过 ≠ 代码能用
02 10 项总览(三层组织)
03 详解 10 项
04 把 10 项落到 PR 流程里
05 适用边界
06 最后总结
这一篇给你带走的,是一张 PR 前必查表
很多测试人都在用 AI 写脚本。
写完那一刻,心里清楚:能跑通,不等于能 merge。
按下回车之前,问自己一句:这段代码,是 AI 自查通过,还是我看过一眼?
AI 的内置自查机制会跑一遍,结果常常「全部 PASS」。
但 AI 自查有它的盲区。
业务上下文它不懂。
团队规约它没读过。
跨环境差异它看不见。
这三件事,全靠人给它。
代码有没有用,要看三件事:
业务、技术、运行。三个维度都不能漏。
下面这 10 项,就是按这三层组织的。
读完你能立刻拿走一个动作:每一份 AI 写出的测试脚本,merge 前花 3 分钟按这 10 项过一遍。
可不可以省?
可以。但省哪一项,你就会在哪一项上摔过。
01
PART
为什么 AI 自查通过 ≠ 代码能用
WHY · THREE-LAYER CHECK
AI 的自查机制有自己的边界。
它能看到刚生成的代码,也能按模型里学到的通用模式做对照。
它看不到的,至少三件事:
· 你的业务(订单金额怎么算、状态机怎么转移)
· 你的团队规约(POM 怎么分、选择器用什么约定)
· 你的环境差异(CI 上访问的是另一个地址,账号也不一样)
这三件事,AI 都得靠人给。
光靠「AI 自查通过」这一项,远远不够。
代码有没有用,要看三个维度都没漏:
业务、技术、运行。
下面这 10 项,就是按这三个维度组织的。
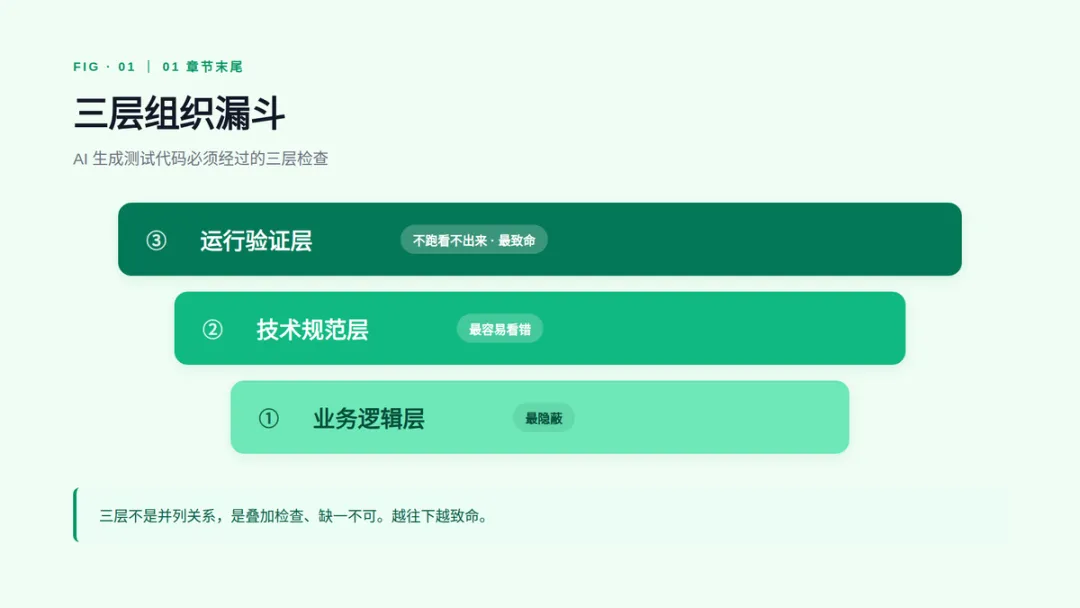
三层组织漏斗:业务 → 技术 → 运行,越往下越致命
02
PART
10 项总览(三层组织)
CHECKLIST · 10 ITEMS
先把 10 项摊开看一眼。
业务逻辑层(必须懂业务才能看出错):
1. 断言空泛化:AI 倾向写 assert status_code == 200,不验业务字段。
2. 业务流程断裂:默认只跑 happy path,缺取消、幂等、重试。
3. 边界值遗漏:默认整十数,业务上 0、负数、极值的合法性常常被忽略。
4. 跨接口依赖被吞:前置条件失败时,断言失败的位置错乱。
技术规范层(脱离团队规约):
5. 选择器硬编码:index=0、长 CSS 路径、写死的 XPath。
6. sleep 兜底时序:time.sleep(2) 替代显式等待。
7. 测试数据未隔离:fixture 复用、用例间互相污染。
8. 异常被吞掉:空 try/except、日志丢失。
运行验证层(不真跑发现不了):
9. 环境硬编码:localhost、硬编码账号、字面量 URL。
10. 「全 PASS」被误读为「全覆盖」:用例绿了不等于业务被覆盖。
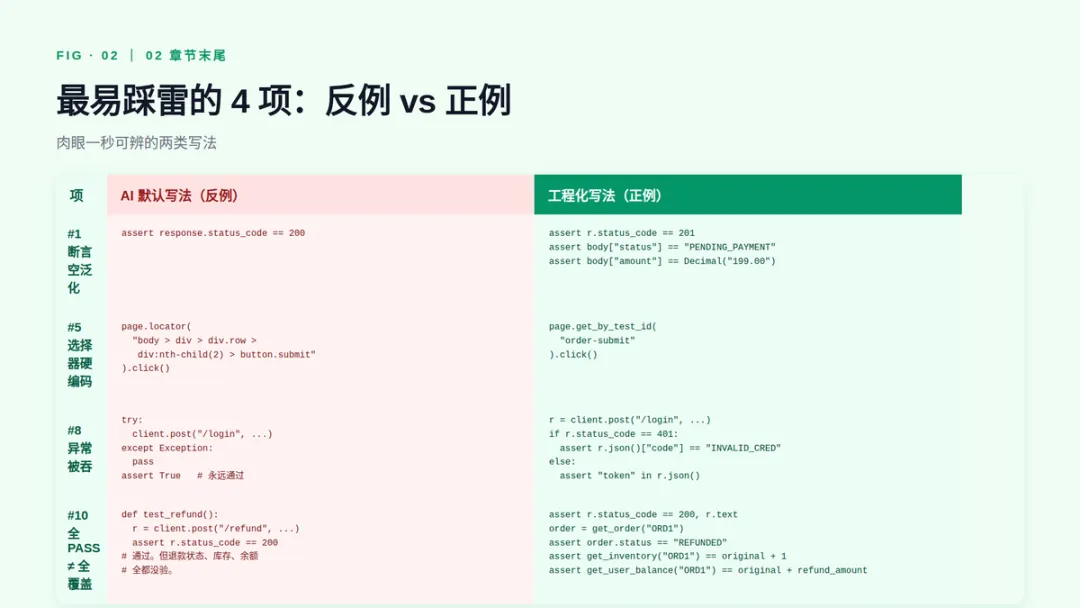
最易踩雷的 4 项:反例 vs 正例,肉眼一秒可辨
03
PART
详解 10 项
10 ITEMS · 反例 / 正例 / 30 秒动作
下面把 10 项一项一项展开。
每项都有:翻车现象 / 反例 / 正例 / 30 秒人工动作 / 为什么 AI 这么写。
断言空泛化
你让 AI 写一个断言,它会这么给你:
反例 · 看起来在断言,其实只验了 HTTP 通没通
def test_create_order():
r = client.post("/orders", json={"sku": "A1", "qty": 1})
assert r.status_code == 200
正例 · 加业务断言,不只是 HTTP 状态
def test_create_order():
r = client.post("/orders", json={"sku": "A1", "qty": 1})
assert r.status_code == 201
body = r.json()
assert body["status"] == "PENDING_PAYMENT"
assert body["amount"] == Decimal("199.00")
30 秒人工动作:扫一眼每一个 assert 都问一句——如果服务端造假但返回 200,这条断言还能抓到吗?抓不到——这一项没过。
为什么 AI 这么写:训练语料里 status_code == 200 的例子最多。它复制的是「测试模板」,不是「测试断言」。
课程建议 · 详细的多层断言体系另有篇幅展开。本篇只点出「表面通过 ≠ 业务通过」这个根本问题。
业务流程断裂
反例 · 只写 happy path 直链
def test_order_lifecycle():
order = create_order()
assert get_order(order.id).status == "PAID"
delete_order(order.id)
正例 · 显式覆盖关键状态与反例分支
def test_order_lifecycle():
order = create_order()
assert get_order(order.id).status == "PENDING"
pay_order(order.id)
assert get_order(order.id).status == "PAID"
cancel_order(order.id)
with pytest.raises(BizError):
pay_order(order.id)
30 秒人工动作:数一遍业务里的状态数。AI 默认只覆盖你显式提到的那些;业务上其他高价值状态(比如「申请退款但未审核」),AI 没主动想到。
为什么:AI 不知道你的状态机长什么样。给它一张状态图,它也不会主动写「取消分支」。
已验证 · 在多个真实项目里,状态分支缺失是 10 项里出现频率最高的之一 —— AI 一上手就只走你显式提到的那条直线。
边界值遗漏
反例 · 参数都是整十数
@pytest.mark.parametrize("amount", [100, 200, 500])
def test_payment_amount(amount):
r = client.post("/pay", json={"amount": amount})
assert r.status_code == 200
正例 · 补上 0 / 负数 / 极值 / 货币最小单位
@pytest.mark.parametrize("amount", [
0, 1, 99999999, -1, Decimal("0.01"),
])
def test_payment_amount(amount):
r = client.post("/pay", json={"amount": amount})
# 每个值的预期由业务决定,不是 AI 能猜
assert r.status_code in (200, 400)
30 秒人工动作:看 @parametrize 那一组数。问:业务上 0 是什么语义?负数该被拒还是该报错?极值会不会触发溢出?只要答案你没把握,这一项没过。
为什么:AI 默认偏「整数默认值」。它不知道你的产品决策。
待你团队实际业务验证 · 把业务方允许/禁止的边界列一张表,每次 AI 出用例前贴给它。
跨接口依赖被吞
反例 · 步骤排成直线,前置失败位置错乱
def test_inventory_deduct_after_pay():
pay() # 失败信息会误导
inv = get_inventory()
assert inv > 0
正例 · 把前置条件拉出来显式 assert
def test_inventory_deduct_after_pay():
pay_result = pay()
assert pay_result["status"] == "PAID",
f"前置失败: {pay_result}"
inv = get_inventory()
assert inv["available"] >= 0
30 秒人工动作:看每个步骤的前置条件。失败的报错信息能直接定位「哪一步出了问题」吗?如果都只是 assert ... == True,定位时间会被拉长。
待你团队实际业务验证 · 跨接口依赖的具体清单,建议按业务子系统维护一份「调用关系图」。
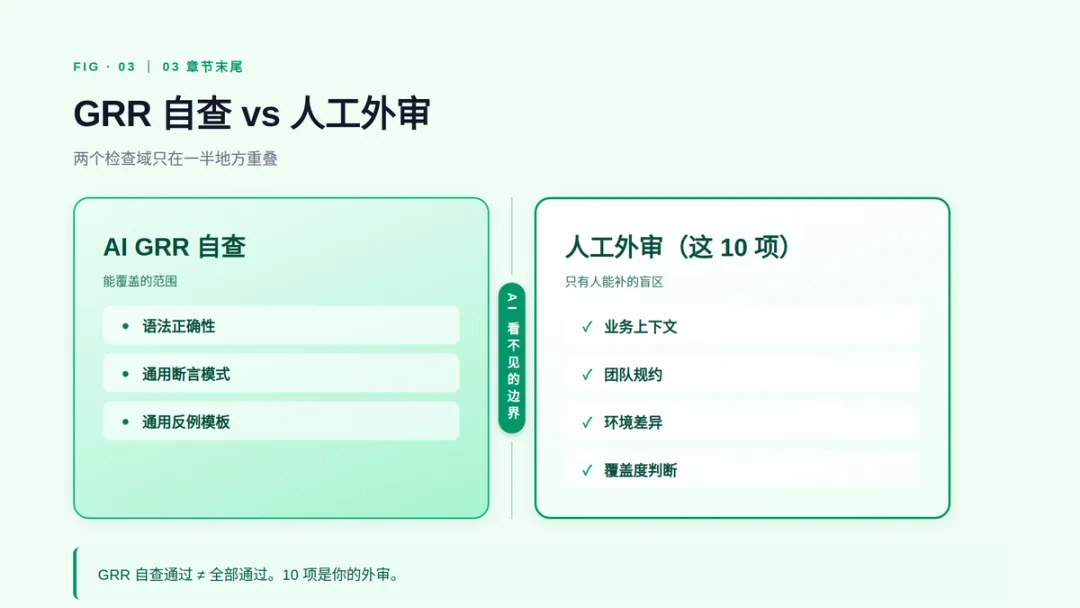
GRR 自查 vs 人工外审:两个检查域只在一半地方重叠
选择器硬编码
反例 · 长 CSS 路径 + nth-child
page.locator(
"body > div > div.row > div:nth-child(2) > button.submit"
).click()
正例 · data-testid 这类团队约定的标识符
page.get_by_test_id("order-submit").click()
30 秒人工动作:扫一遍 locators。出现 nth-child、长 CSS、XPath 路径——这就是反例信号。data-testid 才是工程上能稳定的写法。
为什么:AI 倾向「找得到元素」。它不知道你团队的标识符约定。
sleep 兜底时序
反例 · time.sleep 替代显式等待
page.click("#submit")
time.sleep(3)
assert page.locator("#result").is_visible()
正例 · 显式等待 + 超时
page.click("#submit")
expect(page.locator("#result")).to_be_visible(timeout=5000)
30 秒人工动作:全局 grep -n "sleep"。一旦命中,必查。CI 上比本地慢得多,sleep(2) 一定会被打爆。
已验证 · 这一项的修复通常 2-3 行代码,CI 红/绿立刻翻转——投入产出比最高的一项。
测试数据未隔离
反例 · 复用 fixture + 单测任意修改
@pytest.fixture
def order():
return create_order(qty=10)
def test_a(order):
order.qty = 5
def test_b(order):
# 依赖 test_a 的修改
assert get(order.id).qty == 5
正例 · function scope 或参数化
@pytest.fixture # function scope 是默认
def order():
return create_order(qty=10)
# 或者显式参数化
@pytest.fixture(params=[5, 10, 100])
def order(request):
return create_order(qty=request.param)
30 秒人工动作:看 fixture 的 scope。function 是默认;module / session 要确认是不是真的能共享。「昨天绿今天红」最常见就是这一组合。
异常被吞
反例 · 显式吞异常 + 末尾 assert True
def test_login():
try:
client.post("/login", json={"u": "x", "p": "y"})
except Exception:
pass
assert True # 永远通过
正例 · 显式处理预期失败,而不是吞掉所有异常
def test_login():
r = client.post("/login", json={"u": "x", "p": "y"})
# 显式处理业务预期的失败,而非吞掉所有异常
if r.status_code == 401:
assert r.json()["code"] == "INVALID_CRED"
else:
assert r.status_code == 200
assert "token" in r.json()
30 秒人工动作:全局搜 except:、except Exception:、pass。命中任何一条,停下来。组合「吞异常 + 末尾 assert True」是 AI 写「假装测试通过」最常见的方式。
为什么 AI 这么写:它关心的是别报错,不是抓到错。
课程建议 · 所有「看起来很奇怪能让测试通过」的反例,都要被人工重点审。
环境硬编码
反例 · localhost + test- 开头 token
BASE_URL = "http://localhost:8000"
ADMIN_TOKEN = "test-admin-token"
正例 · 从环境变量读,CI 必须设置
import os
BASE_URL = os.environ.get("E2E_BASE_URL",
"http://localhost:8000")
ADMIN_TOKEN = os.environ.get("E2E_ADMIN_TOKEN")
30 秒人工动作:搜字面量 localhost、127.0.0.1、test- 开头 token。命中任何一条,在 CI 上一跑多半红。
「全 PASS」≠「全覆盖」
反例 · 用例通过 = 业务覆盖?不一定。
def test_refund():
r = client.post("/refund", json={...})
assert r.status_code == 200
# 通过。但退款状态、库存、余额全都没验。
正例 · 显式验证业务断言,不只是 HTTP 状态
def test_refund():
r = client.post("/refund", json={...})
assert r.status_code == 200, r.text
# 显式验证"业务断言",而不只是 HTTP 状态
order = get_order("ORD1")
assert order.status == "REFUNDED"
inventory = get_inventory("ORD1")
assert inventory == original_inventory + 1
balance = get_user_balance("ORD1")
assert balance == original_balance + refund_amount
30 秒人工动作:对每一份「全 PASS」的测试输出,问自己一遍——如果我现在去掉某个业务断言,业务缺陷会被发现吗?答案是「不会」——这一项没过。
为什么 AI 这么写:它能验证「我做了什么」。不能验证「我该做的都做了」。
已验证 · GRR 自查解决不了这一项,必须靠人补。
04
PART
把 10 项落到 PR 流程里
WORKFLOW · 团队成熟度三档
这 10 项不是个人习惯,是团队规约。
PR 流程:Generate → GRR 自查 → 10 项人工外审 → CI 跑过 → Merge。
橙框那一步不能省。
省哪一项,你就会在哪一项上摔过。
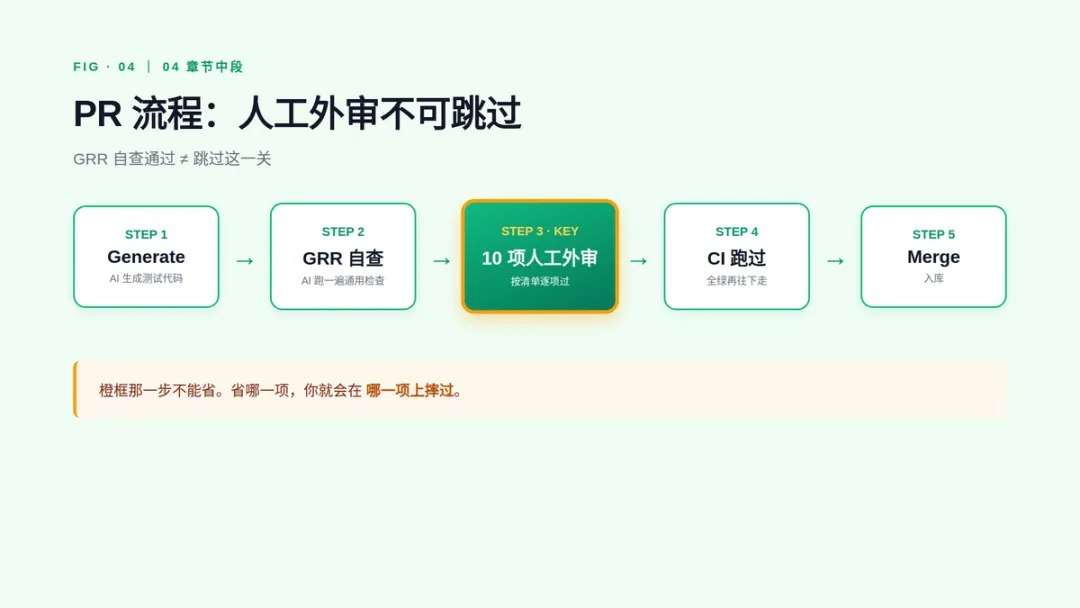
PR 流程:人工外审不可跳过
按团队成熟度分三档:
L1 · 起步档
个人 · 3 分钟
合并前自己过一遍 10 项。未覆盖:团队维度
L2 · 团队档
PR 模板 checklist
PR 模板自带 10 项,提交者勾完才能 merge
L3 · 平台档
工具 + Agent
#5 #6 #8 #9 静态扫描拦 7 成;#1 #2 #3 #4 #10 由 AI 评审 agent 出报告 + 人工终审
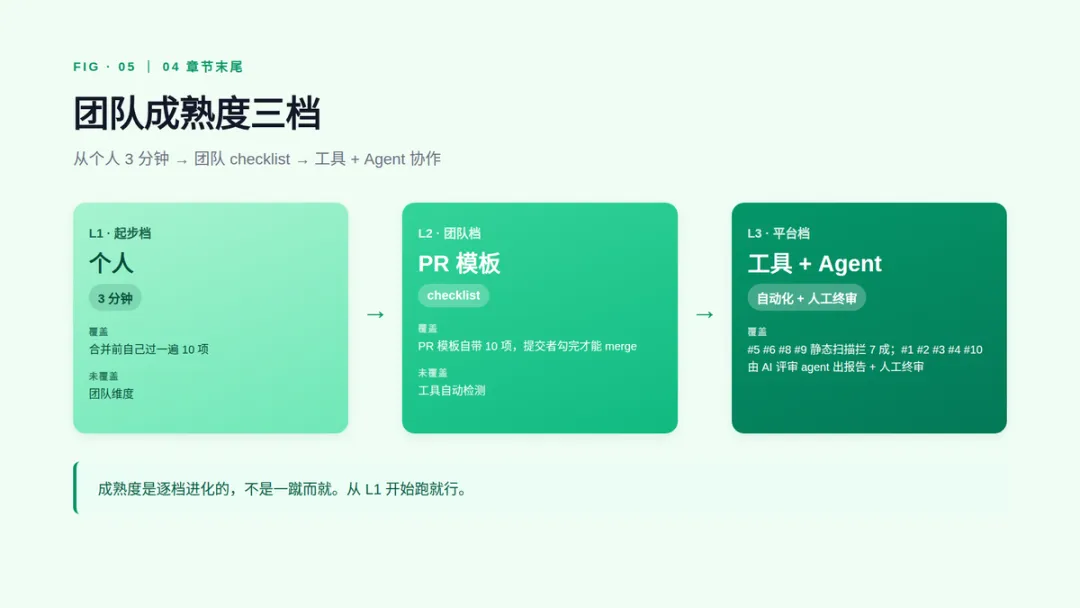
团队成熟度阶梯:从个人 3 分钟 → 团队 checklist → 工具 + Agent
05
PART
适用边界
BOUNDARY · 不是所有场景都必须
不适合直接套:
· 一次性 PoC、探索性测试 — 验证思路就行
· 临时调试脚本 — 不会入库
特别需要人工兜底:
· 跨系统集成(外部依赖多)
· 涉及资金、涉及权限变更(出错成本极高)
· 监管要求留痕的领域(金融、医疗)
与三层审核的对应关系:
· 业务逻辑层 4 项 ≈ 第一层(业务/需求一致性)
· 技术规范层 4 项 ≈ 第二层(技术规范/格式合规)
· 运行验证层 2 项 ≈ 第三层(运行验证/可执行性)
第 10 项是第三层里特别容易漏的。
AI 输出全绿,但没人说业务真的被验到了。
这一篇不展开「三层审核」完整流程;下一篇「让 AI 从接口文档生成可执行测试用例」里会拆这套门禁。
///
LAST
最后总结
SUMMARY · GRR 内审 vs 人工外审
AI 自查给你的是一段能跑的代码。
「能跑」和「能用」之间,隔着这 10 个地方。
把这 10 项做成 PR 前的固定动作。
团队会少踩一些坑。
一句话
GRR 是 AI 的内审。这 10 项是你的外审。
下次 AI 给你一段让你「立刻想 merge」的代码时,停一下,过一遍。
你团队里,AI 翻车翻得最多的,是这 10 项里的哪一项?
评论区告诉我。下一篇就挑翻车最多的那一个,写它的「工程化修复」。
待你团队实际验证 · 以上 10 项的边界场景和识别动作,需要在你的项目里走一遍才能最终校准。本篇给的是通用基线。
我是程序员小濠,专注 AI 测试工程化与实战落地。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING