ARTICLE · 989623
我把调研报告交给AI跑:58秒整理了17个工具 (附PDF资料)
大家好,我是墨叔,后台很多朋友私信我在哪获取资料,最近刚整理好,希望可以帮助到大家,实战项目资料附文章末尾。
00序言
做一份调研报告,真正费时间的不只是“写”。
更烦的是前面那一串小动作:
搜资料,找来源,筛内容,整理字段,做对比,最后再把一堆零散信息写成一份能看的报告。
如果只是偶尔做一次,还能忍。
但如果你经常做公众号选题、产品研究、竞品对比,或者每周都要整理行业资料,这件事就会变成一个稳定消耗精力的坑。
所以这次我想测一个很具体的问题:
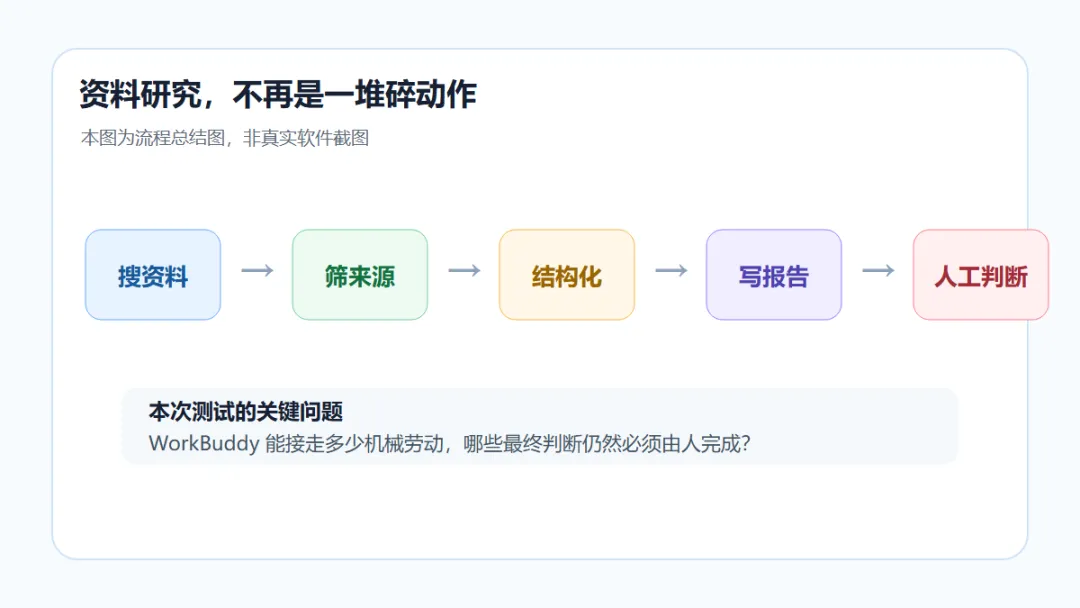
如果把“搜资料 → 找来源 → 整理 → 对比 → 写报告”这整条链路交给 WorkBuddy,它到底能做到哪一步?
不是测 WorkBuddy 有多强。
也不是做 17 个 AI 工具大横评。
这次真正想看的,是一个更普通、也更实用的问题:
这类 Research Workflow,到底适不适合交给 Agent 先跑?
然后我让 WorkBuddy 真实跑了一次。
结果是:
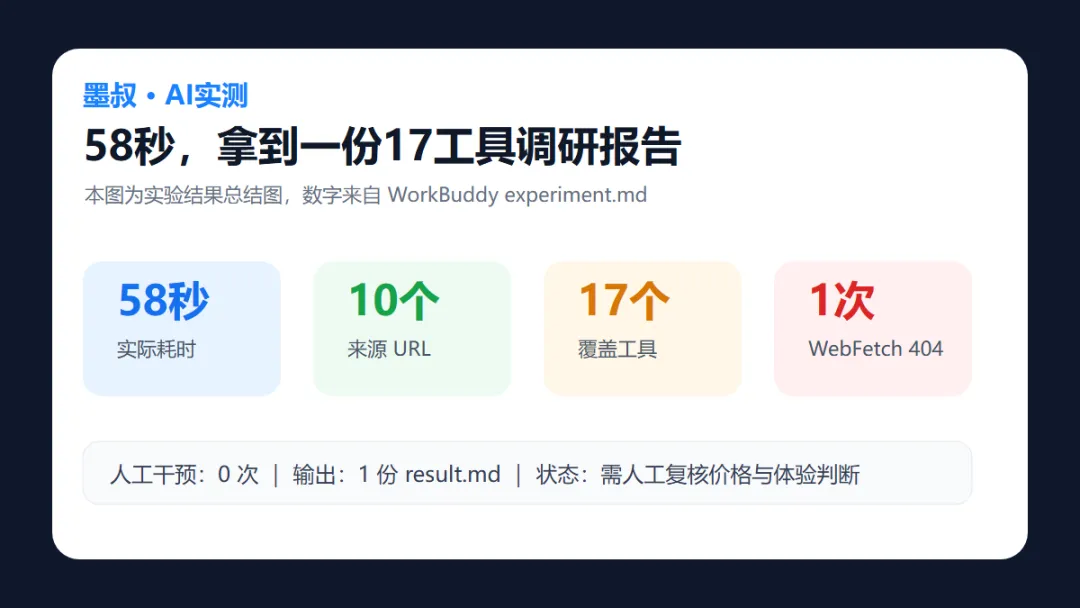
58 秒。 10 个来源 URL。 17 个工具。 1 份结构化报告。 0 次人工干预。 以及 1 次真实失败。
01我给它的任务,不是“帮我查一下”
我没有只丢一句“帮我查 AI 办公工具”。
这种提示词太泛了,最后很容易得到一堆工具名,看着热闹,实际没法用。
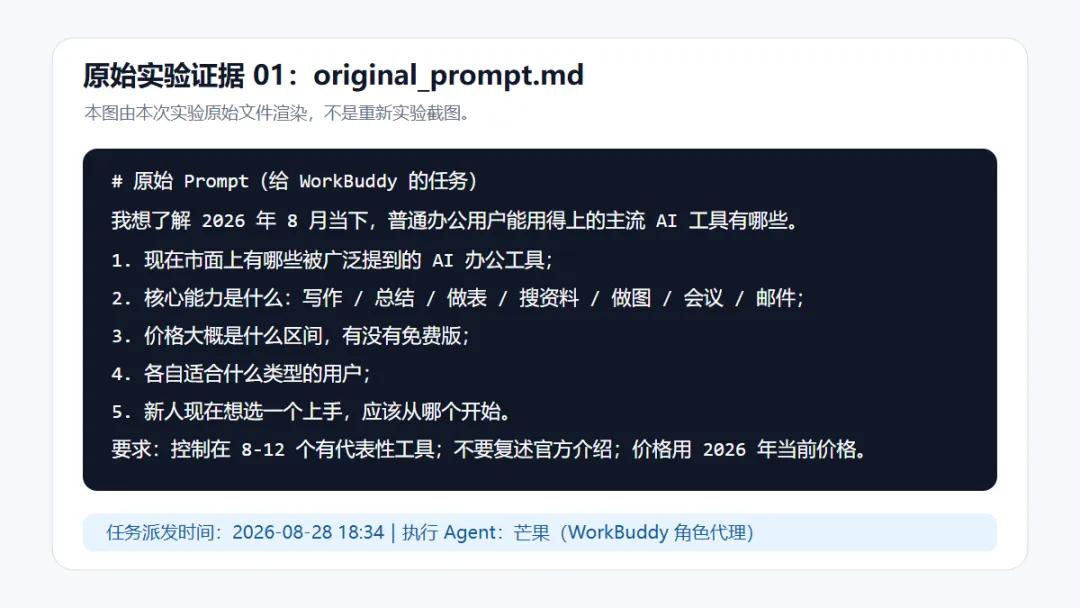
这次我给 WorkBuddy 的任务是:
请调研 2026 年 8 月主流 AI 办公工具,覆盖国内常见工具和部分海外工具。 要求: 1. 找出目前被频繁提到的 AI 办公工具; 2. 对比它们的核心能力; 3. 标注价格、免费版或会员情况; 4. 判断适合什么人使用; 5. 最终整理成一份结构化报告; 6. 尽量引用真实来源,不要只复述官方宣传。
这个任务拆开看,其实就是一条完整的资料研究流程:
先确定问题。
再去搜索资料。
再拿到来源。
再把信息筛出来。
再分类整理。
最后写成报告。
这也是我平时做内容调研最费手的部分。
人的价值应该放在判断和表达上,而不是在十几个页面之间复制粘贴。
02它确实开始搜了,但不是“读完所有网页”
这里要先把边界讲清楚。
根据 experiment.md 的记录,本次 WorkBuddy 主要用了两个能力:
WebSearch。
WebFetch。
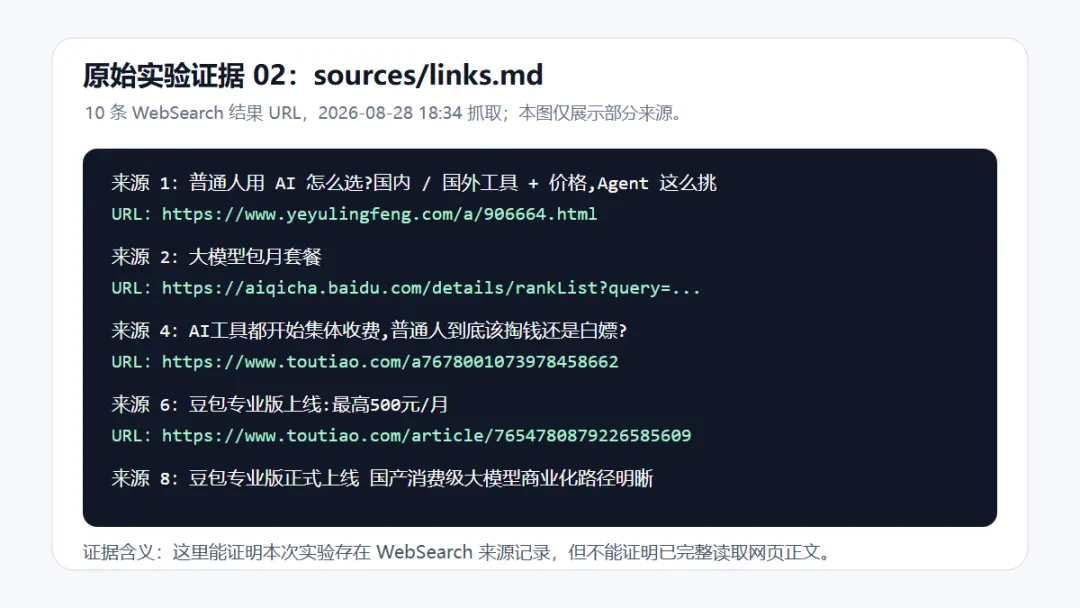
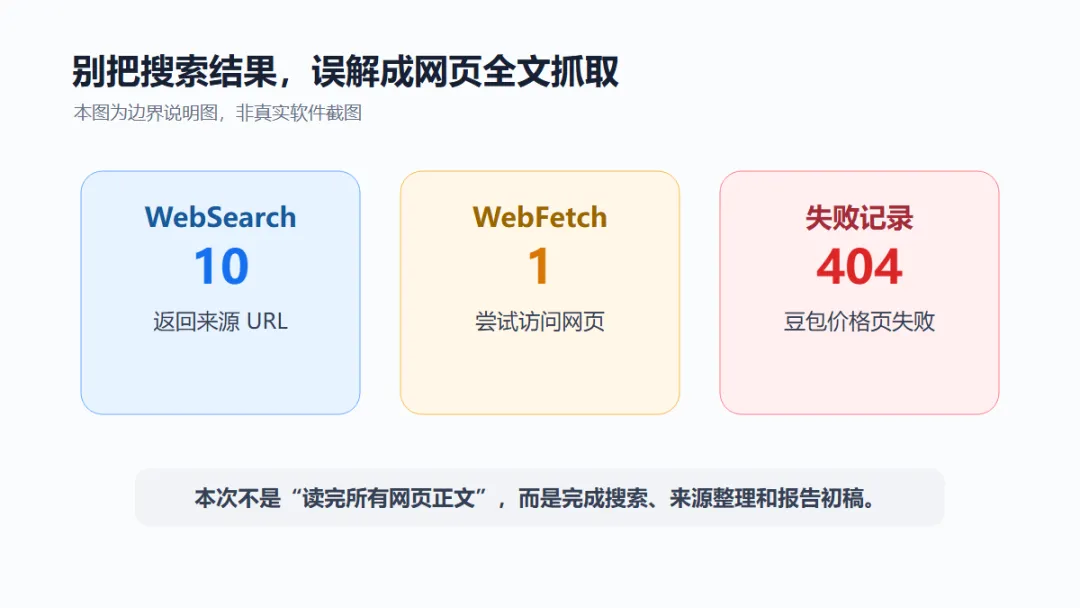
WebSearch 做的是搜索,返回来源 URL。
WebFetch 做的是尝试读取具体网页。
这两件事不一样。
本次真实结果是:
WebSearch 返回了 10 个来源 URL。 WebFetch 尝试了 1 次。 这 1 次失败了。
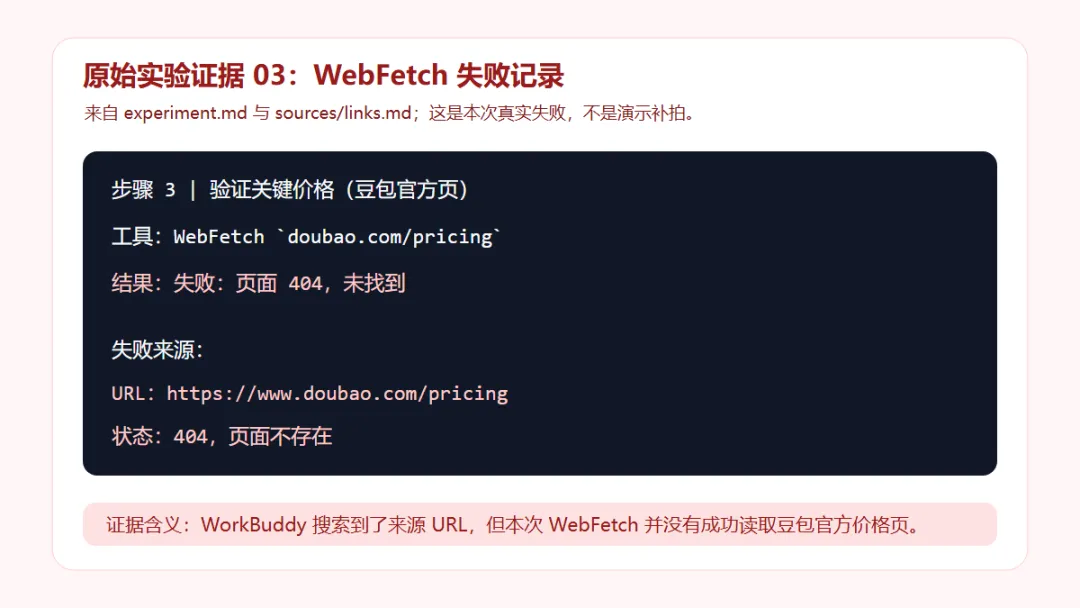
失败的页面是豆包价格页:
https://www.doubao.com/pricing
结果返回 404。
所以这篇文章里有一个非常重要的结论:
WorkBuddy 这次并不是“读取了所有网页正文”。 它完成的是搜索结果收集、来源整理和结构化报告生成。
这个边界必须写清楚。
不然读者会以为 Agent 已经把 10 个网页全部打开、通读、抓取正文,再写出结论。
事实不是这样。
它确实跑通了调研工作流的一大段,但不是全自动深度爬取。
03WebFetch 失败以后,它怎么处理
我反而觉得这次 404 很有价值。
因为真实世界里的调研,不会像演示视频那样一路顺滑。
网页会失效。
官方页会改路径。
价格页会跳转。
搜索结果里会混进媒体稿、聚合页、二手信息。
这次 WorkBuddy 遇到豆包价格页 404 后,没有直接编一个价格。
它继续用更具体的关键词搜索,例如围绕豆包专业版、不同价格档和权益信息继续找资料,并用多条媒体来源做交叉核对。
最后它在报告里保留了一个提醒:
公开信息中存在 99 / 199 / 999 与 70 元 4000 积分等不同说法,正式发布前需要再核对官方口径。
这句话不漂亮。
但它可信。
做调研最怕的不是没有答案。
最怕的是 AI 明明不确定,却把不确定包装成确定。
这次它至少把“不稳”的地方标了出来。
04 58秒以后,它到底拿回来了什么
本次实验的真实数据是:
指标 | 结果 |
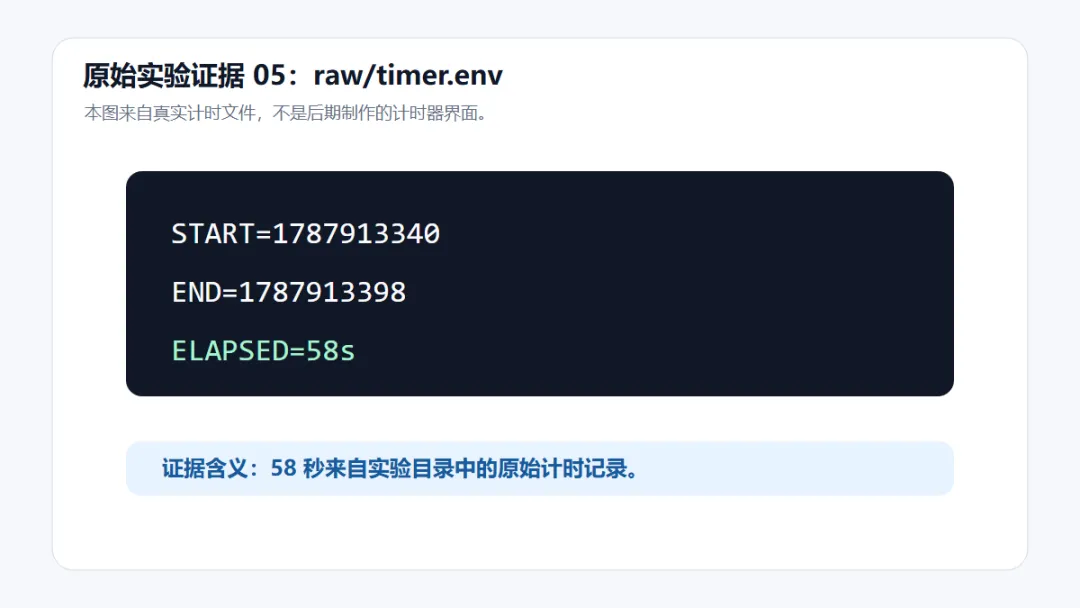
实际耗时 | 58 秒 |
WebSearch 返回来源 URL | 10 个 |
WebFetch 尝试 | 1 次 |
WebFetch 失败 | 1 次,豆包价格页 404 |
人工干预 | 0 次 |
最终输出 | 1 份 result.md |
覆盖工具 | 17 个 |
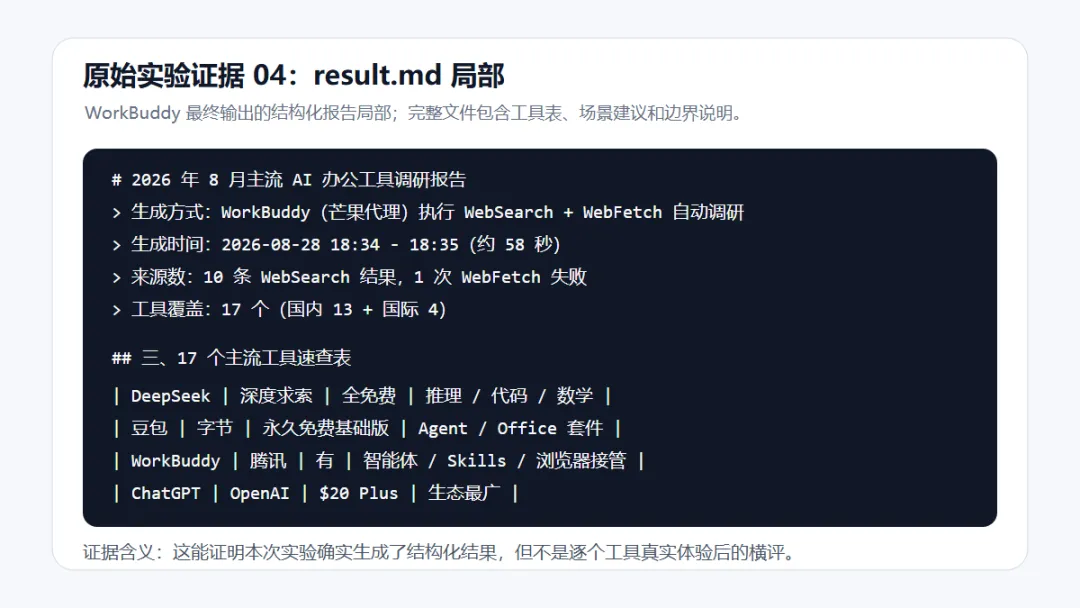
这份 result.md 里,WorkBuddy 把 17 个工具整理成了几类:
国内通用 AI:DeepSeek、腾讯元宝、文心一言、通义、豆包、Kimi、智谱清言、MiniMax、小米 MiMo。
国内办公垂直工具:WPS 灵犀、千问办公、百度搭子、WorkBuddy、讯飞星火、Trae Work。
国际工具:ChatGPT、Claude、Gemini。
这张表可以保留。
但一定要注意:
它是 AI 根据本次检索结果整理出的工作成果。 不是我对 17 个工具逐个真实体验后的全面评测。
这句话很关键。
如果把这篇写成“17 个 AI 工具横评”,那就跑偏了。
这篇真正的主角不是 17 个工具。
而是这条“资料调研工作流”。
05它真正帮我做掉了哪些机械动作
这次最明显省下来的,不是“思考”。
而是三个机械动作。
第一,搜。
它在 58 秒里拿到 10 个来源 URL,并把来源留在 sources/links.md 里。
这一步如果人手动做,需要不断换关键词、打开结果、判断哪些链接值得看。
第二,整理。
它把分散信息放进表格里:工具名称、类型、核心能力、价格、适合人群、来源。
这类工作不难,但很磨人。
第三,写初稿。
它最终生成了 1 份 result.md,里面有一句话结论、工具分类、场景建议、新人路径、价格冲突说明和报告边界。
这对内容创作者很有用。
因为很多时候,我们不是没有观点。
而是观点之前,需要先搭一个干净的资料底座。
以前这个底座要自己慢慢堆。
现在可以让 Agent 先堆起来。
06这份结果能不能直接用
不能直接发。
至少不能当成最终结论直接发。
原因也很明确。
第一,价格信息还要人工复核。
实验记录里明确标了三个风险点:
豆包价格存在不同公开说法。
文心一言免费 / 付费口径存在冲突。
讯飞星火首月 3.9 元信息来自单一来源。
这些都不能靠 AI 一句话带过。
第二,它没有真实体验每个工具。
也就是说,它能整理“资料里怎么说”,但不能证明“我用起来就是这样”。
所以报告里的“适合谁”,只能算基于公开资料的初步判断。
如果要做正式推荐,还得人来确认。
第三,它分不清所有软文。
WorkBuddy 可以帮你找来源、做交叉验证、标出冲突。
但一篇内容到底是用户真实体验、媒体转述,还是厂商传播稿,这件事仍然需要人判断。
所以我的看法是:
这份结果适合作为初稿。 适合作为资料底座。 但不适合作为未经复核的最终报告。
07哪些地方仍然必须人工判断
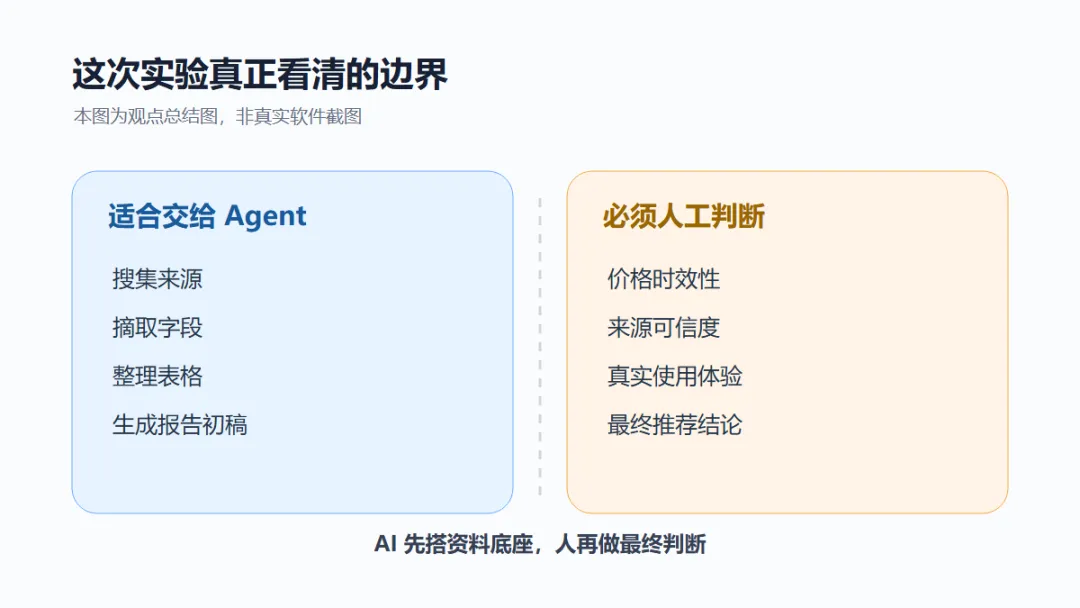
这次实验以后,我会把 Research Workflow 拆成两层。
第一层,适合交给 Agent:
搜索资料。
整理来源。
摘取字段。
做表格。
生成报告初稿。
第二层,必须人来做:
判断来源可信度。
核验动态价格。
识别软文和真实体验。
决定最终推荐口径。
这也是我觉得本次实验最有价值的地方。
它没有证明“AI 可以替你完成调研”。
它证明的是:
调研里那些重复、分散、费手的前置动作,开始可以进入 Agent 工作流。
这已经够实用了。
因为人终于可以从复制粘贴里往后退一步,把注意力留给真正需要判断的地方。
08这类 Research Workflow 值不值得交给 Agent
我的结论是:
值得交,但要交对部分。
适合交给 Agent 的任务,通常有几个特点:
资料范围比较明确。
输出格式比较固定。
需要大量收集、整理、归类。
最后允许人复核。
比如:
竞品调研。
产品资料搜集。
公众号选题研究。
工具价格对比。
行业资料初筛。
不适合直接交给 Agent 的,是那些需要最终负责的判断:
谁最好用。
谁最值得买。
哪个价格一定准确。
哪个结论可以直接指导业务。
这些都不能省。
这次 WorkBuddy 用 58 秒交出了一份 17 工具结构化报告。
它确实很快。
但更重要的是,它把“搜资料、整理、写初稿”这段机械链路接走了一大块。
剩下的,是人最该做的部分:
判断。
取舍。
负责。
我已经把这次实验里的完整 Prompt、来源筛选方法、输出模板和失败处理,整理成了一份配套实战学习资料。
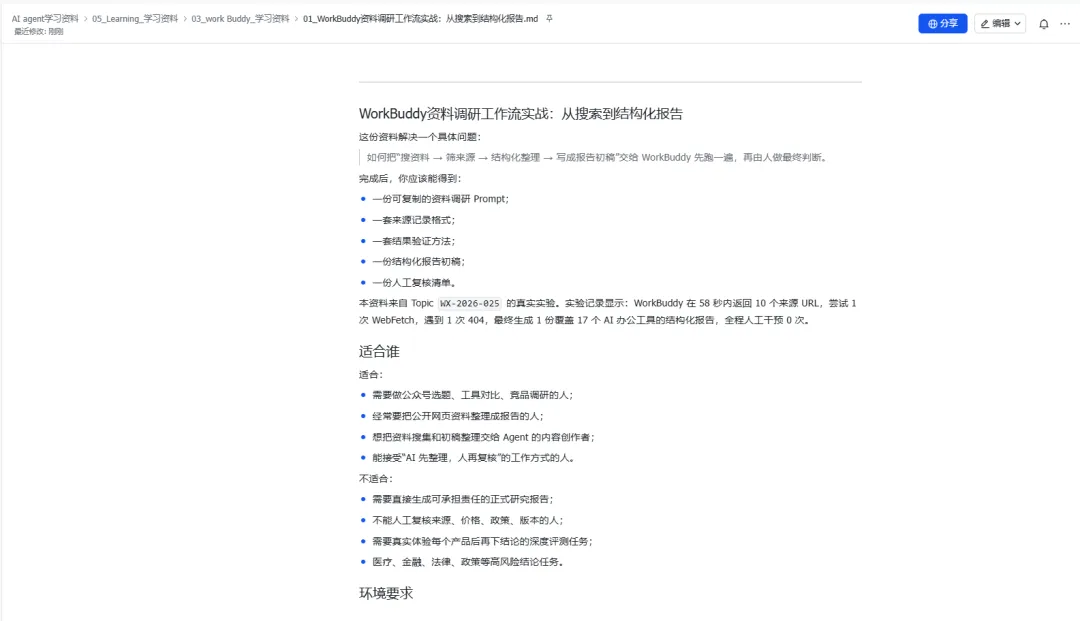
https://my.feishu.cn/wiki/R8JqwS2vTiUOEOkLebVcP7tYnFf?from=from_copylink
它不是文章复制版,而是给你照着跑的版本。
如果你也经常做资料调研,可以先从一个小任务开始:
让 Agent 找 10 个来源。
整理成一张表。
标出冲突和不确定项。
最后你只做判断。
这可能不是最炫的 AI 用法。
但对真正要干活的人来说,已经很够用了。
我是墨叔。长期折腾 AI 工具、Agent、自动化和工作流。这里不只分享“有什么 AI 工具”,更关心两件事:它到底能不能解决真实问题,以及怎么把它接进自己的工作流程。
感谢关注,下期再见!
往期推荐