ARTICLE · 1035972
AI Morning #034|Claude、Google与AWS:AI进入可控执行阶段
AI MORNING DAILY · #034
2026.09.19
早上好,这里是 AI Morning。
过去一天,AI 的新信号都在指向同一个变化:模型开始参与自己的研发,代理开始拥有共享身份和工具权限,基础设施则把隔离、主权与审计写成可交付的产品。
共同判断:AI 的下一阶段不是“更会回答”,而是“能执行、可追责、可回退”。权限、沙箱、评估与部署边界,会成为能力之外的新竞争门槛。
01|Anthropic 与 Accenture:把前沿模型评估嵌入组织内部
发生了什么:Anthropic 9 月 18 日宣布与 Accenture 合作,由 Faculty 牵头开展独立的前沿 AI 评估,包括模型评测、红队测试、对齐评估和安全措施测试。两家公司预计未来 5 年各投入至少 10 亿美元。Anthropic 还披露,嵌入式评估人员将以接近员工的权限进入组织内部工作,但具体安排仍在制定中。
为什么重要:安全评估正在从上线前的一次性审核,变成靠近研发现场的持续能力。评估者能否看到真实工具、真实权限和真实失败记录,决定了“安全”究竟是宣传语,还是能改变发布决策的工程环节。
MARKETING / BUSINESS TAKE:采购 AI 服务时,除了问模型能力和合规证书,再问三个问题:谁能独立检查、多久检查一次、触发什么阈值会暂停或回退。把评估权限、证据保留和干预机制写进合同,比泛泛承诺“负责任 AI”更有用。
Source|Anthropic,2026-09-18|官方合作公告/投入与安排为参与方披露https://www.anthropic.com/news/accenture-embedded-evaluation
02|Claude 开始量化“AI 做 AI”:能力增长也要配套监督仪表盘
发生了什么:Anthropic 发布了衡量 AI 研发进度、代理监督和算力分配的方法。截至 2026 年 8 月,Claude 已主导 Anthropic 内部约 26% 的 AI 研发工作,至少 90% 的相关工作已达到“AI 协作”或更高层级,但在已测子集里还没有达到完全自主。Anthropic 还披露,最常用的内部平台上约有 3 万个代理参与研究和工程工作;8 月在线监控覆盖率为 100%,超过 10 亿次决策中约 0.002% 被拦截。
为什么重要:这组数字不是一个新的模型排行榜,而是一块“研发组织仪表盘”:AI 到底承担了多少工作、监督覆盖到哪里、算力如何分配、异常多久被发现。Anthropic 也说明这些是内部测量,口径和范围有限,不能直接外推成整个行业的自动化比例。
MARKETING / BUSINESS TAKE:企业可以先建立自己的三项指标:AI 代做任务占比、人工复核延迟、被阻断或回退的动作比例。比起只报调用量,这三项更能回答 AI 是否真的减少等待,以及组织是否仍保有控制权。
Source|Anthropic Institute,2026-09-18|官方测量说明/内部指标与方法限制由 Anthropic 披露https://www.anthropic.com/institute/measuring-pace-of-ai-development
03|Anthropic 生命科学验证计划:高风险能力开始按身份与监督分层
发生了什么:Anthropic 9 月 17 日公布生命科学验证计划 beta。通过验证的生命科学团队可以获得更适合生物学工作的 Mythos、Opus 和 Sonnet,访问分为 Standard Use 与 High-risk Use;高风险使用需要更严格的资质、安全和伦理审查,Mythos 的高风险访问目前只向小范围团队开放。计划还包括离线监控、对标记活动保留 30 天、数据隔离,以及继续保留网络安全分类器;当前主要面向 Anthropic 第一方 API、Claude Science 和 Enterprise/Team,且不支持 BAA 组织。
为什么重要:当模型可以帮助做更专业、更敏感的工作,产品的核心不只是“开放或关闭”,而是把使用者身份、风险等级、监控方式和升级路径组合成一套访问策略。能力越强,权限就越像产品本身的一部分。
MARKETING / BUSINESS TAKE:为内部 Agent 建一张风险分层表:普通检索、专业分析、可执行建议、外部动作分别需要什么资质和批准。先让低风险任务留下完整日志,再决定是否扩大高风险权限,避免把“试用”误当成“无限授权”。
Source|Anthropic,2026-09-17|官方项目公告/验证、监控与可用范围由 Anthropic 披露https://www.anthropic.com/news/life-sciences-verification-program
04|Google CC:家庭 Agent 开始处理共享日程与共同决定
发生了什么:Google Labs 9 月 17 日扩展了实验性家庭 Agent CC,最多支持 6 名成员,每个人使用自己的 Google 账号、身份和权限。CC 可以生成共享的“Your Day Ahead”简报,连接 Calendar 与 Tasks,并在获得许可后填写报名表、登记表或用餐计划;它只对群组成员执行和回复,不会未经许可向群外分享。当前产品面向美国 18 岁以上个人账号,仍属于实验性体验。
为什么重要:个人助手正在变成小型组织助手。共享场景的难点不只是上下文更长,而是谁代表谁说话、谁能看到什么、哪些动作需要全体确认。身份、权限和“先征求同意”因此从后台设置变成用户可感知的产品体验。
MARKETING / BUSINESS TAKE:设计团队 Agent 时,不要只建一个“管理员”角色。先把成员、可见信息、可执行动作和必须确认的动作拆开;凡是涉及支付、对外承诺、隐私或不可撤回改变的动作,都保留清晰的确认节点。
Source|Google Blog,2026-09-17|官方产品说明/功能与可用范围由 Google Labs 披露https://blog.google/innovation-and-ai/models-and-research/google-labs/cc-expanding-to-groups/
05|AWS Lambda MicroVM:让自托管 Agent 在自己的隔离空间里调用工具
发生了什么:AWS 介绍了用 Lambda MicroVM 与 Firecracker 运行自托管 AI Agent 沙箱的方案。每个 Agent 会话都可以获得新的虚拟机,拥有独立的凭证、文件系统和网络边界;会话最长可运行 8 小时,支持从快照启动、暂停、恢复和终止,并可从 0.25 vCPU/0.5 GB 扩展到 4 vCPU/8 GB,而不用重新配置。AgentCore 等宿主服务负责模型编排、路由和会话状态,工具执行留在自己的 AWS 账号内。
为什么重要:Agent 的风险不只来自模型输出,也来自它调用工具时触碰到的文件、凭证和网络。把执行放进一次性、可终止、可审计的环境,意味着组织可以把“允许它做什么”进一步落实为“它在哪里做、用什么身份做、完成后留下什么证据”。
MARKETING / BUSINESS TAKE:凡是包含第三方工具、代码执行或外部数据的 Agent,默认放入短生命周期沙箱;按任务发放最小权限,隔离生产凭证和网络出口,并为暂停、终止和回放留出接口。先做边界,再追求自动化率。
Source|AWS Compute Blog,2026-09-18|官方技术发布/MicroVM 方案与限制由 AWS 披露https://aws.amazon.com/blogs/compute/running-self-hosted-ai-agent-sandboxes-with-aws-lambda-microvms/
06|AWS 欧洲主权云上线 Gemma 4:开源模型开始绑定地域与运营控制
发生了什么:AWS 宣布在 AWS European Sovereign Cloud 的 Amazon Bedrock 上提供 Gemma 4 开放权重模型。该方案强调欧盟内数据驻留、由欧盟居民运营、最小权限和默认零操作员访问/零数据保留;Gemma 4 采用 Apache 2.0 许可,提供不同规模的 dense 与 MoE 变体,并支持函数调用、多模态和兼容 OpenAI 的 Responses/Chat Completions 接口。
为什么重要:模型“开放权重”只解决了能力和许可的一部分,企业还要考虑数据在哪里、谁能操作基础设施、日志保留多久、接口迁移成本多高。主权云把地域、运营者和数据保留写成部署条件,可能成为公共部门和受监管行业采购 AI 时的默认检查项。
MARKETING / BUSINESS TAKE:做模型或云服务选型时,把模型许可、数据驻留、运营权限、保留策略和迁移接口放在同一张表里。不要把“部署在本地”直接等同于“控制权在自己手里”,先核对日志、密钥和紧急停用路径。
Source|AWS Security Blog,2026-09-17|官方云安全发布/主权云与 Gemma 4 能力由 AWS 披露https://aws.amazon.com/blogs/security/run-open-weight-models-on-aws-bedrock-in-aws-european-sovereign-cloud/
MARKETING WATCH
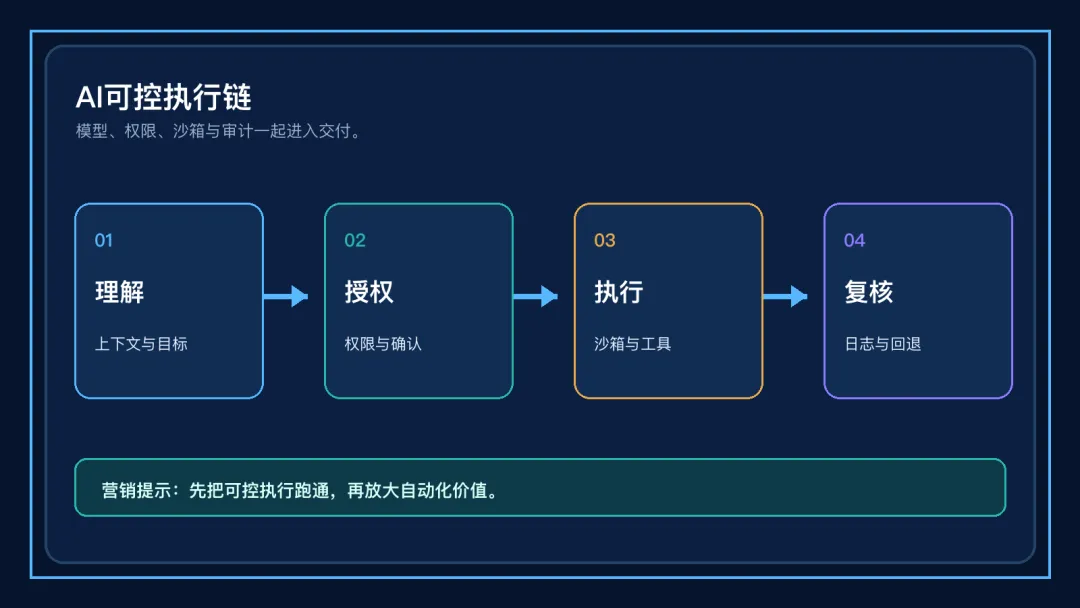
今天最相关:从独立评估、内部研发指标,到家庭 Agent、MicroVM 沙箱和主权云,AI 产品正在把“可控执行”拆成一条完整链路。营销与业务团队要准备的,不是更多模型名单,而是能被客户验证的权限、证据和回退设计。
直接影响:客户会越来越具体地追问:谁能看见数据、Agent 用什么身份行动、工具调用在哪里运行、发生异常谁能停下来。能把这些问题回答成流程图和日志样例的供应商,更容易进入真实采购。
现在可以做:选一个高频、低风险流程,保留现有路径作 A 组;B 组只增加一个受控 AI 环节。连续 7 天记录一次通过率、人工接管率、权限请求次数和最终行动,不改预算、受众和权限范围。
核心指标:合格行动率=完成目标下一步的合格任务 ÷ 进入 AI 环节的合格任务。辅助记录答案一次通过率、证据缺口、人工接管率、阻断率和每次任务总成本。
停止/调整条件:出现未经批准的外发、支付、删除、隐私数据暴露或不可撤回动作,立即回退人工;结果质量低于人工基线 10% 以上,先缩小问题和资料范围,不增加自动权限。
AI MORNING TAKE
六个信号共同说明,AI 正在从“模型能力”进入“可控执行系统”:评估负责发现问题,指标负责看清自动化边界,分层权限负责控制高风险使用,Agent 身份负责处理共享场景,沙箱负责隔离工具动作,主权云负责把地域与运营责任落到基础设施。下一阶段真正稀缺的,不是又一个更会回答的模型,而是能把动作、证据、成本和责任同时留下来的系统。
WATCH NEXT
接下来关注:① 嵌入式独立评估会不会真正影响模型发布和权限决策;② “AI 做 AI”的比例是否会从公司自报走向可复核的行业口径;③ 家庭、企业和科研 Agent 会不会把共享身份、沙箱和主权部署变成标准采购条款。
今天最值得带走的判断是:AI 的竞争优势,不只来自更强模型,而来自模型、权限、沙箱和责任能否一起运行。
今天这 6 个信号里,你最关心哪一个?
是独立评估、AI 做 AI、生命科学权限,还是家庭 Agent、沙箱与主权云?欢迎在留言区告诉我:如果只能先改一条经营链,你会从哪一步开始?
如果你希望每天早上少看一点信息噪音,多带走一点真正值得关注的 AI 与市场判断,欢迎关注 AI Morning。
每天早上 5–8 分钟,读懂 AI 与市场。
明早见。