ARTICLE · 1038794
AI组队搞科研?谷歌多智能体系统助力Gemini解决多个顶刊顶会的开放难题丨arXiv每周论文推荐
【编者按】
一道题想不明白怎么办?
多叫几个 AI,先拉个会。
但真正的科研显然不是“人多力量大”这么简单。Google Research 最新研究 《Stellar Colosseum: A Many-Agent Harness for Long-Horizon Research in Mathematics and Theoretical Computer Science》 提出多 Agent 长程科研框架 Colosseum:有人探索路线,有人专门挑错,证明可以拆开并行推进,失败方案和反对意见也不会随手丢掉,而是留给下一轮继续用。与 Gemini 3.1 Pro 结合后,系统参与取得了多个来自 FOCS、JMLR 等论文开放问题的新结果;在研究级定理证明基准 TCS-Bench 上,准确率也从直接作答的 30.3% 提升至 54.0%,进一步在两次运行间进行跨模型选择后达到 71.0%。
更多精彩论文:
2014 年图灵奖得主 Michael Stonebraker 等人提出 Chronos,让 Agent 的多条探索路径能够跨数据库、向量库和文件系统统一“开分支”,同时避免合并时出现状态不同步;
Agent 跑得越久,未必越划算。Elo-per-token 找到长程计算的“减速点”:当继续追加 Token 的边际收益低于重新开启独立探索时,也许该考虑“重开一局”;
DRAM 正面不够用了?Flip DRAM 通过正反面背靠背堆叠的 FVCT 方案,将单元面积从 4F² 推向 2F²;
机器人手里的东西什么时候开始滑?SlipSense 融合压力与高频振动触觉信号,76% 的滑动可在 23.1 ms 内检出,并实现跨机械手零样本迁移。
1. AI组队搞科研?谷歌多智能体系统助力Gemini解决多个顶刊顶会的开放难题
让大模型写一道数学题,和让它连续推进一项数学研究,并不是同一件事。真正的长程研究往往要经历路线选择、猜想验证、子问题拆解、失败返工和全局检查:前面一个隐藏漏洞,可能到几十页之后才暴露;一条失败路线里,又可能留有下一轮真正有用的线索。
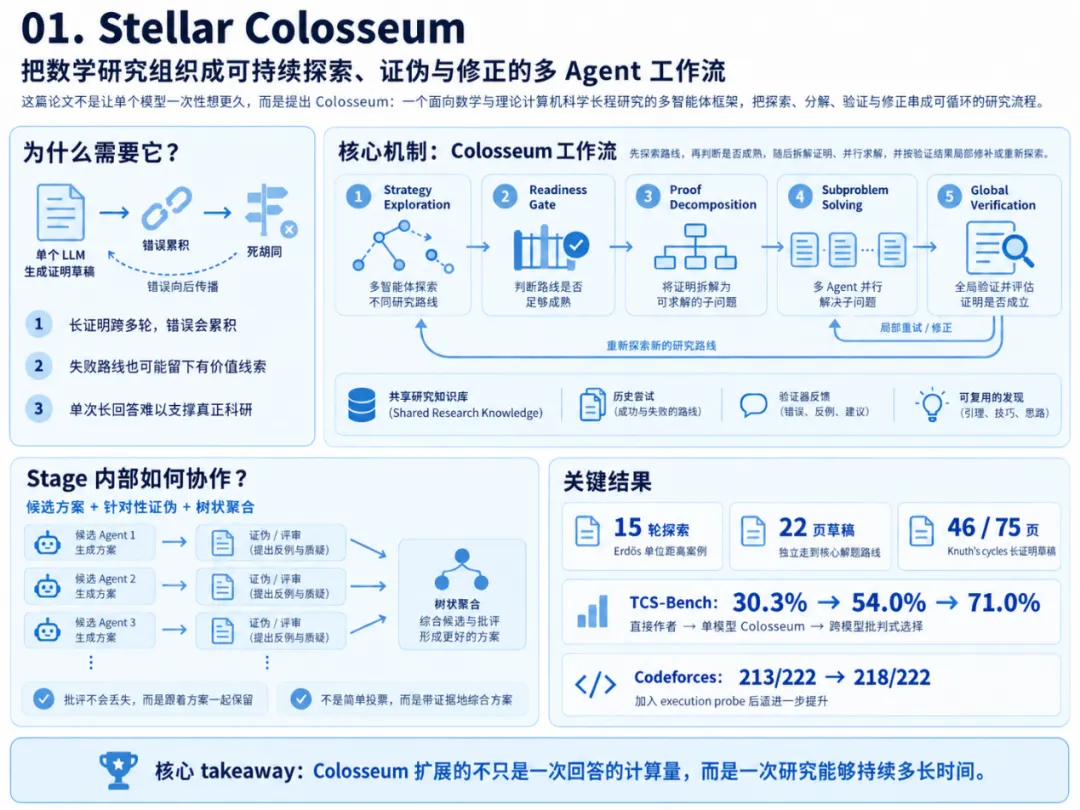
Google Research最新论文《Stellar Colosseum: A Many-Agent Harness for Long-Horizon Research in Mathematics and Theoretical Computer Science》提出了多 Agent 长程科研框架 Colosseum,试图把原本依赖研究者持续判断的探索、证伪、分解、验证与修正过程,显式组织成一个可以跨多轮运行的研究工作流。论文的核心思路,不是让单个模型一次性“想得更久”,而是让多个 Agent 围绕同一个研究问题持续协作,并把中间结果、失败路线和验证反馈保留下来,供后续研究继续使用。作者报告,Colosseum 与 Gemini 3.1 Pro 结合后,参与取得了多项针对 FOCS、JMLR 等论文开放问题的新结果。
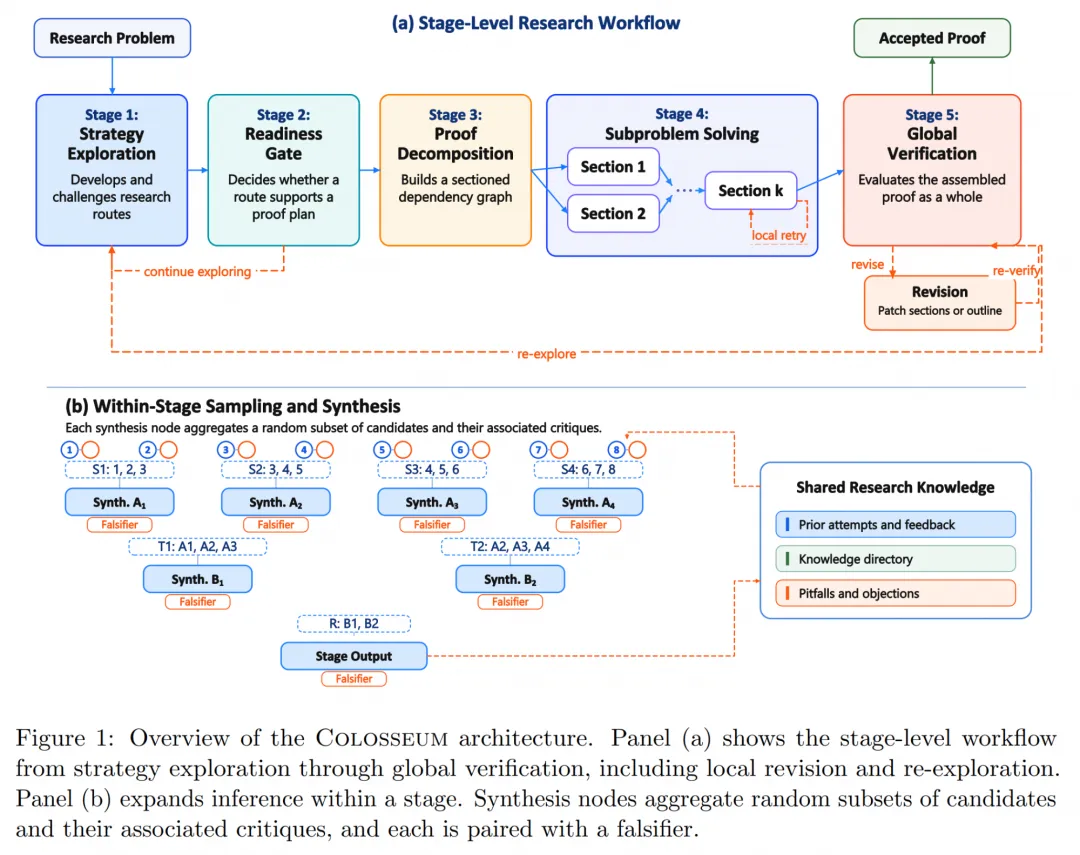
它首先改变了模型处理长证明的方式。Colosseum 不会拿到问题后立刻开始写证明,而是先进行 Strategy Exploration,同时探索并挑战多条研究路线;只有当一条路线通过 Readiness Gate、已经具体到足以支撑完整证明时,系统才会进入下一步。随后,它把证明拆成带有依赖关系的 section-level 子问题,能够并行的部分分别推进,再由全局验证器检查最终组合起来的证明。如果只是局部出错,就回到对应章节修补;如果问题已经动摇核心路线,则重新开启探索,而不是在错误方向上继续堆叠推理。
但“多 Agent”并不只是多生成几份答案再投票。对于策略、证明骨架、局部证明乃至最终验证,Colosseum 都会先生成多个候选,再让专门的 falsifier 主动寻找反例、错误推导、循环论证、遗漏假设或目标错位。更关键的是,这些批评不会随着候选被淘汰而消失,而是始终和原方案绑定,再通过重叠随机采样的树状聚合逐层综合。也就是说,系统不仅保存“什么可能是对的”,也保存“哪里可能是错的”。
这种机制还配合了一层跨轮次的研究记忆。上一轮失败的完整证明和 verifier 反馈会直接留给下一轮;共享 knowledge directory 则继续保存更广泛搜索中产生的可复用结论。于是一次失败不再等于从零开始,而可以成为后续研究的一部分。
论文给出的案例也很能体现这种“长程”能力。在 Knuth’s cycles 问题上,系统最终生成了两份分别长达 46 页和 75 页的证明草稿,作者用它说明:远超单次模型输出长度的证明,可以被维护成一个具有显式依赖关系、可以持续修订的研究文档。
另一个更有意思的案例是 Erdős 单位距离问题。研究者关闭 Gemini 3.1 Pro 的互联网访问,让 Colosseum 独立推进;系统经历 15 轮探索,持续携带此前的部分结果、反对意见和失败尝试,最终形成一份 22 页草稿,并独立走到了此前 OpenAI 方案的核心架构。这并不能简单等同于“重新解决了一遍问题”,但它提供了一个很直接的例子:多轮研究状态确实可以跨较长时间保持并继续演化。
论文随后又用标准化评测检验,这种复杂工作流是否真的比直接调用模型更有效。
研究级定理证明:30.3% → 54.0% → 71.0%
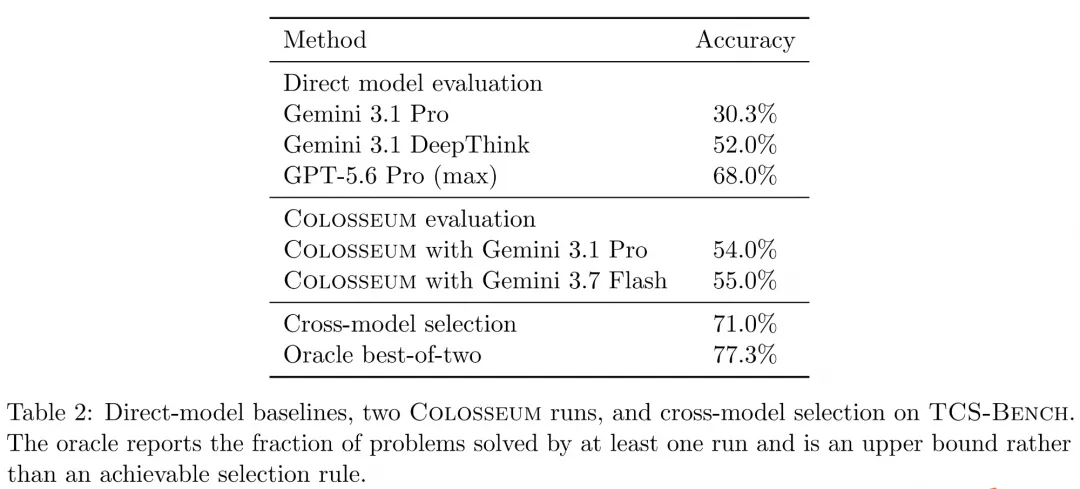
在包含 300 道来自 FOCS、STOC 和 SODA 论文的研究级定理证明任务的 TCS-Bench 上,Gemini 3.1 Pro 直接作答准确率为 30.3%;使用 Colosseum 后提升到 54.0%。进一步让 Gemini 3.1 Pro 与 Gemini 3.7 Flash 分别运行 Colosseum,再利用批判结果在两份证明之间选择,准确率达到 71.0%。两次运行中至少有一次正确的 oracle 上限为 77.3%,说明不同运行之间确实存在明显的错误互补。
从证明迁移到代码:213/222 → 218/222
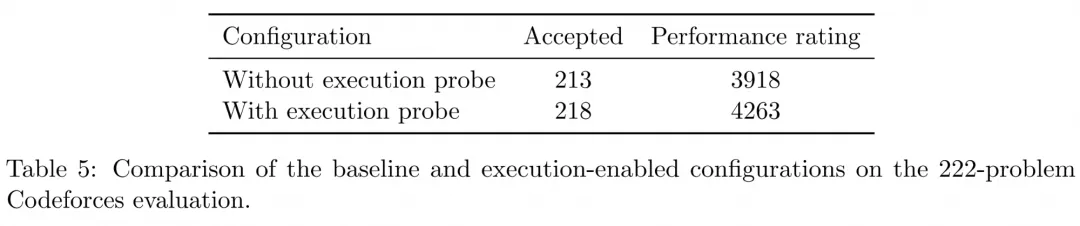
作者还把几乎同一套“探索—分解—验证—修正”结构搬到了 Codeforces,只额外加入一个 C++ execution probe,让程序在公开样例和模型生成的压力测试上实际运行,再把报错、时间和内存信息送回修正环节。在 222 道题上,不使用执行反馈时通过 213 道,加入执行探针后通过 218 道。
因此,Colosseum 最值得关注的并不是“堆了更多 Agent”,而是它把研究过程中何时探索、何时收敛、如何拆问题、如何保存失败、以及何时推翻已有路线都显式做成了推理流程。它试图扩展的已经不只是一次回答的计算量,而是一次研究能够持续多长时间。
不过,这也留下了一个重要边界:当前系统的候选数量、树状聚合宽度和采样次数等配置仍主要在运行前固定。作者明确指出,未来需要让计算预算根据未解决异议、局部失败和候选一致性动态分配,并通过 compute-matched evaluation 区分收益究竟来自更聪明的计算分配,还是单纯使用了更多推理计算。
标题:Stellar Colosseum: A Many-Agent Harness for Long-Horizon Research in Mathematics and Theoretical Computer Science
作者:Honghao Lin, David P. Woodruff, Yuan Deng, Jieming Mao, Song Zuo, Vahab Mirrokni
作者单位:Google Research; Carnegie Mellon University
摘要:语言模型可以生成看似合理的简短证明,但在长期研究问题上可能仍然不可靠,因为这类问题的进展依赖于一系列不确定且相互依赖的决策。我们提出了Stellar Colosseum,这是一个与模型无关的工具,用于在数学和理论计算机科学的研究中分配推理任务。Colosseum在构建证明之前探索替代策略,使用“准备度门”来决定何时某条路径已足够成熟以进行分解,将证明计划表示为相互依赖的章节级子问题,并将验证器的发现反馈到论证中受影响的部分。在这些阶段中,它并行生成候选方案,通过有针对性的证伪对其进行攻击,并通过重叠随机采样树聚合将候选方案及其批评意见整合为单一的研究成果。Colosseum的工作流程已集成到Google Antigravity的Teamwork框架中,作为“长证明模式”。
我们通过开放式研究和在定理证明与竞赛编程基准上的评估,展示了Colosseum的能力。使用Colosseum与Gemini 3.1 Pro,我们获得了若干新成果,解决了来自FOCS和JMLR等顶级会议论文中提出的开放性问题。在TCS-Bench(一个从FOCS、STOC和SODA等会议论文中提取的研究级定理证明任务基准)上,Colosseum使用Gemini 3.1 Pro和Gemini 3.7 Flash实现了71.0%的准确率。在另一项使用Gemini 3.1 Pro的Codeforces评估中,以证明为导向的流程结合执行反馈,成功解决了222个问题中的218个。
论文链接:https://arxiv.org/pdf/2609.15983
2. Agent并行探索,Chronos如何统一跨存储分支?
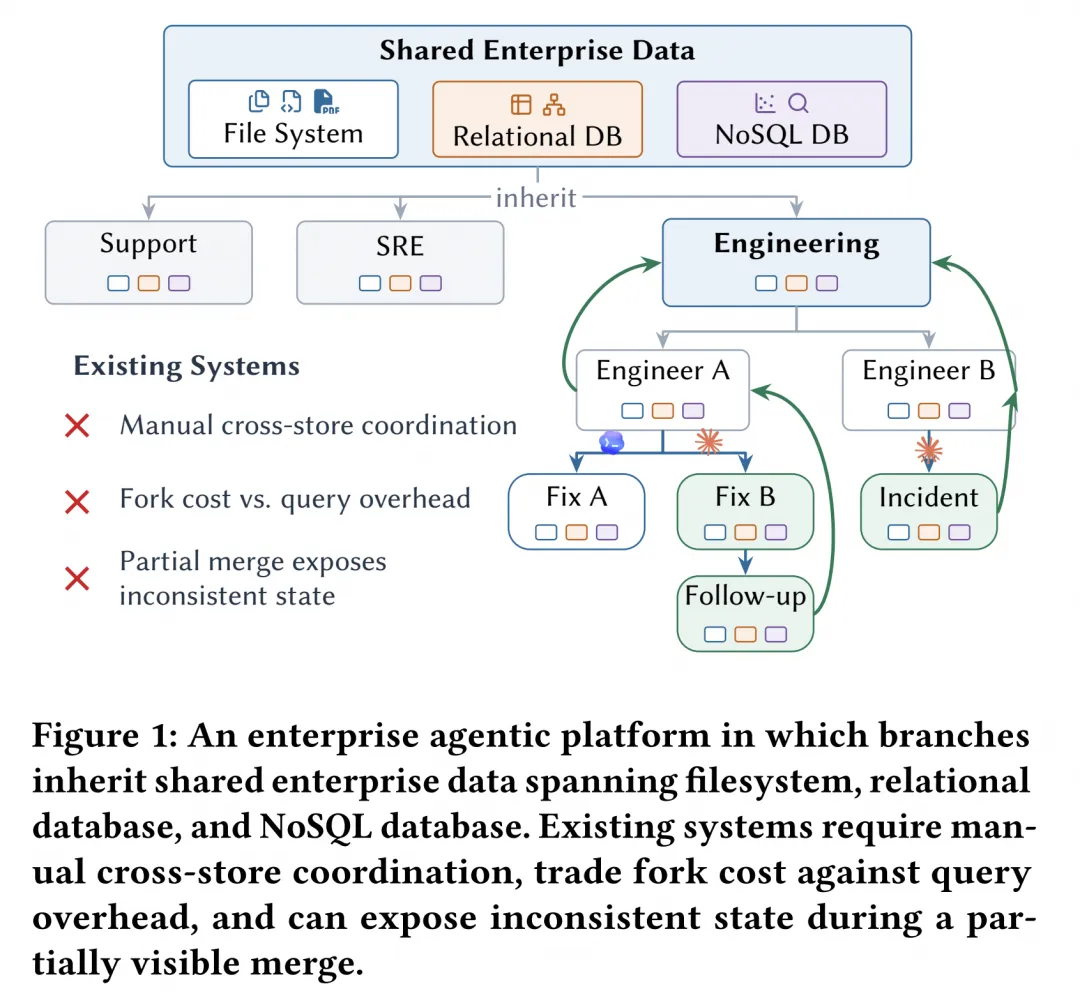
工具调用Agent的一次探索,往往不只修改代码。它可能同时改动文件、数据库记录和向量索引,再从多条候选路径中选出一个结果。如果这些状态分别创建分支、分别合并,就可能出现向量索引已经指向新文档,文件系统里却还看不到该文档的中间状态。
2014年图灵奖得主、数据库系统先驱Michael Stonebraker等人的最新研究《Chronos: Efficient Bolt-On Branching Across Data Stores for Stateful Agentic Applications》,如何让一次Agent探索拥有横跨异构数据存储的统一分支,又不必复制整套数据或改造各个存储引擎。
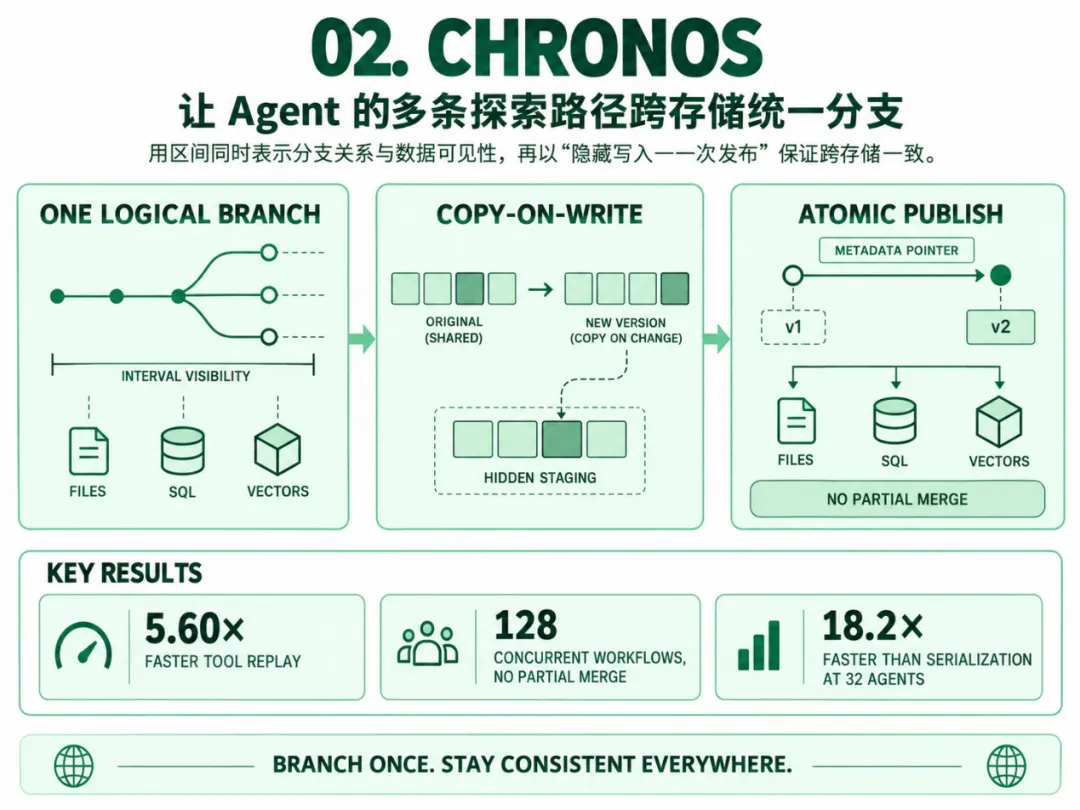
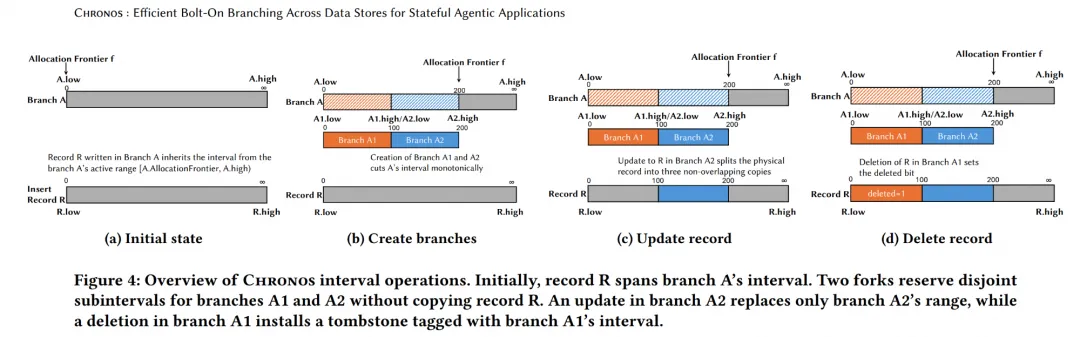
Chronos的第一个关键,是用同一套区间同时表示“分支关系”和“数据可见性”。
系统为每个分支分配一个半开区间,子分支占用父分支区间中的一段;每条物理记录也附带自己的可见区间。读取某个分支时,系统只需判断该分支的读取点是否落在记录区间内,即执行类似low ≤ f < high的过滤条件。
由于子分支的读取点天然落在父分支已有记录的可见范围内,fork时只需创建少量元数据,不必复制数据;无论分支嵌套多少层,查询也不用沿着祖先链逐层回溯。
真正发生修改时,Chronos才进行记录级写时复制。假如子分支更新了一条继承自父分支的记录,系统不会覆盖原值,而是切分其可见区间:父分支及其他子分支继续看到旧版本,当前分支对应的区间则指向新版本或删除标记。这样,未修改的数据能够在分支间共享,查询路径也保持为固定长度的区间谓词。不过,代价更多体现在写入侧的版本碎片与索引维护:大量兄弟分支修改同一热点记录时,会产生更多物理版本;不过在论文测试规模下,读写延迟仍基本稳定。
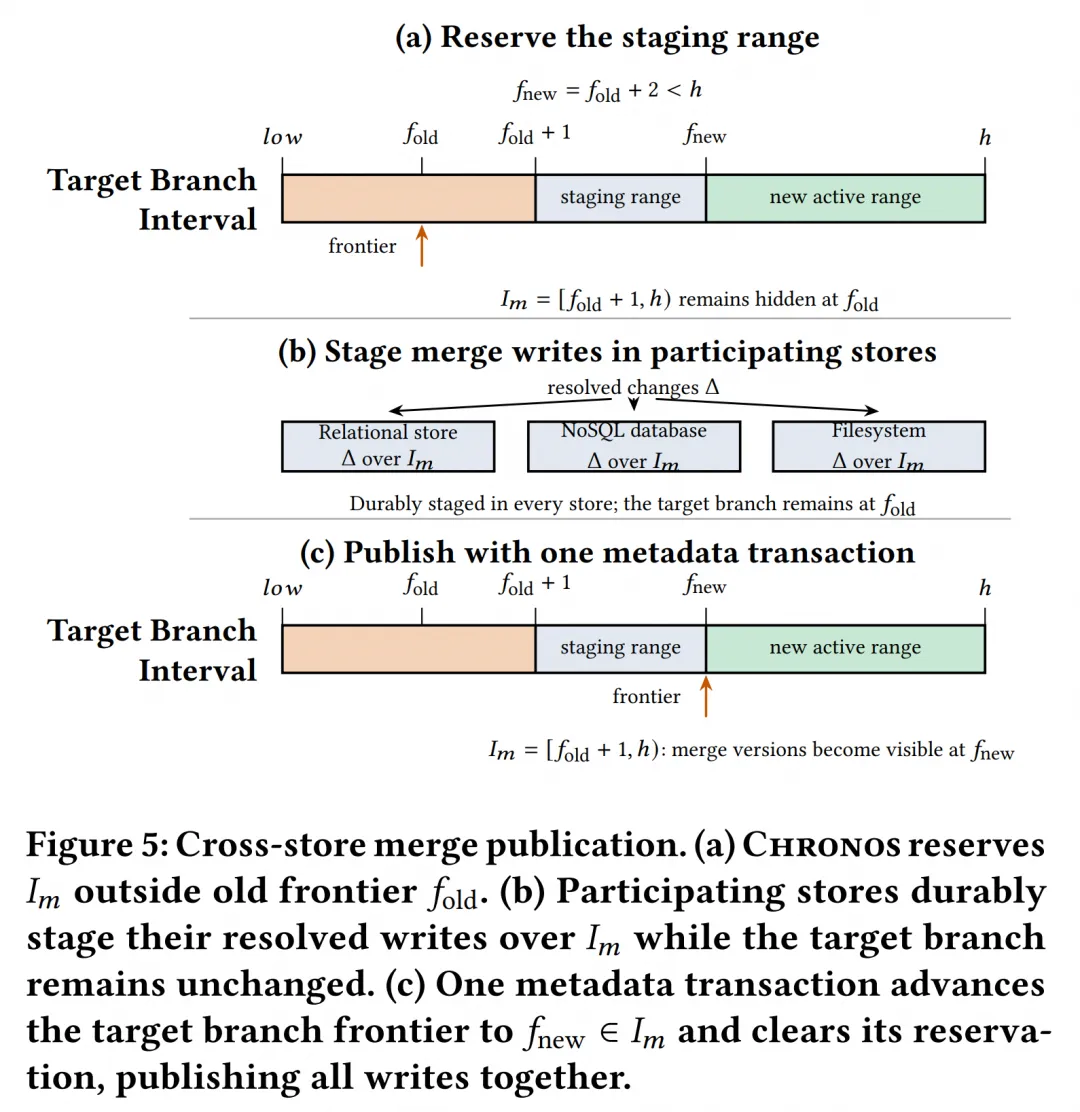
第二个关键,是把跨存储合并变成“先隐藏写入,再一次发布”。
Chronos并不要求PostgreSQL、DuckDB、Qdrant或文件系统原生支持同一种分支与事务机制,而是在各个存储前增加查询重写和版本管理层,并通过一个事务型关系数据库集中维护分支元数据。
合并时,系统先比较源分支、目标分支与共同基线,再由Agent、用户或应用策略处理语义冲突。确定合并结果后,Chronos分别向关系数据库、向量库和文件系统写入新版本,但先把这些结果放在目标分支当前读取点之外的隐藏区间中。
只有当所有存储都确认写入已经持久化,系统才通过一次元数据事务移动目标分支的读取点,让各个存储中预先写好的版本同时对读取者可见。如果某个存储写入失败,读取点就不会移动,其他存储中已经暂存的版本也继续保持隐藏。因此,Chronos提供的不是各个引擎在物理层面同时提交,而是面向读取者的跨存储原子可见性。
实验从四个层面检验Chronos:它是否更快、能否保证一致性、能否支撑高密度分支,以及为此付出多少代价。
真实Agent工作流:在约62.8万份文档、1070万个索引分块组成的语料上,Agent需要跨文件系统、关系数据库和Qdrant完成代码修复、证据检索、记忆写入与结果合并。11个工作流中,Chronos的工具调用回放时间相比Doltgres、Btrfs与分支感知Qdrant组成的基线,几何平均快5.60倍。计入模型推理后,端到端提升缩小至1.40倍,因为模型推理已占Chronos总时间的91%。
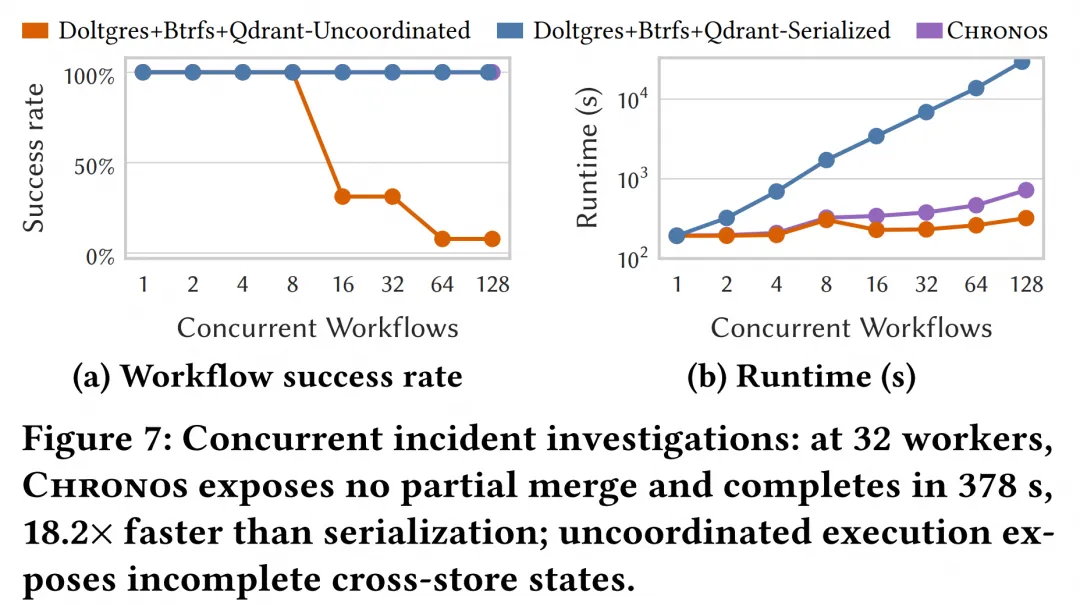
并发一致性:在故障调查工作流中,Chronos扩展到128个并发任务时仍未暴露部分合并;未经协调的基线从4个并发开始出现一致性违规,16个并发后开始向读取者暴露不完整状态。这直接验证了“隐藏写入—统一发布”机制的作用。
并发与分支效率:全局锁虽然也能避免不一致,却会把工作流串行化。32个Agent下,全局锁方案耗时6876秒,Chronos仅需378秒,快18.2倍。在分支密集的BranchBench MCTS工作流中,Chronos又分别比Doltgres和基于Btrfs克隆PostgreSQL的方案快6.0倍和16.7倍。
版本化代价:相比未版本化系统,Chronos在PostgreSQL上的吞吐下降1.18–1.75倍,DuckDB TPC-H平均变慢1.12倍,Qdrant在0.99召回率下变慢1.34倍。它以一定的单存储性能成本,换取了跨存储分支与原子可见性。
标题:Chronos: Efficient Bolt-on Branching Across Data Stores for Stateful Agentic Applications
作者:Xinjing Zhou, Jason Mohoney, Samuel Madden, Michael Stonebraker, Lei Cao
作者单位:MIT CSAIL; University of Arizona
摘要:以数据为中心的应用程序越来越多地使用推测执行来探索多个候选路径,每条路径都会修改分布在异构数据存储中的状态。随着工具调用代理的兴起,这一趋势进一步加剧。因此,应用程序需要能够快速创建分支、隔离状态修改路径,并在不产生大量查询开销的情况下,跨存储一致地合并更改的数据系统。现有系统仅提供部分支持,迫使应用程序手动协调分支和合并,这不仅增加了开销,还可能导致跨存储状态的不一致。
为解决这一问题,我们提出了Chronos,这是一个附加系统,可在异构数据存储之间提供分支能力。我们做出了两项贡献。首先,Chronos引入了一种紧凑的基于区间的版本控制技术,通过简单的查询重写实现高效的分支和数据共享。其次,Chronos采用了一种附加架构,将分支管理与每个存储内的数据路径分离。结合基于区间的版本控制,这种分离为合并操作提供了原子性的跨存储可见性,并使Chronos无需修改存储引擎即可支持多种数据存储。
我们为PostgreSQL、SQLite、DuckDB、Qdrant以及一个基于DBMS的文件系统实现了Chronos。我们通过跨存储代理工作流、MCTS风格的探索以及单存储基准测试对其进行了评估。Chronos在执行MCTS风格探索时,速度比现有方法快达16.7倍,同时保持了底层存储的实用查询性能。在并发跨存储工作流下,Chronos能够防止部分可见的合并操作,同时显著优于串行执行。
论文链接:https://arxiv.org/pdf/2609.14889
3. 跑得越久,越该“重开”?Elo-per-token 找到Agent长程计算的拐点
给Agent更多token,通常能得到更好的答案;但这不等于继续同一条轨迹就是最有效的计算方式。随着上下文不断积累,Agent可能反复修补已有方案,却越来越难回头更换核心思路。
最新论文《When Agents Slow Down: Understanding LLM Agents’Test-Time Strategies via Elo-per-token Analysis》,研究的不是“性能还会不会上涨”,而是一个更具体的问题:新增token带来的边际收益,什么时候已经不如重新开启一次独立探索?
第一步,是给Agent的长程进展建立一条可比较的刻度。
论文选择GPU内核优化、启发式编程和机器学习研究等开放式任务。这类任务允许Agent反复提交方案,每次都获得连续分数,因此可以记录“消耗多少token时,最好方案达到什么水平”。但不同任务的分数单位差异很大,同一任务中,从50分升到60分也未必与80分升到90分同样困难。
文章提出Elo-per-token:不直接比较分差,而是把不同token预算下的历史最佳方案两两对战,由分数更高者获胜,再用Bradley–Terry模型汇总成Elo曲线。这样,Kimi Code、Codex、Claude Code和Gemini CLI在不同任务中的进展可以被放到同一个相对尺度上。
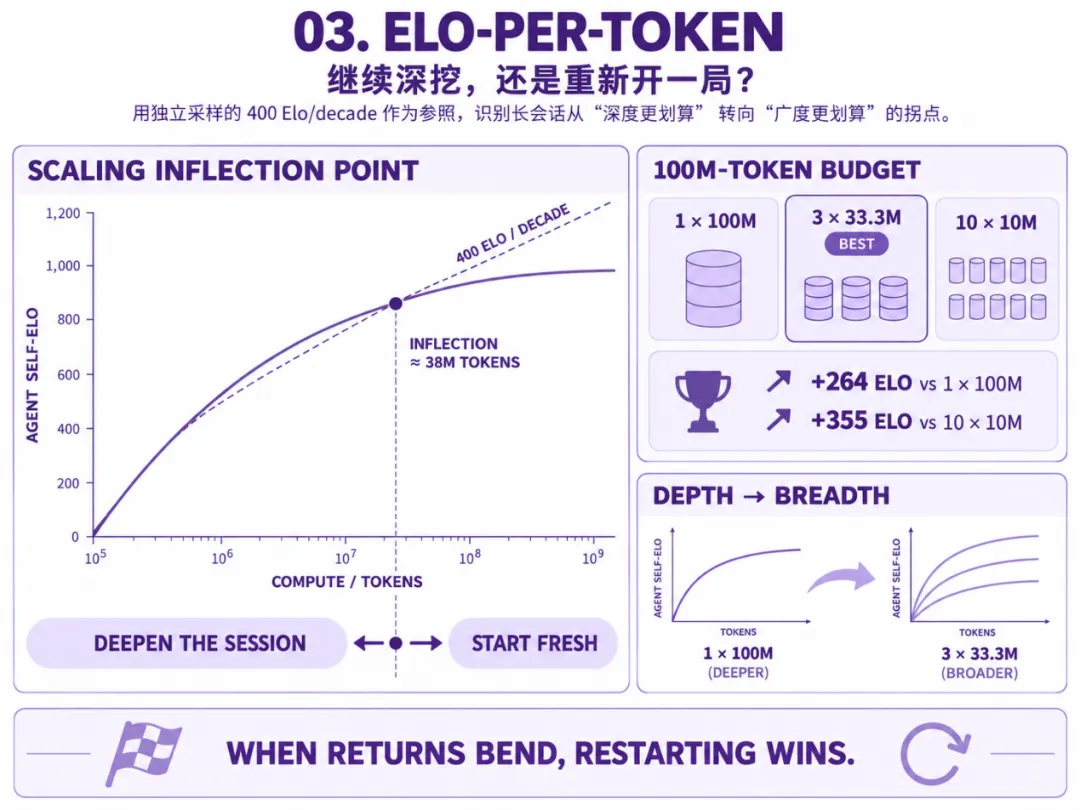
论文为这条曲线建立了一个理论参照:在独立尝试得分服从 i.i.d. 连续分布、且每次尝试 token 成本相同的理论设定下,如果把预算用于彼此独立的多次尝试并保留最好结果,那么预算每扩大10倍,Elo恰好增加400分;这一参考斜率与具体分数分布无关。因此:
曲线斜率高于400,说明继续当前会话比独立采样更有效;
低于400,则说明继续当前会话的边际效率已经低于独立采样参考;在论文的理论假设下,长期看把更多计算分给独立会话会更有利。
实验发现,Agent早期确实会“利用经验”,但这种优势没有持续下去。
作者在FrontierCS、ALE-Bench、MLS-Bench和FlashInfer-Bench的14个任务上测试四套通用Agent,每个“Agent—任务”组合运行5次,每次最多消耗1亿token。所有系统的最好结果都随预算增加而提高,但Elo曲线呈现出相似形状:早期部分Agent的局部斜率超过400,表明工具反馈、上下文记忆和迭代修改确实比盲目重试更有效;随着会话延长,边际收益逐渐下降,在汇总结果的最大预算附近,四套系统均落到独立采样基线以下。这里的结论不是“长会话不再进步”,而是继续追加token虽然仍可能改进方案,却已不如把这些token交给新的独立会话划算。
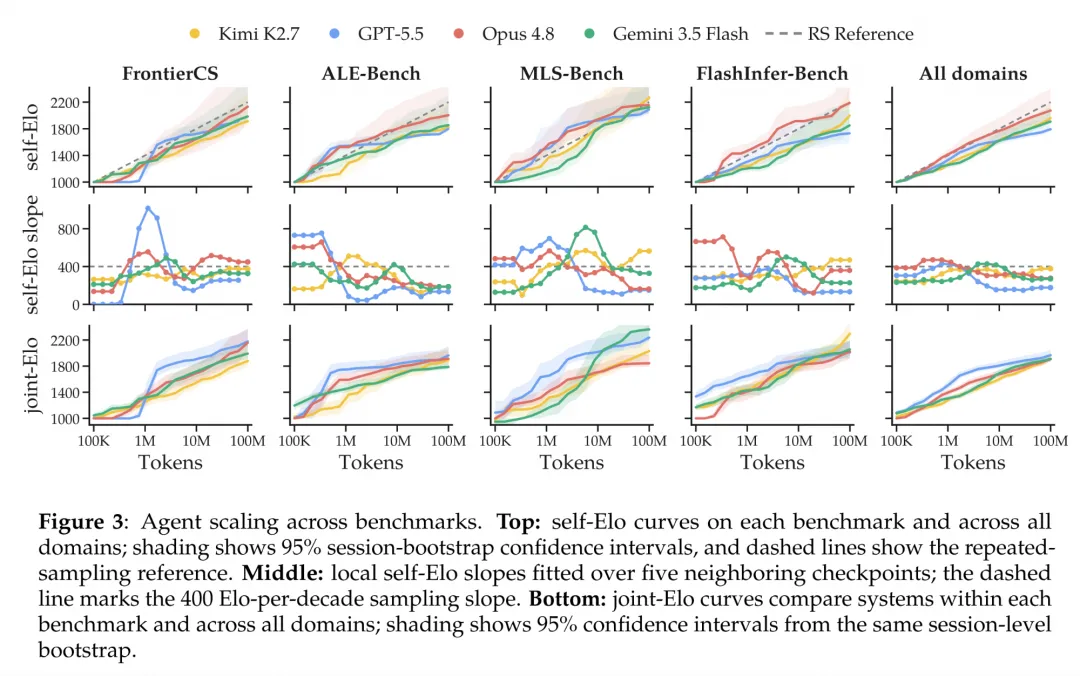
这也不只是某个通用Agent框架的问题。作者进一步测试了演化程序的AdaEvolve、演化提示词的GEPA,以及更新模型参数的TTT-Discover。它们都在早期获得更高效率,却同样没有维持超线性增长:AdaEvolve和GEPA相对普通Agent的领先随预算增加而缩小,TTT-Discover的Elo斜率也最终回落到独立采样参照附近。这组控制实验说明,现有外循环优化和测试时训练至少在本文设置下,仍未改变长期边际收益递减的形状。
与Agent形成对照的是AtCoder启发式竞赛中的历史人类选手。论文汇总7场长赛的提交轨迹后发现,顶尖选手在对数时间轴上的Elo曲线反而呈凸形:越到后期,新增一倍时间带来的进步越大。在采用同一评测器、按真实时间对齐的AHC014上,两种Agent在多日运行中逐渐变平,而Top-10人类选手继续提升并最终超过它们。
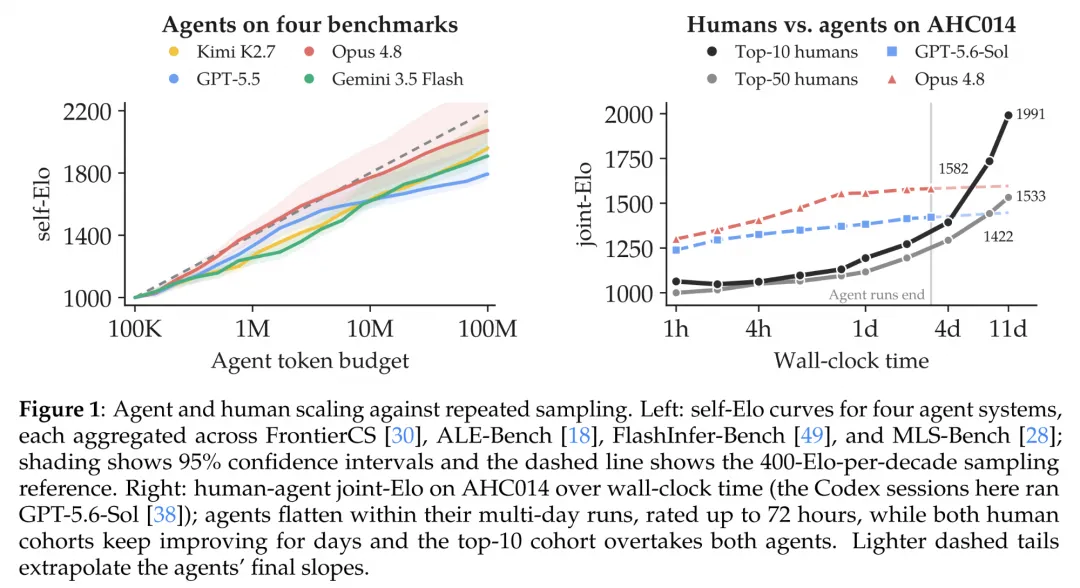
作者将其视为长程持续学习的证据:人类不仅在已有方案附近搜索,还可能从反馈中形成新的问题理解。不过,“Agent被早期方案困在某个搜索盆地”仍是论文提出的解释性假设,并非实验直接证明的内部机制。
这个“减速点”还能直接指导计算预算怎么分。
论文把Agent曲线最后一次从高于400降到低于400的位置定义为缩放拐点。在FrontierCS的Polyomino Packing任务上,Kimi K2.7的拐点约为3800万token。因此,面对1亿token总预算,规则预测的方案不是全部投入一次会话,也不是切成大量短会话,而是运行3个各约3330万token的独立会话。结果显示,三会话方案比单个1亿token长会话高 264 Elo,比10个1000万token短会话高 355 Elo,并在六种候选分配中表现最好;MLS-Bench上的复现实验也显示,中间数量的会话优于两个极端。
这套结论目前建立在具有确定性连续评分、能够频繁提交并获得反馈的开放式任务上,未必能直接外推到只有最终成败信号的Agent任务;Elo只使用方案之间的顺序,也会舍弃原始分数差距。除AHC014外,人类与Agent的主要曲线还分别使用比赛时间和token作为横轴,更适合比较曲线形状,而非直接比较计算效率。
标题:When Agents Slow Down: Understanding LLM Agents' Test-Time Strategies via Elo-per-token Analysis
作者:Kaiyuan Liu, Qiuyang Mang, Bo Peng, Wenhao Chai, Hanchen Li, Shreyas Pimpalgaonkar, Luke Zettlemoyer, Alex Dimakis, Alvin Cheung
作者单位:UC Berkeley; University of Washington; Princeton University; Bespoke Labs
摘要:大型语言模型(LLM)代理在修订解决方案、使用工具、探索替代方案以及决定何时停止时,会自适应地分配测试时的计算资源。这种测试时策略使得很难衡量代理性能如何扩展。我们研究了开放式任务,这些任务为中间提交提供连续评分,从而在整个长时间轨迹中观察到进展。我们提出了每token Elo分析方法,该方法跟踪每个token预算下找到的最佳解决方案,并使用Bradley-Terry模型将任务内的排序汇总为跨不同评分尺度的任务的Elo评分。我们将其应用于四个通用代理在四个开放式基准测试上(每次会话最多1亿个tokens),以及三个反馈驱动的LLM优化框架在受控的单任务干预中。独立采样提供了一个理论上可表征的参考,其Elo评分随计算对数线性增长。与该参考相比,代理最初可以将token转换为Elo的速度比独立采样更快,但其边际收益逐渐减少,最终低于参考值。相比之下,历史上最强的参赛人类选手在共享的AtCoder启发式竞赛任务上,其成绩随竞赛时间呈超线性增长,这表明人类选手在竞赛后期仍能持续学习,并且存在显著的提升空间。我们将扩展拐点定义为每会话预算中边际Elo收益与独立采样参考值相等时的点。以该点作为每会话预算,我们在FrontierCS多联骨牌填充任务上将1亿个token分配到并行会话中,相比一个长会话,我们获得了+264的Elo提升,而相比十个短会话,我们获得了+355的提升。
论文链接:https://arxiv.org/pdf/2609.15309
4. 一片晶圆正反两面都用上:Flip DRAM方案把4F²推向2F²
DRAM继续缩小,难点已经不只是把晶体管做得更窄。传统6F²结构正在逼近工艺与寄生极限,4F²垂直沟道晶体管虽然进一步压缩了面积,却仍只利用晶圆正面。本篇论文提出的思路很直接:把晶圆翻过来,让背面也成为存储单元和互连结构的一部分。
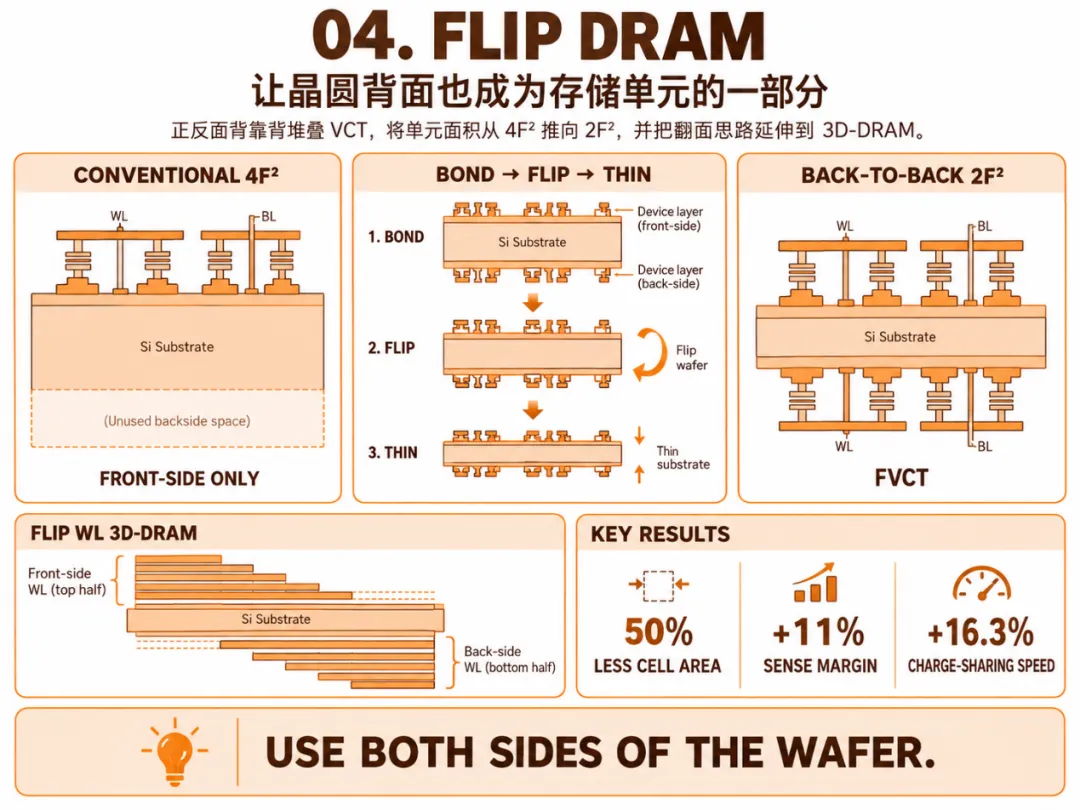
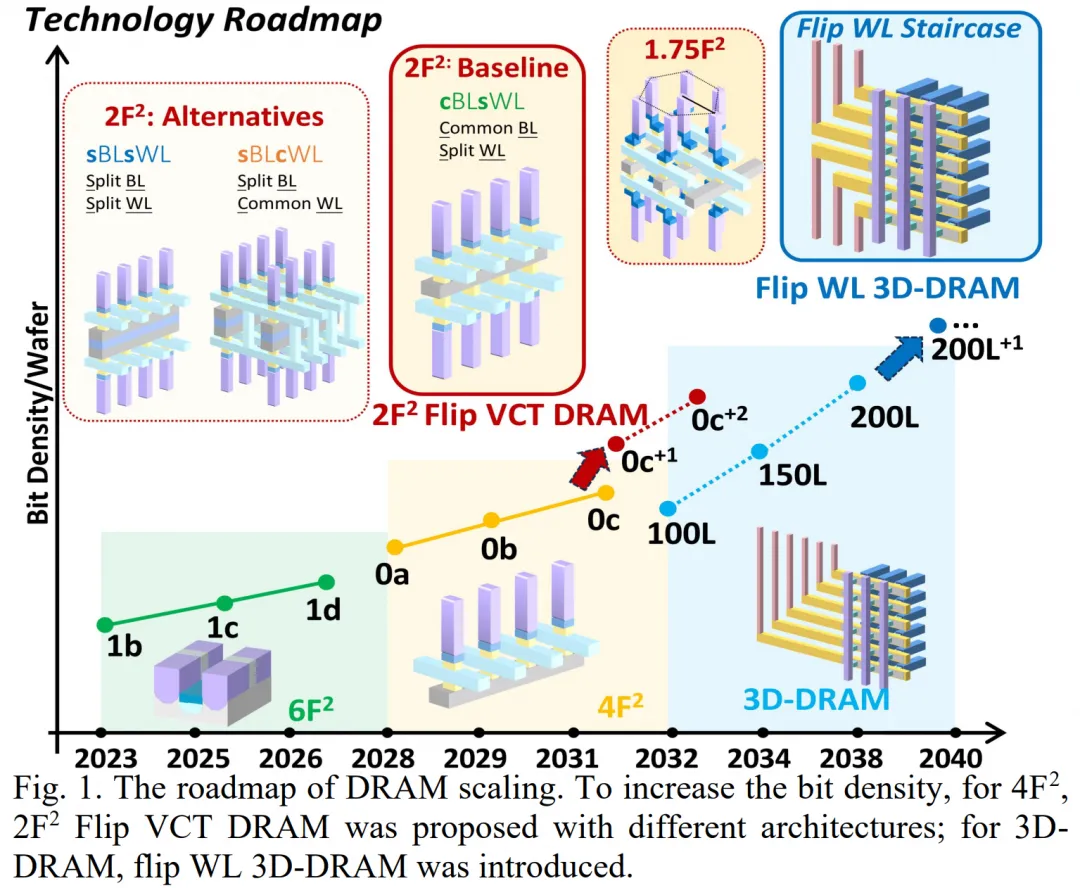
把两组1T1C单元背靠背叠在同一片晶圆上。论文提出2F² Flip VCT:正面和背面各形成一组垂直沟道晶体管与电容,两组单元在垂直沟道底部相接。完成正面单元后,研究者通过晶圆键合、翻转和衬底减薄暴露背面,再加工第二组单元。由于正、背两侧的字线分别形成,无需在两次曝光之间进行精确对准;位线也通过自对准工艺形成;在 split-BL 方案中,正、背面的两条 BL 分离但保持自对准。
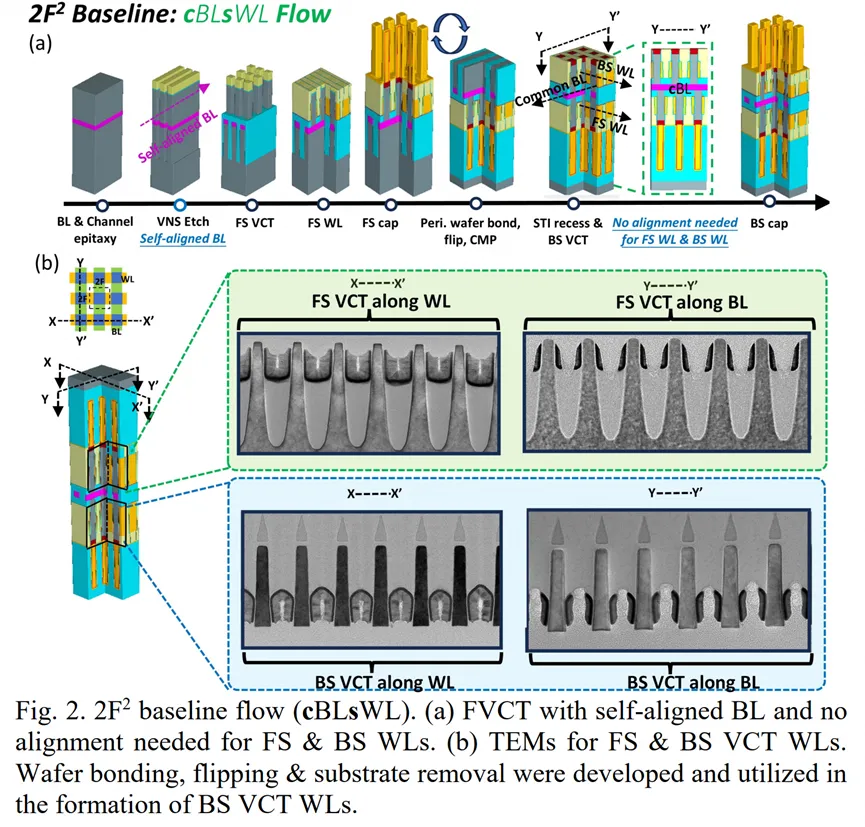
针对翻转工艺可能带来的热预算和套刻问题,作者还设计了“电容最后形成”的流程:先在正面单片形成上下两层 VCT 及正面电容,再翻转形成背面电容,避免已经完成的电容经历后续晶体管高温工艺。论文展示了高宽比约1:20的垂直纳米片刻蚀、低电阻钴存储节点、自对准位线和字线等关键模块,并给出了相应TEM结果。把单元密度、互连方式和芯片性能放进同一套DTCO框架,而不只证明结构能够制造。文章比较了三种正背面连接方案:共用位线、分离字线的cBLsWL;位线和字线均分离的sBLsWL;以及分离位线、共用字线的sBLcWL。不同方案分别在寄生、噪声、读写速度和阵列布局上取舍,其中cBLsWL整体表现最好:它将位线长度缩短50%,按每个存储单元折算的位线寄生降低27.5%,理想感知裕量比4F²结构提高11%,电荷共享速度提高16.3%,同时把单元面积从4F²减至2F²。
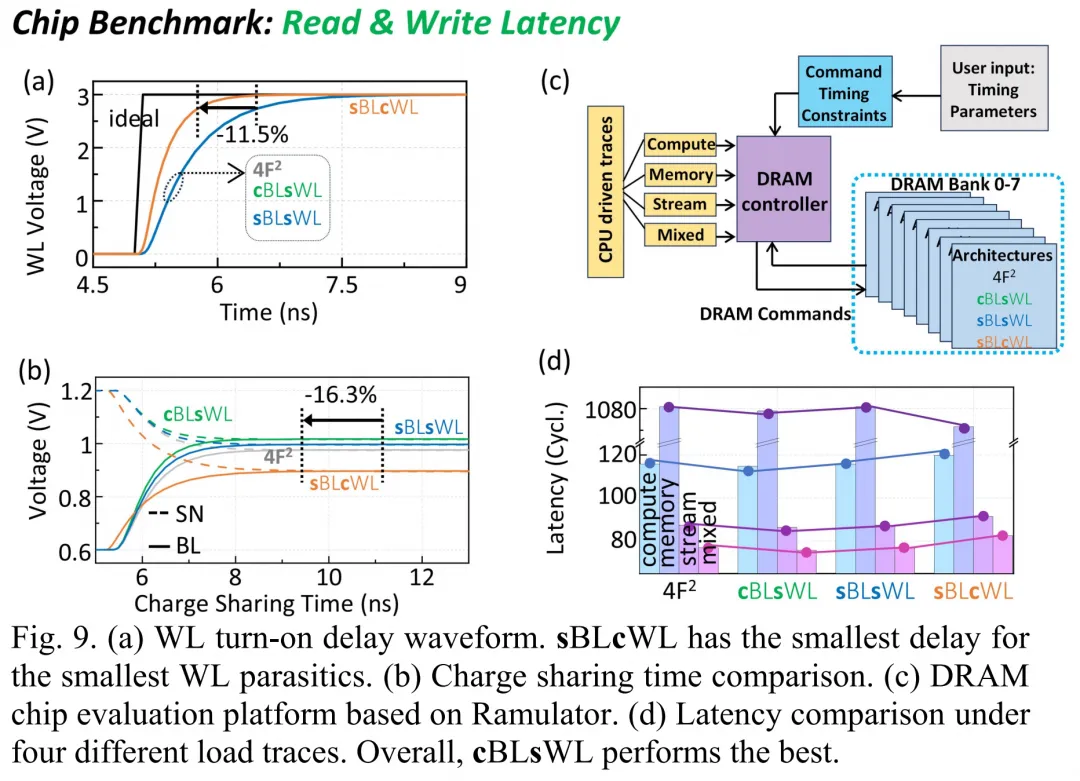
这套结论不是只来自器件级估算。论文先用神经网络拟合VCT的SPICE模型,误差低于0.95%;再通过工艺仿真与寄生提取建立不同阵列尺寸的RC模型,并外推到1024×1024阵列;最后把字线延迟和电荷共享时间输入Ramulator,在计算、流媒体、内存和混合负载下评估芯片级延迟。结果显示,cBLsWL在四类负载中整体最优;sBLcWL虽然拥有最快的字线开启和写入速度,但噪声和读取性能较差,因此整体延迟表现并不占优,仅在频繁切换行的 memory workload 中最好。
论文还把“翻面”延伸到了3D-DRAM。垂直位线3D-DRAM需要用面积较大的字线阶梯连接不同层,堆叠越多,阶梯对密度收益的侵蚀越明显。Flip WL方案把一半字线阶梯移到晶圆背面,并在正、背两侧分别布置子字线驱动器。评估中,该设计将字线阶梯面积减半,带来约25%的密度提升、15.1%的字线开启加速和6.8%的电荷共享时间下降。作者还提出用正交VCT与六边形电容布局进一步达到1.75F²,但这一部分主要是结构设计与仿真评估。
标题:First Demonstration of Flip DRAM from Process, Architecture to System to Push DRAM Scaling beyond 4F2: 2F2 Self-aligned Flip Vertical Channel Transistor (FVCT) DRAM and Flip WL (FWL) 3D-DRAM
作者:Yu Liu, Xinyue He, Yanbang Chu, Siyuan Liu, Jianxiang Jin, Fangcheng Sun, Yuyang Qiao, Xu Tian, Lan Li, Baokang Peng, Lining Zhang, Xing Wu, Pengpeng Ren, Zhigang Ji, Zongwei Wang, Lijie Zhang, Xinwei Wang, Weihai Bu, Ming Li, Runsheng Wang, Heng Wu, Ru Huang
作者单位:School of Integrated Circuits, Peking University, Beijing, China; School of Integrated Circuits, SJTU, Shanghai, China; Peking University Shenzhen Graduate School, Shenzhen, China; School of Integrated Circuits, ECNU, Shanghai, China
摘要:我们首次提出了一种创新的堆叠技术,通过翻转工艺和背面工艺实现DRAM的尺寸缩放,充分利用了DRAM晶圆的背面,并在4F2和3D-DRAM上进行了研究。针对4F2 VCT,我们研究了具有自对准背对背堆叠1T1C存储单元的2F2翻转VCT,并探索了多种BL与WL配置。同时,成功开发了关键工艺模块,如自对准堆叠垂直沟道、BL与WL形成、晶圆键合与翻转、衬底减薄以及低电阻钴存储节点(SN),有效解决了翻转VCT工艺中可能存在的热效应、对准误差和寄生效应问题。此外,我们还建立了从器件到模块再到芯片层面的完整DRAM DTCO框架。与相同模块尺寸的4F2 VCT DRAM相比,2F2 FVCT在寄生效应上减少了27.5%,感测裕量提升了11%,电荷共享(CS)速度提高了16.3%,面积则缩小了50%。在3D-DRAM方面,我们研究了一种全新的翻转WL阶梯设计,并结合外围电路创新,证明了该设计具有25%的密度提升、15.1%更快的开启速度以及6.8%更短的CS时间,进一步验证了翻转技术在DRAM领域的可扩展性。
论文链接:https://arxiv.org/pdf/2609.14464
5. 压力看接触,振动听摩擦:SlipSense让76%的滑动在23.1毫秒内被发现
机器人夹住物体后,滑动通常从接触面的微小位移开始。如果等到物体明显下落再调整抓力,往往已经来不及。《SlipSense: Multimodal Tactile Learning for Low-Latency and Generalized Slip Detection》提出多模态触觉滑动检测框架 SlipSense,希望同时解决两个问题:既要尽早发现滑动,也要避免换一个物体、传感器或机械手后失效。
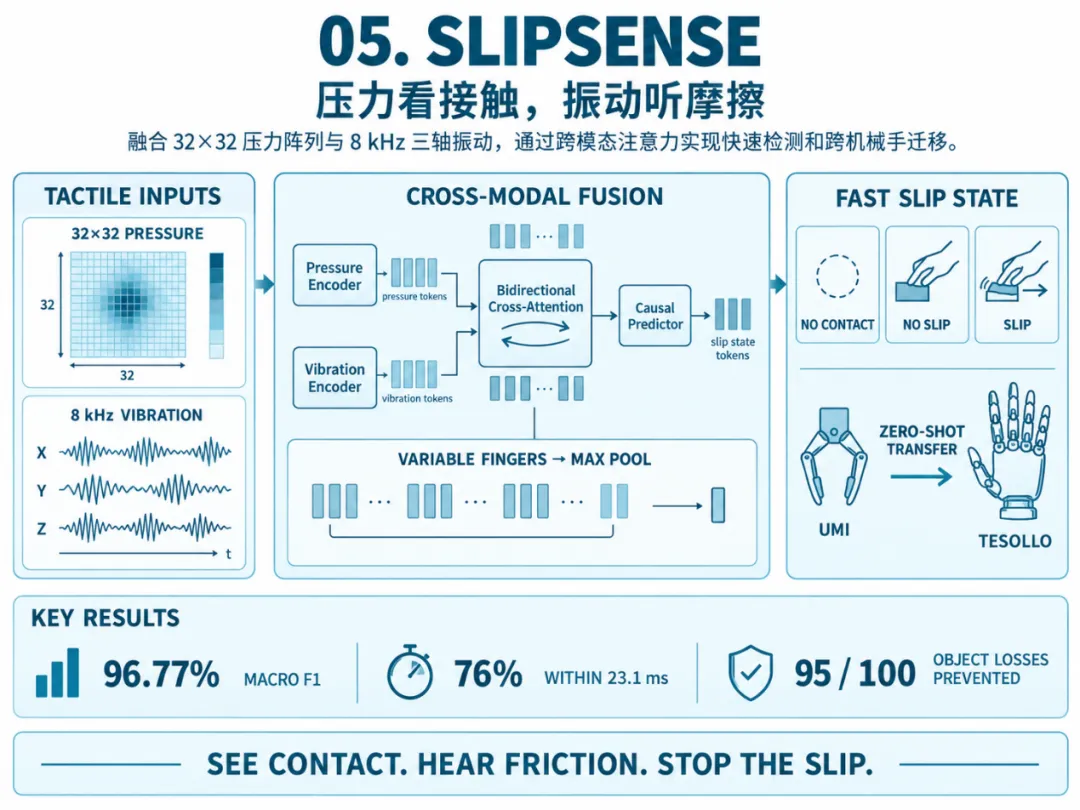
SlipSense的核心,是让两种错误模式不同的触觉信号互相纠正。
作者开发的TacV5触觉模块集成了两类传感器:32×32压阻阵列以240 Hz记录接触面的压力分布,三轴加速度计以8 kHz捕捉摩擦产生的高频振动。压力图能够判断物体在哪里接触、压力如何迁移,但容易把抓力变化误认为滑动;振动信号对滑动初期更加敏感,却可能受到机械手余振和外部扰动影响。
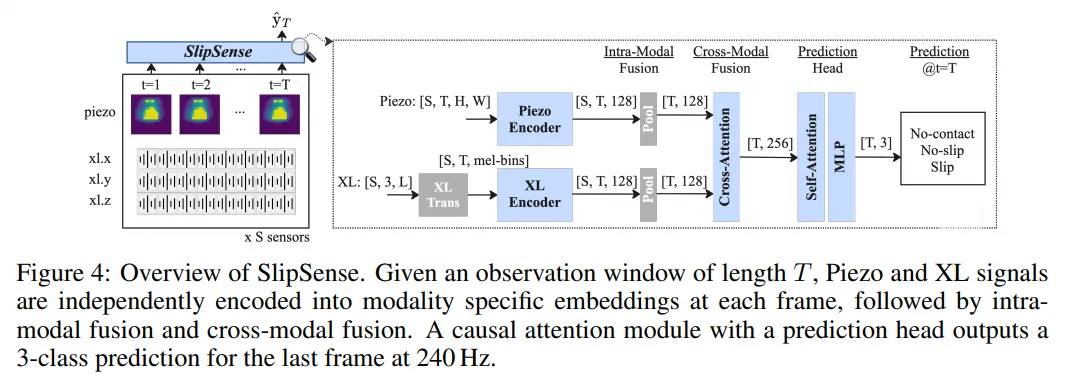
模型分别编码压力图与振动频谱,再通过双向交叉注意力,让压力信息查询振动历史、振动信息查询压力变化,最终判断“无接触、接触但未滑动、滑动”三种状态。针对不同机械手的手指数差异,SlipSense还会对同一模态下的多个传感器进行最大池化,主动舍弃手指身份,只保留最显著的接触信号。因此,在双指夹爪上训练的模型,也可以直接接收三指灵巧手的数据。
实验结果可以归纳为四组证据:
多模态融合:在同分布测试集上,单独使用压力和加速度信号的Macro F1分别为83.54%和81.61%;融合后提升至 96.77%,误报率降至 1.33%。
检测延迟:43%的滑动能在起始帧被识别,76%在5帧、即20.8毫秒内检出;加上RTX A4500上平均2.3毫秒的推理耗时,76%的滑动可在 23.1毫秒内完成检测。
跨平台迁移:模型仅使用UMI双指夹爪数据训练,在不微调的情况下迁移到Tesollo灵巧手,双指夹持Macro F1达到 94.39%;改为三指后降至87.24%,说明复杂接触几何仍会带来性能损失。
闭环抓取:面对10个未见物体和多种拉动方向,系统在100次试验中识别出全部滑动且没有误报,最终阻止了其中 95次物体掉落。其余5次失败并非没有检测到滑动,而是控制器采取的收紧动作反而将物体推出。
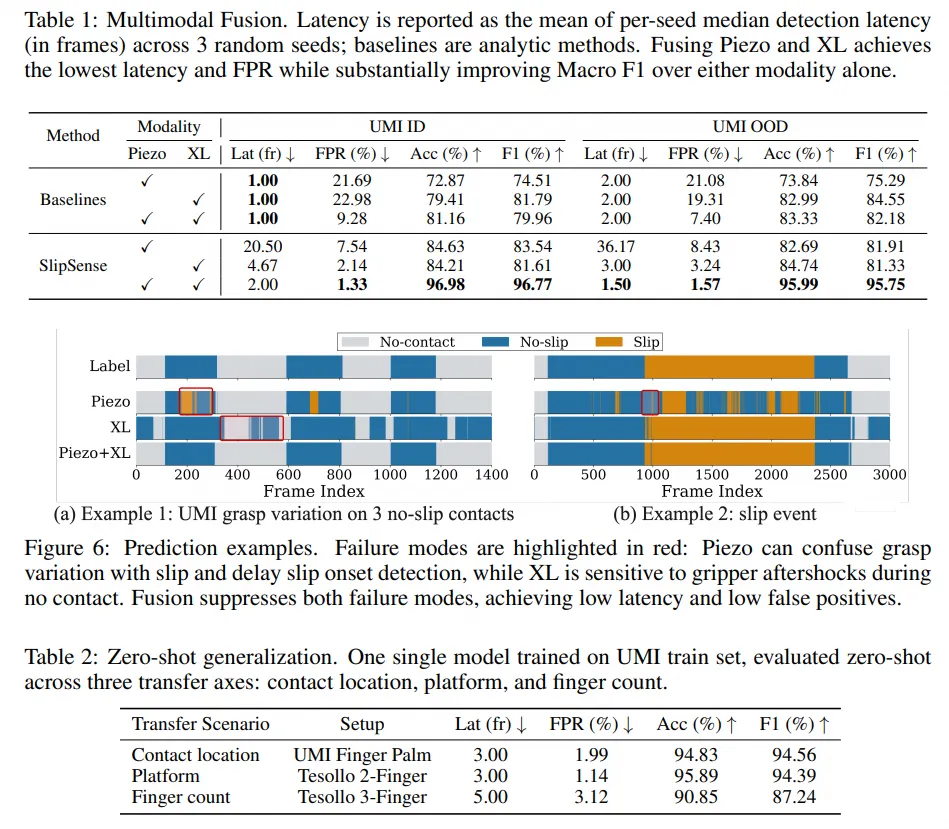
论文使用超过140万帧、覆盖37种物体的数据训练与测试,并通过分辨率0.02毫米的直线编码器独立标注滑动起点,避免用待评估的触觉信号反过来生成标签。不过,训练数据主要来自实验台上的单轴直线滑动;旋转和多方向滑动虽已在真实部署的100次试验中成功检出,但尚缺少定量延迟分析,主动操作中的 in-motion slip 也仍待系统验证。
标题:SlipSense: Multimodal Tactile Learning for Low-Latency and Generalized Slip Detection
作者:Tong Jian, Aditya Thurvas Senthil Kumar, Xinyi Li, Ziling Chen, Tianyu Dai, Ali Sengul, Matteo Grimaldi, Wenjie Lu, Saleh Nabi, Tao Yu
作者单位:Dexterous AI Group, Analog Devices, Inc.
摘要:滑动检测是灵巧操作的基础,但现有系统往往缺乏精确的检测延迟表征和跨平台泛化能力。我们提出了 SlipSense,这是一个基于 TacV5 的多模态触觉滑动检测框架,TacV5 是一种紧凑型传感器,集成了 32×32 压阻阵列(240 Hz)和三轴 MEMS 加速度计(8 kHz)。压阻阵列捕捉空间压力分布,而加速度计捕捉摩擦引起的振动,从而提供互补的滑动线索。该框架在 240 Hz 的采样率下,执行模态特定编码、传感器内部融合以及跨模态注意力机制,并结合因果时间预测。在包含 1.4 百万帧数据、涵盖 37 个物体的数据集上进行的实验表明,这两种模态具有关键的互补性:该系统实现了 96.7% 的宏 F1 分数,误报率低于 1.6%,并在 23.1 毫秒内检测到 76% 的滑动事件。值得注意的是,SlipSense 仅在 UMI 上进行训练,却能零样本泛化到 Tesollo 灵巧手,无需任何重新训练即可迁移到未见过的物体、不同的传感器单元以及新的机器人平台上。
论文链接:https://arxiv.org/pdf/2609.15910
(本文部分内容由 AI辅助生成,
内容可能存在局限或疏漏,欢迎理性探讨与指正)
阅读推荐:
* 点击“阅读原文”,了解黄大年茶思屋科技网站论文分享专题页更多精彩内容。
扫码进入茶思屋科技网站
加入茶思屋产学研思想碰撞
转载请联系本公众号获得授权
投稿:hdncsw@huawei.com