ARTICLE · 1043057
AI写报告,把隔壁片区的数搬过来了
AI写报告,把隔壁片区的数搬过来了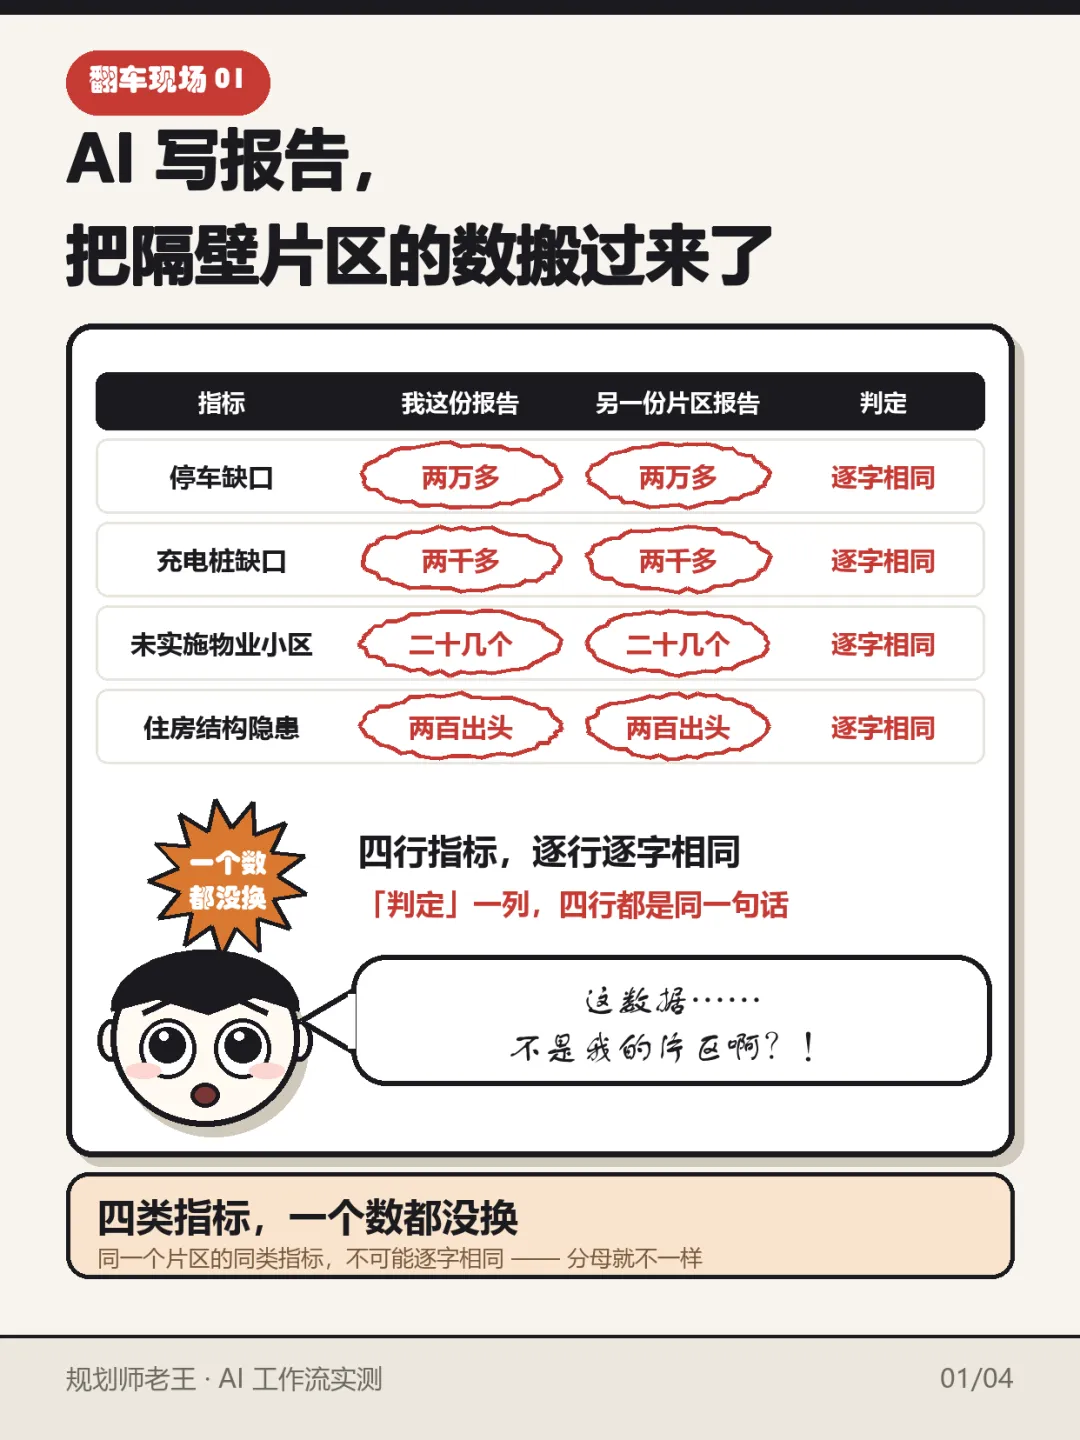
先说一句衔接:前面写过城市体检报告按四阶段怎么搭(指标解释 → 体检结果 → 问题清单 → 整治建议),那是"怎么做得对"。从这篇开始,我换个方向讲——它是怎么骗我的。 这个系列叫《驯服 AI 失败实录》,一共 7 篇,每篇一个真实翻车现场。不吹它能干,只讲它翻过的车。 一、翻车现场:四类指标,和另一个片区逐字相同 做的是一个老城片区的体检报告。手上压着三份同类片区报告作参考——同一批模板、同一批指标、同一套表述方式。 稿子写完自查的时候,我做了件当时觉得很多余的事:把几份报告里同名的指标拉到一张表里,并排看。 结果后背一凉。四类指标,和另一份片区报告一模一样: 指标 | 我这份报告 | 另一份片区报告 停车缺口 | 两万多 | 两万多 充电桩缺口 | 两千多 | 两千多 未实施物业小区 | 二十几个 | 二十几个 住房结构隐患 | 两百出头 | 两百出头 不是"接近",不是"同量级",是逐字相同。 一份报告里,指标值是要被引用、被汇总、被拿去排项目库的。四个值全部来自另一个片区,等于这份报告在四个关键结论上,讲的根本不是自己的事。 二、同一个片区,指标表和汇总段各说各话 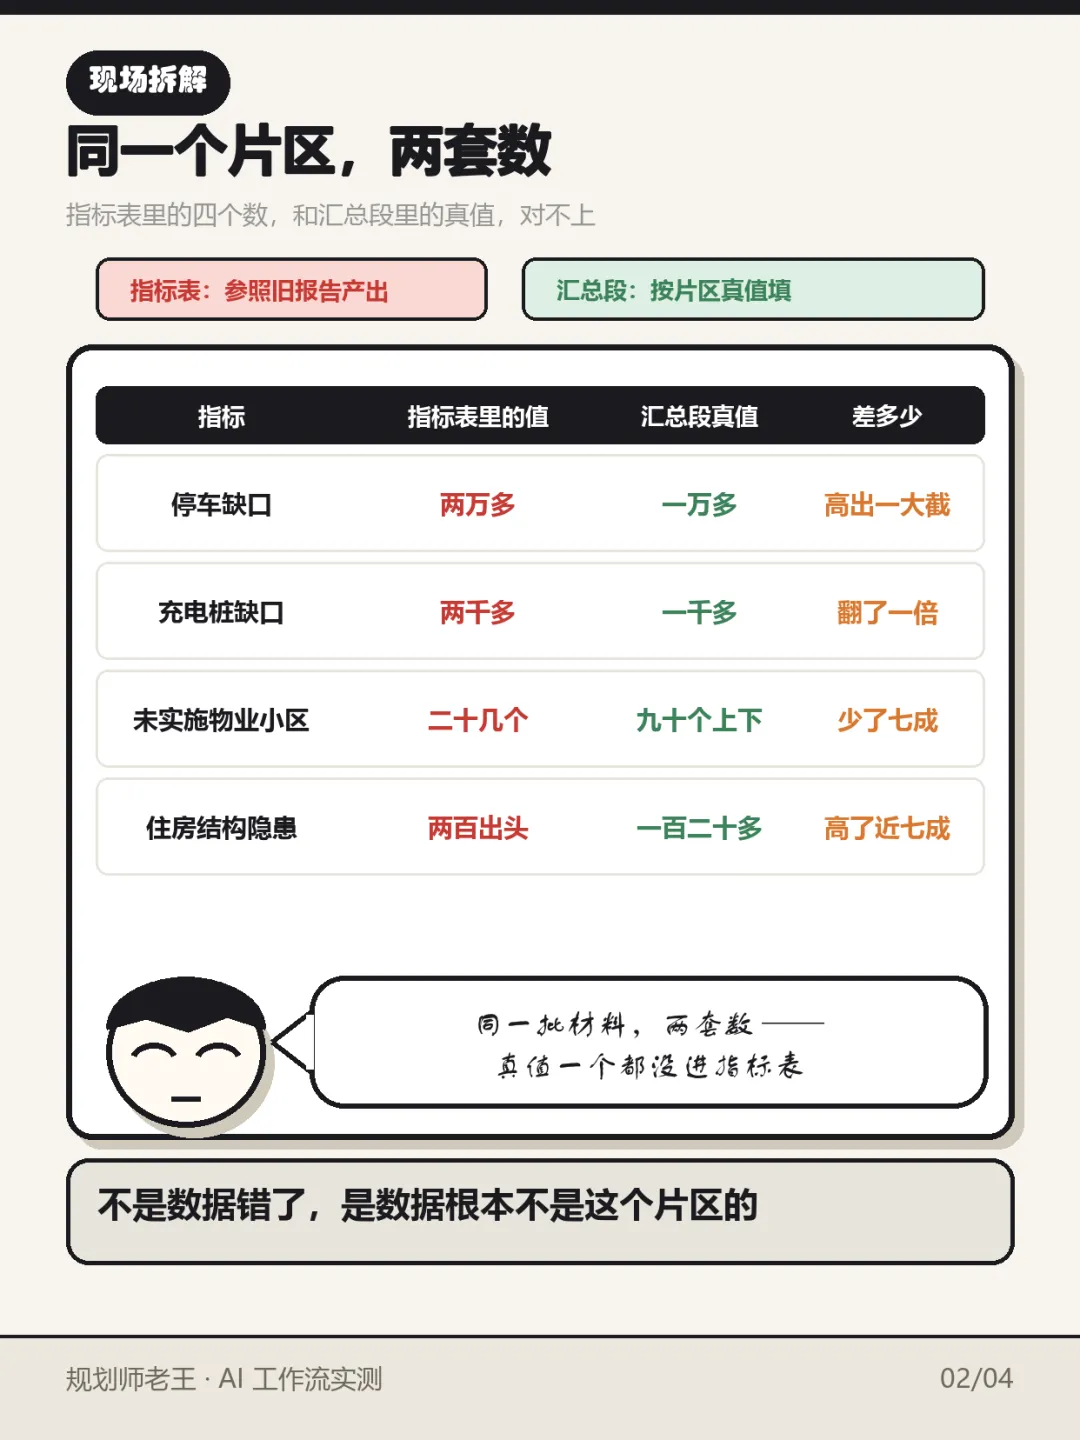
更让人难受的是:这四个数的真值其实就摆在同一批材料里,只是没进指标表。 同一个片区的汇总段(按片区逐个列数的那一段)里写着: 指标 | 指标表里的值(抄来的) | 汇总段里的真值 | 差多少 停车缺口 | 两万多 | 一万多 | 抄来的偏高,高出一大截 充电桩缺口 | 两千多 | 一千多 | 抄来的翻了一倍 未实施物业小区 | 二十几个 | 九十个上下(比例接近六成) | 抄来的少了七成 住房结构隐患 | 两百出头 | 一百二十多 | 抄来的高了近七成 一份报告内部出现两套数,而且两套数的口径、来源、作者都不同:指标表是"参照旧报告产出的",汇总段是"按片区真值填的"。 这就是"数据换头"最典型的样子:不是数据错了,是数据根本不是这个片区的。 三、还没完:连占比都是搬的 同一批稿子里还有个更隐蔽的:另一份片区报告,托育设施的覆盖率。 正文里写着"八十多个小区,五成半"。 我顺手算了一下。这个片区的小区总数是一百三十多个,八十多除以它,得到的是六成出头,不是五成半。 那五成半是哪来的? 我把另两份报告的分母翻出来对——五成半,是拿另一个片区的分母算出来的。那个片区小区总数一百五十多个,八十多除以一百五十多,正好落在五成半。 也就是说:分子(那八十多个)是 A 片区的,分母却用了 B 片区的,最后得出的比例,既不属于 A 也不属于 B。 更麻烦的是同一个指标在这个片区里三套口径并存: - 指标测算段:八十多个小区,五成半 - 对策段:还残留着旧版的"一百来个" - 汇总段:又是另一个比例 三段文字指着同一个指标,三个数。而且每一段单看都通顺、都像"算过了"——这种错误比抄整行难发现得多,因为它长得不心虚。 四、根因:AI 搬的不是"写法",是"数值" 我不想把锅全甩给 AI,说清楚它到底错在哪: 我让它参照另外三份报告,产出这个片区的指标。它把"结构"学得很好——有哪些指标、每项怎么表述、结论怎么落,全靠这个效率才起来。 但它把数值也一起搬了过来。 问题的本质在这儿:体检报告的指标值不是一个独立的数,每一个都挂着自己的分母。 - "未实施物业小区占比" = 本片区未实施物业的小区数 ÷ 本片区小区总数 - "停车缺口" = 本片区的停车需求 − 本片区的现有泊位 换一个片区,分子分母全变,值必须重算。而在 AI 眼里,这几行是"一段格式正确的文本",它的任务是把格式搬到新片区——数值被它当成了格式的一部分,一起过去了。 所以它交付的东西,格式上一处毛病挑不出来,内容上四个数全是别人的。这正是最危险的地方:错得让人放心。 五、我是怎么发现的:把同名字段做成一张"数值指纹" 方法不复杂,就是三方比对——三份同类片区报告 + 一份汇总段,把能对齐的字段全部拉平。 判据只有一句话: > 同名字段取值逐字相同 = 判定为"没改"。 为什么这条判据这么灵?因为正常情况下,两个不同片区的同类指标不可能逐字相同——分母不一样、基数不一样、基础条件不一样,就算巧合接近,也不可能一字不差。 "逐字相同"本身就是最强的异常信号,比任何统计检验都灵敏,而且不依赖阈值、不需要专业知识判断。 我这四行,逐字相同,一格不差。 六、怎么修的:先冻结,再核对 我的修法只有一条原则:先冻结源文件,一个字都不改。 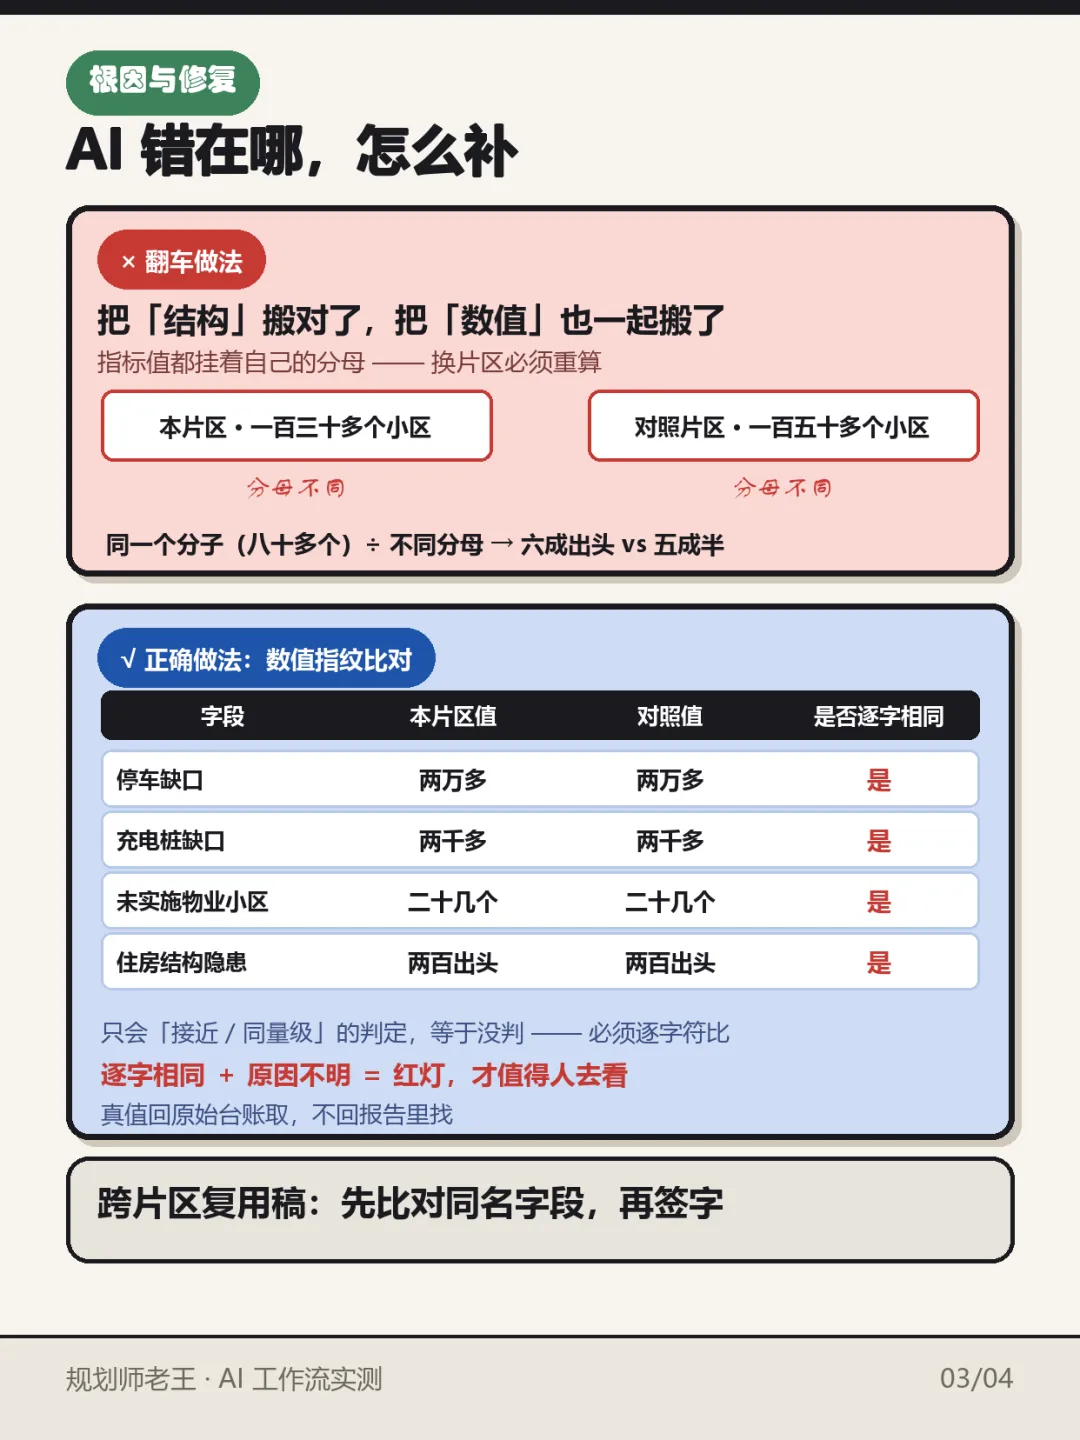
1. 源文件零改动。 先产出一张独立的《指标核对表》,把每一处疑似复用标出来,附证据:在哪一段、和谁相同、差异是多少、真值是多少。 2. 真值回原始台账取,不回报告里找。 报告里的数可能本身就有问题,回报告找真值等于拿错的去校错的。 3. 只改指标表,不动方法论段落。 结构性文字是好的,改它反而引入新错。 4. 口径不统一的,列成"口径待定"清单交人拍板。 三套口径哪个对,是规划意图和统计合规的判断——这件事 AI 判不了,也不该让它判。 这套做法后来固定成了我的习惯:跨片区复用稿,签字之前必须先过一遍数值指纹比对。 七、一条可抄的提示词:数值指纹比对表 我不写"帮我检查一下数据有没有问题"这种话——AI 会回"数据看起来正常"。 我用的说法是把任务结构化成一个表: 你是数据核对助手,只做机械比对,不做专业判断。 任务:用我给出的【本片区指标表】与【对照材料】,输出一张「数值指纹比对表」。 对照材料包括:另外几份同类片区报告、以及本片区汇总段。 输出四列,逐行填写: 1. 字段名 2. 本片区值 3. 对照值(哪个片区/哪一段,写出处) 4. 是否逐字相同(只能填"是"或"否") 硬约束: - "是否逐字相同"必须是逐字符比较,不允许按"接近""同量级"来判。 - 凡填"是"的行,必须追加一列「差异原因」,写不出来就填「原因不明」。 - 不允许修改、补充或推测任何我没有提供的数值;缺失一律写"待核"。 - 最后单独列出:所有"逐字相同"且"原因不明"的行 —— 这些是红灯项。 关键在两处: - "逐字相同"必须显式判定。 不能只让它算差异——必须让它对每一行输出一个是/否。这一步把"发现异常"从判断题变成了机械动作,AI 做得比人稳。 - "差异原因"必须写。 逐字相同 + 原因不明,两个条件同时成立,才是要人去看的红灯。只报"相同",你会拿到一堆"理论上可以相同"的合理项,噪声太大。 
八、这篇的提示词去向 这是《规划 AI 防翻车提示词包(7 条)》的第 1 条,7 篇发完合成完整版。评论区或私信留「指纹」,我把这张比对表的完整提示词发你。 下一篇:一个片区四个面积,多出来的小半公顷被谁"消化"了——表格是平的,数字是错的。 (本系列全部素材来自真实项目的返工记录,涉及项目、地名、数值均已作脱敏与量级化处理。)