ARTICLE · 1047849
AI安全到底在防什么?一张图看懂四类风险|30天入门①
AI安全到底在防什么?一张图看懂四类风险|30天入门①你可能见过这样的场景: AI 把不存在的政策说得煞有介事;员工把客户名单粘贴进公共模型;一句藏在网页里的指令,让 AI 助手偏离原本任务;一个能调用邮件和文件工具的 Agent,因为权限过大,把“小错误”放大成真实损失。 这些问题看起来不同,其实都属于同一个主题:AI 安全。 AI 安全不是“让模型永远不出错”,而是尽量降低 AI 对个人、组织和社会造成伤害的概率与影响,并在问题发生时能发现、限制和追溯。 美国国家标准与技术研究院 NIST 的 AI 风险管理框架提出,可信 AI 不只要“能用”,还要考虑可靠性、安全性、韧性、透明度、可解释性、隐私与公平。管理这些风险也不是上线前做一次检查,而应贯穿设计、开发、部署和使用全过程。图 1|AI 安全四层风险示意(AI 手绘) 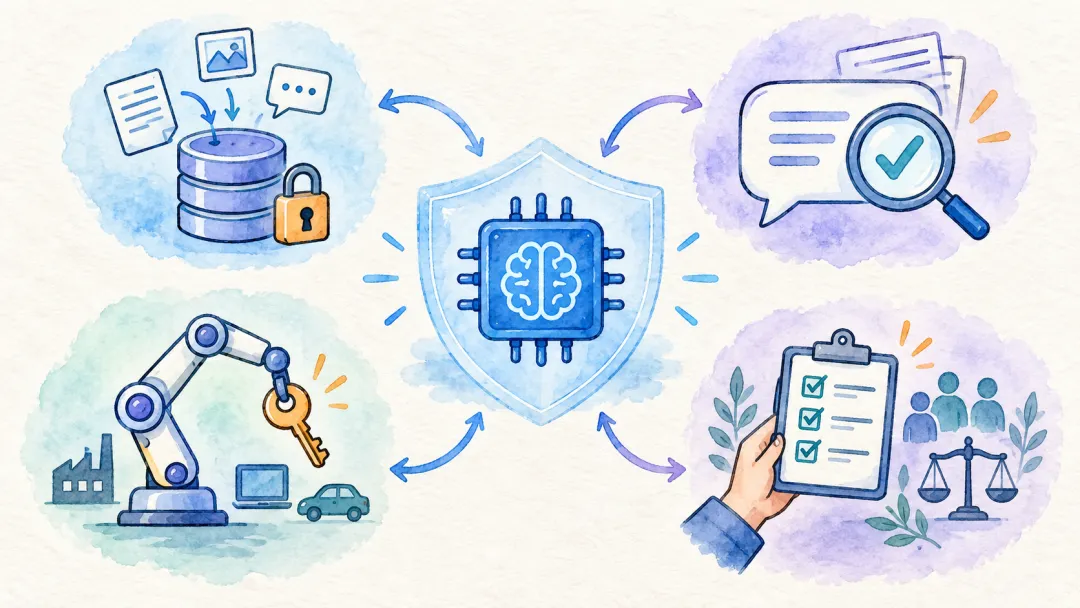
AI 的表现高度依赖数据。如果训练数据、知识库或用户输入有问题,输出也可能被污染。 常见风险包括:把身份证号、合同、源代码等敏感信息直接交给外部模型;攻击者在知识库中混入错误内容;网页或文档里藏着恶意指令,诱导 AI 忽略原任务。 最实用的原则是:先把输入当作“不可信内容”。敏感数据要分类、脱敏和限制访问;外部资料进入知识库前要核验来源;来自网页、邮件和文档的文字不能自动获得指挥 AI 的权限。 大模型擅长生成“最像答案的文字”,但流畅不等于正确。它可能产生事实错误、虚构引用,也可能输出偏见、有害建议或不恰当内容。 因此,高风险场景不能只问“回答得好不好”,还要问:事实能否追溯?不确定时会不会承认?不同人群是否被公平对待?面对危险请求是否有边界? 一个简单做法是要求答案附来源,并把“生成”和“核验”拆成两步。医疗、法律、金融和对外发布等高影响用途,还必须保留专业人员复核。图 2|从“自信输出”到“事实核验”(AI 手绘) 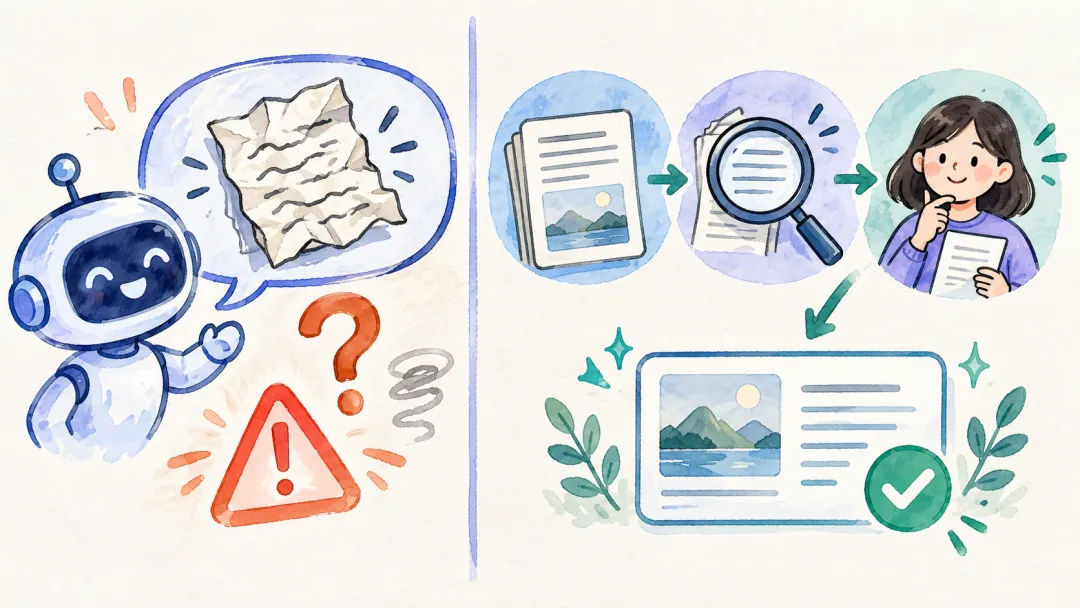
普通聊天机器人答错一句,影响可能有限;但当 AI 能读取数据库、发送邮件、修改文件、调用支付或生产系统时,同样的错误会变成真实操作。 OWASP 的大模型应用风险清单把提示词注入、敏感信息泄露、供应链风险、数据与模型投毒、输出处理不当等列为重点风险。这提醒我们:安全问题往往不只在模型内部,还存在于模型与工具、数据和业务流程的连接处。 给 AI 工具权限时,应坚持最小权限:只开放完成当前任务所需的能力;读取和写入分开;重要操作需要二次确认;设置金额、次数和影响范围上限;保留可审计日志。 AI 安全最终不是一个按钮,而是一套持续管理过程。NIST 把核心工作归纳为四个动作:治理、识别情境、衡量风险和管理风险。 落到日常,就是在上线前明确用途和禁区,测试可能的失败方式;上线后持续监控异常;出现事故时能暂停、回滚、通知和复盘。更重要的是,要明确谁有权批准高风险用途,谁对结果负责。图 3|AI 风险管理闭环(AI 手绘) 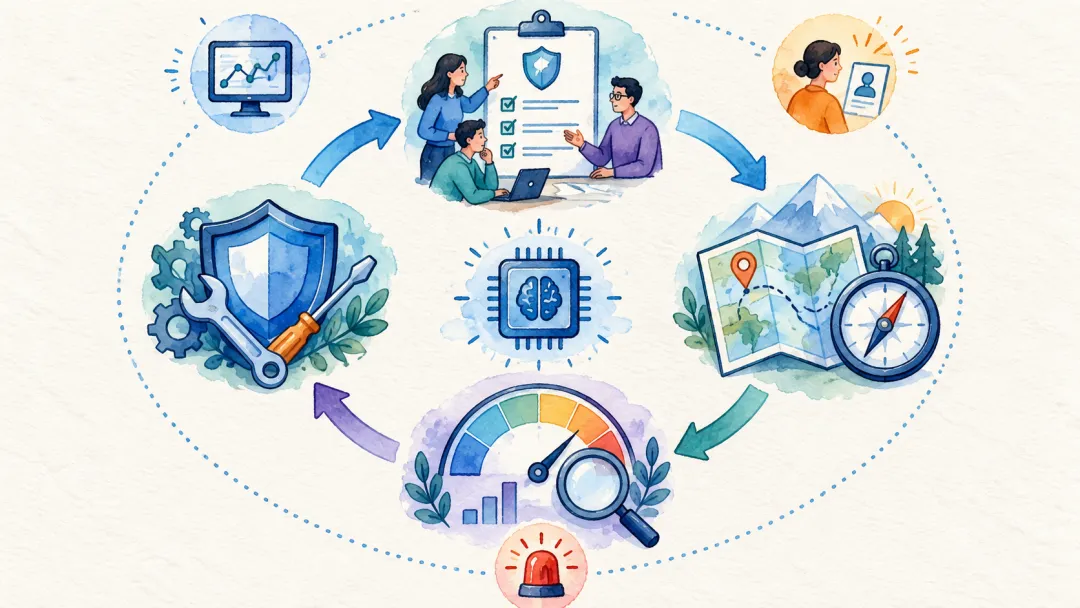
判断一个 AI 功能是否安全,可以先问五个问题: 如果这五个问题都没有答案,那么这个系统即使演示效果很好,也还不适合放心交给真实用户。 记住一句话:AI 安全不是阻止 AI 做事,而是让它在可控的边界内做事。 下一篇,我们聊一个最常见、也最容易被误解的问题:AI 为什么会“一本正经地胡说八道”? 参考资料: 1. NIST AI Risk Management Framework 1.0 https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-ai-rmf-10 2. NIST AI RMF Core https://airc.nist.gov/airmf-resources/airmf/5-sec-core/ 3. OWASP 2025 Top 10 for LLMs and Gen AI Apps https://genai.owasp.org/llm-top-10/ 注:截至 2026 年 9 月,NIST 已说明 AI RMF 1.0 正在修订中;本文使用其稳定的核心概念作为科普框架,并会在后续文章中关注更新。
一、数据与输入:AI 吃进去的东西安全吗?
二、模型与内容:回答听起来像真的,就是真的吗?
三、应用与权限:AI 能做什么,比它会说什么更重要
四、人和治理:谁负责,什么时候停?
它会接触哪些数据?其中有没有敏感信息? 它可能在哪些情况下给出错误或有害结果? 它能调用什么工具,权限是否过大? 关键操作是否有人确认,出了问题能否立即停止? 过程是否有记录,结果是否可以追溯?