ARTICLE · 1048404
GitHub开源神器:这个AI语音合成工具让机器开口"说人话",效果堪比真人!
最近刷GitHub的时候,被一个项目惊到了。它不是什么大厂出品,却靠"说人话"的本事火遍了开发者圈子。没错,我说的就是 ChatTTS。
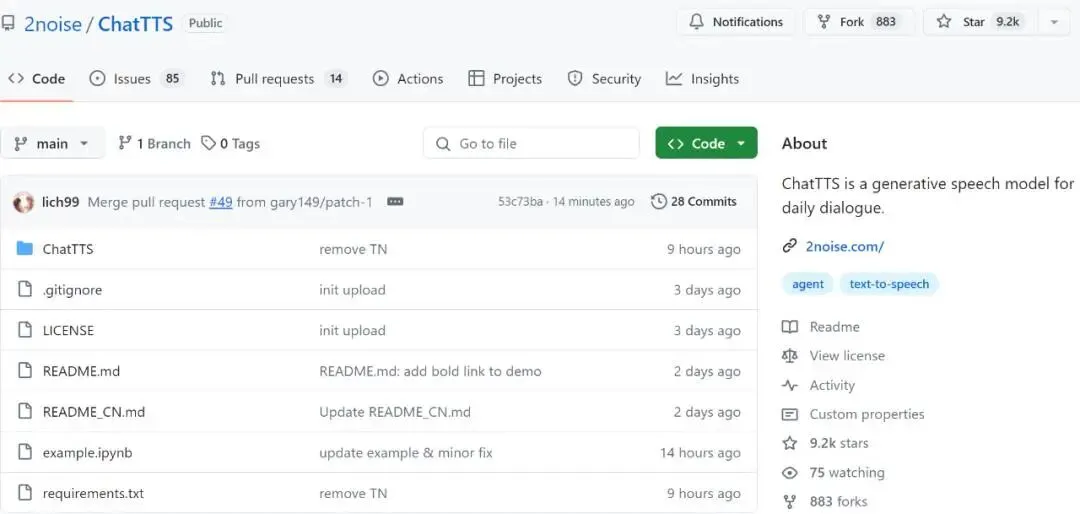
说实话,语音合成这东西我玩过不少,但大多数都一个毛病——读得太"标准"了。标准到不像真人,像新闻播报员在念稿子,生硬得很。ChatTTS不一样,它专门瞄准了对话场景做优化,生成的语音自带停顿、笑声、语气词,甚至能模仿人说话时的犹豫和换气。你闭上眼睛听,真会以为对面坐着个活人。
这个项目由国内团队 2noise 开发,开源在GitHub上已经积累了超过3万颗星。核心模型用了10万小时以上的中英文对话数据训练,开源版本是基于4万小时数据预训练的模型。虽然代码遵循AGPLv3+协议,模型权重是CC BY-NC 4.0(仅限学术和非商业用途),但对个人开发者、研究者来说,完全够用了。
它到底牛在哪?
先说说几个让我眼前一亮的点。
第一,对话感极强。 传统的TTS模型追求"字正腔圆",ChatTTS追求的是"像聊天"。它能自动在句子中间插入自然的停顿,该笑的时候笑,该嗯嗯啊啊的时候绝不省略。你让它读一段日常对话,出来的效果跟微信语音条几乎没差。
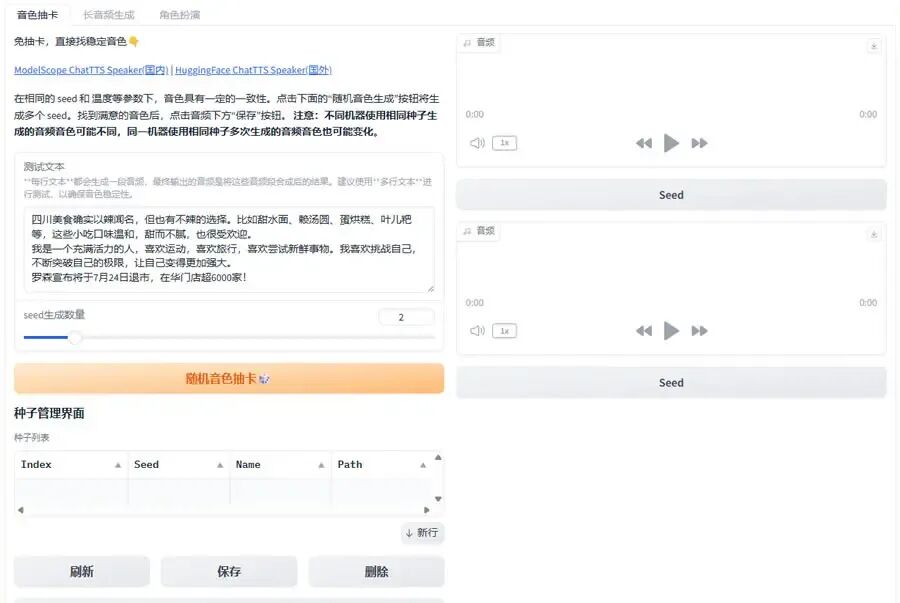
第二,细粒度控制。 你可以用特殊标记来操控语音的细节。比如 [laugh_0] 到 [laugh_2] 控制笑声程度,[break_0] 到 [break_7] 控制停顿长短,[oral_0] 到 [oral_9] 调节口语化风格。甚至还能用 [uv_break] 和 [lbreak] 做更精细的断句控制。这相当于给语音装了个"遥控器",想让它怎么表现都行。
第三,多音色支持。 它支持多说话人模式,可以随机采样不同的音色,也可以固定某个音色嵌入(speaker embedding)来保证一致性。做有声书、播客或者游戏NPC对话时,这个功能简直是刚需。
第四,轻量且高效。 模型参数量大概3亿,4GB显存就能跑起来。在RTX 4090上,生成速度大概是每秒7个语义token,实时率(RTF)约0.3,也就是说生成30秒音频大概需要10秒左右。这个速度对于本地部署来说相当可以了。
怎么安装?手把手教你
ChatTTS的安装方式有好几种,我按从简单到复杂的顺序给你捋一遍。
方法一:pip 一键安装(最省事)
如果你只是想用,不想折腾源码,直接pip安装最方便。
# 安装稳定版pip install ChatTTS# 或者追新,装GitHub上的最新版pip install git+https://github.com/2noise/ChatTTS装完之后,几行代码就能跑起来:
import ChatTTSimport torchimport torchaudiochat = ChatTTS.Chat()chat.load(compile=False) # 如果你的GPU支持,可以改成True加速texts = ["你好啊,今天天气真不错。", "对啊,适合出去走走。"]wavs = chat.infer(texts)for i in range(len(wavs)):try: torchaudio.save(f"output{i}.wav", torch.from_numpy(wavs[i]).unsqueeze(0), 24000)except: torchaudio.save(f"output{i}.wav", torch.from_numpy(wavs[i]), 24000)就这么简单。chat.infer() 会返回音频数组,然后用 torchaudio 保存成24kHz的WAV文件。注意这里用了try-except,因为不同版本的torchaudio保存方式略有差异,这样写兼容性最好。
方法二:源码部署(开发者推荐)
如果你想改代码、调参数,或者用到最新的功能,建议直接克隆仓库。
git clone https://github.com/2noise/ChatTTScd ChatTTS然后装依赖。官方推荐用conda管理环境,避免跟系统Python打架:
conda create -n chattts python=3.11conda activate chatttspip install --upgrade -r requirements.txt如果你用的是Linux,还可以选装vLLM来加速推理:
pip install safetensors vllm==0.2.7 torchaudio注意两点坑:
TransformerEngine 和 FlashAttention-2 暂时别装。 官方明确说了这俩还在适配中,装了反而可能变慢或报错。 路径别带中文和空格。 很多小伙伴启动失败就是因为文件夹名字里有"新建文件夹"这种,改成纯英文就没事了。
装好之后,你可以直接跑官方提供的示例。
启动WebUI界面:
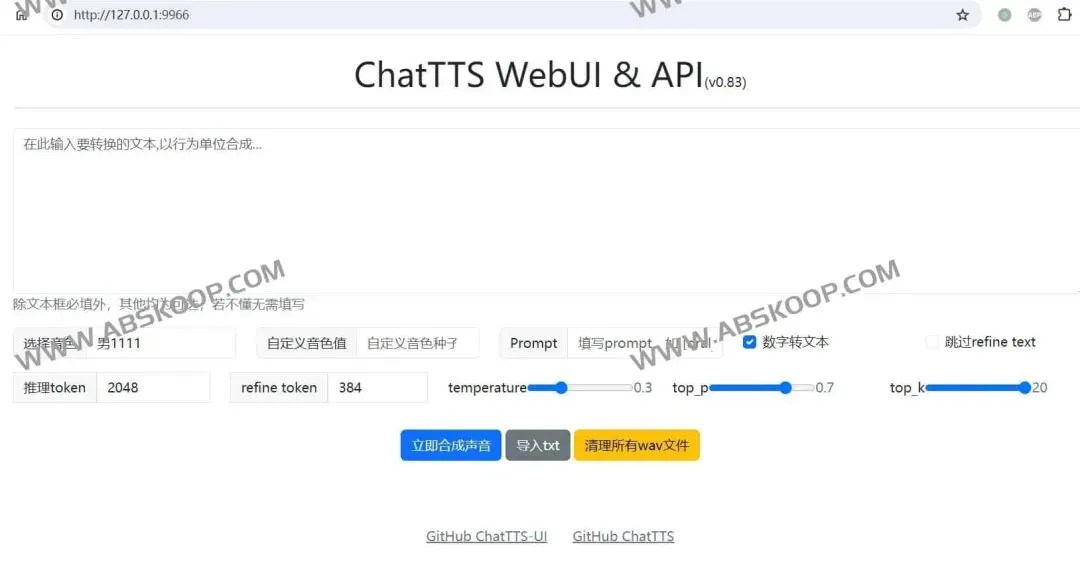
python examples/web/webui.py浏览器会自动打开一个本地页面,你在里面输入文字、选音色、调参数,点一下就能生成音频。对新手来说,这个界面最友好。
或者用命令行快速生成:
python examples/cmd/run.py "你好,这是ChatTTS生成的语音。"生成的音频会保存在当前目录下,文件名是 output_audio_0.mp3 这种格式。
方法三:Docker 部署(服务器党福音)
如果你要在服务器上跑,或者不想污染本地环境,用Docker最干净。
# GPU加速版(推荐)docker compose -f docker-compose.gpu.yaml up -d# 纯CPU版(没N卡的同学用这个)docker compose -f docker-compose.cpu.yaml up -d启动之后,通过端口访问WebUI就行。Docker的好处是一次配置,到处运行,换机器也不用重新配环境。
方法四:离线整合包(小白专属)
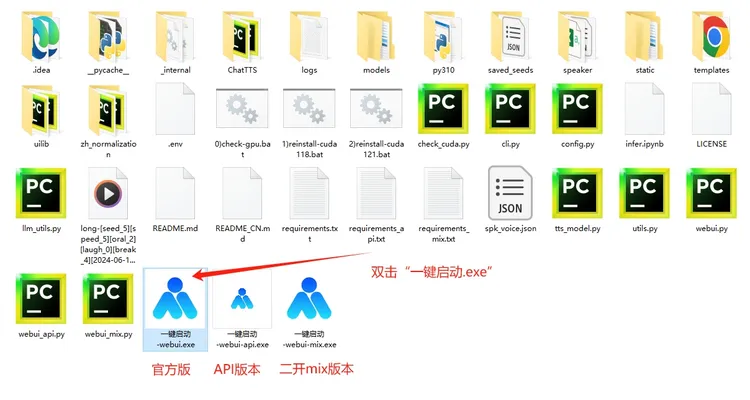
如果你连Python环境都懒得配,网上有热心开发者打包的离线整合包(比如ChatTTS-ui或者ChatTTS_colab)。下载解压,双击 app.exe 或者启动脚本就能用,模型文件都内置好了。不过这种方式更新比较慢,想体验最新功能还是得用源码。
进阶玩法:怎么让语音更"有灵魂"?
基础用法会了,再来点高级的。ChatTTS最迷人的地方就是可控性,你可以像导演一样指挥AI怎么说话。
1. 控制口语化风格和韵律
通过 RefineTextParams 传入prompt,可以全局控制语音风格:
params_refine_text = ChatTTS.Chat.RefineTextParams( prompt='[oral_2][laugh_0][break_6]',)wavs = chat.infer( texts, params_refine_text=params_refine_text,)[oral_2] 表示中等程度的口语化,[laugh_0] 关掉笑声,[break_6] 停顿稍长。这些标记的组合可以调出各种风格,从严肃播报到轻松闲聊都能覆盖。
2. 词级别的精细控制
如果你想让某个特定词有停顿,或者某句话后面带笑声,可以直接在文本里插入标记:
text = '那个[uv_break]你的想法挺有意思的[laugh][lbreak]'wavs = chat.infer(text, skip_refine_text=True)这里 skip_refine_text=True 表示跳过自动文本优化,完全按你写的标记来生成。[uv_break] 是短停顿,[lbreak] 是长停顿,[laugh] 是笑声。组合起来,你可以精准控制每一句话的情绪节奏。
3. 固定音色,保持一致性
随机音色每次都不一样,做长内容时会很跳戏。你可以采样一个音色保存下来,反复用:
# 随机采样一个音色rand_spk = chat.sample_random_speaker()print(rand_spk) # 把这段输出保存下来,以后复用params_infer_code = ChatTTS.Chat.InferCodeParams( spk_emb=rand_spk, # 固定音色 temperature=0.3, # 温度越低,结果越稳定 top_P=0.7, top_K=20,)把 rand_spk 的值存到文件里,下次加载进来传给 spk_emb,就能保证同一个角色从头到尾声音不变。
4. 多说话人对话
ChatTTS天生支持多说话人。你给 infer() 传一个文本列表,它会按顺序生成,每个文本可以配不同的音色参数。做双人对话时,你只需要准备两段文本,分别指定男声和女声的speaker embedding,出来的效果就像真人在聊天。
实际应用场景
这玩意儿能干嘛?我举几个例子。
做有声书和播客。 以前录一期节目得对着麦克风吼半天,现在写好稿子,调好声音,ChatTTS帮你念。虽然还不能完全替代真人主播,但做初稿、做Demo完全够用了。
给AI助手加声音。 如果你在做LLM应用,ChatTTS可以让你的Agent从"打字聊天"变成"语音对话"。配合实时语音识别,就是一个完整的语音交互系统。
游戏和动画配音。 独立开发者没预算请配音演员?ChatTTS可以生成多种角色音色,还能控制情绪,做NPC对话或者独立游戏的旁白,成本几乎为零。
内容创作辅助。 短视频配音、广告旁白、教学视频解说,只要是需要"人声"的地方,它都能顶上。而且因为是本地运行,不用担心隐私泄露或者按字数收费。
一些小坑和解决办法
用了一段时间,也踩过几个坑,顺便分享下。
显存不够怎么办? 官方说最低4GB,但如果你想跑得更顺,8GB以上比较稳。如果爆显存,可以在 chat.load() 里加 cpu_offload=True,把部分计算挪到内存里,速度会慢一点,但能跑起来。
生成效果不稳定? 这是自回归模型的通病,有时候会出现多说话人混音,或者音质忽好忽坏。官方建议多采样几次,挑一个最好的结果。调低 temperature 也能让输出更稳定。
英文效果比中文差? 目前版本中文优化得更好,英文还在实验阶段。如果你主要做英文内容,建议等后续更新,或者自己微调一下。
模型下载慢? 第一次运行会自动从HuggingFace下载模型,大概1.5GB。如果网络不好,可以手动下载模型文件放到指定目录,或者找国内的镜像源。
写在最后
ChatTTS的出现,算是给开源语音合成领域打了一剂强心针。它证明了开源模型也能做到接近商用的对话式语音效果,而且给了开发者极高的自由度去控制细节。
当然,它也有局限。比如目前开源版本没有SFT(监督微调),完整能力还在内部版本里;再比如模型仅限非商业用途,想直接拿来卖产品是不行的。但对于个人学习、研究、内部项目来说,它已经是当下最好的选择之一了。
项目还在快速迭代,路线图里提到了流式生成、DVAE编码器开源、多情感控制等功能,值得期待。社区也很活跃,GitHub Issues区、QQ群、Discord里都有开发者交流,遇到问题基本能找到答案。
如果你一直想让AI"说人话",而不是"读稿子",ChatTTS绝对值得一试。装起来不复杂,玩起来很有意思,关键是——免费。
guthub地址:https://github.com/2noise/ChatTTS