ARTICLE · 1053145
AI 视觉到底是什么?计算机视觉技术演进与 AI 视觉应用基础
发布时间:2026-09-21 21:09:36 最近访问:2026-09-21 21:09:36
AI 视觉到底是什么?计算机视觉技术演进与 AI 视觉应用基础
从 CNN 到视觉语言模型——计算机视觉技术演进与 AI 视觉应用基础
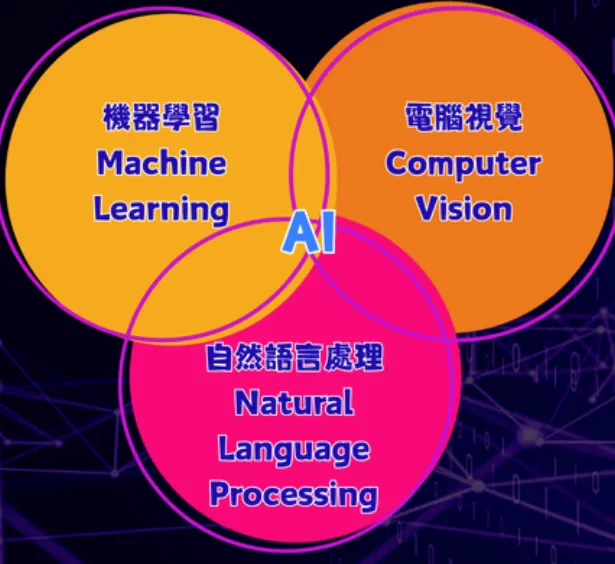
近年来,人工智能的发展逐渐从以文本为中心的语言模型扩展到图像、视频、语音等多模态数据。尤其是视觉领域,从早期依赖人工设计特征的传统计算机视觉方法,到卷积神经网络(Convolutional Neural Network, CNN),再到 Vision Transformer(ViT)、视觉—语言模型(Vision-Language Model, VLM),计算机处理视觉信息的方式发生了明显变化。理解今天的 AI 视觉应用,并不意味着需要记住大量模型名称。更重要的是理解这些技术为什么出现、分别解决了什么问题,以及它们之间存在怎样的关系。本文从计算机视觉的基本概念出发,梳理 CNN、ResNet、目标检测、YOLO、图像分割、ViT、CLIP 和 VLM 等代表性技术,并进一步讨论这些模型如何从单一视觉任务走向实际的 AI 应用系统。
一、什么是计算机视觉?
计算机视觉(Computer Vision, CV)是人工智能的重要研究领域之一,其目标是使计算机能够从图像、视频等视觉数据中获取具有意义的信息。从任务角度来看,计算机视觉并不是单一的问题,而是一组不同层次的视觉感知任务。例如:图像分类(Image Classification):判断一张图片属于什么类别;目标检测(Object Detection):识别图像中有哪些目标,并确定目标所在位置;图像分割(Image Segmentation):进一步确定图像中每一个像素属于哪个区域或目标;目标跟踪(Object Tracking):在连续视频帧中持续定位同一个目标;姿态估计(Pose Estimation):识别人体或其他对象的关键点和姿态;图像检索(Image Retrieval):根据图像内容搜索相似图像。因此,如果把计算机视觉概括成一个问题,可以理解为:如何让机器从视觉数据中获得从低层特征到高层语义的信息。
这一问题的解决方式经历了从人工设计特征到数据驱动表示学习,再到视觉与语言联合建模的演进。
二、从传统计算机视觉到深度学习
在深度学习成为主流之前,计算机视觉通常依赖人工设计的特征。例如,研究人员可以利用图像中的边缘、纹理、角点和局部形状等信息构造特征,再将这些特征输入支持向量机(SVM)等机器学习模型完成分类。人工设计特征 → 特征提取 → 机器学习模型 → 分类或识别
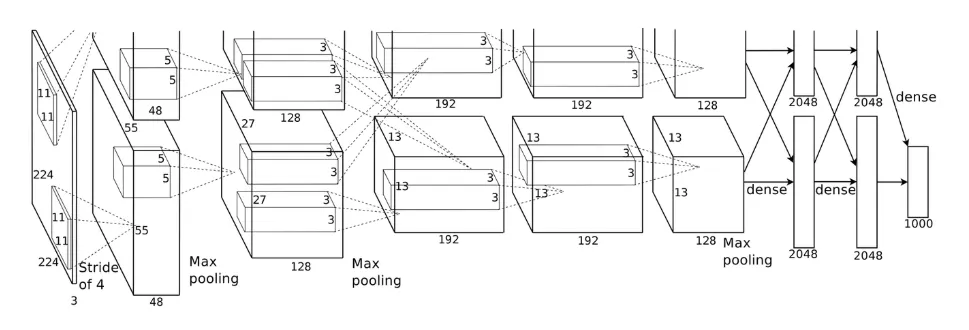
SIFT、HOG、Haar-like features 等方法都属于这一时期具有代表性的技术。这种方法的局限在于,视觉特征主要依赖研究人员进行设计。面对复杂的真实图像,人很难提前规定哪些特征对于所有场景都最重要。与其人为规定特征,不如让神经网络直接从大量数据中学习特征表示。2012 年,Krizhevsky、Sutskever 和 Hinton 提出的 AlexNet 在 ImageNet 图像分类任务上的表现推动了深度卷积神经网络重新成为计算机视觉研究的重要技术路线。原始图像 → 神经网络自动学习特征 → 分类结果
三、CNN:让神经网络自动学习视觉特征
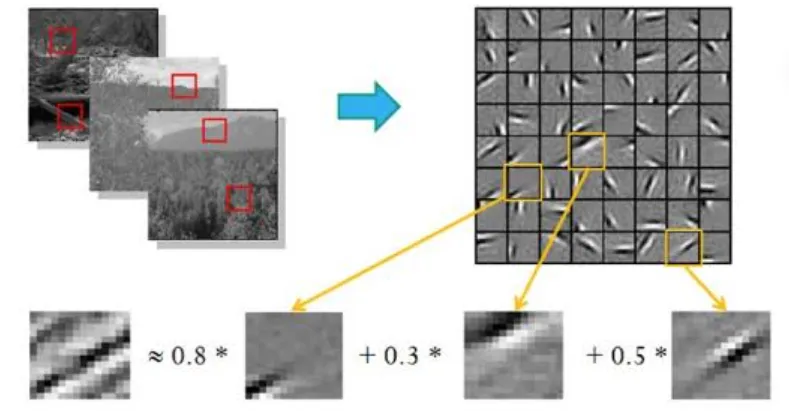
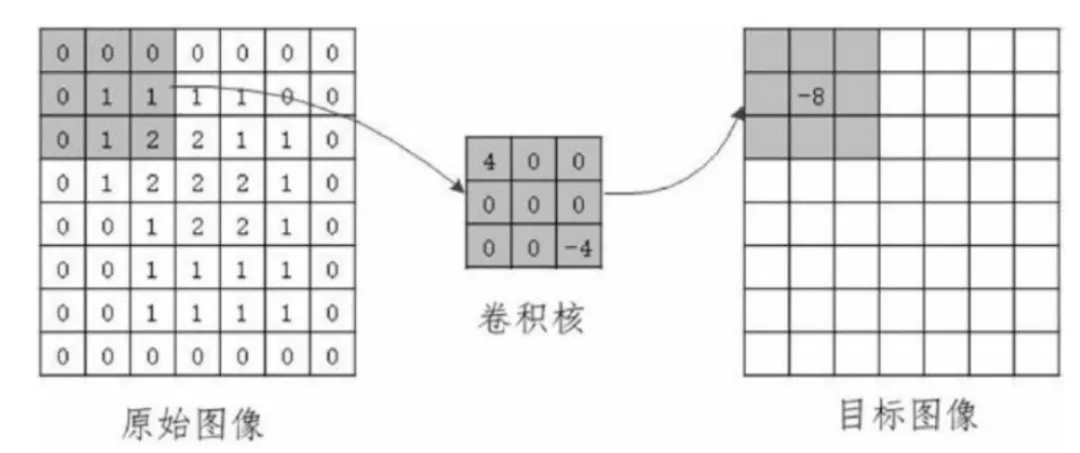
卷积神经网络(Convolutional Neural Network, CNN)是一类针对网格结构数据设计的神经网络,其中图像就是最典型的网格数据。CNN 的核心操作之一是卷积(Convolution)。可以把卷积核理解成一个较小的窗口,它在图像上滑动,并对局部区域进行计算。通过训练,网络可以学习不同卷积核所对应的参数,从而逐渐发现图像中的各种模式。在网络较浅的位置,模型通常学习比较基础的视觉特征,例如:边缘、方向、简单纹理。
随着网络层数增加,这些低层特征可以进一步组合成更加复杂的结构,例如:局部形状、物体部件、整体轮廓。
像素 → 边缘和纹理 → 局部结构 → 物体部件 → 高层语义
CNN 的重要意义并不只是提高了分类准确率,更重要的是,它改变了计算机视觉获取特征的方式:视觉表示不再完全依赖人工设计,而可以通过数据和任务目标进行端到端学习。
四、ResNet:网络为什么不能无限加深?
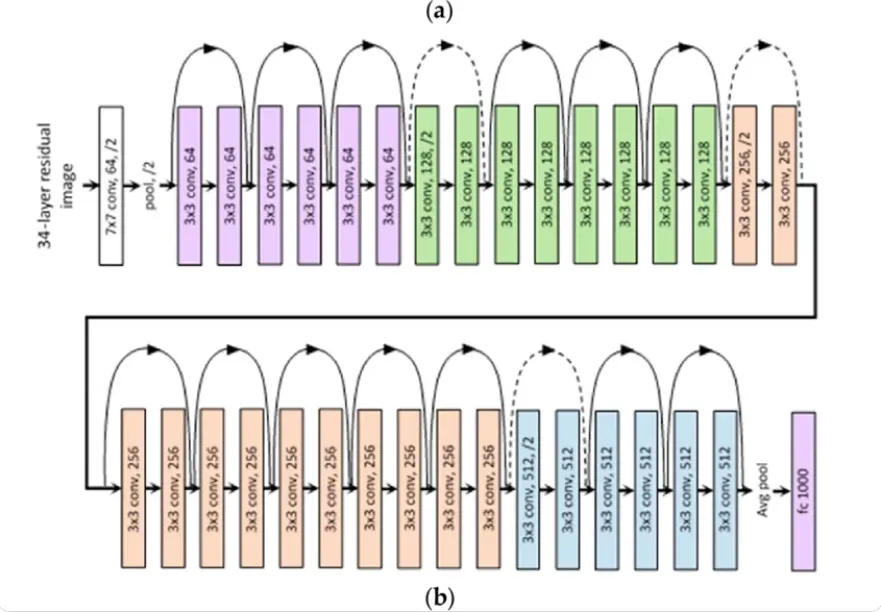
直观来看,如果更多层能够学习更多层次的特征,那么更深的网络似乎应该具有更强的表达能力。随着网络加深,优化会变得更加困难,并可能出现退化问题。也就是说,网络层数增加以后,训练误差不一定继续下降。2015 年,He 等人提出了 ResNet(Residual Network),并在 2016 年 CVPR 发表论文。ResNet 最具代表性的思想是残差学习(Residual Learning)和跳跃连接(Skip Connection)。输入 → 多层网络 → 输出
而残差结构允许输入信息绕过部分网络层,与后续计算结果进行融合:输入 → 网络 → 输出↘────────↗
这种结构使网络不必直接学习完整的目标映射,而可以学习输入与目标之间的残差,从而缓解深层网络优化困难。ResNet 的提出具有重要影响。论文中展示了深达 152 层的残差网络,并证明更深的网络可以在可训练性和识别性能方面获得改善。[2]因此,如果需要用一句话理解 ResNet,可以概括为:ResNet 通过残差连接解决深层 CNN 难以训练的问题,使更深的网络成为可能。
五、从识别是什么到目标在哪里:目标检测
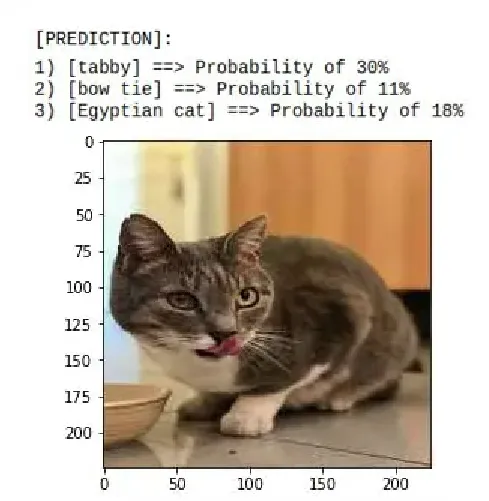
这张图片是什么?
Cat:0.97
人、汽车、自行车、交通标志。
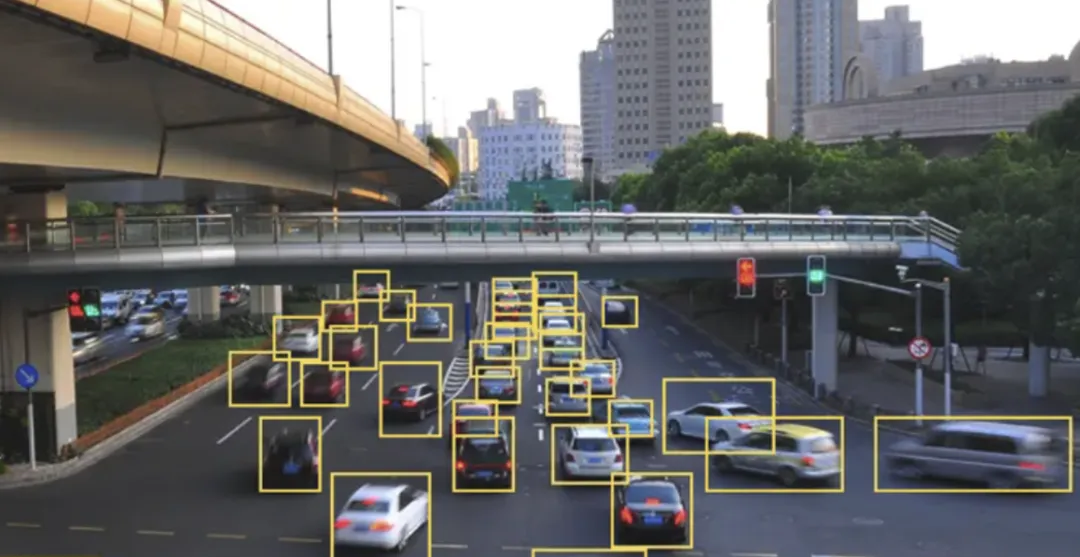
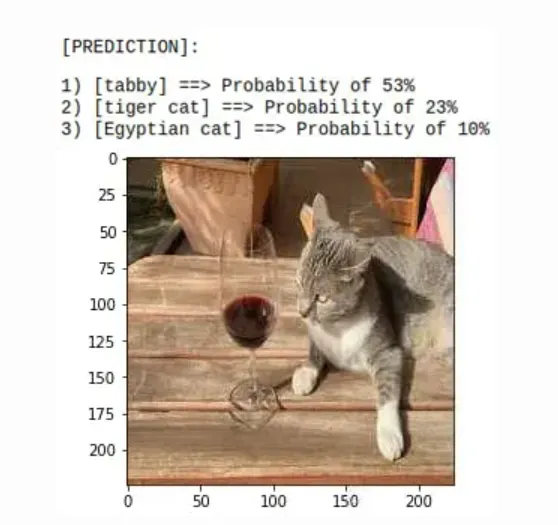
这时,仅仅知道图片包含什么还不够,还需要知道每个目标位于什么位置。这就是目标检测(Object Detection)。如这是一张虎斑猫,如果猫跳到酒杯旁边,模型依然只会识别出图片中占主导地位的虎斑猫。其中目标位置通常通过一个矩形框表示,也就是Bounding Box。What + Where
是什么 + 在哪里。
一类是以 R-CNN、Fast R-CNN、Faster R-CNN 为代表的两阶段检测方法。Faster R-CNN 引入 Region Proposal Network(RPN),用于生成候选区域,并与后续检测网络共享卷积特征。另一类则是单阶段检测方法,其中 YOLO 是最具代表性的系列之一。
六、YOLO:实时目标检测
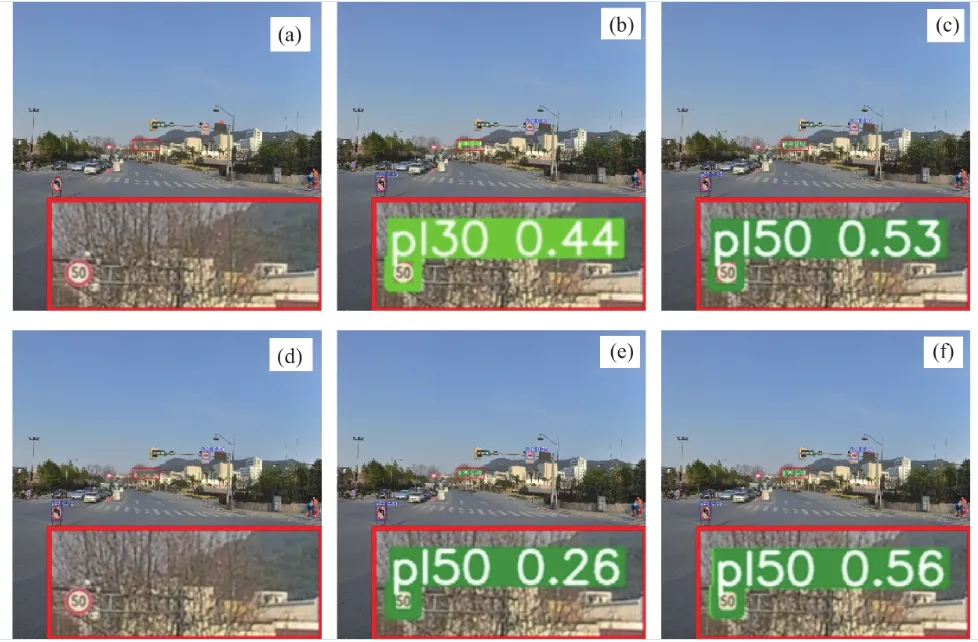
YOLO 的全称是You Only Look Once。2016 年,Redmon 等人提出了最初的 YOLO 方法,将目标检测直接构建为一个从整幅图像预测目标位置和类别概率的回归问题。使用一个统一的神经网络完成目标位置和类别的预测。
这使得 YOLO 类方法非常适合实时视觉场景,例如:例如,在一个安全生产场景中,可以利用目标检测模型识别:人员、头盔、安全绳、危险区域等。
摄像头 → 目标检测 → 状态判断 → 异常报警
需要注意的是,YOLO 是一个不断演进的模型家族,后续版本在网络结构、训练策略和检测能力等方面不断发展。因此,在实际工程中讨论 YOLO 时,还需要进一步明确具体版本和实现。
七、图像分割
“这里有一个人。”
如果希望精确知道人的轮廓,就需要进一步进行图像分割(Image Segmentation)。为图像中的像素分配相应的类别或实例归属。
人在哪里?
哪些像素属于这个人?
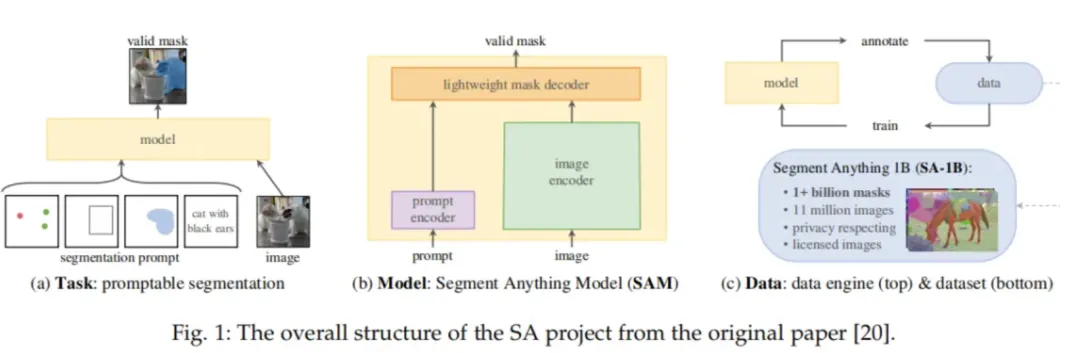
根据任务不同,图像分割还可以进一步分为语义分割、实例分割和全景分割等类型。近年来,一个具有代表性的视觉基础模型是 Segment Anything Model(SAM)。Kirillov 等人在 2023 年 ICCV 发表的 Segment Anything 工作提出了可通过提示进行分割的通用模型和大规模 SA-1B 数据集,其数据集包含超过 10 亿个 mask。视觉模型开始从针对单一任务训练的专用模型,逐渐走向具有更强迁移能力和通用性的视觉基础模型。
八、Transformer 进入视觉领域:ViT
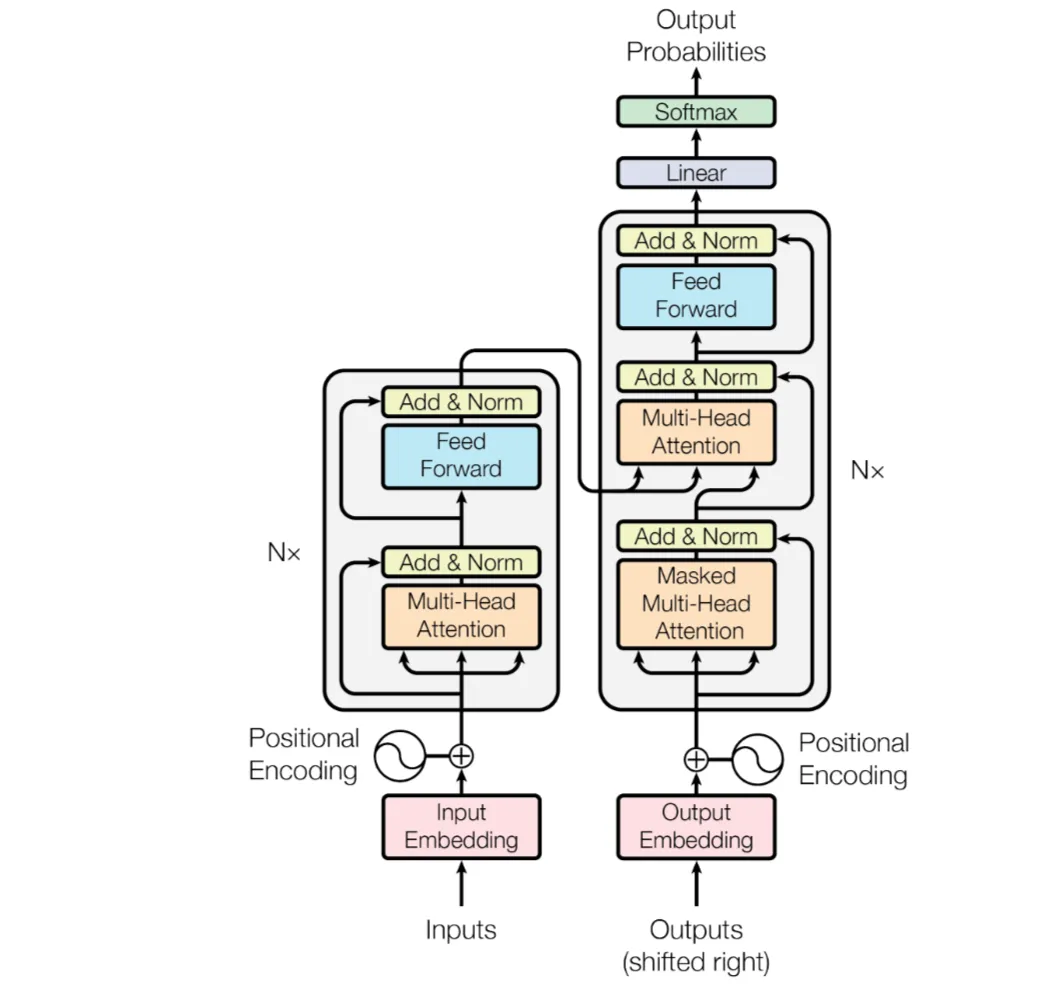
但 Transformer 在自然语言处理领域取得巨大成功之后,一个自然的问题出现了:Transformer 能不能直接处理图像?
2020 年,Dosovitskiy 等人提出 Vision Transformer(ViT),证明纯 Transformer 架构也可以直接用于图像分类。把图片切成一个个小的图像块(Patch),再把这些 Patch 当作类似 Token 的序列交给 Transformer 处理。
Image → Patches → Embeddings → Transformer → Visual Representation
Text → Tokens → Embeddings → Transformer
这也是为什么已经接触过大语言模型的人,理解 ViT 往往并不困难。
九、CNN 与 Transformer:并不是简单的“谁取代谁”
Transformer 出现以后,CNN 就没有用了。
CNN 本身具有很强的视觉归纳偏置,例如局部连接和参数共享,这些结构非常适合图像数据。2022 年,Liu 等人提出 ConvNeXt,通过重新设计和“现代化”经典 ResNet,使纯卷积网络在现代视觉任务中重新展现出很强的竞争力。[7]Transformer 的成功并不意味着卷积结构已经过时。
事实上,现代视觉系统中 CNN、Vision Transformer 以及两者的混合结构仍然都有重要应用。CNN 与 Transformer 提供了不同的视觉特征建模方式,并在不同任务、数据规模和计算条件下形成不同的技术选择。
十、从视觉模型到多模态:CLIP
如何利用 Transformer 理解图像?
如何让图像和语言建立联系?
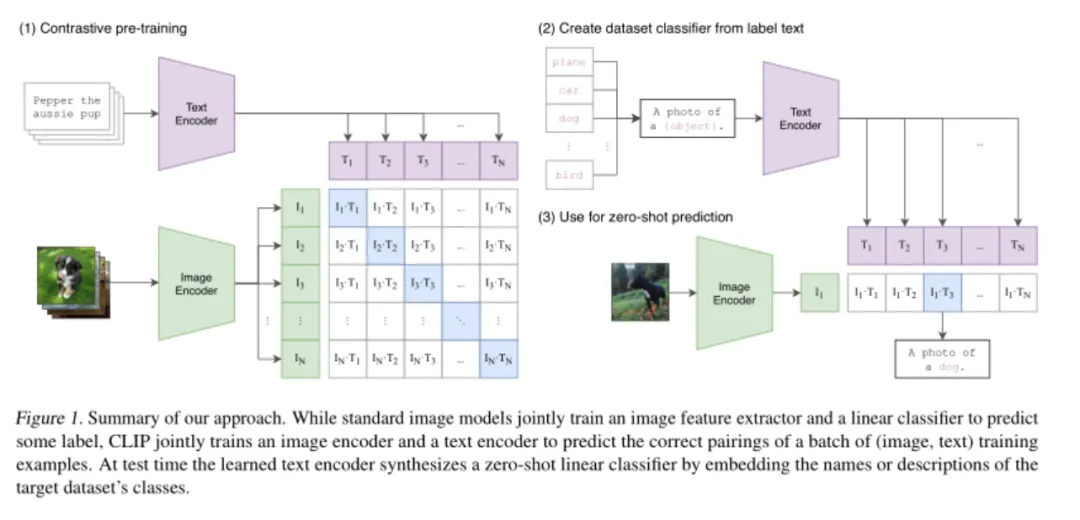
CLIP(Contrastive Language–Image Pre-training)由 Radford 等人提出,并发表于 ICML 2021。CLIP 的核心思想是使用大量图像—文本配对数据进行训练,使图像和对应文本在共同的语义表示空间中更加接近。CLIP由两个相互独立的编码器(Encoder)组成:Text Encoder(文本编码器):使用基于Transformer 的模型(类似于GPT架构)来提取文本序列的特征向量。Image Encoder (图像编码器):作者尝试了两种经典的视觉架构:修改版的ResNet (如ResNet-50)和Vision Transformer例如一只狗的图片与文本:A dog ; A cat ;A horse图片和 “A dog” 的语义匹配程度更高。
这种图像—文本对齐能力带来了很多新的应用可能,例如:从这里开始,计算机视觉逐渐不再只是“看图”,而开始进入:视觉 + 语言
十一、VLM:让模型不仅看见,还能够理解
VLM,即 Vision-Language Model,通常译为视觉语言模型。“图像中有什么?”
“图像表达了什么?”“图像中的不同对象有什么关系?”“根据图片回答问题。”“结合图片和文字完成推理。”
一个人站在公交车站旁边。
“这个人可能正在做什么?”
CV 模型负责视觉感知,语言模型负责语言理解,而 VLM 尝试将两者连接起来。
需要注意的是,VLM 并不是单一固定的模型架构。不同视觉语言模型在视觉编码器、语言模型、跨模态连接方式、训练目标和数据规模等方面可能存在很大差异。但从技术路线来看,CLIP 等视觉—语言预训练工作为后续多模态模型的发展提供了重要基础。[8]
十二、RNN 到 Transformer:为什么序列建模方式发生变化?
在理解 Transformer 之前,还需要了解 RNN。RNN(Recurrent Neural Network,循环神经网络)主要用于处理具有顺序关系的数据,例如文本、语音和时间序列。当前时间步的计算不仅依赖当前输入,还会利用前一个时间步传递过来的隐藏状态。
x₁ → RNN → h₁ → RNN → h₂ → RNN → h₃
其中 h 可以理解为模型在当前时间点保留的状态信息。LSTM 和 GRU 是对传统 RNN 的重要改进,它们通过门控机制改善长序列中的信息传递问题。但 RNN 的序列计算具有明显的顺序性,长距离依赖和并行计算也存在限制。2017 年,Vaswani 等人提出 Transformer,核心机制是 Self-Attention。Transformer 不再要求信息必须通过一个接一个的循环状态进行传递,而是允许序列中的不同位置直接建立注意关系。这一架构后来成为现代大语言模型的重要基础,也进一步被引入视觉领域。RNN → LSTM/GRU → Transformer → ViT → 多模态模型
这并不是简单的模型替换,而是序列和信息交互方式不断变化的过程。
十三、从模型到应用:AI 视觉系统究竟是什么?
一个视觉模型并不等于一个完整的 AI 视觉应用。
因此,一个实际的 AI 视觉应用通常至少包括几个层次:1. 数据层
2. 模型层
3. 推理层
模型训练完成之后,需要将输入数据交给模型进行预测,即:Inference这一阶段还会涉及模型加载、GPU 推理、批处理、推理速度和显存占用等问题。4. 应用层
检测到人员 + 没有安全帽 → 触发报警。
“看到了什么?”
“发现这种情况之后应该怎么办?”
十四、视觉 + LLM + RAG + Agent:AI 视觉应用的进一步发展
当视觉模型和语言模型结合之后,AI 视觉应用可以进一步扩展。例如,一个工业质量检测系统可以设计为这样的系统中,不同模块承担不同职责:从图片中提取视觉信息。
将图像或文本转化为可以比较和检索的向量表示。
从外部知识库中检索相关信息。
对视觉信息和检索结果进行语言理解、综合和生成。
根据任务决定是否以及如何调用外部工具。
这意味着现代 AI 视觉应用已经不一定是一个单独的视觉模型,而可能是:视觉模型 + 多模态模型 + LLM + RAG + Agent + 后端系统
十五、结语
从传统 CV 到 CNN,从 ResNet 到 YOLO,再到 ViT、CLIP 和视觉语言模型,计算机视觉的发展并不是简单地不断更换模型名称,而是在不断回答几个基本问题:如何从图像中提取有效特征?
如何识别图像中的对象及其位置?
如何获得更加精细的视觉表示?