ARTICLE · 1055199
Jev:一个不写字的 AI,专门替软件做判断
你有没有遇到过这种情况:想用 AI 自动处理一些重复判断 —— 比如把客户消息分成 "投诉、咨询、售后",或者判断一封邮件急不急。用 ChatGPT 这类大语言模型(LLM)来做,回答慢、价格贵,给你的还是一大段文字,程序拿到后还得自己解析,运气不好还会碰上它答错格式。
TypeSafe AI 在 9 月 15 日发布的 Jev,就是冲着这个问题来的。它是一款不写句子的 AI:你给它几个选项,它直接告诉你选哪个,还附上 "我有多大把握"。程序拿到答案就能用,不用读、不用解析。
如果你在做自动化或智能体,Jev 值得花几分钟了解。下面用大白话讲清楚:它是什么、怎么用、有什么坑。
01Jev 到底是什么?
Jev 是 TypeSafe AI 推出的模型,官方定位叫 "System One 模型"。这个概念听着难以理解,我们可以从下面这个概念入手。
心理学家卡尼曼把人脑的思考分成两种:一种又快又靠直觉,叫系统 1(比如看到红灯就停);一种又慢又费脑,叫系统 2(比如做数学题)。TypeSafe 的判断是:软件里大多数判断其实是 "系统 1"——"这条消息属于哪一类?"" 这个请求急不急?"—— 但过去,我们一直在用" 系统 2" 级别的完整大模型做这些小事,又慢又贵。
Jev 就是把这类快速判断单独做成一个产品。工作方式是:你给它一段程序状态,加上一组问题,它一次性把所有问题答完 —— 答案不是文章,而是带概率的结构化结果,程序可以直接拿来用。
顺便交代下背景:Jev 由 Diogo Almeida 主导构建,他曾参与 OpenAI 的 RLHF 和 InstructGPT 工作,那项工作奠定了 ChatGPT 的技术基础。发布 Jev 的同时,TypeSafe AI 宣布完成由 DCVC 领投的 4000 万美元融资。名字致敬经济学家威廉・斯坦利・杰文斯(William Stanley Jevons)—— 逻辑是:做一次判断的成本越低,需要的判断就越多。
02Jev 和 ChatGPT 这类模型差在哪
差别就一句话:ChatGPT 给你写一段话,Jev 给你一个答案。
写一段话意味着:你拿到后要自己解析、检查格式,还得担心它有没有 "一本正经地胡说八道"。Jev 则把所有可能的答案提前定好(就像表单里的下拉框),它只能从里面选 —— 拿回来就能用,也不存在格式错误。
还有两个细节值得知道。
第一,它算得很快,因为所有问题是同时算的。问 10 个问题和问 1 个问题,时间差不多。
第二,它每次回答都会附一个 "把握程度",而且这个把握经过校准 —— 意思是,当它说 "90% 把握" 时,长期来看确实有大约九成是对的。这正是自动化的关键:你可以设定规则,把握高就自动处理,把握低就转给人工。这套方法 TypeSafe 称为 "校准决策强化学习"(RLCD,Reinforcement Learning for Calibrated Decisions)—— 优化目标不是让回答讨人喜欢,而是让概率贴近真实结果。
目前 Jev 只支持文字输入(字符串、JSON 或文本列表),图片、音频、视频都还不行。
03它只回答三种问题
整个 API 就三种题型,这是刻意设计:
Choice(选择题):从最多 255 个选项里选一个,同时告诉你每个选项的概率。可以加一个 "都不符合" 的选项。
Score(打分题):在 2 到 10 分的量表上打分,分数可以落在整数之间(比如 1.4 分)。
Noul(判断题):回答是或否,给出 0 到 1 之间的概率。
举个实际例子。客户发来一条工单,你在一次请求里同时问三个问题:该哪个团队处理(选择题)、客户有多不满(打分题)、客户是否明确要求退款(判断题)。程序拿到三个答案,用普通的 "如果…… 就……" 逻辑组合起来,就把工单自动分好了。
TypeSafe 的官方文档把 Jev 比作 "智能 if 语句":在手写规则太死板、搞不定的场景里,做分类、路由、打分、提取或分支。
04适合做什么,不适合做什么
适合的场景有一个共同点:答案范围固定、每天要重复判断很多次。比如工单分类、意图路由、内容审核、信息提取、打分,或者给其他 AI 的输出把关。
因为它便宜又算得快,你可以一次把所有问题都问完,再由代码决定哪些结果重要。
不适合的场景也很清楚:凡是需要 "写东西" 的都不行 —— 聊天、写代码、解释推理过程,它都做不到。还有两点局限要注意:
它没有常识。 Jev 只知道你传给它的信息,不会自己去查资料。所以一套工作流能做到什么程度,取决于你喂给它什么。
"把握程度" 是整体统计。 校准在大量判断上成立,不保证某一次回答正确。Jev 照样会犯错。
05价格便宜得惊人,但先看注意事项
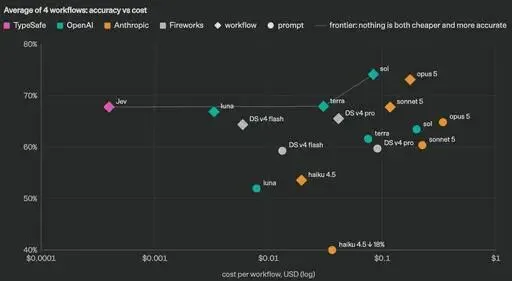
TypeSafe 公布的价格:输入每百万 token 0.042 美元,输出免费;延迟 70–500 毫秒;官方主页宣称在工作流测试中比大模型 "快 193.6 倍、便宜 444.6 倍"。
便宜是真的便宜,但请把这些数字当成厂商自己的说法,不是独立测试的结果。TypeSafe 自己也承认:测试是在自家团队的电脑上跑的;定价有没有补贴,说不清;测试用的工作流是自家团队搭的。而且测试基准把 GPT-6 Astra 和 Fable 5.1 的平均值当成 "正确答案",本身就偏向这两个模型。发布后的第三方指南也提醒:速度和成本数据都是自测,还没有人独立复现过。
唯一很难质疑的是 "格式错误为零"—— 因为选项是提前定死的,想错都错不了;这个说法一个反例就能证伪。
上图来自 TypeSafe 官方博客的工作流测试:横轴是单次工作流成本,纵轴是准确率。
06它在 AI 工作流里站什么位置
一句话:Jev 是负责 "快速判断" 的那一层,不是来替代大模型的。
常见的搭法叫 "级联":Jev 在最前面,低成本完成分类和路由;能处理的由确定性代码处理;少数难啃的,再交给最顶尖的大模型。每个操作还可以设不同的 "把握度门槛":便宜的、只读的判断,把握高就自动执行;代价大的判断,要人工确认;把握低的,转给人或大模型。
这样做的好处:省下大量昂贵的大模型调用,而且 "机器自己决定了" 和 "需要人看一眼" 之间,有一条清晰、可追溯的线。
07总结
Jev 是个少见的思路:它把 AI 做成了一种像 "函数调用" 一样的东西,而不是聊天机器人。如果它在厂商自己的测试之外表现同样好,这类模型有望接管现在硬塞在大模型提示词里的上百万个小判断。
不过现在它还在早期访问阶段,只支持文字,所有性能数据都是厂商自报,“是骡子是马”后续拉出来溜溜就知道了。
#Jev #TypeSafeAI #SystemOne #AI自动化 #智能体工作流 #决策模型 #工单分类 #置信度路由