ARTICLE · 1059319
AI 给全生命之树建了张通用细胞地图
AI 给全生命之树建了张通用细胞地图想象一张地图,上面不只标着城市,而是标着每一个曾经活过的细胞——你肝脏里的一个肝细胞、酵母里的一个出芽细胞、海绵身上的一根领细胞、青蛙视网膜上的一颗感光细胞。它们彼此相距亿万年进化,却能被放到同一个坐标系里,让你一眼看出"谁和谁更像"。 这样一张地图,以前只存在于生物学家的想象中。而就在最近,两篇同期发表于《自然》与《科学》的论文,把它变成了现实[1][2]。它们用的是同一个朴素的野心:给全世界的细胞,建立一个通用的坐标空间。 
▲ 通用细胞坐标空间:每一种细胞都是空间里的一颗光点,距离即相似度 细胞是生命的基本单位。奇妙之处在于:同一个人的每一个细胞,都携带同一套基因组,但它们打开的基因完全不同。胰腺的 β 细胞打开胰岛素相关基因,B 细胞打开抗体相关基因,皮肤细胞打开毛发与色素相关基因——正因打开的"程序"不同,细胞才分成千百种类型。 过去十几年,单细胞 RNA 测序(scRNA-seq)让科学家第一次能数清每个细胞"打开了哪些基因"。数据量爆炸式增长:数万条基因、数亿个细胞。听起来壮观,却带来一个现实难题——这么多信息,人脑已经处理不过来了。斯坦福生物工程教授 Stephen Quake 说得直白:"人类大脑不可能做到。而 AI 模型就是来帮我们做这件事的。"[3] 更麻烦的是"对齐"问题。不同实验室、不同组织、不同物种的细胞,用的是各不相同的基因命名体系;想把"人的神经元"和"酵母的细胞"放进同一个比较框架,传统方法几乎束手无策。早先的基础模型(如 scGPT、Geneformer、scFoundation、SATURN)虽然能处理单细胞数据,但换一个数据集、换一个物种,往往就得重新标注、重新训练——表示根本不"通用"。 这一次的突破,是两篇"搭档"论文,同期登上《自然》与《科学》,由斯坦福的 Stephen Quake、Jure Leskovec,以及陈-扎克伯格倡议(CZI)的 Theofanis Karaletsos 共同牵头。第一作者方面,《自然》篇由 Yanay Rosen 与 Yusuf Roohani 共同担任;主导《科学》篇 TranscriptFormer 的则是 James D. Pearce[1][2]。 两个模型分工清晰,像一套组合拳: UCE(Universal Cell Embedding,《自然》)先"建立坐标" ——它把来自不同实验室、不同组织、甚至不同物种的细胞,都投进同一个抽象的数学空间,距离近即关系近、距离远即差异大。 TranscriptFormer(《科学》)在其上"完形填空" ——它像一个生成式模型,学会了细胞"应该长什么样",从而能做预测、做计算机模拟扰动。 Quake 对这项工作的期许,几乎是在宣告一个新领域的诞生:"这些论文标志着,我们希望,一个全新领域的开端,以及十年的工作。"[3] 而他另一句更形象的话是:"地球上每一个生物体的所有细胞,都可以坐进那个空间里,你能看清它们彼此的关系。" 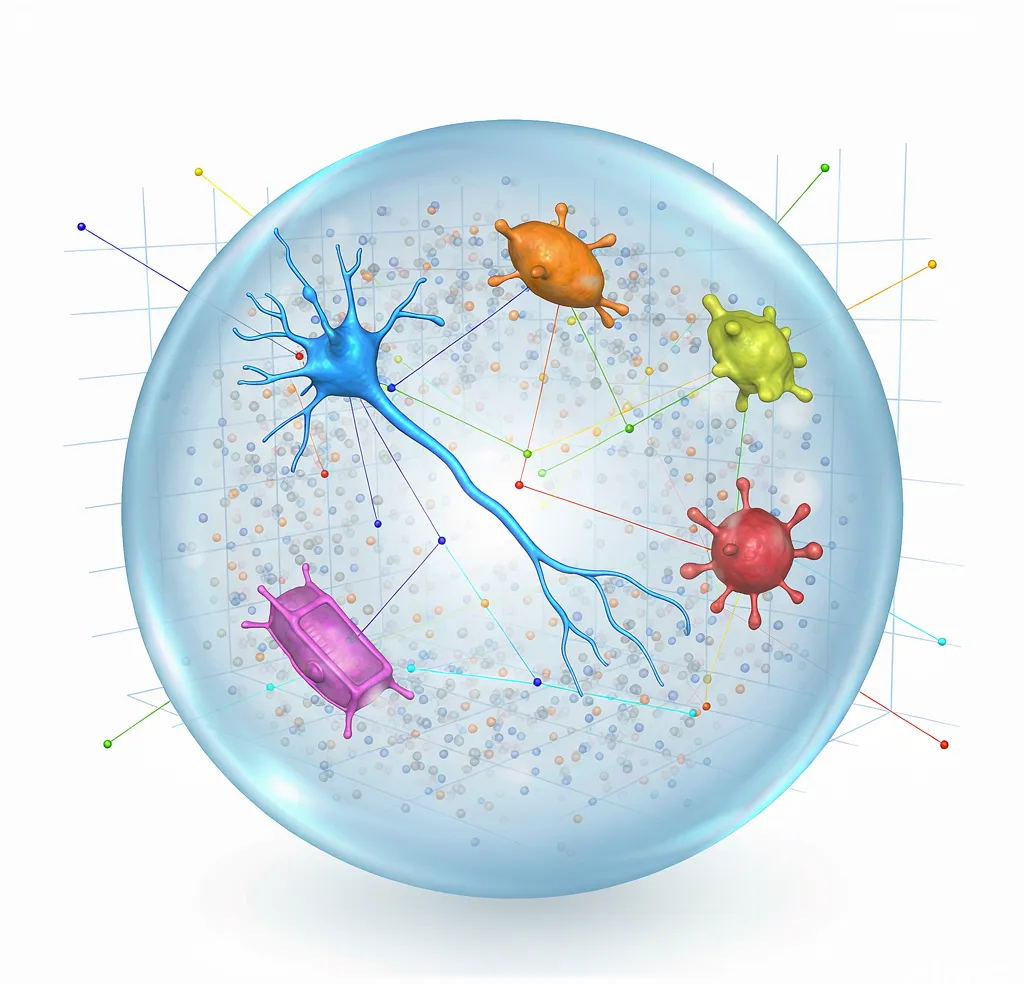
▲ 把神经元、酵母、海绵、免疫细胞同时丢进同一坐标空间,相似者自然聚拢 UCE 是一个零样本(zero-shot)基础模型,专门为单细胞基因表达数据设计。它用自监督学习在大规模细胞语料上训练,构建出一个统一的、有生物学意义的隐空间[1]。 规模本身就有说服力:UCE 的训练数据涵盖3600 万个单细胞转录组,横跨8 个物种——人、小鼠、鼠狐猴、斑马鱼、猪、食蟹猴、恒河猴、西非爪蟾。作者用 UCE 构建了"Integrated Mega-scale Atlas"(超大规模整合图谱),把3600 万细胞、1000 多个具名细胞类型、数百个实验、数十种组织、8 个物种一并嵌入同一个空间。 但真正的技术巧思,在于它怎么"看懂"不同物种的基因。UCE 把单细胞 RNA 抽象成一个"RNA 袋"(bag of RNAs),再结合由大语言模型生成的蛋白质嵌入。这一步是关键:它让模型可以对任意物种的任意蛋白编码基因做表示——哪怕这些基因在训练时从未以同源基因(homologue)的形式出现过。换句话说,UCE 不需要你先告诉它"人的这个基因对应老鼠的哪个基因",它自己就能对齐。 零样本意味着什么?传统方法每来一个新实验、一批新数据,就得重新做耗时的标注和模型训练。UCE 的"通用性"在于:新细胞可以被直接嵌入,无需任何数据标注、无需模型再训练或微调,甚至对训练集中根本没出现过的物种,也能给出有意义的表示。这种"即插即用"的通用坐标,正是细胞生物学一直缺少的工具。 更令人惊讶的是涌现行为:UCE 的嵌入空间自发地识别出了它从未被训练去识别的生物学结构——比如细胞类型的发育谱系,以及那些未参与训练的物种的数据,也能被合理地安放进空间。一个为"表示"而训的模型,顺手把"发育"和"进化"也学了出来。 如果说 UCE 负责"定坐标",TranscriptFormer 则负责"建词典、造句、并预测下一句"。它的训练规模更惊人:1.12 亿个细胞,跨越12 个物种,进化跨度达15.3 亿年——从人类到酵母,再到疟原虫[2]。 它的核心架构思路,和训练一个大语言模型如出一辙。TranscriptFormer 把每个转录组当成一条"细胞句子",预测"在已知前面若干基因的条件下,下一个基因及其表达量应该是什么"——这正是自然语言处理里的 next-token prediction,只不过这里的"词"是基因。它用 ESM-2 蛋白质序列嵌入,把基因映射到一个不依赖同源基因(orthology-free)的共享空间,从而让远缘物种的基因也能直接比较。 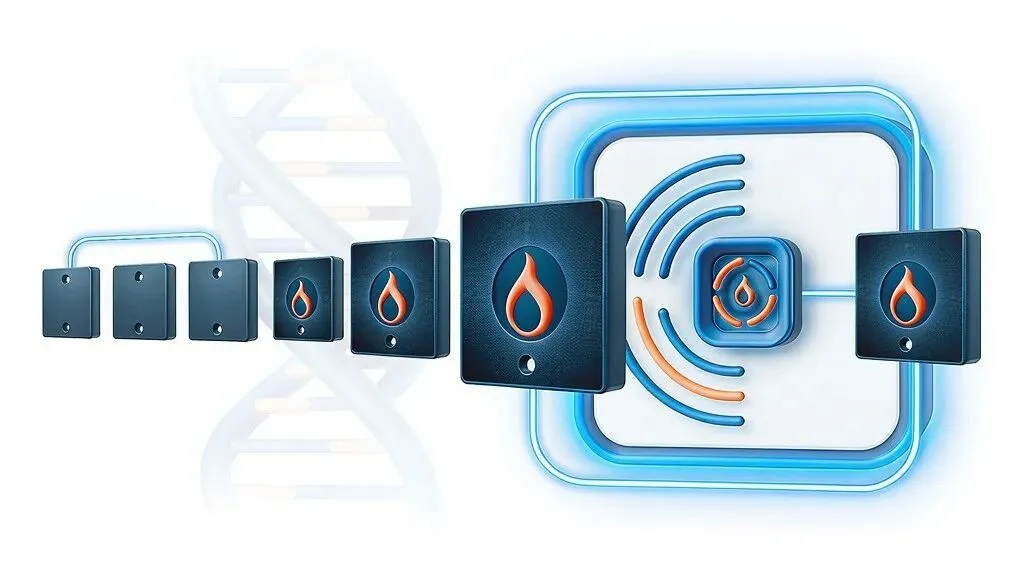
▲ TranscriptFormer 把转录组当作"句子":基因是词,表达量是词义,模型预测下一个基因 作者训练了三个变体,规模清晰可查:
能力表现同样硬核: 细胞类型分类达到 SOTA:即便两个物种的进化分离超过6.85 亿年,分类 F1 仍维持在 0.65–0.91,显著优于 UCE、scGPT、Geneformer 等前作。 零样本疾病识别:无需任务专用训练,就能跨供体识别 SARS-CoV-2 感染状态;在 Tahoe-100M 数据集中,识别出95 种化合物诱导的转录变化。 跨物种注释转移:小鼠、大鼠、兔、猪的巨噬细胞炎症反应,相互转移时 F1 > 0.92;脊椎动物的精子发生细胞类型,在分歧达3.1 亿年的物种间仍能准确映射。 无监督涌现结构:发育阶段按规范分化顺序自动排布;嵌入空间的相似性,与进化距离显著相关——系统发育关系自己"长"了出来。 生成式提示与调控预测:预测转录因子靶标与基因-基因互作,与 STRING 数据库的独立实验验证一致——相当于一种"计算机模拟扰动"。 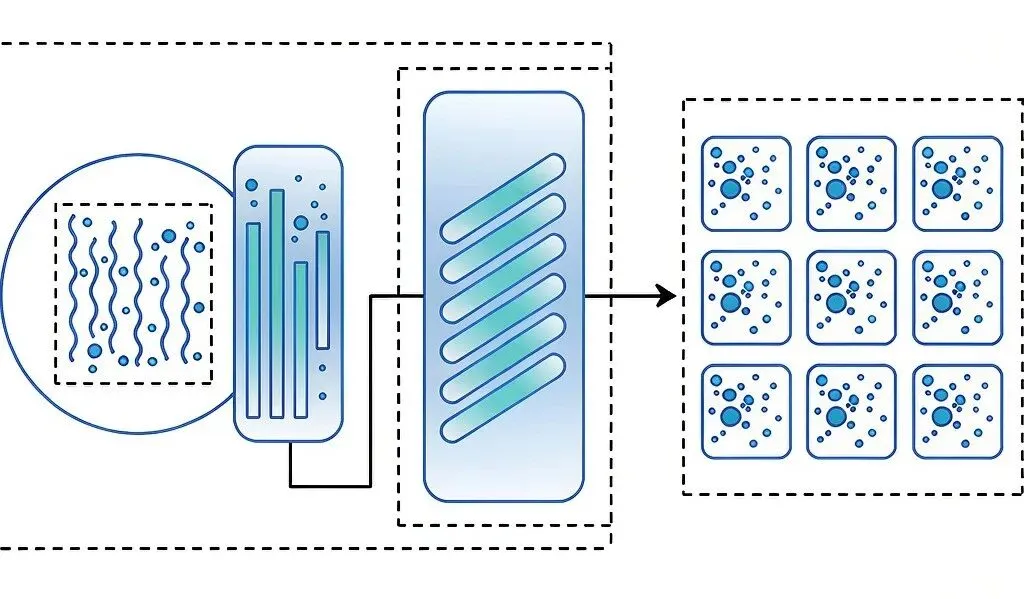
▲ UCE 的表示架构:RNA 袋 + 蛋白质嵌入 → 统一隐空间 → 跨物种共享坐标 这两个模型最让我着迷的,不是某个准确率数字,而是一个它自己发现的生物学洞察。模型从没被教过"功能类比"这件事,却在表示空间里自发地把海绵的领细胞(choanocyte)——一种带鞭毛领、负责滤食的古老细胞——放到了线虫和青蛙神经元的附近;而海绵的"神经样细胞"(neuroid),反而更靠近青蛙的腺体,暗示它可能在服务消化而非神经功能[3]。 这背后是"功能性收敛":在进化树上相距极远的生物,独立演化出了相似的功能角色。过去,这类发现要靠生物学家多年积累的领域直觉;现在,AI 从数亿细胞的表达模式里,自己读出了这条线索。同样的,发育阶段在没被标注的情况下按规范顺序排布,系统发育的远近也直接映射成空间距离的远近。 
▲ 模型自发发现:海绵领细胞与线虫/青蛙神经元在表示空间里"邻近"——功能性收敛 这两篇论文之所以值得在"重大突破"意义上认真对待,有三点理由。 第一,是一次干净的范式迁移。自监督预训练 → 通用表示 → 涌现能力,这套从自然语言处理里跑通的打法,第一次如此干净地搬到了细胞生物学。"细胞有自己的语法"不再只是比喻:TranscriptFormer 把基因当词、把细胞当句子,用 next-token 的方式学出了转录组的"概率语法"。 第二,它真的"通用"。之前的单细胞基础模型,跨物种、跨数据集往往要重训;UCE 与 TranscriptFormer 做到了零样本跨物种、跨实验对齐。UCE 甚至不要求同源基因对齐,直接对任意蛋白编码基因做表示。这种"一个坐标、通吃全树生命"的能力,是地基性的。 第三,它不只是个分类器。凭借生成式架构,TranscriptFormer 支持计算机模拟扰动(in-silico perturbation)、跨物种药物响应预测、演化细胞生物学探索——它是一台"可查询的虚拟生物学仪器",而不只是一张静态的细胞标签表。 放到更大的图景里看:就在同一周,我们已经见证了虚拟药企(用数万个智能体编排药物研发)、基因基础模型(用系统发育先验以 2 亿参数碾压 400 亿参数对手)等 AI4S 突破。但 UCE 与 TranscriptFormer 处在更底层——它们是表示层的地基:先把"细胞是什么"这件事讲清楚,上层应用才站得稳。 作为一篇深度分析,也必须把边界说清楚,免得滑向 hype。 它是表示/嵌入工具,不是因果模拟器。 模型预测的基因互作、功能类比,仍是相关性线索,最终要靠湿实验(如蛋白表达干预、类器官药敏)确认。论文本身也用实验检验了模型提出的耐药线索,走的是"预测→实验验证"的闭环,而非"AI 直接下结论"。 "15.3 亿年"是训练物种的分歧跨度,代表数据覆盖的进化广度,并不意味着模型预言了所有生物学。 基础模型的老问题它也有:依赖训练数据的质量与偏差,表示可能携带数据中的系统性偏见,也可能出现"幻觉式"的近邻关系。把它当科研放大镜,而不是最终裁判。 抛开生物学,这两篇论文对做模型、做产品的人也有启发: ① 通用表示比单任务模型更有杠杆。UCE 不解决某一个具体问题,它提供"坐标"。有了坐标,分类、注释、疾病检测、跨物种映射全都能零样本派生。做产品也是一样——先把领域的"通用表示层"打牢,上层功能会自己长出来。 ② 自监督 + 规模,能涌现跨域能力。没有一条标注说"海绵细胞像神经元",但 1.12 亿细胞、15.3 亿年进化跨度喂出来的表示,自己浮现了功能类比。规模不是目的,规模带来的"语法完整性"才是。 ③ 把领域知识编进架构,比堆参数更关键。用 LLM 生成的蛋白质嵌入、用 ESM-2 做 orthology-free 对齐、用进化距离做偏置——这些"懂行"的设计,才是跨物种成立的根本原因,而非单纯把参数量做大。 对正在做"数据综汇系统"这类产品的团队而言,这其实是一个同源的方法论样板:先建立领域统一的"坐标空间",让异构数据无需逐库重训即可对齐,上层应用才能既快又稳地长出来。 如果你对"通用表示 / 世界模型 / 智能演化"这条线感兴趣,推荐两本作者自有书籍(公众号文章不支持外链,请自行复制链接到浏览器): 《世界模型》——理解下一代 AI 的认知基础 https://leanpub.com/World-Model 《智能进化论》——理解 AI 智能正在如何演化 https://leanpub.com/Intelligent-Evolution Rosen Y., Roohani Y., Agrawal A., Samotoran L., Quake S. R., Leskovec J.Universal cell embedding provides a foundation model for cell biology.Nature, 2026. DOI: 10.1038/s41586-026-10689-z Pearce J. D., Simmonds S. E., Mahmoudabadi G., et al. (Karaletsos T., Quake S. R. 共同通讯).TranscriptFormer: A generative cell atlas across 1.5 billion years of evolution.Science, Vol. 393, Issue 6806, 2026. DOI: 10.1126/science.aec8514 Stanford Medicine / EurekAlert 新闻稿(2026-09),Quake 教授引语出处;medlabportal 对两模型跨物种比较的报道。 Chan Zuckerberg Initiative.TranscriptFormer开源代码与模型:github.com/czi-ai/transcriptformer(含 TF-Metazoa / TF-Exemplar / TF-Sapiens 三变体的参数与词表细节)。
给地球上每一个细胞,发一张"世界地图"
一、一个困扰生物学家几十年的老问题
生物学家早就习惯把细胞想象成某种"通用地貌"上的点。最著名的就是 Waddington 景观:干细胞像山顶的水珠,顺着发育的斜坡,最终流进一个个代表终末分化细胞的"山谷"。问题是,这座景观一直只存在于比喻里。
二、两篇论文,同一个野心:给所有细胞一个"通用坐标"
三、UCE:把全世界的细胞,放进同一个坐标系
四、TranscriptFormer:把转录组写成"句子",让细胞自己说话
五、最迷人的发现:海绵细胞,竟"像"神经元
这正应了 Quake 的那句话:"地球上每一个生物体的所有细胞,都可以坐进那个空间里,你能看清它们彼此的关系。"当表示空间足够通用,跨物种的"亲戚关系"会自己浮现。