ARTICLE · 1061380
长文档摘要新玩法:模拟学术评审的专家-编辑多智能体,逐步提问打磨摘要
长文档摘要新玩法:模拟学术评审的专家-编辑多智能体,逐步提问打磨摘要
做过长文档摘要的同学,大概率都踩过这些坑:文档太长塞不进上下文,分段再聚合又容易丢逻辑、漏重点;单模型写出来的摘要要么信息不全,要么细节出错,和原文对不上。
传统的思路要么卷模型上下文长度,要么卷分段聚合策略,但本质都是“一次性生成”,生成完就结束了。那能不能像人写文章一样,写完初稿,有人从内容上提意见,有人从文字上把把关,改几轮质量就上去了?
最近这篇论文就借鉴了学术评审的思路,提出了一个专家-编辑逐步提问多智能体框架(SQ2E):让写初稿的作者Agent,先被专家Agent从语义内容上提问打磨,再被编辑Agent从文字一致性上检查修正,每轮提问都引导作者反思和修改摘要。实验显示,这种方法在多个长文档数据集上都比直接生成、分段聚合的效果稳定更好。
一、为什么要做逐步提问的多智能体?
长文档摘要的难点从来不是“写”,而是“抓重点”和“保准确”。文档长度一上来,模型的上下文处理能力跟不上,很容易出现信息遗漏、事实偏差。传统的分段-聚合方法,把文档拆成块分别摘要再拼起来,很容易丢失整体逻辑,块与块之间的衔接也容易出问题。
而多智能体的思路,是用分工协作代替单模型一次性输出。之前的研究已经证明,多角色、多轮迭代的智能体协作,在长文本生成、复杂推理上都比单模型表现更好。但在长文档摘要这个场景,怎么设计协作流程才最有效?
这篇论文的核心观察很有意思:针对性的提问,能刺激大模型重新审视自己生成的内容,发现之前没注意到的问题。比如问一句“原文里的关键术语有哪些?”,模型就会回去核对,把遗漏的关键信息补进摘要里。论文里的图1就展示了这个简单的例子:
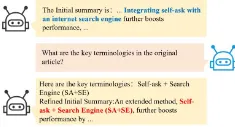
图1 提问引导摘要优化的示例
原本的初稿只笼统提了方法,一问关键术语,模型就把具体的缩写和定义补进去了,摘要立刻更准确。
就这么简单的一个提问,比直接让模型“重写更好的摘要”效果还好。因为大模型有时候不是不会写,而是不知道该往哪个方向改,给一个具体的问题,就给了它明确的优化方向。
二、核心方法:专家-编辑四角色框架
基于这个思路,论文设计了完整的多智能体工作流,整体架构如图2所示,一共四个角色:作者、专家、编辑、评估者,流水线式协作。
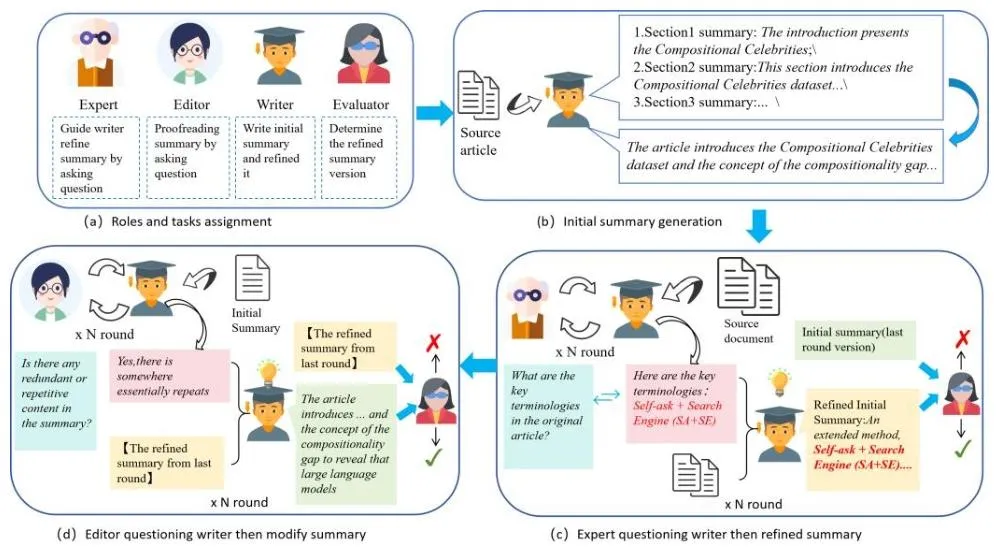
图2 专家-编辑逐步提问多智能体整体流程
四个角色分工很清晰,完全对应学术出版的流程:
1. 作者(Writer):负责撰写初始摘要,以及根据提问修改自己的摘要。 2. 专家(Expert):聚焦语义内容,比如核心观点完不完整、关键信息有没有遗漏、和原文主旨对不对,负责提出内容层面的问题。 3. 编辑(Editor):聚焦文字层面,比如语法错误、事实一致性、表述准不准确,负责提出格式和文字校验类问题。 4. 评估者(Evaluator):每改完一版,评估者对比新版本和旧版本,判断修改有没有提升质量,好就保留新版本,不好就维持上一版。
整个流程分三步推进,先写初稿,再改内容,再校文字:
第一步:生成初始摘要
先采用最朴素的分段聚合思路:把长文档按章节拆成文本块,作者Agent给每块写局部摘要,再汇总成整篇文档的初始摘要。这就是后续待打磨的初稿。
第二步:专家提问,内容层面优化
专家先根据原文和初稿,制定提问计划。问题都是围绕摘要的核心质量维度设计的:完整性、连贯性、相关性、事实一致性。不是所有问题都一股脑抛出来,而是逐步提问。作者每回答一个问题,就反思一下自己的摘要需不需要修改,改完之后,评估者判断这版是不是更好。专家一轮最多提5个问题,可以多轮迭代。
这一步的核心是,用提问代替直接给修改意见。相比直接说“你这里写得不对”,问一个具体的问题,引导模型自己去原文里找答案、自己修正,效果更好,也不容易引入新的错误。
第三步:编辑提问,文字层面校验
专家改完内容,编辑再上场。编辑的问题更偏向事实核对和文字校验,而且采用是/否的简洁格式,比如“摘要里的数值和原文一致吗?”“有没有语法错误?”作者对照原文核对,有问题就修改,没问题就保持原样。同样每轮之后评估者做对比筛选。编辑一轮最多提4个问题。
为什么要分开专家和编辑两个角色?因为内容和文字是两个维度的优化。混在一起的话,模型很容易顾此失彼;分开逐步来,先保证内容对,再保证文字准,优化方向更清晰。
三、实验效果怎么样?
论文在两个经典的科学文献长文档数据集上做了实验:Arxiv和PubMed,文档长度统计如下表:
都是几千词的长文档,摘要只有两百词左右,属于典型的长文档短摘要场景。
测试了三个模型:Llama 3.1 8B、Llama 3.1 70B、DeepSeek-R1,对比了三种方法:直接生成(DG)、HERA基线方法、以及本文的SQ2E方法。评价指标用了ROUGE-1/2/L、BERTScore、FactCC,分别覆盖词汇重合度、语义相似度、事实一致性。
核心实验结果如表3所示:
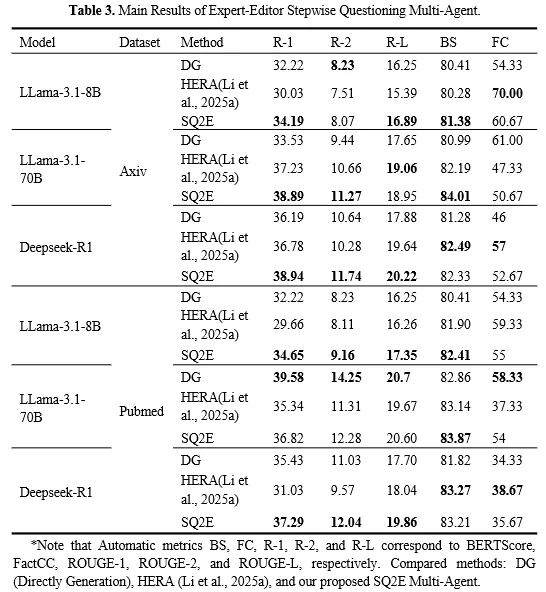
表3 主要实验结果
以Arxiv数据集上的Llama 3.1 8B为例:
• 直接生成的ROUGE-L是16.25,BERTScore 80.41,FactCC 54.33 • SQ2E方法的ROUGE-L是16.89,BERTScore 81.38,FactCC 60.67
各项指标都有提升,尤其是FactCC提升很明显,说明事实准确性提高很多。DeepSeek-R1上提升也很稳定,ROUGE-L从17.88提升到20.22,BERTScore和FactCC也有上涨。
比较有意思的是Llama 3.1 70B的结果:ROUGE和BERTScore提升了,但FactCC反而下降了。论文推测可能是70B模型推理时的精度损失,和实验算力限制有关。这也侧面说明,好的Prompt设计和协作流程,有时候能让小模型逼近大模型的效果。
论文还统计了每轮有效提问的数量,如图3所示:
图3 专家和编辑的有效提问数量
专家的提问平均能带来3-4次有效优化,编辑的提问能带来2-3次有效修订。说明两个角色的提问都起到了实际作用,不是无效的轮次。而且不同模型、不同数据集上的有效提问数很稳定,说明这套提问机制的通用性不错。
四、价值与局限
总的来说,这个工作最值得参考的地方,是它没有堆复杂的Agent架构,也没有卷更大的模型,而是用很朴素的「逐步提问+角色分工」思路,就提升了长文档摘要的质量。
它的核心逻辑其实是:不要让模型一次做对,而是给它明确的优化方向,让它一步步改对。比起直接给一个“写得更好”的模糊指令,一个个具体的问题,就是一个个明确的优化抓手。
对于做落地的团队来说,这个思路的可复制性很强:不需要复杂的多智能体编排,不需要额外训练模型,只需要设计好角色、问题清单和评审流程,用现成的模型就能搭起来,落地成本很低。
当然也有局限:比如目前只在科学文献数据集上验证了,其他类型的长文档(比如报告、合同)效果还不确定;提问的数量和顺序还是预设的,还做不到完全动态自适应;评估者的判断也可能存在偏差。
未来可以优化的方向也很多:比如让模型自己动态决定该问什么问题、问几个,而不是固定上限;比如加入检索增强,提问的时候直接定位原文段落,核对更准;再比如把这种逐步提问的思路拓展到其他长文本生成任务。
结语
总的来说,这篇论文给长文档摘要提供了一个很务实的多智能体思路:不追求单模型一步到位,而是用角色分工+逐步提问的方式,模拟人工审稿的流程,一步步把摘要磨准。
很多时候我们做AI生成效果优化,总想着换更大的模型、用更复杂的算法,但其实有时候,把生成流程拆成“初稿-提问-修改-评审”的步骤,给模型明确的优化方向,用小模型也能做出不错的效果。
如果你在做长文档处理、智能体协作相关的工作,这种“提问引导迭代”的思路,很值得借鉴到你的方案里。
https://arxiv.org/pdf/2607.10390