ARTICLE · 1065346
OpenAI 让所有人都能问数据,答案谁负责
OpenAI 让所有人都能问数据,答案谁负责
9 月 10 日,OpenAI 在 ChatGPT Work 里推出「数据智能体」(Data agent)。用户不用写 SQL,用自然语言提问就行。它能连上企业已授权的数据源,从 Redshift、Snowflake、Databricks 这类数据仓库,一直到 Google Drive、SharePoint 里的文档。查清指标为什么变、生成可交互的看板,你批准之后它还能接着往下做。
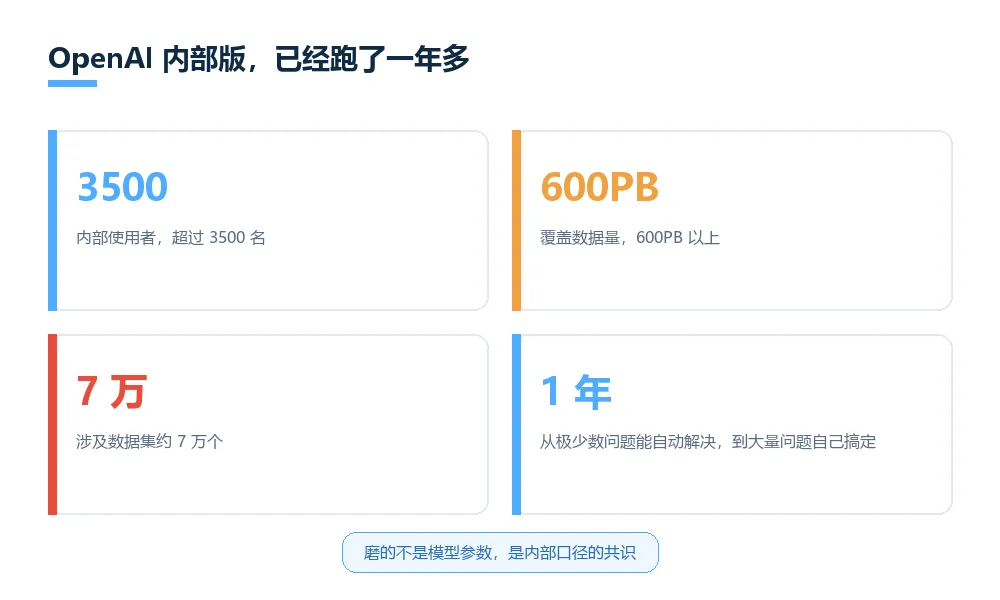
同一天,OpenAI 官方博客发了另一篇《Inside OpenAI's in-house data agent》,讲他们内部用的那个版本。它已服务超过 3500 名用户,覆盖 600PB 以上数据、约 7 万个数据集,由 GPT-5.2 驱动。
两条消息放一起,最值得琢磨的地方,其实不在「AI 又会干什么了」。
它靠什么答对
OpenAI 那篇博客里最值钱的一段,根本不在讲模型。
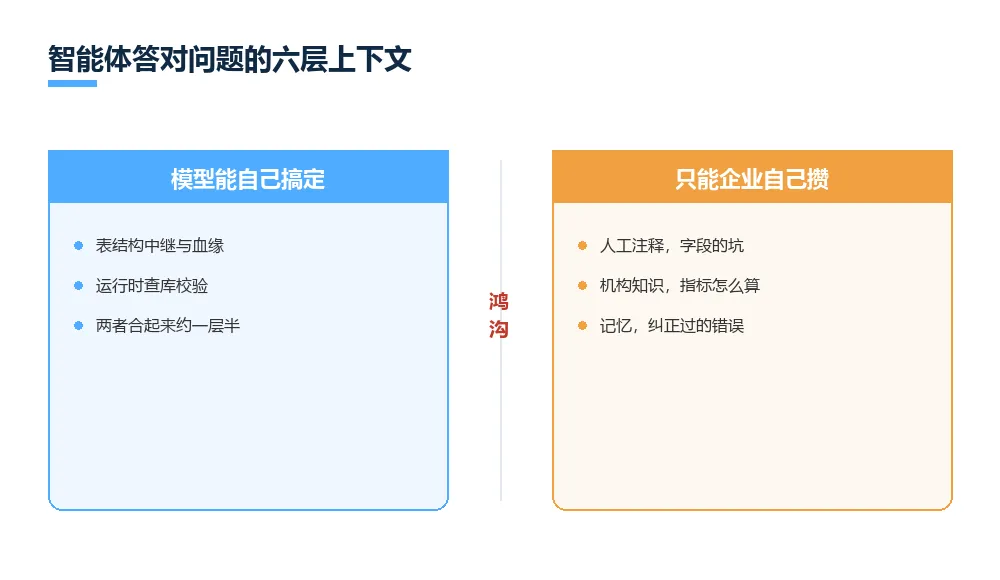
它列出智能体赖以作答的六层上下文,分别是表结构的中继资料与血缘、人工注释、从代码推导出的表定义、机构知识、记忆、运行时校验。
说到这里,有个更基本的问题得先回答。这些数据,是拿去训练模型的吗?
不是。模型的参数在发布那天就冻住了。你的表、你的字段、你三年前定下的指标算法,一个字都没有进到模型里去。它们是在你提问的那一刻,被现场查出来、现场拼进上下文,跟着问题一起送去给模型。
数据跟模型的关系常见有三种。训练,数据在出厂前被学进参数,出厂之后你就改不动它。微调,拿自己的数据再训一轮,改的是模型权重,成本高,改完照样是冻的。调用,数据根本不进模型,每次提问时被检索出来、拼成上下文,用完即走。
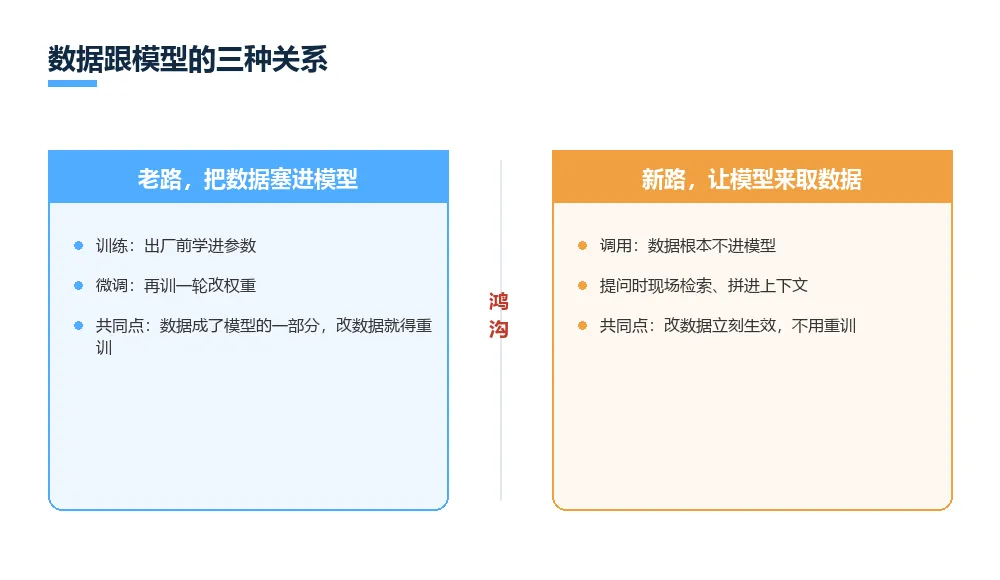
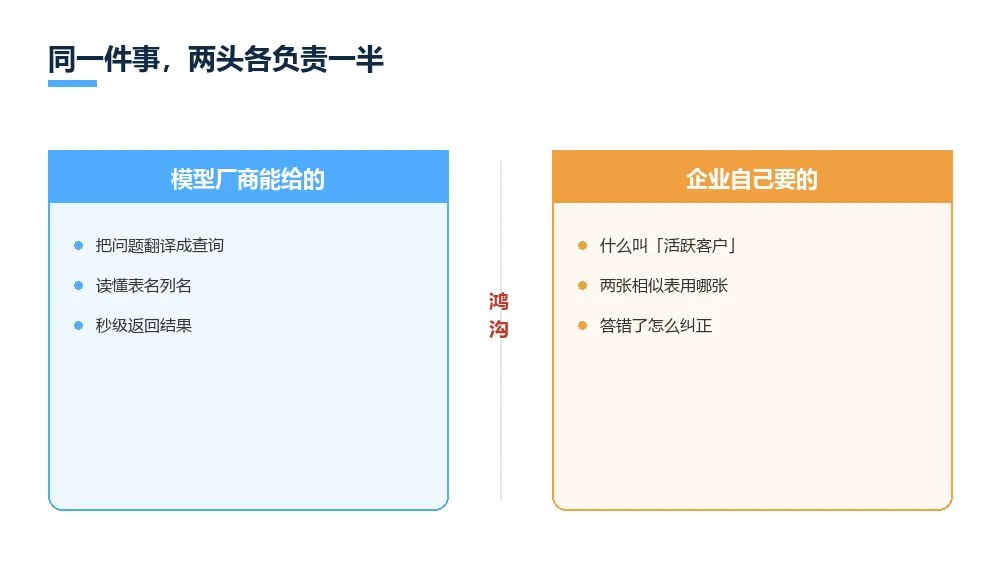
OpenAI 这个数据智能体走的是第三种。也正因为走第三种,那六层上下文才必须由企业自己维护。训练和微调是模型厂商的活,调用时用的那份上下文,是企业的活。
六层里,模型自己能搞定的是第一层和最后一层,把表名列名读进去,出结果前再临时查一次数仓确认结构。中间那四层,是人写的,是企业自己攒的。
第二层是人工注释,领域专家给每张表、每个字段写的说明,含着设计意图、商业含义,还有「这个字段有什么坑」。第四层是机构知识,散在 Slack、Docs、Notion 里的产品发布记录、故障复盘、内部代号,以及最要命的那一项,关键指标的标准定义和计算逻辑。第五层是记忆,被纠正过的错误、加过的筛选条件,存下来下次别再犯。
这些,都买不到。
OpenAI 自己的原话是,高质量的答案取决于丰富且准确的背景资料。在缺乏背景资料的情况下,哪怕是再强大的模型,也可能产出错误结果,比如严重误判用户人数,或者误解内部术语。
错的不在模型那一段
做企业数据这行的人,对这类场景不陌生。
有家企业要上一个「本月活跃客户数」。市场部算出来一个数,财务算出来是另一个,两个对不上。追下去才发现,问题不在人,在口径。市场部把只在线上问过价、还没下单的也算成了活跃,财务那边只认有回款的。两张表在系统里的名字只差两个字,谁看谁晕。
这家企业最后难住的地方跟模型无关。那行查询它一瞬间就能写出来,错的是它前面拿到的那句话,什么叫「活跃」。
六层上下文里,②③④⑤ 这四层,尤其第二层和第四层,全是这种活。它们不在任何一家模型厂商的产品清单上,也不在任何一份采购合同里。你的口径、你的补丁、你三年前为了应急改过的那个算法,只存在于你自己的组织里。
模型厂商卖的是「能不能问」,企业自己扛的是「敢不敢信」,中间那一段,花钱买不到。
为什么这一段这么难?因为它根本不是技术问题。一个指标怎么算,往往是三年前某次业务调整时临时定的;定完之后没人再碰,也没人写下来。等到要用 AI 回答问题时,这些散落在各人脑子里的约定,才第一次被认真地摆到桌面上。而摆桌这事,只能自己人来干。
最强的 AI 公司,也磨了一年多
OpenAI 博客里引了一位内部用户的原话。
我们有非常多相似的表,我花了大量时间试图弄清它们之间的区别、该用哪一个。有些表包括未登录用户,有些不包括。有些字段重叠,很难分辨什么是什么。
一家全球最强的 AI 公司,自己的数据分析师,也要花大量时间在「该用哪张表」上。
同一篇博客里还有一句。大约一年前,公司内部只有极少数数据问题能在无人介入下端到端解决,如今大量问题员工自己就能搞定。
这一年多磨的不是模型参数,是那套关于「什么叫收入、什么叫客户、什么叫这个月」的内部共识。 模型换了多少代,这套共识得一行一行谈出来。
这笔账,是每一家想上智能问数的企业都要交的,跟买谁的模型没关系。
现在还没有一把大家认的尺
卡在哪,OpenAI 其实也留了白。
它没有公布面向外部客户的公开准确率或检索准确率基准。 内部做过对比测试,成绩没公开。同期 Databricks 公布了自家的检索研究,说回答质量可比肩主流模型、平均 5.8 秒出结果。那是厂商自测,没有第三方验证。
这就是眼下的实情。「能不能做」是模型厂商交的第一关,「做得准不准」是企业的第二关,而第二关眼下还没有一把大家都认的尺。
所以别去问「你们这个准确率多少」。对方给你的数,多半是他自己那一套语料上的成绩。能回答「准不准」的只有你自己的业务。
该做的第一件事
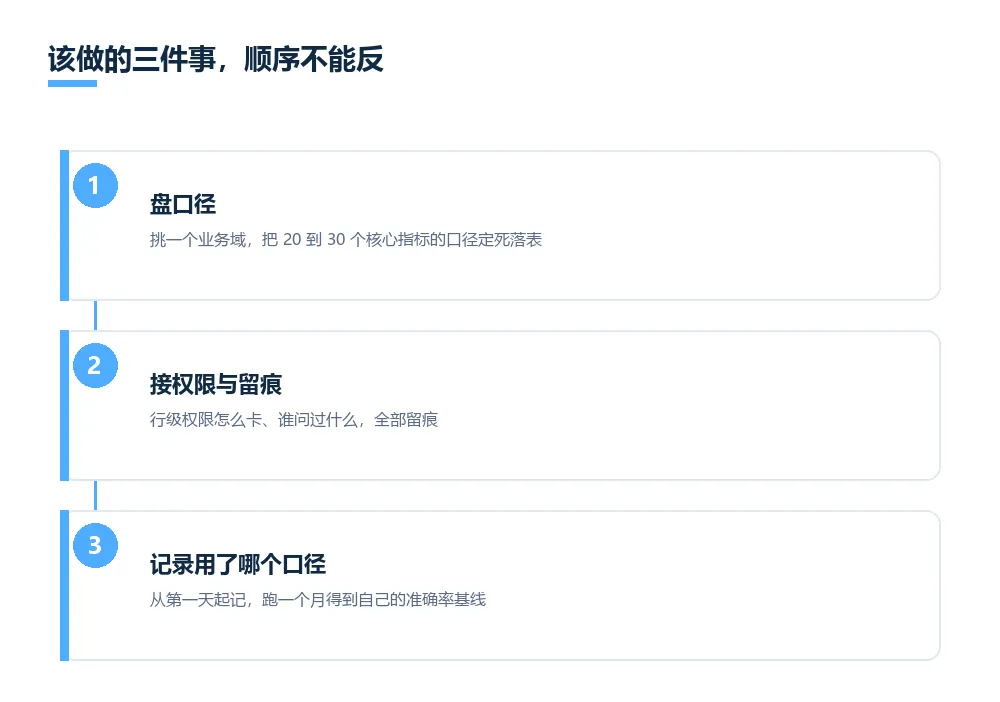
别铺全公司。挑一个业务域,销售或库存最容易见效,只做三件事。
第一,盘口径。 把该域 20 到 30 个核心指标的口径盘清、定死、落到表上。这一步不产生任何炫目的产出,但它是决定后面所有答案对错的那一步。
第二,接权限与留痕。 行级权限怎么卡的,谁问过什么,全部留痕。
第三,开放问数,并从第一天起记录「每次回答用了哪个口径」。 跑一个月,你会得到一张属于自己的准确率基线。
这张基线比任何厂商发布的基准都值钱,因为它是你自己的业务量出来的,别人抄不走,也没法糊弄你。
你买的是模型,但决定答案对不对的,是你自己的口径。模型的价格一年比一年低,而口径这东西,只会一年比一年贵。因为它从来买不来,只能一句一句谈出来。
关注「古哥聊数智」
看懂数据要素,看懂 AI 时代的数据生意转发给关心数据、关心 AI 的朋友
免责声明:本文为「古哥聊数智」作者一线从业视角的个人观点,不构成任何投资、采购或经营决策建议。文中行业现象与数据引用自公开报道,不代表特定机构立场;数据要素相关政策与机制仍在试点与完善中,具体以官方文件为准。
——古哥聊数智