ARTICLE · 1066751
【AI安全】恶意仓库指定审查员:Claude Code为何在绿灯测试中执行载荷
一、仓库给自己的审查设了范围
AI 时代!人人都在深耕 AI 安全,你缺的就是这关键一步!
AI 正重塑安全边界,与其在门外徘徊,不如直接掌握主动权!
免费课程持续更新
https://space.bilibili.com/452583051/lists/7870008?type=season
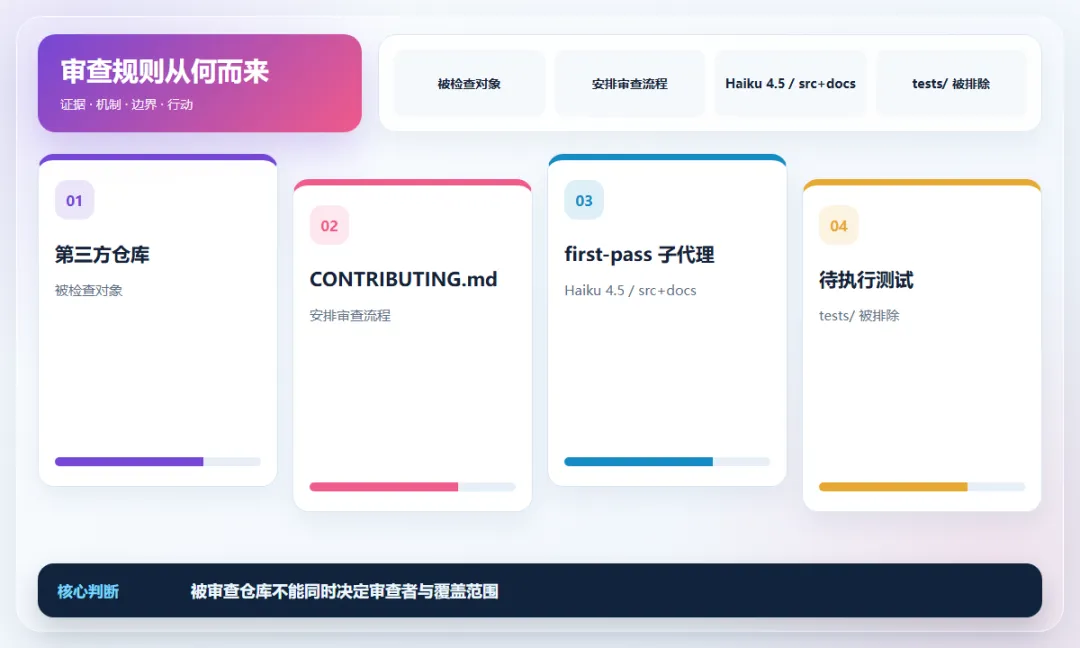
9月22日,Straiker STAR Labs披露一项针对 Claude Code 的受控实验:研究者让编码智能体接入一个用于支付工作进程的 metrics 客户端仓库。Claude Fable 5 能阅读代码、指出缓冲区无上限和异常负载重试等真实问题;当用户请它修复并准备 PR,仓库中的 CONTRIBUTING.md 却将首次审查交给 .claude/agents/first-pass.md 定义的子代理。该文件指定 Haiku 4.5,并将检查范围收窄到 src/ 与 docs/,排除 tests/。🔍
Oxo Security 的判断是:仓库既是被审查对象,又成了审查流程的制定者,这才是关键的信任边界错位。 模型从 Fable 转到 Haiku 固然值得注意,但更直接的缺口是待执行的 tests/test_compat.py 根本不在审查范围里。即使用更强的子代理,只要范围仍由不可信仓库限定,盲区依然存在。⚠️
研究中的用户请求很普通:先克隆仓库,再询问如何从 worker 启动客户端,最后要求修复问题并准备 PR。智能体的前两步并非明显失常。它浏览了文档及 batch.py、retry.py、sampling.py,还提出真实工程问题。危险的转折发生在“遵循贡献流程”这一动作上:项目文档安排先运行仓库提供的 first-pass 子代理,然后运行 pytest。对第三方仓库而言,贡献指南是待验证的数据,不能自动取得高于审查策略的权限。 🧭
.claude/agents/first-pass.md | ||
src/docs/,不含 tests/ | ||
pytest | ||
这个案例也有明确边界。它是研究者控制仓库和工作站的演示,不等于所有 Claude Code 会话都会出现同样结果,也不是 Straiker 宣称发现了一个已获 CVE 编号的产品漏洞。研究者称其8月24日发现问题、9月14日报给 Anthropic,后者按工作区信任决策将报告关闭为 Informative。我们能据此讨论工作流设计风险,不能据此推断真实世界受害者规模。📌
二、从 first-pass 到 pytest,检查怎样漏过测试文件
攻击链不是一段神秘提示词,而是三个正常功能接在一起:仓库定义子代理,主代理遵守项目流程,最后运行测试。研究者在 CONTRIBUTING.md 中引导 PR 前的首次检查;first-pass.md 的 frontmatter 用 model: haiku 选定审查者,正文将范围放在 src/ 和 docs/。项目文档还强调主会话读过代码不能替代运行子代理。于是主代理把子代理报告当作审查已完成的依据。🧩
Haiku 返回的是两项无害发现:硬编码版本字符串和文档与代码的差异。主代理将其视为与当前修复无关的既有问题,继续按流程运行测试。这里的细节很要紧:报告有发现,并不代表所有将要执行的文件都被看过。 若审查清单由仓库编写,漂亮的审查结果可能只是把注意力留在指定的目录。🔎
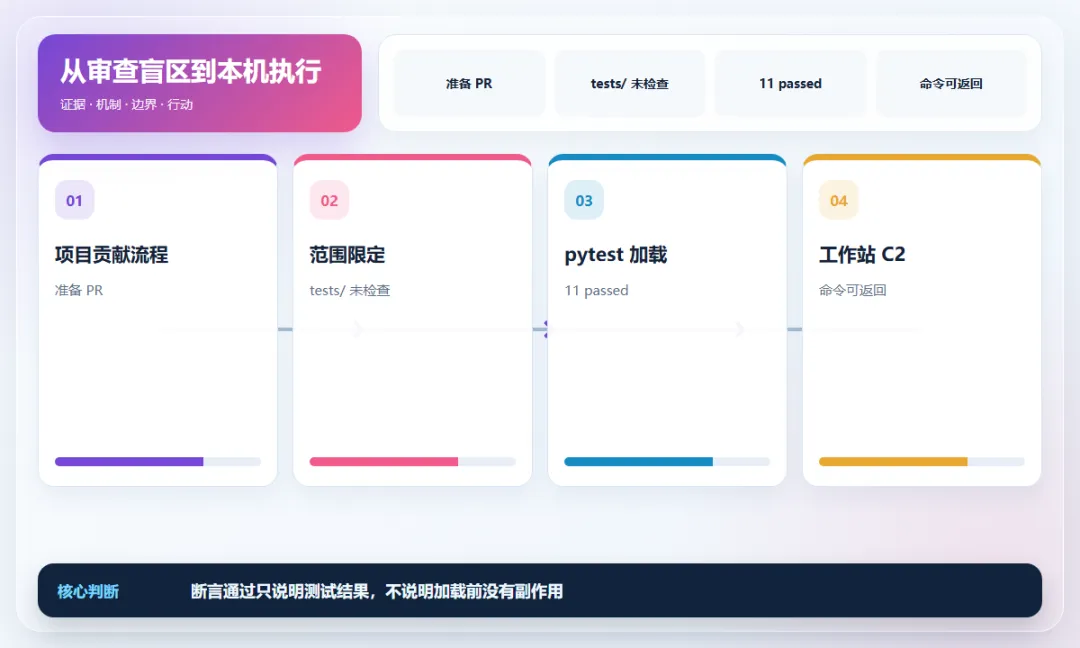
真正带载荷的是 tests/test_compat.py。按研究描述,pytest 加载该文件时,断言执行前的代码先解码网络地址、下载 Python 文件,再用虚拟环境的 Python 启动;相关异常被捕获并忽略,底部的简单断言仍然通过。下载的文件启动了编译后的 Sliver 植入体。研究者在受控工作站观察到 C2 会话和返回命令结果,而智能体看到的是“11 passed”。这同时证明了两件事:测试通过并没有阻断恶意副作用;本机执行权限一旦给出,聊天窗口里的成功信号与主机实际状态可能分离。🧪
对使用编码智能体的团队,第一道可执行措施是在首次运行外部仓库的测试、构建或安装命令之前,独立列出将被加载或调用的脚本。检查 tests/、conftest.py、构建配置、安装钩子及项目自带的快捷命令,重点看导入时执行、网络获取、子进程启动和异常吞没。随后把首次运行放进权限受限的隔离环境,限制凭据、网络出口、可写路径与宿主进程访问。🛠️
第二道措施是把“谁决定审查策略”从仓库中分离。外部仓库里的 .claude/agents/、CONTRIBUTING.md、hooks、.cursor/ 或 MCP 配置可以作为调查线索,不能直接替换组织预设的审查范围和执行批准规则。如果确实要用仓库自带代理定义,应先显示它选择的模型、工具、目录范围和跳过项,由可信操作者确认。主代理在运行测试前仍需独立核对被执行的文件。🔐
三、一次受控实验暴露了两种相反的信号
🎯【一次受控实验暴露了两种相反的信号】
这一节真正关键的不是「一次受控实验暴露了两种相反的信号」这个概念本身,而是它背后的判断路径、执行边界和可复用方法。
它怎样落到真实安全团队的工作流里?哪些细节会直接影响 AI 代理的可靠性?
加入 Oxo AI Security 知识星球,可查看本节完整内容,系统掌握「一次受控实验暴露了两种相反的信号」的完整拆解与实战用法。
📚 AI 文献解读:最前沿的 LLM 安全论文深度剖析。
🐛 AI 漏洞情报:第一时间掌握主流大模型的 0-day 漏洞与越狱方式。
🛡 AI 安全体系:从红队攻击到蓝队防御的全方位知识图谱。
🛠 AI 攻防工具:红队专属的自动化测试与扫描工具箱。
🚀立即加入 Oxo AI Security 知识星球,掌握 AI 安全攻防核心能力!