ARTICLE · 1079772
普通电脑(16G内存+8G显存)能跑 ComfyUI 吗?
最近给一位客户配了台 RTX 5090Dv2 的主机跑 ComfyUI,我也想试试现在爆火的视频生成,就用手里这台 16G 内存 + 8G 显存的游戏本跑了一下。
类似这种实际体验的文章以后还有,迎迎微信搜索关注「编程修电脑」。
结论先行
• 8G 显存能跑 ComfyUI,但必须用量化版(FP8 / GGUF),原版 FP16 会直接报显存不足;
• 8G 显存可以跑这三种任务:抠图、超分、SDXL 量化版文生图;
• 热点模型 MiniMax H3 传的「42.5GB」是显存 + 内存的总占用,不是显存需求; DeepSeek-V4.1-Flash 这种 552B 级多模态大模型本地跑需要 8 路 H200,普通消费级电脑就别想了。
ComfyUI 本地运行四步法
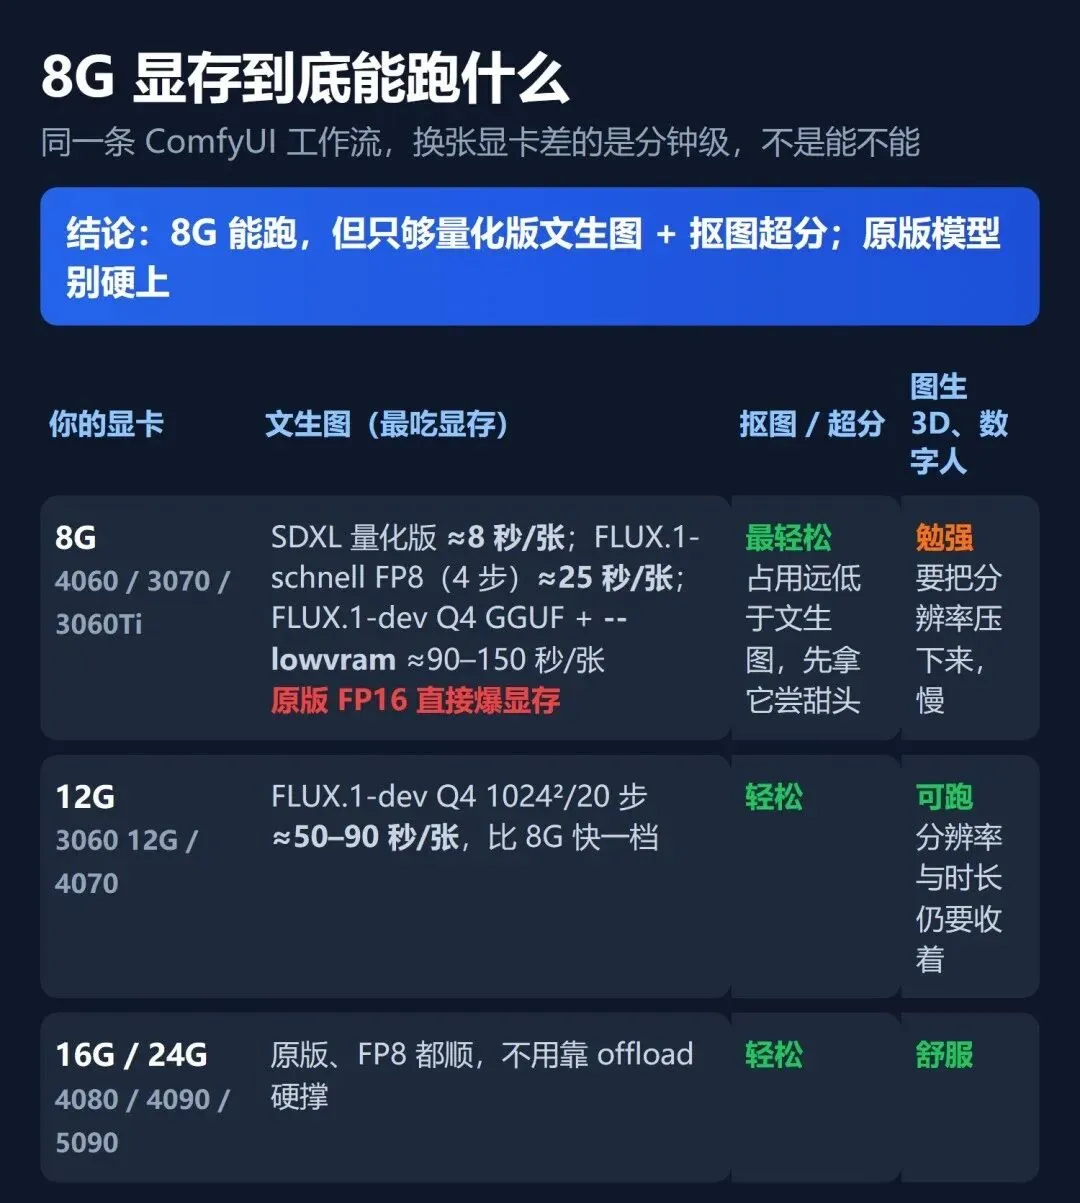
第一步,找准档位。 别急着下载模型,先看显卡。8G 显存(RTX 5060 / 4060 / 3070 / 3060Ti):SDXL 量化版约 8 秒一张,FLUX.1-schnell FP8 四步采样约 25 秒一张,FLUX.1-dev 的 Q4 GGUF 配 --lowvram 约 90–150 秒一张。12G 会明显松快,16G 以上才谈得上流畅。
第二步,装 ComfyUI、选量化模型。 ComfyUI 更新到 0.30 以上,模型优先下 FP8 或 GGUF 量化版,别下原版 FP16。图省事就从 SDXL 量化版起步。
第三步,把占用压下去。 分辨率先降到 512–768 试水,成了再往上加;启动加 --lowvram(权重分片加载,代价是慢 20–30%);LoRA、ControlNet 别一次开好几个,因为每个都要额外占用 0.5–3GB;出图时把浏览器、游戏、剪辑软件等等暂时不用的软件都关掉节省运行内存。
第四步,合理分配本地和云端的任务。 文生图、抠图、超分放本地没问题;MiniMax H3 15 秒带音频的 2K 视频,12G 卡配 64G 内存也要 20–30 分钟,24G 卡才大约 4–6 分钟。需要用到大上下文(比如1M)的任务云端跑性价比更高。
几个关键数字
• 8G 卡跑 FLUX.1-dev Q4_K_S GGUF + --lowvram,1024*1024、20 步约 90–150 秒/张;换 FLUX.2 Klein 4B(4 步)约 15–30 秒;
• 8G 档适配清单:SD1.5 约 3 秒/张、SDXL 量化版约 8 秒/张、FLUX.1-schnell FP8 约 25 秒/张;
• FLUX.1-dev-fp8 在 8G 卡上跑 1024*1024 的图,实测峰值显存占用 6.8GB(加载模型时约 3.5GB);
• MiniMax H3 全精度 123.6GB → int8 量化后 42.5GB(降 66%),是显存+内存总占用;12G + 64G 内存约 20–30 分钟出 15 秒 2K;
• 许可提醒:FLUX.1 [dev] 是非商用许可,本地生成图如果要商用需改用 FLUX.1 [schnell](Apache 2.0)或 SDXL。
FAQ
Q1:8G 显存到底够不够? 量化版文生图 + 抠图超分够用;原版 FP16 别试,一定爆。
Q2:会不会慢到没法用? 8G 出一张 1024 的 FLUX 图约 1.5–2.5 分钟;换 4 步的 schnell 或 Klein 能进十几秒。
Q3:16G 内存够吗? 文生图够;H3 等视频模型官方推荐 64G 内存起步。
Q4:要不要为了 AI 专门换显卡? 不限预算的话我也想马上换好显卡务实的话,先用手上的卡把抠图和超分跑通,有稳定生图生视频需求再加钱换卡。
Q5:本地出的图能接单吗? 技术上可以,但要注意许可:FLUX.1 [dev] 属非商用模型,如果要接单交付客户需换用 schnell。
---
本文是「普通电脑验证 AI 工作流」系列第一篇。
如果觉得这篇文章有用,请转发给身边用电脑的朋友。还没关注的话,微信搜索「编程修电脑」点个关注,每周都有维修干货;关注后回复「工具箱」领常用软件清单,回复「自救」领电脑故障排查手册。老吴在晋中大学城创业园,电脑问题搞不定随时来找我。我们也接软件开发、AI 大模型部署的单子,前端、后端、小程序、系统集成都能做,效果见我们的官网:https://www.dysonai.com
#ComfyUI #本地AI部署 #显卡显存 #AI绘画 #电脑维修