ARTICLE · 1096492
别再用RAG硬检索了:OpenKB把文档「编译」成Wiki
大家好,我是Zack。
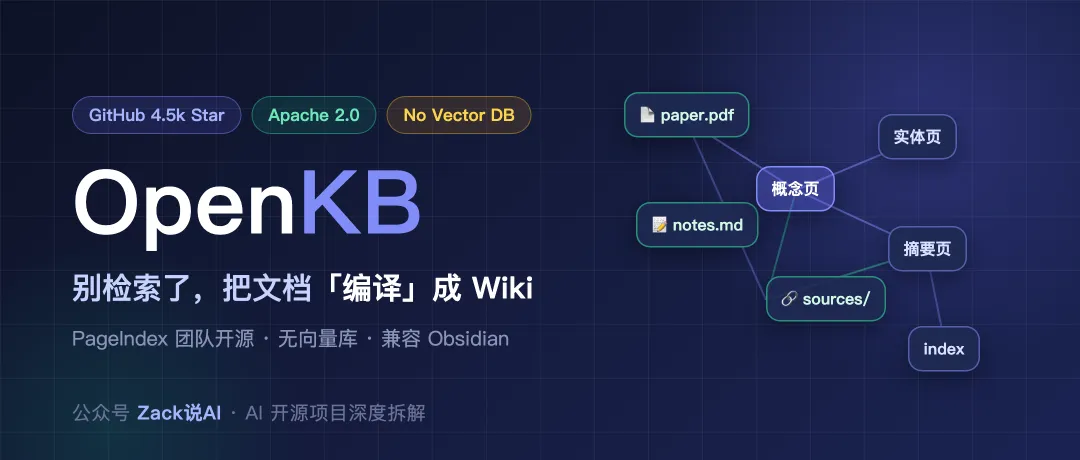
这周在 GitHub 刷到一个项目:OpenKB,PageIndex 团队(VectifyAI)出品的开源 LLM 知识库,4 月份创建,现在 4.5k Star、Apache 2.0 协议,更新很勤。
一句话:它不玩传统 RAG 那套「切块 + 向量 + 检索」,而是用 LLM 把你的文档「编译」成一个不断长大的 Wiki。对,不用向量库。
传统 RAG 的流程你肯定熟:文档切块 → Embedding → 存向量库 → 查询时召回 top-k → 塞给 LLM。这套流程有个天生的毛病:知识从不积累。你问 100 次,它就重新「发现」100 次知识;两份文档说法打架,也没人负责标记。
OpenKB 的思路是把「检索」变成「编译」:文档加进来的时候,LLM 一次性把它消化成 Wiki 页面——摘要页、概念页、实体页,互相交叉链接。之后查询,LLM 是在一个已经整理好的知识网络上做推理,而不是在碎块堆里捞 needle。
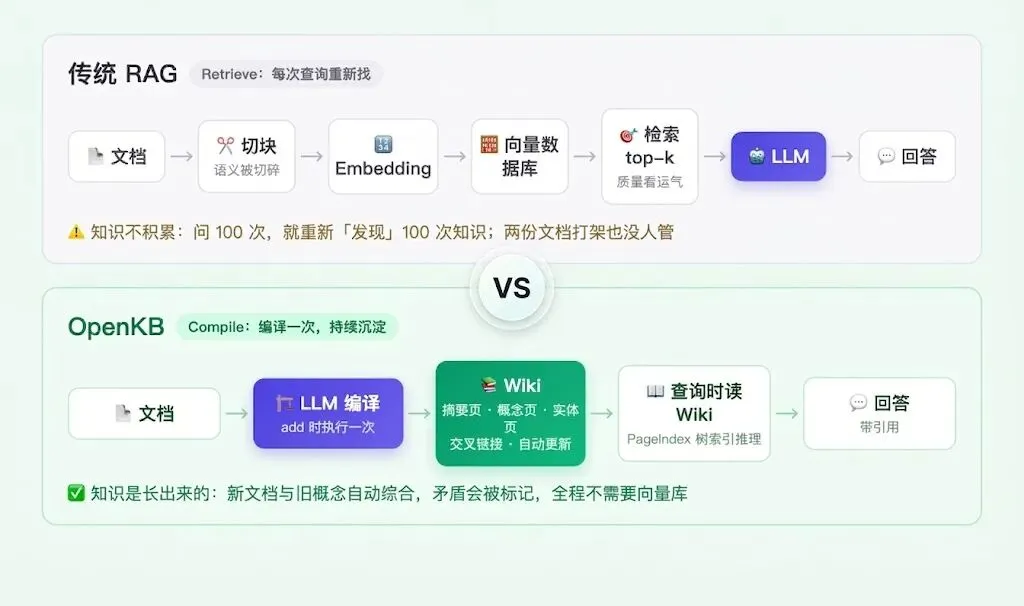 这个理念其实来自 Andrej Karpathy 描述过的图景:LLM 自动生成摘要、概念页和交叉引用,知识随时间沉淀,而不是每次查询都从头推导。
执行 openkb add paper.pdf 时,LLM 会做五件事:
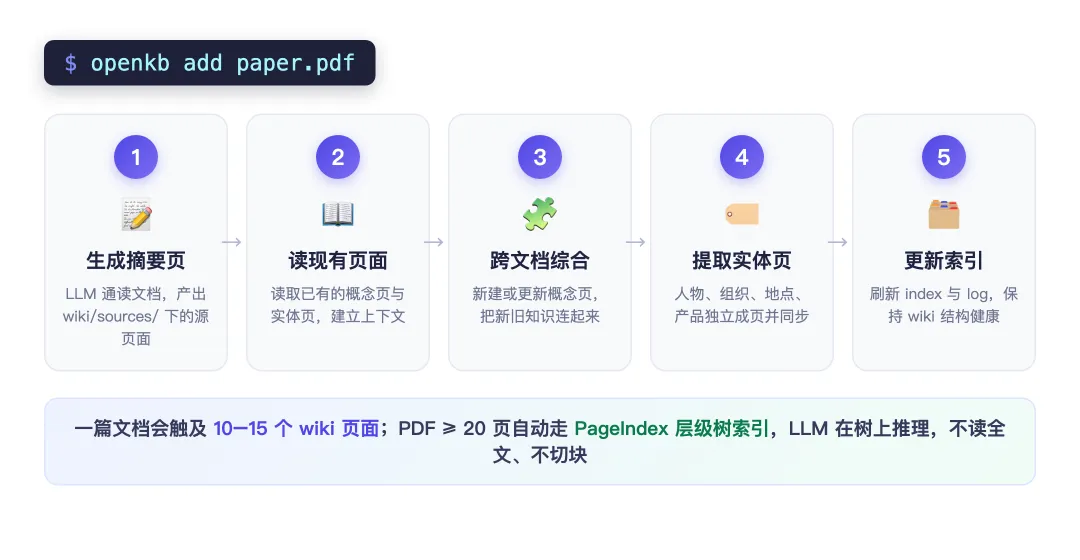
关键在第三步「跨文档综合」:新文档的概念不是孤立成页,而是和已有概念页合并、互相引用。官方说一篇文档会触及 10–15 个 wiki 页面——所以知识库越用越「稠」,不是一堆碎文件的集合。
长文档是它的强项:PDF 超过 20 页自动走 PageIndex 树索引(这就是它爹的本体,GitHub 35.8k Star),LLM 在层级树上做推理定位,不切块、不读全文。图片、表格原生多模态处理,不是只抠文字。
这是我非常喜欢的一点:没有私有格式、没有数据库。整个 wiki 就是带 [[双链]] 的纯 Markdown 目录,直接扔进 Obsidian 就能看图谱视图,数据永远是你的。
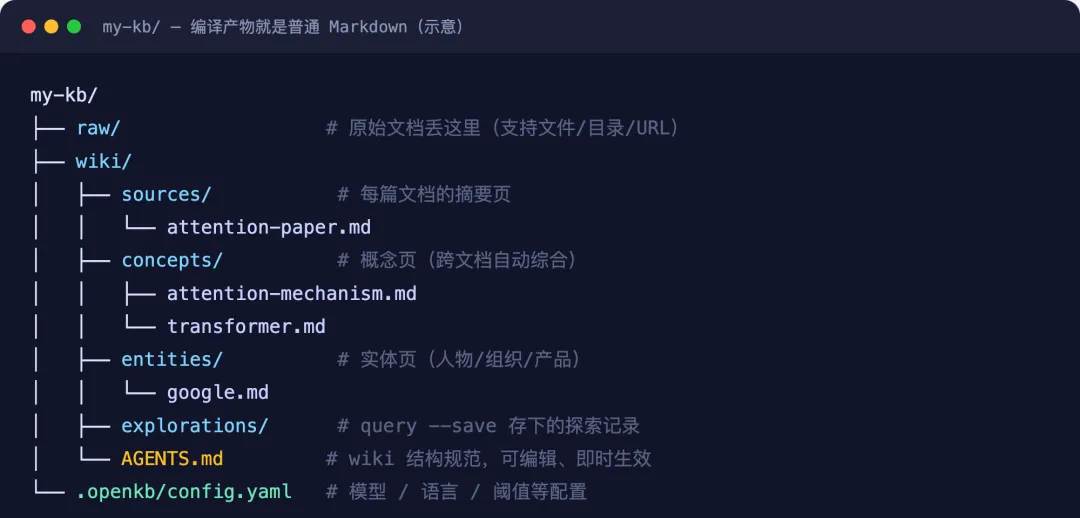
页面还遵循 Google 的 OKF(Open Knowledge Format)规范,实体抽取类型(人物/组织/产品…)可以自己配。
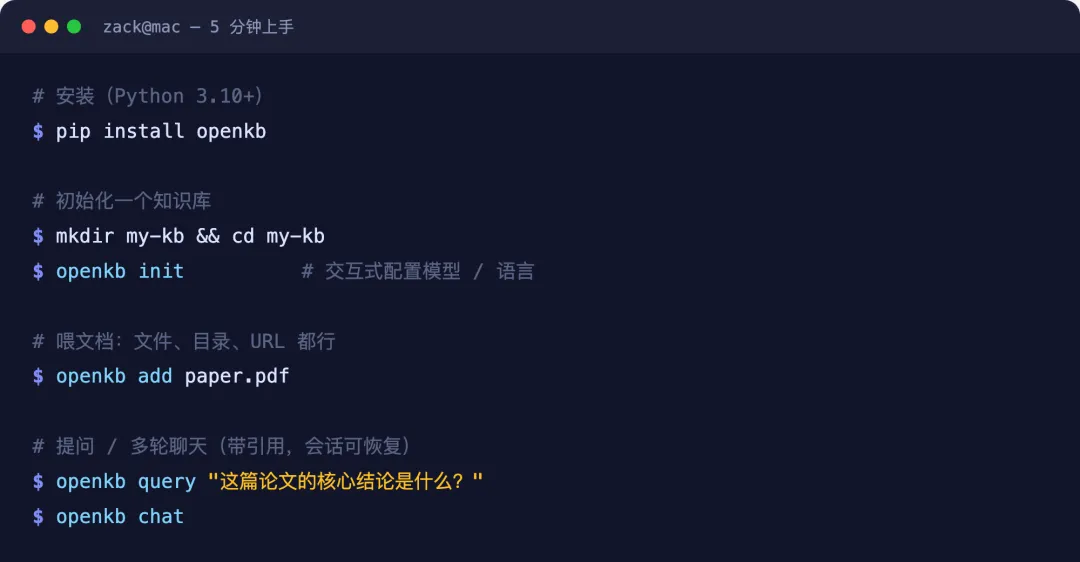
模型走 LiteLLM,OpenAI / Claude / Gemini 随便换,API key 放 .env 就行。除了 query / chat,还有两个挺有意思的命令:
- openkb skill new:把 wiki 蒸馏成可分发的 agent 技能,Claude Code / Codex / Gemini CLI 都能装,不用 MCP
- openkb visualize:一键生成交互式 3D 知识图谱,看自己知识库长什么样挺爽的
不喜欢命令行的话,pip install "openkb[web]" 装个 Web 工作台,浏览器里拖文件、聊天、看时间线。
几个要泼冷水的点,选型前想清楚:
- 编译要花钱:每篇文档进来都是实打实的 LLM 调用,文档多的话 token 成本要先算一下
- 吃 LLM 能力:wiki 质量完全取决于你接的模型,弱模型编译出来的概念页会稀碎
- 别手贱改 wiki:recompile 会覆盖手动编辑
- 非 PDF 长文档还在路上:树索引目前主要服务长 PDF,路线图上写着扩展到其他格式
所以我的判断:适合「沉淀型」场景——论文追踪、行业调研、个人知识库、团队内部文档编译,知识越攒越值钱;不适合实时流式入库、低延迟问答这类场景,那还是传统 RAG 的地盘。
项目地址
github.com/VectifyAI/OpenKB
pip install openkb | Apache 2.0 | Python 3.10+
我个人挺看好这个方向:RAG 卷到今天,大家发现暴力检索的天花板很低,「知识编译 + 沉淀」可能是下一站。PageIndex 本体 35.8k Star,团队是认真做长文档推理检索的,值得持续关注。
你在用什么方案管理自己的文档和知识库?向量库派还是编译派?欢迎留言聊聊,我会挑有意思的回复。
点击关注 👉 Zack说AI