ARTICLE · 1105399
基于HyperV的软件保护编译器
我于2025年12月左右创建这个系统,我称之为太虚幻境,GhostVeil Protect System,太虚的本质是一套编译器工具链,并且作为我的本科毕业设计存在,所以有些部分的核心代码不会公布,因为我还没有毕业,另外原定于议题中公布的Windows Boot漏洞将不会公布,本系统依赖于Winodws boot loader中的一个隐秘漏洞,用于创建一个系统不可见的内存区域,话不多说开始正题。
太虚(GhostVeil)是一套基于 Intel VT-x 硬件虚拟化技术的新一代软件保护系统,运行于 Ring -1 特权层。以 Hypervisor 层的 Host 作为被保护软件的执行调度器,将被保护目标自动分解为基本块(Basic Block),通过对执行流的精密调度,在硬件层面实现对软件控制流的完整掌控。
借助 Intel EPT Execute-Only 技术,代码页对外不可读、不可写,软件断点、内存转储、调试器注入等传统攻击手段悉数失效。
在这之前我们需要了解一些前置知识。
相关技术基础
Intel-VT硬件虚拟化原理
Intel VT-x(Virtualization Technology for IA-32/64)是Intel处理器提供的硬件虚拟化扩展技术,允许在同一物理硬件上同时运行多个相互隔离的操作系统实例。VT-x引入了两种处理器运行模式:VMX Root模式(Host)和VMX Non-Root模式(Guest)。Hypervisor运行于VMX Root模式,享有对硬件的完全控制权;被保护的客户操作系统及应用程序运行于VMX Non-Root模式,其特权指令的执行受到Hypervisor的监控与拦截。
VT-x通过虚拟机控制结构(VMCS,Virtual Machine Control Structure)管理Host与Guest之间的状态切换。VMCS是一块内存区域,记录了Guest的寄存器状态、控制字段及退出原因等信息。当Guest执行特定敏感指令时,处理器自动触发VM Exit,将控制权交还给Hypervisor;Hypervisor处理完毕后通过VMRESUME指令恢复Guest执行,此过程称为VM Entry。
VT-x的核心操作流程如下:首先由Hypervisor执行VMXON指令进入VMX操作模式,随后通过VMLAUNCH启动Guest虚拟机。Guest运行期间,凡触发VM Exit条件的指令(如CPUID、RDMSR、I/O操作等)均会陷入Hypervisor进行处理。本文所设计的GreatVoid系统正是利用CPUID指令必然触发VM Exit这一特性,将其作为控制流调度的同步点,实现对被保护程序每个基本块执行流的精密控制。
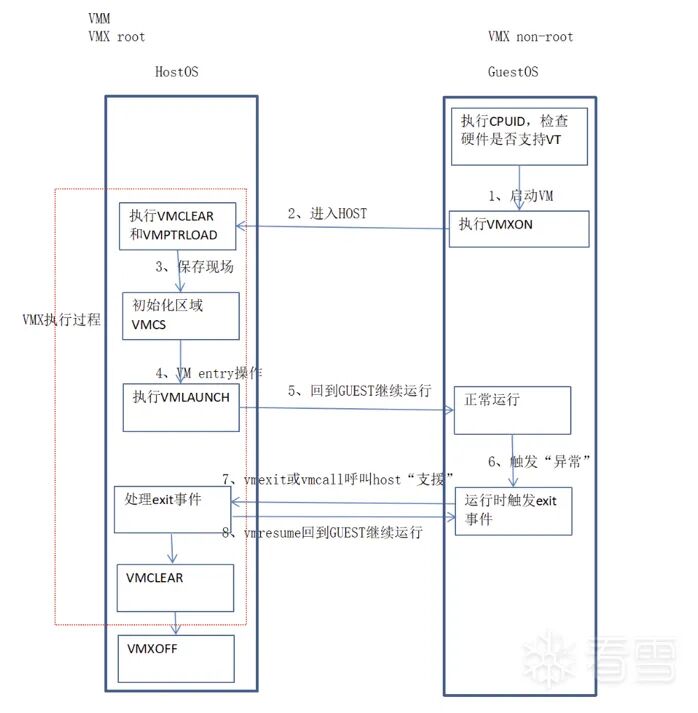
EPT-Execute-Only机制
扩展页表(EPT,Extended Page Tables)是Intel VT-x提供的第二级地址转换机制。在启用EPT的虚拟化环境中,Guest物理地址(GPA)到宿主机物理地址(HPA)的转换由EPT页表完成,而非直接映射,从而实现了对Guest内存访问权限的精细控制。
EPT页表项中包含三个独立的访问控制位:可读位(R)、可写位(W)和可执行位(X)。通过对这三个权限位的组合配置,Hypervisor可以对Guest的每一个内存页设置不同的访问策略。其中,Execute-Only模式是指将内存页配置为仅设置可执行位(X=1),同时清除可读位和可写位(R=0,W=0)。在此模式下,Guest可以正常执行该页中的代码,但任何读取或写入该页内容的操作都将触发EPT Violation,从而陷入Hypervisor进行处理。
GreatVoid系统利用EPT Execute-Only特性对被保护程序的代码页进行保护。被保护代码所在的内存页被配置为Execute-Only,使得攻击者无法通过内存读取指令获取代码内容,从根本上封堵了内存转储(Memory Dump)攻击手段。
同时,由于代码页不可写,软件断点(INT 3指令写入)也无法生效,传统调试手段因此失效。结合CPUID触发VM Exit的控制流调度机制,GreatVoid在硬件层面实现了对被保护程序的完整执行流掌控。此外,GreatVoid的运行时组件以Bootkit形式实现。
系统在Boot阶段由Bootkit读取TFR表并将其加载至内存,随后通过对Windows启动加载器(WinLoad.efi)的特定机制进行利用,将运行时组件注入至系统启动流程中,在操作系统内核初始化之前完成Hypervisor的部署与激活。
值得注意的是,Bootkit在Boot阶段所申请的内存区域对操作系统内核不可见,该内存不会出现在操作系统的物理内存管理结构中,因此无法被内核及用户态程序感知或枚举。GhostVeil运行时通过私有的寻址机制对该内存区域进行访问,从而保证TFR表及运行时数据在系统运行期间不会暴露于操作系统的内存视图之内。出于安全考虑,本文对所利用的具体技术细节不作公开披露。
太虚的依赖
太虚是一个穿越Ring-1到Ring3的保护系统所以开销较大,需要搭配ShellCode编译器将核心的算法代码提取为ShellCode之后进行保护,这里进行说明 ShellCode编译器将会作为一个组件存在于编译链中,同时太虚在编译过程中将会通过热点分析分析出热点的嵌套执行块降低 执行块的 混淆膨胀体积 以提升性能。
LLVM 框架编译器概述
传统Pass开发(IR层)
LLVM的Pass机制是对IR进行分析和变换的标准手段。开发者通过继承FunctionPass或ModulePass实现自定义Pass,在IR层面对程序进行修改。IR Pass操作的对象是虚拟寄存器和SSA形式的指令,与具体物理寄存器无关,适合进行结构性变换。本文的GVShellcodeCompiler即以ModulePass形式实现,在IR层完成全局变量下沉、调用链收集及外部符号哈希化等变换。IR Pass可通过opt工具以插件形式加载,无需修改LLVM源码树。
MachineFunctionPass(MC层)
MachineFunctionPass运行于寄存器分配完成之后、机器码输出之前,操作对象为真实的物理寄存器和机器指令。与IR Pass相比,MachineFunctionPass能够直接获取RAX、RBX等物理寄存器的活跃信息,精确识别序言指令边界,并对基本块进行机器级切割。由于MachineFunctionPass不支持插件式加载,必须集成进LLVM源码树并通过addPreEmitPass注册。
GreatVoid的GVAntiDbg模块(GVA)以MachineFunctionPass形式实现,在机器码输出前向被保护函数的基本块中插入反调试检测stub。选择MC层而非IR层的原因在于:反调试指令的插入需要精确控制物理寄存器的使用,避免与寄存器分配结果冲突,而这一信息只有在MC层才能准确获取。
Basic Block与CFG
基本块(Basic Block)是程序控制流分析的基本单位,由一组顺序执行的线性指令序列构成。每个基本块有且仅有一个入口点(第一条指令)和一个出口点(终结指令)。终结指令要么跳转到另一个基本块,要么从函数返回。在基本块执行过程中,控制流不会从中间进入,也不会从中间跳出,这一性质使得基本块成为编译器分析与变换的原子单位。
控制流图(CFG,Control Flow Graph)是以基本块为节点、以基本块之间的跳转关系为有向边所构成的图结构。一个函数对应一张CFG,其中有且仅有一个入口块,可能存在多个出口块。CFG完整描述了程序在运行时所有可能的执行路径,是编译器进行优化、混淆及静态分析的核心数据结构。
在LLVM IR中,基本块以BasicBlock类表示,函数以Function类表示,二者均继承自Value基类。通过对Function的迭代器遍历可以获取函数内所有基本块,进而对每个基本块的指令序列进行分析与变换。
GreatVoid的GVRC模块以基本块为核心处理单元,在MachineFunctionPass阶段对每个基本块进行切割,并在其末尾插入CPUID指令作为控制流调度的同步点。TFR表以基本块为粒度记录控制流信息,GVRuntime在运行时依据TFR表对每个基本块的后继执行目标进行动态调度。
基于Dominator Tree的Heat Code识别
支配树(Dominator Tree)
在控制流图中,若从程序入口到达基本块B的所有路径都必须经过基本块A,则称A支配B(A dominates B)。基于支配关系可以构建支配树(Dominator Tree),树中每个节点的父节点即为其直接支配节点(Immediate Dominator)。支配树是编译器进行循环分析、代码优化及静态分析的核心数据结构。
回边与自然循环
在控制流图中,若存在一条边从基本块A指向基本块B,且B支配A,则该边称为回边(Back Edge)。每一条回边对应一个自然循环,其中B为循环头(Loop Header),循环体由所有能够不经过B而到达A的基本块构成。GreatVoid通过逆后序遍历(RPO)结合支配关系识别所有回边,进而收集自然循环体内的基本块集合。
算法实现
本文实现了CLoopAnalysis类完成上述分析,其核心流程分为四个步骤。第一步遍历RPO序列,对每个基本块的后继节点检查是否满足回边条件,即后继节点的RPO编号不大于当前节点且后继节点支配当前节点,将满足条件的边记录为回边。第二步对每条回边从tail节点出发沿前驱方向进行反向BFS,收集直到header为止的所有基本块,构成自然循环体。第三步遍历所有循环,对每个循环体内的基本块累加嵌套深度计数,并记录其最内层循环头。第四步将计算结果写回每个基本块的m_nestDepth字段,供后续模块查询。
嵌套深度与热点识别
对每个基本块计算其循环嵌套深度(Nest Depth),位于多层嵌套循环内部的基本块具有更高的执行频率,被识别为热点代码(Heat Code)。这一方法本质上是静态分析中抽象程序点技术的工程应用——在不实际运行程序的前提下,通过对CFG结构的静态推导,以程序点的抽象状态近似估计运行时的执行频率分布,属于典型的May Analysis范畴。
GreatVoid的GVRC模块利用热点代码识别结果,对循环内部的基本块采取整体打包策略,避免在循环体内部插入CPUID调度点,从而防止因频繁VM Exit导致的性能损耗。
// GVRCLoopAnalysis.cpp#include"GVRCLoopAnalyzePass.h"#include<queue>namespace GVRC{ CLoopAnalysis::CLoopAnalysis(CCFG& cfg, CDomTree& domTree) {build(cfg, domTree); }// 核心:识别回边 -> 收集循环块 -> 计算嵌套深度 voidCLoopAnalysis::build(CCFG& cfg, CDomTree& domTree){auto rpo = cfg.rpoOrder();// Step 1:找所有回边// 回边定义:a -> b,且 b dom a(b 支配 a)// 即在 RPO 下,后继的 RPO 编号 <= 自己(往回跳)且支配关系成立 std::unordered_map<CBasicBlock*, int> rpoIdx;for (int i = 0; i < (int)rpo.size(); ++i) rpoIdx[rpo[i]] = i;// back edges: (tail, header) std::vector<std::pair<CBasicBlock*, CBasicBlock*>> backEdges;for (CBasicBlock* bb : rpo) {for (CBasicBlock* succ : bb->m_vecSuccessors) {// succ 的 RPO 编号 <= bb,且 succ dom bbif (rpoIdx[succ] <= rpoIdx[bb] && domTree.dominates(succ, bb)) backEdges.push_back({ bb, succ }); // tail -> header } }// Step 2:每条回边对应一个自然循环,收集循环体 for (size_t i = 0; i < backEdges.size(); ++i) { CBasicBlock* tail = backEdges[i].first; CBasicBlock* header = backEdges[i].second; Loop& loop = m_loops[header]; loop.pHeader = header; loop.blocks.insert(header);collectLoopBlocks(header, tail, loop); }// Step 3for (CBasicBlock* bb : rpo) m_nestDepth[bb] = 0;for (auto it = m_loops.begin(); it != m_loops.end(); ++it) { CBasicBlock* header = it->first; Loop& loop = it->second;for (CBasicBlock* bb : loop.blocks) { m_nestDepth[bb]++;if (m_loopHeader.find(bb) == m_loopHeader.end() || m_nestDepth[m_loopHeader[bb]] < m_nestDepth[header]) { m_loopHeader[bb] = header; } } }// Step 4:写回 CBasicBlock::m_nestDepth for (CBasicBlock* bb : rpo) bb->m_nestDepth = m_nestDepth[bb]; }// 从 tail 反向 BFS 收集自然循环体(直到 header 为止)voidCLoopAnalysis::collectLoopBlocks(CBasicBlock* header, CBasicBlock* tail, Loop& loop){ std::queue<CBasicBlock*> worklist;if (loop.blocks.find(tail) == loop.blocks.end()) { loop.blocks.insert(tail); worklist.push(tail); }while (!worklist.empty()) { CBasicBlock* cur = worklist.front(); worklist.pop();// 沿前驱反向遍历,直到碰到 header 停止for (CBasicBlock* pred : cur->m_vecPredecessors) {if (loop.blocks.find(pred) == loop.blocks.end()) { loop.blocks.insert(pred);if (pred != header) worklist.push(pred); } } } }// 查询接口 size_tCLoopAnalysis::getNestDepth(CBasicBlock* pBB){auto it = m_nestDepth.find(pBB);return it != m_nestDepth.end() ? it->second : 0; }CBasicBlock* CLoopAnalysis::getLoopHeader(CBasicBlock* pBB){auto it = m_loopHeader.find(pBB);return it != m_loopHeader.end() ? it->second : nullptr; }boolCLoopAnalysis::isLoopHeader(CBasicBlock* pBB){return m_loops.find(pBB) != m_loops.end(); }} // namespace GVRC太虚系统架构
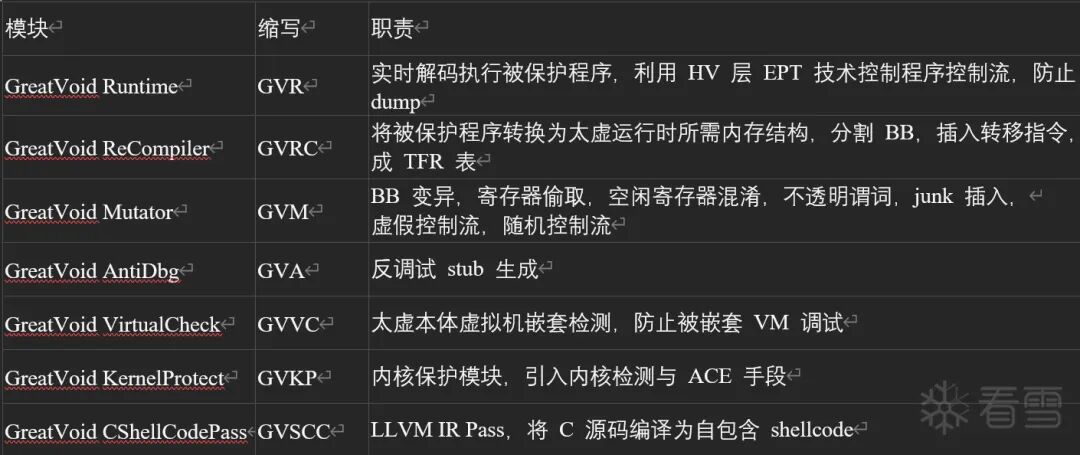
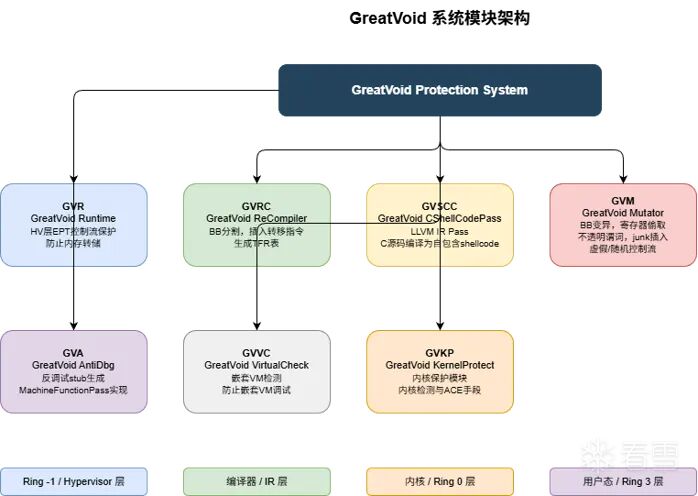
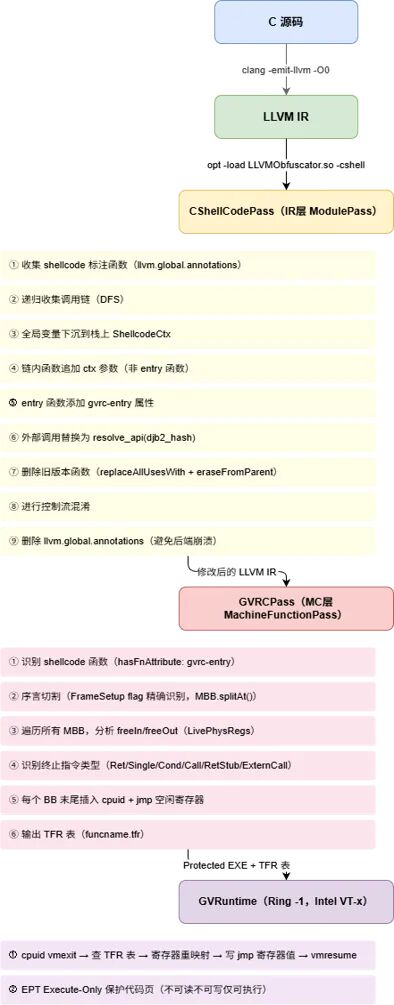
太虚的核心Runtime VT分发器设计
我们将详细讲述VT分发器的设计这是太虚的核心。
GVRuntime运行于Ring -1特权层,是GreatVoid系统的核心运行时组件。其主要职责是在被保护程序执行过程中,拦截由CPUID指令触发的VM Exit事件,查询TFR表获取当前基本块的控制流信息,计算下一基本块的执行地址并写入跳转寄存器,最后通过VMRESUME恢复Guest执行。
VT分发器的核心dispatch逻辑根据TFR表中的FlowType字段进行分支处理,共处理以下五种控制流类型。
对于Ret类型,分发器从Guest栈顶读取返回地址,将rsp加8模拟ret语义,并将读取到的地址写入跳转寄存器。
对于Single和RetStub类型,分发器直接将succs[0]中记录的后继地址写入跳转寄存器。
对于Cond类型,分发器读取VMCS中的RFLAGS寄存器,根据TFR表记录的condCode字段索引条件判断handler表,根据判断结果选择succs[0](fall-through)或succs[1](taken)写入跳转寄存器。
对于Call类型,分发器将succs[1]中记录的return stub地址压入Guest栈,再将succs[0]中记录的callee入口地址写入跳转寄存器。
对于ExternCall类型,外部调用通过GVSCC的resolve_api机制处理,硬件直接执行call与ret,不经VT调度。
此外,GreatVoid的运行时组件以Bootkit形式部署。系统在Boot阶段由Bootkit读取TFR表并加载至内存,通过对Windows启动加载器WinLoad.efi的特定机制进行利用,在操作系统内核初始化之前完成Hypervisor的部署与激活。Bootkit在Boot阶段申请的内存区域对操作系统内核不可见,不出现在操作系统的物理内存管理结构中,GVRuntime通过私有寻址机制访问该区域,保证TFR表及运行时数据在系统运行期间不暴露于操作系统的内存视图之内。出于安全考虑,本文对所利用的具体技术细节不作公开披露。
下面给出TFR表的结构:
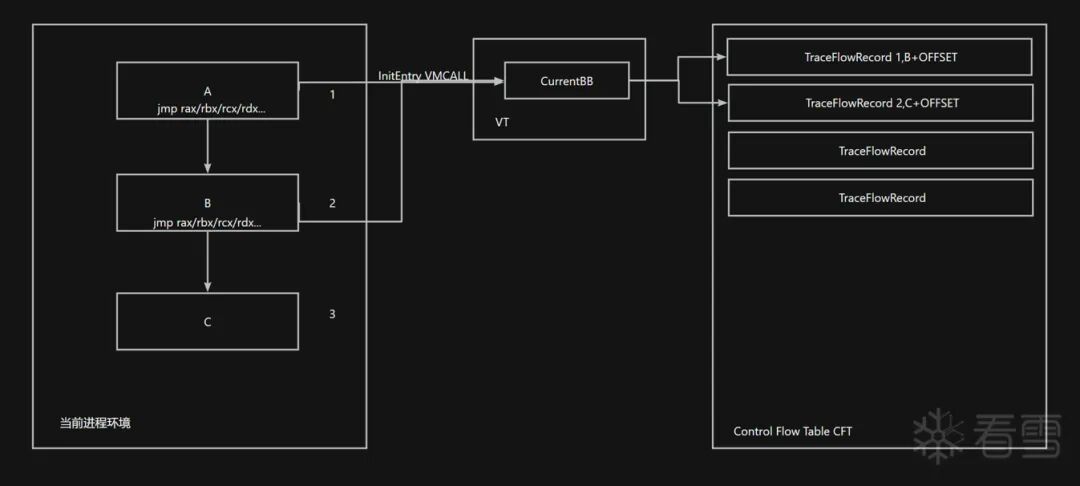
多分支TFR
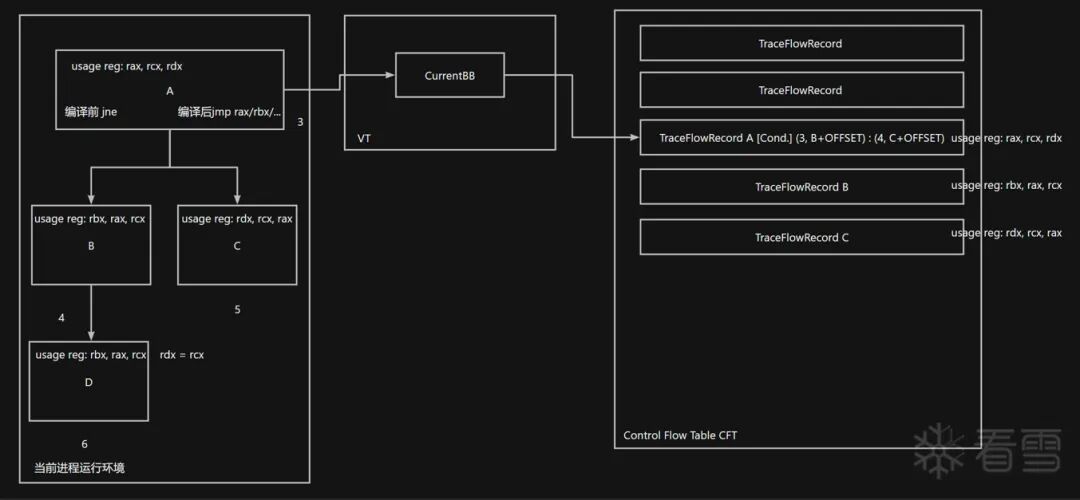
TFR表以基本块为粒度,每个基本块对应一条TraceFlowRecord记录,包含以下字段:FlowType字段标识该基本块的控制流类型,共分为Ret、Single、Cond、Call、RetStub、ExternCall六种;condCode字段在FlowType为Cond时有效,存储条件跳转的条件码,与x86 0F8x系列opcode低nibble对应;succs字段为两个SuccInfo结构,分别存储后继基本块的序号与回填后的地址偏移;freeIn与freeOut字段分别记录该基本块入口与出口处的空闲物理寄存器掩码,供GVRC选择跳转寄存器时使用。
六种FlowType的语义如下表所示:
FlowType | 后继数 | succs含义 | GVR处理方式 |
Ret | 动态 | 无 | 读Guest栈顶,rsp加8,写跳转寄存器 |
Single | 1 | succs[0]为目标 | 直接写succs[0]地址到跳转寄存器 |
Cond | 2 | [0]为fall-through,[1]为taken | 读RFLAGS按condCode选择后继 |
Call | 2 | [0]为callee入口,[1]为return stub | 压stub地址,写callee入口到跳转寄存器 |
RetStub | 1 | succs[0]为call后续BB | 直接写succs[0]到跳转寄存器 |
ExternCall | 1 | succs[0]为call后续BB | 硬件处理,不经VT调度 |
TFR构建过程
TFR表由GVRCPass在MachineFunctionPass阶段自动构建,整个构建过程分为以下步骤。
第一步识别目标函数,通过F.hasFnAttribute("gvrc-entry")判断当前函数是否为shellcode入口函数,仅对标注函数执行后续处理。
第二步序言切割,遍历入口MBB的指令,通过FrameSetup flag精确识别序言边界,找到第一条不带FrameSetup标志的指令后调用MBB.splitAt()将序言单独切分为一个MBB,避免序言被拆断导致栈帧初始化异常。
第三步活跃寄存器分析,对每个MBB使用LivePhysRegs分别计算freeIn(入口处空闲寄存器集合)和freeOut(出口处空闲寄存器集合),从候选寄存器集合中排除cpuid执行后会被覆盖的RAX、RBX、RCX、RDX四个寄存器,优先从R10至R15中选取跳转寄存器。
第四步终止指令识别,分析每个MBB最后一条指令的opcode,判断其控制流类型。对于ret指令识别为Ret类型;对于无条件跳转识别为Single类型;对于JCC_1或JCC_4识别为Cond类型,并从operand[1]读取X86::CondCode枚举值填入condCode字段;对于CALL64pcrel32识别为Call类型并生成对应的RetStub记录;对于链外调用识别为ExternCall类型。
第五步替换终止指令,删除原始终止指令,在MBB末尾依次插入cpuid指令和jmp跳转寄存器指令,cpuid作为VM Exit触发点,jmp目标由GVRuntime在vmexit handler中写入。
第六步输出TFR表,将所有MBB对应的TraceFlowRecord序列化输出到funcname.tfr文件,供GVRuntime在Boot阶段加载使用。u64SuccOffset字段在编译期记录符号名,链接完成后由独立工具解析PE符号表回填真实地址。
以如下简单C函数为例说明TFR表的构建过程:
intfoo(int a, int b){if (a > b)return a;return b;}经GVRC处理前,该函数对应的x86汇编如下:
foo:push rbp mov rbp, rsp cmp ecx, edx ; 比较 a 和 b jle .BB2 ; 若 a <= b 跳转.BB1: mov eax, ecx ; return apop rbp ret.BB2: mov eax, edx ; return bpop rbp ret经GVRC处理后,序言被切割为独立MBB,每个基本块末尾的终止指令被替换为cpuid加跳转寄存器,生成如下结构:
foo_prologue: ; MBB0 序言块 push rbp mov rbp, rsp cpuid ; VM Exit 触发点 jmp r10 ; GVR 填入 MBB1 地址foo_BB1: ; MBB1 条件判断块 cmp ecx, edx cpuid ; VM Exit 触发点 jmp r10 ; GVR 根据 RFLAGS 填入 MBB2 或 MBB3foo_BB2: ; MBB2 taken 分支 mov eax, ecx cpuid jmp r10 ; GVR 读栈顶填入返回地址foo_BB3: ; MBB3 fall-through 分支 mov eax, edx cpuid jmp r10 ; GVR 读栈顶填入返回地址对应生成的TFR表记录如下:
MBB | FlowType | condCode | succs[0] | succs[1] | freeOut |
MBB0 | Single | None | MBB1地址 | - | R10,R11 |
MBB1 | Cond | JLE | MBB1地址 | MBB2地址 | R10,R11 |
MBB2 | Ret | None | - | - | R10,R11 |
MBB3 | Ret | None | - | - | R10,R11 |
太虚的另一个核心技术 寄存器重映射与数据流截断
在传统编译器生成的代码中,寄存器分配器按照固定的调用约定与活跃性分析结果决定每个变量使用哪个物理寄存器,攻击者通过阅读汇编代码可以直接追踪寄存器与变量之间的对应关系。GreatVoid系统利用VT层介入每次基本块切换的时机,在编译期静态确定寄存器重映射方案,在运行时由GVRuntime透明执行映射,使攻击者在逆向分析时无法建立寄存器与变量的稳定对应关系。
重映射原理
以块A向块B传递变量X为例,编译器原始分配结果为块A通过RCX传递X,块B从RCX读取X。GVRC在MachineFunctionPass阶段分析块B入口处的freeIn集合,从中选取一个与RCX不同的空闲寄存器(如RDX)作为块B实际接收X的寄存器,将这一映射关系记录在TFR表中。GVRuntime在处理块A的VM Exit时,从VMCS读取RCX的当前值,将其写入RDX对应的VMCS字段,再写入跳转地址后执行VMRESUME。块B执行时从RDX读取X,与原始语义完全等价,但物理寄存器已发生改变。
// 编译器原始分配块A: mov rcx, X → jmp 块B块B: use rcx // 从RCX读取X// 重映射后(攻击者视角)块A: mov rcx, X → cpuid / jmp rXX块B: use rdx // 从RDX读取X,攻击者不知道RDX从何而来空闲寄存器的选取
重映射目标寄存器从GVRC计算的freeOut集合中选取,具体选取策略为:排除CPUID覆盖的RAX、RBX、RCX、RDX,排除块B入口处已有活跃值的寄存器,从剩余候选(R10至R15、RDI、RSI、R8、R9)中按随机顺序选取,保证每次块切换时的映射关系不固定,攻击者无法通过统计规律推断映射方案。
混淆效果
经过寄存器重映射后,攻击者在对被保护程序进行静态或动态分析时面临以下困难:每个基本块使用的物理寄存器组合与编译器原始分配结果不一致,跨块的数据流在汇编层面断裂,无法通过寄存器追踪还原变量的生命周期;不同运行实例中映射方案可配置为动态变化,进一步增加动态分析的难度;结合GVMutator的控制流混淆,攻击者既无法确定控制流路径,也无法确定寄存器语义,在保证TFR表无法被攻陷的情况下整个系统几乎无法被破解。
看雪ID:TeddyBe4r
https://bbs.kanxue.com/user-home-983513.htm
# 往期推荐
当高频观测不再经过异常路径:Shadow Cave 与常驻式插桩架构
D3CTF 2026 d3llvm.apk 反调试定位与加密 SO的Dump
球分享
球点赞
球在看
点击阅读原文查看更多