ARTICLE · 1106180
灵知AI:给数据底座装上“私域知识库”
灵知AI:给数据底座装上“私域知识库”
上篇说道
上篇讲了后台任务调度工具:它把用编程工具编的程序模块、或第三方编写的程序统一纳入调度策略;既能按事件规则调度(每晚 10 点出当天报表),也能按复杂条件控制(放假期间,学校 1#、3# 教学楼不做能耗统计);运行中还能监控、终止、热加载。
上篇结尾留了一句:数据攒在底座里,除了被查、被算、被展示,能不能让它自己“生”出点新东西来?
一、聊了三十天,为什么一直没正经讲 AI
先说一句可能有人憋了很久的话:
这三十天讲了采集、建模、表单流程报表、2D/3D/GIS、接口和调度——怎么就没正经讲过 AI?
现在最火的词就是它。一个讲数字化的号,三十天不提 AI,确实说不过去。但我们是有意这么排的。
因为这两年看下来:AI 在企业里落不下去,十次里有八次不是模型的问题,而是地基的问题。模型再聪明,它不认识你的设备、你的台账;它写出来的东西没有数据支撑,只是一篇漂亮的作文;它给完答案就结束了,没有人接着把事办完。
所以前面三十天我们一直在打地基。地基打完了,今天才轮到 AI 出场。而且要说明:AI 不是 AGP 的第四十件工具,它是站在前面三十篇成果之上的那一层——前面那些东西不是给 AI 让路的,恰恰是喂给 AI 的。
从今天起,我们用两篇讲 AGP 的 AI 产品:灵知。
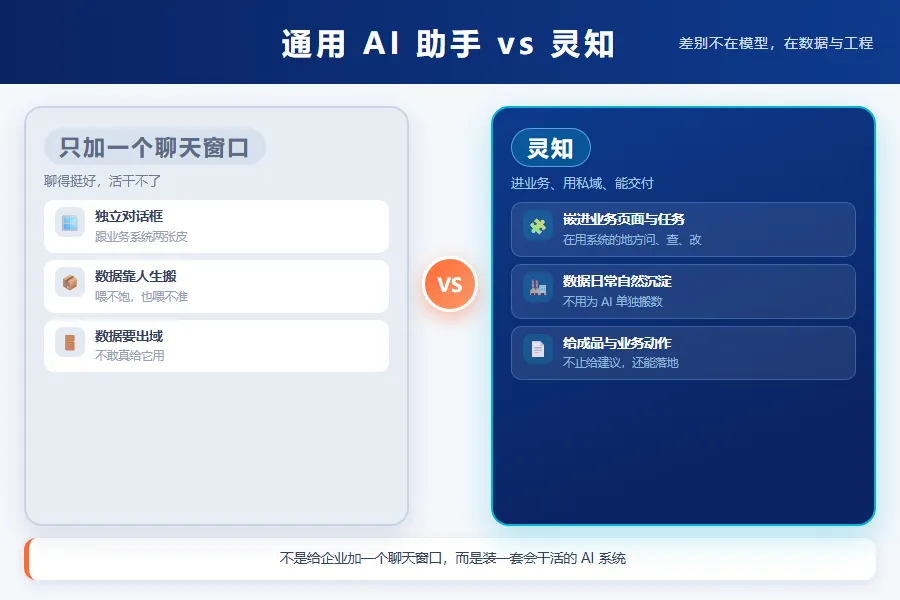
灵知 = 私域知识库 + 智能体协同。它不是给企业加一个聊天窗口,而是装一套会干活的 AI 系统。
这个式子正好对应上下两篇:这篇讲“私域知识库”——数据;下篇讲“智能体协同”——干活。
二、先看三个“AI 落不了地”的现场
现场一:AI 不认识你的企业。
通用大模型懂世界——懂物理、懂化学、懂管理常识。但它不懂你的厂:不知道 3 号泵去年修过几次、换过什么件;不知道你们车间的能耗基线是多少;不知道那份《检修规程》第 4.2 条写的是什么;更不知道今天上午 9 点那台压缩机跳过一次闸。
这些它都不知道,所以它给出来的,只能是“正确的废话”。也有项目试过把文档喂进去——可文档是死的:规程是 2019 年版的,台账是上月导出的表格,图纸还是 PDF 扫描件。喂进去的东西本身就不新、不全、不联,结论自然不敢用。
现场二:为了用 AI,先得去“搬数据”。
更常见的做法是:先立一个知识库项目,把散在各处的文档、台账、图纸收集起来,清洗、切片、灌进向量库——这件事本身就是个大工程。
更要命的是两点:搬完还要维护,业务数据天天在变,搬过来的那份很快就过期;搬出来的和业务系统是两张皮,知识库一套数、ERP 一套数、报表又是一套,对不上还得人工核。结果就是:为了 AI,先给企业增加了一个新的数据孤岛。
现场三:结果只停在一个对话框里。
很多 AI 应用长这样:右下角一个悬浮球,点开是对话框,问一句答一句,看着挺热闹。但它不写回系统、不生成文件、不推进流程。你问它“3 号泵状态怎么样”,它给一段分析——可这段分析躺在对话框里,不进设备档案、不生成记录、不触发工单。聊完,活还是人干,还多了一步“把 AI 说的话抄进系统”。
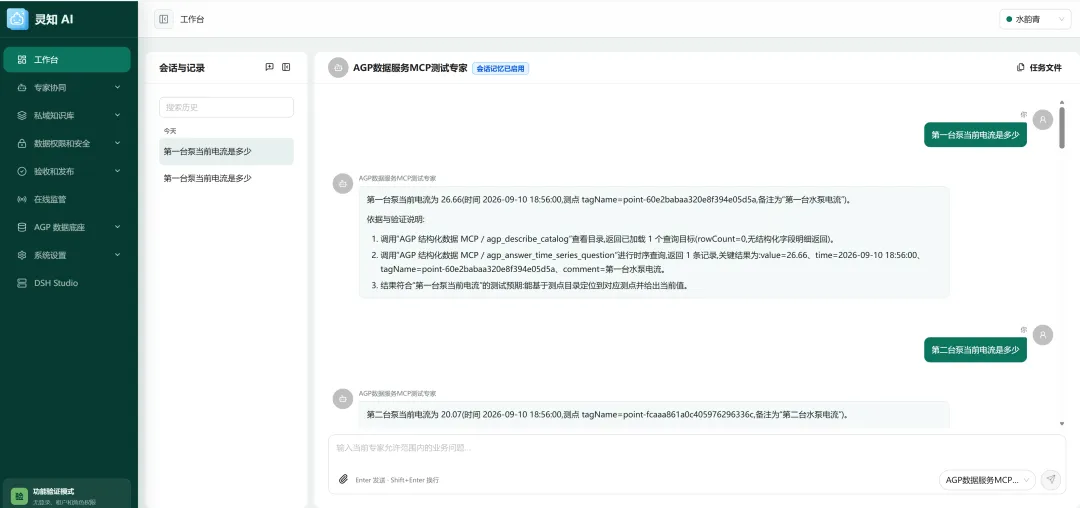
灵知,就是冲着这三个现场来的。先看一眼它长什么样——左边是 AI 管理菜单,右边是交互和测试区:
三、第一个答案:完全的私域数据
针对现场一和现场二,灵知的答案是同一句话:数据不搬,就用你自己的。
灵知完全基于 AGP 的数字化底座,也就是前面反复出现过的那三类存储:
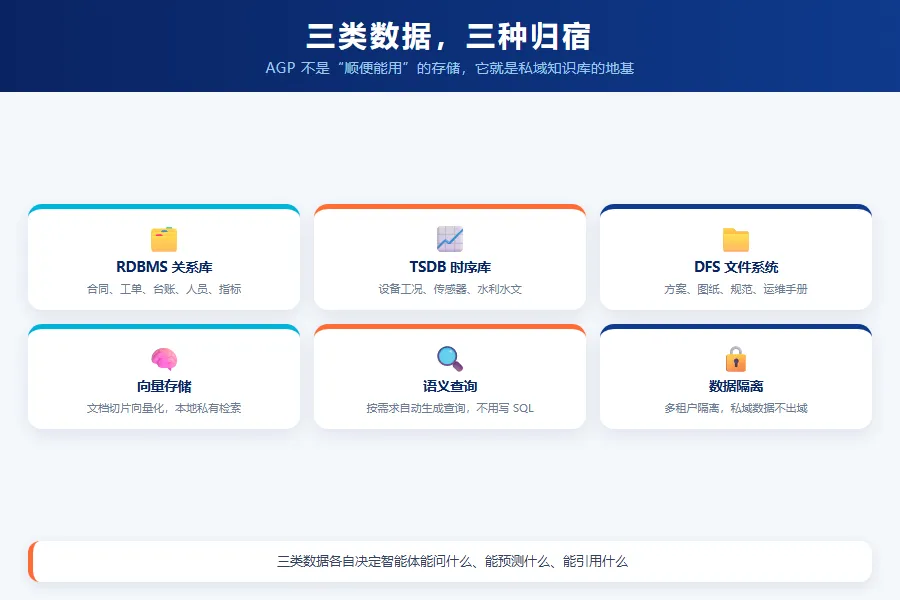
① 关系数据库 RDBMS——业务台账的家。合同、工单、设备台账、人员、报表指标本来就在这儿;它还额外承担三样:专家的配置元数据、权限规则、审计日志——AI 自己的“身份和行为记录”也在这里。
② 时序数据库 TSDB——决定了智能体能“预测”什么。设备监测、传感器、生产工况、水利水文指标都以时序形式存在这里。没有历史曲线,AI 只能描述现在;有了历史曲线,它才能说“照这个走势,三天后可能会出问题”。
③ 分布式文件系统 DFS——私有向量库的原始文件载体。方案、图纸、规范、会议纪要、运维手册都在这儿,它们是私有向量库的原材料——切片、向量化之后,就成了 AI 可以检索的“知识”。
这三类数据各自决定了智能体能问什么、能预测什么、能引用什么。围绕它们,底座还做了三项 AI 适配:向量存储兼容(切片向量化后存回底座,本地私有化检索)、语义查询自动生成(按需求自动生成查询,不用写 SQL)、多租户数据隔离(多客户、多行业数据隔离,满足合规)。
最要紧的一点是:这些数据本来就在你自己的机房里。不需要为了用 AI 把它们导出到别人的云上,也不需要把数据“翻译”成另一种格式再存一遍。
一句话概括:AGP 不是“顺便能用”的存储,它就是私域知识库的地基。有了这些数据,专家才谈得上——认识设备、看懂状态、算清指标、找对关系、办成事情。
四、第二个答案:数据不是为 AI 搬的,是干活干出来的
上面解决了“数据在哪”,接下来解决“数据怎么来”。
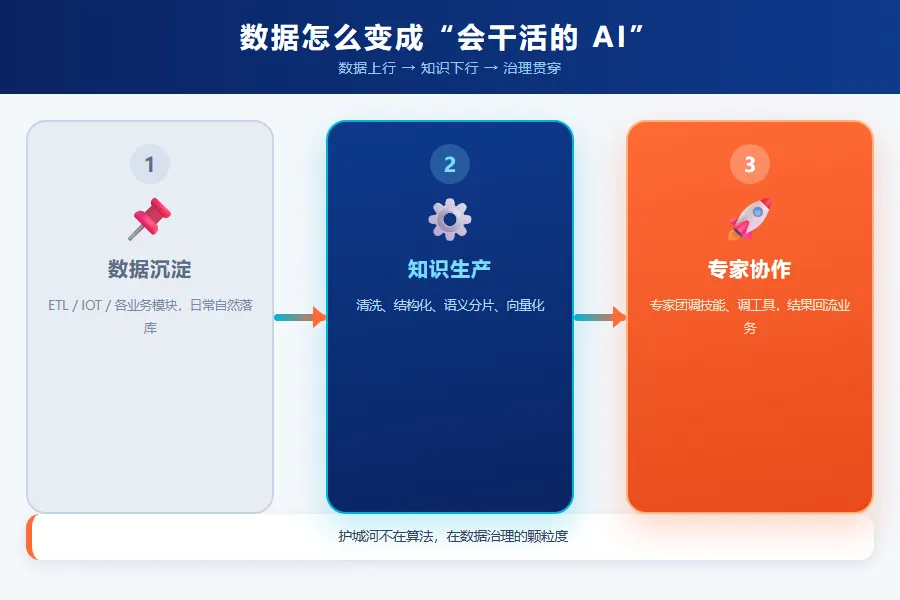
很多 AI 项目的逻辑是:先有 AI,再去凑数据。所以永远在补数据,永远补不完。灵知反过来:数据从日常业务里自然长出来。三条链各管一段:
业务系统数据——ERP、MES、WMS 走 AGP 的 ETL 抽过来(第 16 篇);
现场设备数据——DCS、PLC、电表走 AGP 的 IOT 实时接进来(第 15 篇);
管理动作数据——人事、资产、检修、培训、OA 由 AGP 业务模块承接,员工在日常工作里顺手就填了(第 18–20 篇)。
不需要靠人额外硬输入维护,而是通过日常的业务,数据自然落库。这就是“全要素、全业务、全流程”真正落地的地方:把获取全量私域数据的过程融进员工的日常工作,数据才能常在常新。
从数据到知识:四步走完
原始数据还不能直接给 AI 用,中间要过一道“知识生产”:数据清洗(去重、脱敏、格式统一)→ 结构化转换(PDF、图纸、表格自动解析,抽取实体、指标、流程规则)→ 语义分片(按语义边界切片,不是硬按字数切,那样会把一句话切断)→ 向量索引(切片做 Embedding,写进本地私有向量库)。
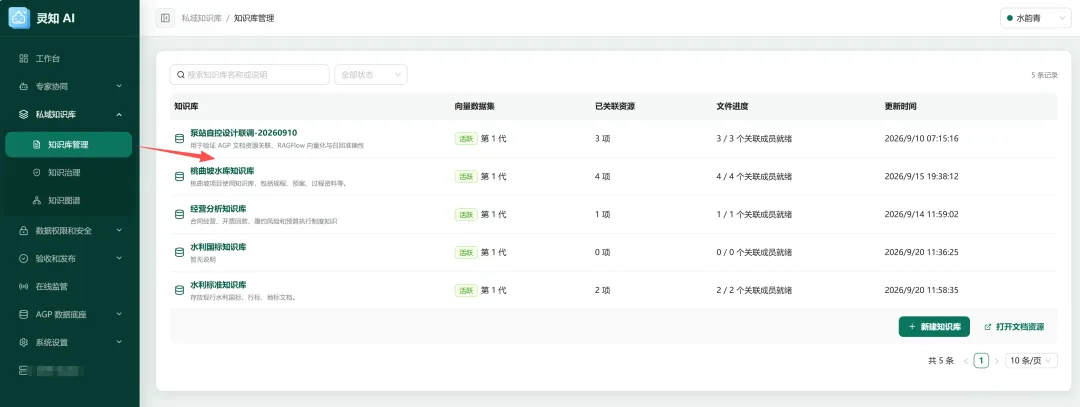
输出两样东西:一个私有向量库,加一个知识服务 API。API 提供四种检索——语义相似度检索、关键词精准检索、时序指标联动查询、多文档联合问答,并内置权限拦截:专家只能访问自己权限范围内的知识。
不同类型的内容,能放在一起问
数据进来了,还得是个整体,不能各说各话。这里用到的,正是第 27 篇讲过的那些简单接口函数——十几条数据接口就能存取全部类型的数据,既不用了解库表结构,也不用写 SQL。于是你就能问出这些“混合型”的问题:
张师傅今年运维的绩效——跨实体把人、工单、工时串起来;
年龄 50 岁以上的职工在各个部门的分布——条件 + 分组统计;
三号水泵现在运行的主要参数——取 TSDB 实时测点;
查询近期产线主要生产数据,并根据规范做出效能评估——数据 + 知识库里的“规范”一起用。
注意最后一条:它同时用到了台账里的数、时序里的曲线、文件柜里的规范。这才是“综合查询”的意思——不是查一个库,是把这件事相关的所有东西一起找出来。
用一句话总结这套数据侧的设计:
护城河不在算法,在数据治理的颗粒度。把图纸和台账一起讲清楚,AI 才真的能用。
五、小结
为什么现在才讲 AI:AI 在企业里落不下去,常常不是模型的问题,而是地基的问题;
它是什么:灵知 = 私域知识库 + 智能体协同——不是加一个聊天窗口,而是装一套会干活的 AI 系统;
三个现场:AI 不认识你的企业 / 为了用 AI 先搬数据 / 结果只停在对话框;
第一个答案:基于 AGP 底座的 RDBMS + TSDB + DFS——RDBMS 存业务与 AI 配置,TSDB 决定能预测什么,DFS 是向量库的原料,数据本来就在客户自己手里;
第二个答案 + 知识生产:ERP/MES/WMS 走 ETL、现场设备走 IOT、管理动作走业务模块,在日常工作里自然沉淀;清洗 → 结构化 → 分片 → 向量化,再用十几条接口函数把台账、曲线、图纸、规范放在一起问。
下集预告
数据备好了。可数据自己不会干活。
一个只有数据的 AI,最多是个“资料员”;要让它变成“业务员”,还得有人把活分下去、把工具递到它手上、把结果收回系统里。
下篇讲灵知的另一半:智能体协同——专家、专家团、技能工坊,五大核心引擎,以及一次任务从头到尾的完整旅程。
《灵知AI:给业务流程装上“智能体协同”》
下集见。
智道 AGP · 让您做数字化项目,像做PPT一样简单