ARTICLE · 1110378
AI时代软件工程专业课程教学方法研究报告
摘要:本报告以 CMU 11-768《AI Agents》为样本,系统解析了一门"AI 时代软件工程专业"课程是如何被设计、讲授与考核的。核心发现是:这门课完成了从"教学生写软件"到"教学生构建、评估、训练并治理会写软件的智能体"的范式转移。它并非在传统“软件工程专业课”上叠加一节"AI 工具介绍",而是以智能体(Agent)为第一性对象,重构了知识体系、实验形态和评价标准。
课程呈现出五条可复用的设计主线:
- 三层能力栈:Harness(构建)→ Eval(评估)→ Training(训练),三份个人作业正好对应由浅入深的工程闭环。
- 资源三件套 + 问题驱动:每讲配 Slides、录播、必读论文与大量参考链接,课堂用于串联而非灌输。
- 科学范式实验:作业要求 A/B 对照、消融、token 用量分析,学生交出的不是"能跑的代码",而是可复现的证据链(轨迹 trajectory、artifact、成本)。
- AI 原生的学术诚信:明确允许使用 AI 工具,但用"理解性质询/quiz"与"禁止 AI 生成课堂亮点"来守住能力底线。
- 研究前置:半学期团队研究项目 + 海报答辩,把研究生课程直接锚定为"可发表的研究训练"。
报告同时指出了该模式的风险与局限(算力成本、可复现性、模型快速迭代、评分主观性、材料快照不一致等),并给出面向国内高校软件工程专业的可迁移建议清单。
1. 研究背景与问题
1.1 AI 正在重写"软件工程"本身
传统软件工程教育围绕软件生命周期组织:需求 → 设计 → 编码 → 测试 → 部署 → 维护。生成式 AI 与自主智能体出现后,编码环节被大幅自动化,软件的生产方式正在转向"人类定义意图与约束,智能体执行与自省"的新形态。这带来三个直接后果:
- 能力重心迁移:从"手写实现"转向"构建执行框架、设计评估、编排工具与控制上下文"。
- 工程对象变化:系统边界从确定性程序扩展到"概率性语言模型 + 工具 + 环境"的闭环。
- 质量与安全挑战升级:非确定性、长程任务、权限与凭据、沙箱隔离成为一等公民。
因此,软件工程专业课程需要回答一个新问题:当代码可以被生成时,软件工程专业应该教什么、怎么教、如何考?
1.2 研究对象的选择理由
CMU 11-768 是一门 2026 年新开的、定位高年级/研究生层次的 AI Agents 前沿课程,具备三个适合做教学法研究的特征:
- 完整度高:公开了 syllabus、15 周日程、三份作业定位、评分权重与政策,且 Assignment 1 有可获取的完整讲义与 starter 仓库。
- 代表性强:由 NLP/智能体领域一线学者主讲,并邀请 OpenHands、LangGraph、Deep Research、RL 系统等方向的研究者客座,反映学界前沿共识。
- 方法论清晰:它的实验设计、评价量规和诚信政策,是"AI 时代如何教与考"的具体答案。
1.3 研究方法与材料
本报告采用课程逆向工程:不依赖师生访谈,而是从公开课程产物反推设计意图。材料来源与证据对应如下(详见:https://github.com/daniellaah/cmu-11-768-ai-agents/)。
11-768-AI Agents Fall 2026 CMU.md | ||
course/syllabus.md | ||
course/schedule.md | ||
course/catalog.json | ||
assignments/README.mdassignments/01-harness/README.md 等 | ||
github.com/cmu-agents/assignment-1b3e1c20) | ||
project/{proposal,check-in,poster,report}.md | ||
experiments/template.md |
说明:本报告中的"观察"均来自上述公开材料;"洞察/建议"为本报告基于观察的综合推断,已尽量标注。
2. 课程概览:CMU 11-768 AI Agents
2.1 基本信息
2.2 课程目标(能力导向)
课程明确列出学生结课后应能:
在开源 LLM 之上从零实现一个 agent; 为多步任务设计评估; - 训练智能体以提升其能力;
对安全与可靠性权衡作出推理; 就 agent 的开放研究问题展开研究。
这五条目标罕见地把"实现—评估—训练—安全—研究"串成一条完整链路,而不是并列的知识点。评价一门 AI 时代课程是否到位,可以看它是否覆盖这条链路。
2.3 模块结构与时间分配
课程共 15 周、30 个日程条目(含 23 讲、3 次停课、2 次 project hours、2 次海报展示),按官方模块标签组织:
观察:模块是交错编排而非线性排布——能力(capabilities)→ 领域(domains)→ 训练(training)→ 框架/安全 → 交互/搜索,形成"先建立共同语言,再下钻领域,再学会训练,最后拓到系统与人"的螺旋。
2.4 评分结构:个人作业 + 团队研究
结构性洞察:
- 作业只占 40%,项目占 50%,参与占 10%。重心明确偏向"研究产出"而非"习题完成度"。
- 三次个人作业刻意等价于三种独立能力(造 / 评 / 训),避免"一个作业包打天下"的模糊评价。
- 最终报告 30% 的单点权重:说明课程把"把工作写成研究"视作与实现同等重要的能力。
3. 课程设计逻辑剖析
3.1 知识体系:一条"能力栈"贯穿全课
课程内容可抽象为一座三层塔,恰好对应三次作业:
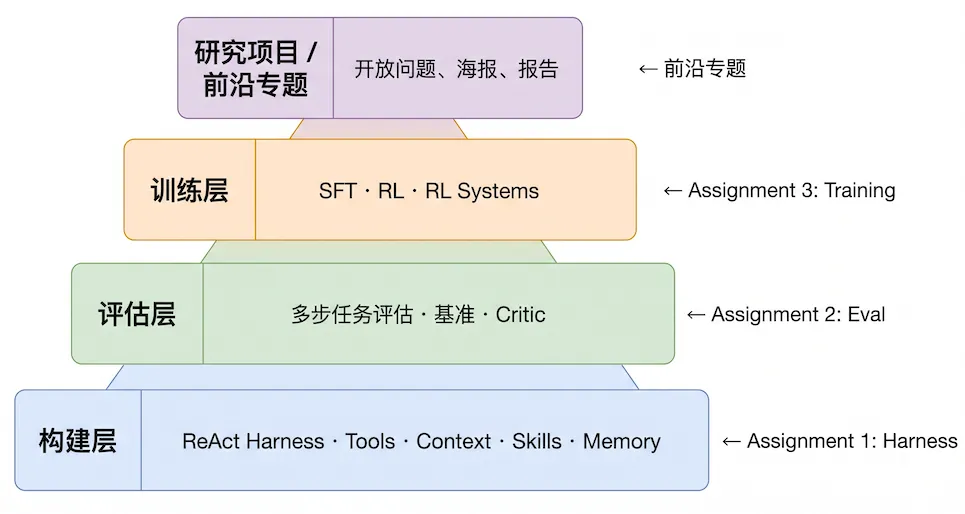
- 构建层:回答"智能体如何观察、行动、记住、规划";对应 Toolformer、ReAct、CodeAct、MemGPT、AWM 等经典与前沿读物。
- 评估层:回答"如何衡量一个多步、随机、长程系统的正确性与功能";这是 AI 时代最稀缺的工程能力之一。
- 训练层:回答"如何用数据与强化学习改进智能体";要求先修"训练语言模型",因此课程直接进入 SFT/RL/系统层面。
3.2 螺旋上升与先修假设
课程把先修设为"训练过语言模型",从而可以把宝贵的课时跳过"什么是 Transformer/梯度下降",直接用于智能体特有的问题。这是一种高门槛换高天花板的设计:面向研究生,用最短路径到达前沿。
3.3 能力目标的可测量化
课程没有停留在"理解agent"这类模糊表述,而是把目标写成可交付行为(implement / design evaluations / train / reason about / pursue research)。这使评分、作业、项目能共享同一套能力语言。
3.4 理论与实践的比例
讲座侧重概念 + 文献地图(每讲附大量 reading/reference)。 作业与项目侧重动手 + 实证。 两者通过"Assignment 对相关讲座"的显式映射(如 Assignment 1 → 讲座 01–06)耦合,避免"上课讲一套、作业做另一套"。
4. 教学方法与实践
4.1 "资源三件套 + 课堂串联"的翻转式资源模型
每讲公开三类材料:Slides(PDF)、Recording(YouTube 录播)、Readings/References。以第 1 讲为例:
Slides: lecture-01-agents.pdfRecording:YouTube 链接 Readings:Toolformer、ReAct、Mini-SWE-Agent
第 2 讲(工具使用)更进一步,列出 4 篇 readings + 26 条 references,覆盖 OpenAI API、HF Chat Templates、JSON Schema、OpenAPI、MCP 规范、FastMCP 等。这传递出一个教学法信号:课堂时间用于建立心智模型与串联脉络,细节交给可检索的权威一手文档。
4.2 Lecture highlights:用"微写作"替代点名
每次合格讲座后 24 小时内,学生须在 Canvas quiz 提交一条"课堂亮点":一个具体的收获或问题,须足够具体以证明参与了讲座。规则要点:
共 22 次机会,计分取其中 20 次(内置容错); - 不得由他人或 AI 生成;
评分看"及时、有思想的参与",不要求认同教师。
教学法价值:这是一种低成本、高频率的形成性评价(formative assessment),既解决大课出勤与注意力问题,又把"输出式学习"制度化。
4.3 客座讲师与一线研究者
课程邀请多位研究者主讲专题(JY Koh 讲 GUI/树搜索、Yueqi Song 讲 SFT、Akari Asai 讲 Deep Research、Eric Wallace 讲可观测性、Zora Wang 讲未来工作、Valerie Chen 讲人机交互、Karthik Narasimhan 与 Sasha Rush 客座)。这让学生接触到研究前沿与产业框架的第一手视角,也让课程内容能跟上领域月级迭代。
4.4 项目制学习:半学期研究项目
项目要求 2–3 人团队完成 Proposal → Check-in → Poster → Final report 全流程,占分 50%。项目模板(project/)覆盖:研究问题、动机与相关工作、假设、任务/环境/数据、基线与指标、方法、实验计划与算力预算、风险与退路、团队分工与时间线。
洞察:模板本身就是一份科研方法论脚手架——它把"如何提出并落地一个研究问题"显性化为可勾选的清单,这是研究生课程最常缺失的部分。
4.5 AI工具政策:允许但要求"可解释"
这是本课程最具时代特征的设计。政策要点:
作业与项目报告一般允许使用 AI 工具,除非具体作业另有规定; - 课堂亮点禁止AI 生成;
无论如何使用 AI,学生须对准确性、合规性、理解程度负责; 教师通过作业/报告的 quiz 来验证理解,可能要求学生解释设计决策、代码行为、实验结果与局限; "AI 输出不是权威来源,须核验代码、事实与引用"。
这是"AI 时代学术诚信"的可落地范式:不靠禁用(不可执行),而靠理解性质询(可执行、可辩护)来区分"会用 AI"与"被 AI 代做"。
4.6 弹性与公平:Slack days
每次作业配 2 个 slack day(24 小时延期,无需事先批准),不可跨作业转移;用完后每延迟一天扣 5%。proposal 与 final report 各 2 天,海报展示 0 天(因为是排期事件)。这是对研究生现实(会议、面试、健康)的温和制度化。
5. 实验设计深度拆解:以 Assignment 1 Harness 为例
Assignment 1 是理解"AI 时代软件工程专业实验课"的最佳切片。其官方讲义长达 386 行,信息密度极高。
5.1 三次作业的递进关系
A1 明确要求"通用的 ReAct 循环必须抽象、可跨领域复用",即先写框架,再实例化为 CodeAgent 与 ChessAgent——这正是软件工程"抽象与复用"的经典训练,但载体换成了智能体。
5.2 A1的三个部分(实验链条)
Part 1:构建编码 agent 并修复棋类应用
实现共享 Agent的 ReAct 循环:构造 prompt → 取模型动作 → 执行工具调用 → 追加观察 → 直到完成/步数上限。构造 CodeAgent 的 system/task prompt,系统信息须按指定 JSON 块逐字给出。 实现 execute、send_message两个工具,并要求畸形 JSON 与未知工具必须变成可恢复的观察,而不是抛出异常中断。实现技能(Skills)与渐进式信息披露(progressive disclosure):系统提示只放技能的 name/description,完整内容通过 invoke_skill工具按需加载。若无技能,提示中不得出现patch.txt或提交说明。让 agent 修复一个棋类应用的真实缺陷,产出 fix.patch并以"在全新 testbed 上重放补丁 + 跑回归测试"验证。
Part 2:上下文压缩(Context Compaction)
实现模型生成的工作记忆:保留目标、约束、文件、命令、编辑、结果、失败尝试、测试、阻塞与下一步;原样保留 system/task 与最近一条完整动作链路。 在 6,000 token 阈值下运行 SWE-bench 的 django__django-15368,并跑一个COMPACT_THRESHOLD=0的全上下文基线。提交 token-usage-analysis.md,比较两种条件下的 token 用量趋势并解释权衡。
Part 3:构建 ChessAgent,探索工具接口与程序化调用
定义 play_move(UCI 记法)并实现;错误(非法走法、malformed JSON、网络失败)须变成<chess_error>观察。- A/B 实验
:对两个模型分别比较"仅棋盘观察"与"棋盘 + 合法走法观察",记录 play_move调用数、非法率、是否终局,产出observation-experiment.md。 加入 simulate_move(无副作用推演)与run_python(程序化工具调用,在沙箱中把工具当普通函数调用)。再次引入 skill,要求轨迹体现 invoke_skill→run_python调simulate_move搜索 →play_move提交的协作链,而非每回合直接走子。
5.3 评价体系:证据化、量规化、防作弊
A1 满分 100 分,量规把每个能力点拆成独立计分的行,并绑定证据类型:
invoke_skill | ||
两个关键机制:
- Private tests:公开测试仅给里程碑,私有测试覆盖失败清理、重复/畸形技能、并行棋步、传输错误、artifact 一致性、真实 Modal 集成等。公开测试通过 ≠ 正确,这是刻意设计的。
- 轨迹重放(trajectory replay)+ 补丁重放:评分器"重放补丁与提交的轨迹,不发起新的 LLM 调用"。这既保证可复现、可审计,又控制评分成本,并天然抑制"只交截图/口头结论"。
5.4 基础设施:把"工程素养"写进工具链
A1 的工程栈本身就是教学内容:
uv:可复现的 Python 依赖管理;make setup/doctor/test/ run-*:统一入口与健康检查;- Modal:云端沙箱,安全执行模型生成的代码;make doctor 在不花钱的前提下校验子模块、认证与模型端点;
- 成本意识:区分"billable"操作,提示监控 API 用量、检查并停止遗留沙箱;
- 凭据安全:.env 管理密钥,明令"绝不出售/记录/提交凭据"。
洞察: make doctor这一类"零成本预检"设计,是把成本与安全当作一等公民的教学体现,也是 AI 课程最容易被忽视的工程纪律。
5.5 实验科学范式的内化
A1 反复要求学生做对照实验并解释权衡:
Part 2 的"压缩 vs 全上下文"token 分析; Part 3 的"两种观察接口 × 两个模型"四组 A/B; 明确说明"评分看实验与证据,而非某个结果或是否赢棋"。
这实际上把统计学意义上的实验设计(变量控制、对照、指标、可复现命令、局限性)植入了软件工程作业。
6. AI 时代软件工程课程的新方法与新实践(核心洞察)
6.1 从"写代码"到"造系统、评系统、训系统"
传统 SE 课程的能力终点是"能实现正确程序"。本课程的能力终点是"能构建并治理一个会自主行动的软件系统"。三种新能力被显性化:
- 构建(Harness Engineering):把概率模型包成可靠系统——提示结构、工具协议、错误恢复、上下文管理、技能编排。
- 评估(Evals):为随机、多步、长程系统设计可复现、可判定、可统计的度量。
- 训练(Training):用 SFT/RL 与系统优化改进智能体,涉及算力与成本工程。
6.2 "Harness 优先"——抽象机制比 API 更重要
课程把 A1 设计成"写一个通用的、领域无关的 ReAct Harness",再实例化到编码与棋类两个领域。这与软件工程的核心素养(抽象、接口、复用、关注点分离)高度一致,但载体从"业务模块"换成了"智能体循环"。API 会变,抽象能力不会——这是课程对"模型月更"现实的回答。
6.3 可复现性 = 轨迹 + Artifact + 成本
课程把"证据链"产品化:补丁、轨迹 JSON、游戏结果、token 分析报告、观察实验报告都作为提交物。评分器重放而非新调用。这带来三重收益:可审计、可复现、可规模化评分。AI 时代,"证据"本身就是交付物。
6.4 评价重心:从"结果正确"转向"过程可解释 + 可统计"
结果正确(补丁通过)仍是硬指标; 但同样重视过程:是否触发压缩、是否恢复错误、轨迹是否体现工具协作; 并要求统计思维:A/B、消融、趋势解释、局限性。
6.5 AI原生学术诚信
课程用"允许 + 理解性质询 + 局部禁用(课堂亮点)"的组合替代全面禁令。这提供了一个可复制的三支柱诚信模型:
- 允许层:作业与报告可用 AI;
- 约束层:关键能力点不得代做(亮点禁 AI,禁止硬编码答案);
- 验证层:quiz/答辩要求学生解释设计、结果与局限。
6.6 算力、成本与安全作为一等公民
沙箱(Modal)、凭据管理、可观测性、成本监控被独立成模块/讲次并贯穿作业。这标志着软件工程专业课程的外延扩展:安全不再只是"输入校验",而是权限、凭据、隔离、监控的系统工程。
6.7 研究前置:把课程当作科研训练场
项目占 50% 权重,模板覆盖从问题到算力预算到风险退路,并要求海报与最终报告。课程甚至提示"若教师建议显著提升项目质量,可考虑邀请其共同署名"。这把研究生课程与真实科研生产直接对接。
6.8 "渐进式信息披露":既是技术,也是教学隐喻
课程要求 agent 对技能采用 progressive disclosure(先给目录,用时再展开全文)。这个机制同时也是理想的教学法隐喻:课堂给"技能目录"(心智模型与索引),细节由学生在需要时按需深挖——这正是 4.1 的翻转式资源模型。
7. 对软件工程专业课程的可迁移建议
7.1 课程架构:可复制的最小骨架
第一段(共同语言,4–6 周) 何为 Agent → 工具/协议 → 上下文管理 → 技能与记忆 → 规划/多智能体第二段(工程闭环,与第一段交错) 构建 Harness → 设计 Evals → 训练/微调 → 安全与沙箱 → 框架与可观测性第三段(研究输出,后 4–6 周) 选题 → Proposal → Check-in → Poster → Final report贯穿线:成本意识、可复现性、AI 使用政策7.2 实验设计 Checklist
[ ] 是否有一个通用抽象,并能实例化到 ≥2 个领域? [ ] 是否强制错误可作为观察恢复,而非崩溃? [ ] 是否要求至少一组对照/消融实验,并提交证据(轨迹、指标)? [ ] 是否有零成本预检(doctor / public tests)与付费运行的清晰边界? [ ] 是否要求学生解释权衡与局限,而不只看最终分数? [ ] 是否用私有测试 + 重放防作弊,并明示"公开测试通过 ≠ 正确"? [ ] 是否把安全与凭据写进规则并在评分中体现?
7.3 评价体系:量规化的四条原则
- 能力点独立计分:一个能力失败不连坐其他能力。
- 证据绑定:每一项分数都要有可复核的 artifact/trajectory。
- 重放优先:评分用重放而非重新调用,保证公平与低成本。
- 过程与结果并重:既看是否通过,也看如何达成。
7.4 AI 使用政策模板(三支柱)
允许:作业/报告一般可用 AI,但须声明与负责; 约束:核心能力点禁止代做;关键参与类任务(如课堂亮点)禁 AI; 验证:通过随堂 quiz、口头解释或答辩验证理解。
7.5 基础设施最低配置
uvmake 统一入口 | |
.env | |
7.6 分角色建议
- 课程负责人:先定"能力栈"与评分权重(个人作业 40% / 项目 50% / 参与 10% 是值得参考的比例),再倒推讲座。
- 授课教师:采用"资源三件套 + 课堂串联",把文献地图交出去,把时间留给串联与讨论。
- 助教:维护 public/private 测试分层、doctor 与重放评分器;组织 project hours。
- 学生:把每次实验当作"可复现的论文雏形"来做,从第一天就积累轨迹与成本数据。
8. 风险、争议与局限
上述"材料快照不一致"来自仓库快照与课程介绍文本的对比,属客观观察,非课程缺陷断言——公开课程材料在迭代中出现版本差异属正常现象,应以官方 live 页面为准。
9. 结论
CMU 11-768《AI Agents》提供了一份 AI 时代软件工程专业课程的高质量范本。它的核心贡献不在于"教了哪些模型或 API",而在于重构了课程的第一性对象、能力栈与证据观:
- 对象转移:以智能体系统(而非程序)为教学对象;
- 能力重组:构建—评估—训练三层闭环,对应个人作业,并以研究项目收口;
- 方法升级:资源三件套 + 微写作参与 + 科学范式实验 + 证据化量规;
- 治理创新:AI 允许但须可解释,算力/安全/成本成为一等公民;
- 出口前移:把课程直接作为科研训练与可发表工作的孵化器。
对于正在思考"AI 时代软件工程专业怎么教"的院校,这门课最值得借鉴的不是它的具体 topic,而是它的设计方法:先定义能力栈,再用证据链贯穿始终,最后用政策把"用AI"与"靠AI"区分开。掌握这套方法,课程就能在模型月更的浪潮中保持稳定与可迁移。