ARTICLE · 1112009
百页策划案成了 AI 程序员照妖镜:A2Z 基准测出长程开发深层短板
点上方蓝色头像关注,持续推送优质 AI 内容
给大模型一段提示词,让它在几分钟内敲出一个能跑的贪吃蛇或俄罗斯方块,已经算不上什么新鲜事。但在真实的软件工程中,写出看似能运行的小玩具与交付一套符合长篇规格书的复杂系统,完全是两码事。最近一项专门针对游戏开发的评测基准显示,当 AI 编码智能体直面包含多重约束与前后依赖的长篇设计文档时,往往会陷入“顾头不顾尾”的工程泥潭。
写小脚本不灵了,整套游戏才是硬碰硬
游戏开发涉及逻辑、渲染、交互等多模块协同,对需求一致性要求极高。这使得游戏设计文档(Game Design Document,简称 GDD)天然具备了极高的结构复杂度,它要求底层系统与顶层表现之间维持严丝合缝的逻辑约束。
然而,过去行业中用来评估代码大模型的评测方案,大多集中在单函数补全或孤立的错误修复上。即便是针对游戏开发的评测任务,往往也只提供几行简短的需求描述。研究团队在 arXiv 发布预印本论文研究团队在 arXiv 发布预印本论文《A2Z GameSpec-Bench: How Faithfully Can Coding Agents Generate Games from Game Design Specifications?》(标注日期为 2026 年 9 月 30 日),提出评测智能体从游戏设计规范生成游戏的基准。研究人员明确指出,现有游戏开发评测基准普遍采用简短紧凑的需求规范,缺乏对长篇游戏设计文档中跨游戏逻辑、渲染和玩家交互的相互依赖需求的评测支持。
研究团队构建了新的评测场景。A2Z GameSpec-Bench 包含 100 份长篇游戏设计文档(GDD),专门用于评估智能体端到端自主开发游戏的能力。该基准用于评估智能体端到端自主开发游戏的能力。
代码能跑不算赢:静态扫描与动态试玩的双重闭环
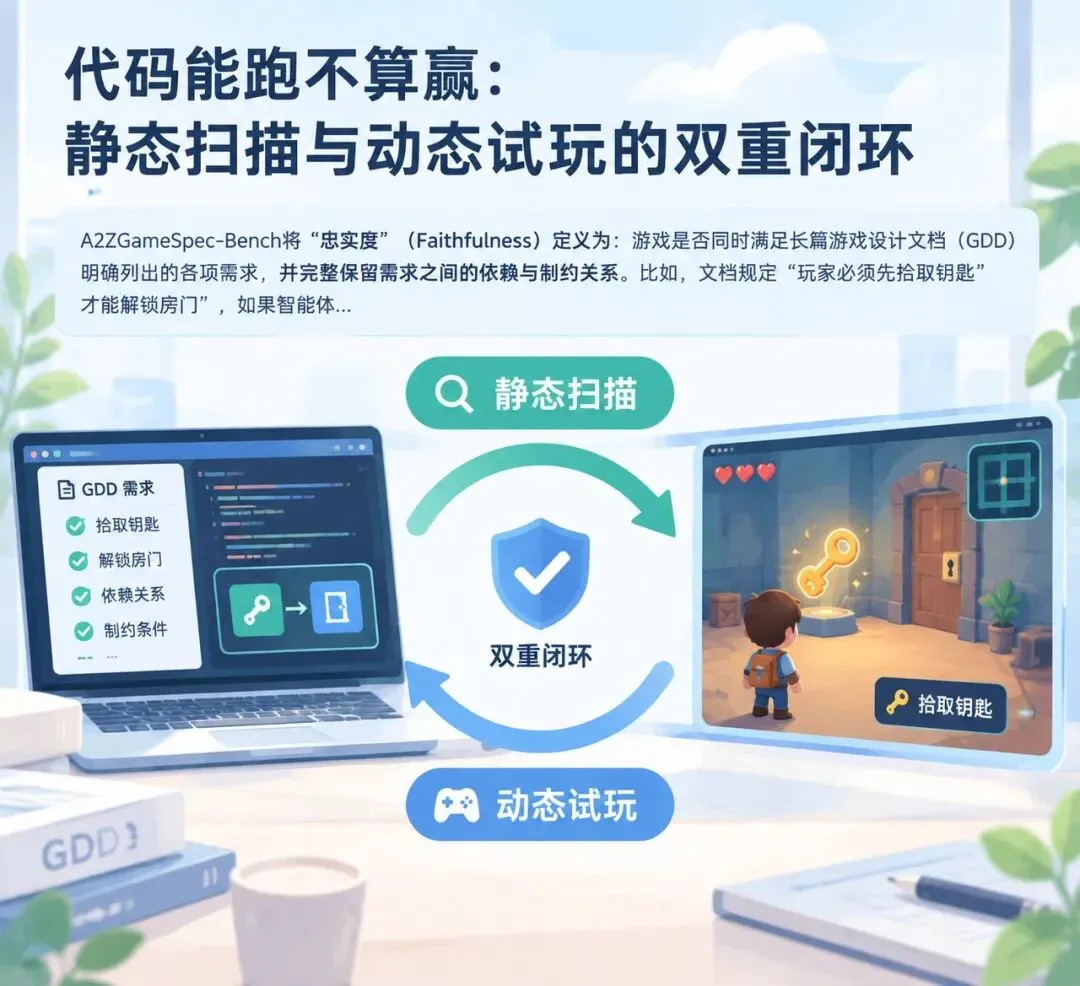
A2Z GameSpec-Bench 将“忠实度”(Faithfulness)定义为:游戏是否同时满足长篇游戏设计文档(GDD)明确列出的各项需求,并完整保留需求之间的依赖与制约关系。比如,文档规定“玩家必须先拾取钥匙才能解锁房门”,如果智能体生成的代码让玩家不用钥匙就能撞开门,即使整个游戏程序没有报错崩溃,其系统逻辑也已经被判定为实质性失效。
在评测流程中,每份长篇 GDD 都会被形式化转化为包含规则、约束和前置关系的“依赖感知契约”。评测体系遵循工业界游戏开发实践,将源代码静态检查与智能体生成的测试策略相结合,实施基于场景的重放与自适应动态试玩。评测体系将源代码静态检查与智能体生成的测试策略相结合,实施基于场景的重放与自适应动态试玩。
依赖契约在不同编码智能体以及多轮代码修改过程中保持固定,将判定结果和执行证据挂钩到具体需求上以实现稳定对比和定位失败根因。评测系统不仅能指出游戏哪里做错了,更能直接把失败证据锁定在某一条被违背的具体契约条款上。
盲目自省行不通:破解长程依赖崩溃需要精准靶向
评测结果表明,当前主流编码智能体在兼顾代码实现逻辑与实际运行试玩时,极难同时满足那些具有相互依赖关系的多维需求。当前主流编码智能体在兼顾代码实现逻辑与实际运行试玩时,极难同时满足那些具有相互依赖关系的多维需求。
相比之下,缺乏外部约束的自我修正(self-revision)难以应对复杂依赖链。
研究显示,引入针对具体需求的反馈可改善表现。在两轮迭代修正后,提供针对具体需求的反馈能使智能体的 GDD 忠实度相比自我无监督修正(self-revision)提升 10.9%。这表明,针对具体需求的反馈比无监督自我修正更能提升智能体对复杂需求的遵循能力。
该基准表明,评估代码智能体需超越实现层面的判断,关注其对长篇规范中复杂依赖关系的遵循能力。