ARTICLE · 1112010
RSIGame不只让AI多改几轮游戏,而是给迭代加上“刹车”
点上方蓝色头像关注,持续推送优质 AI 内容
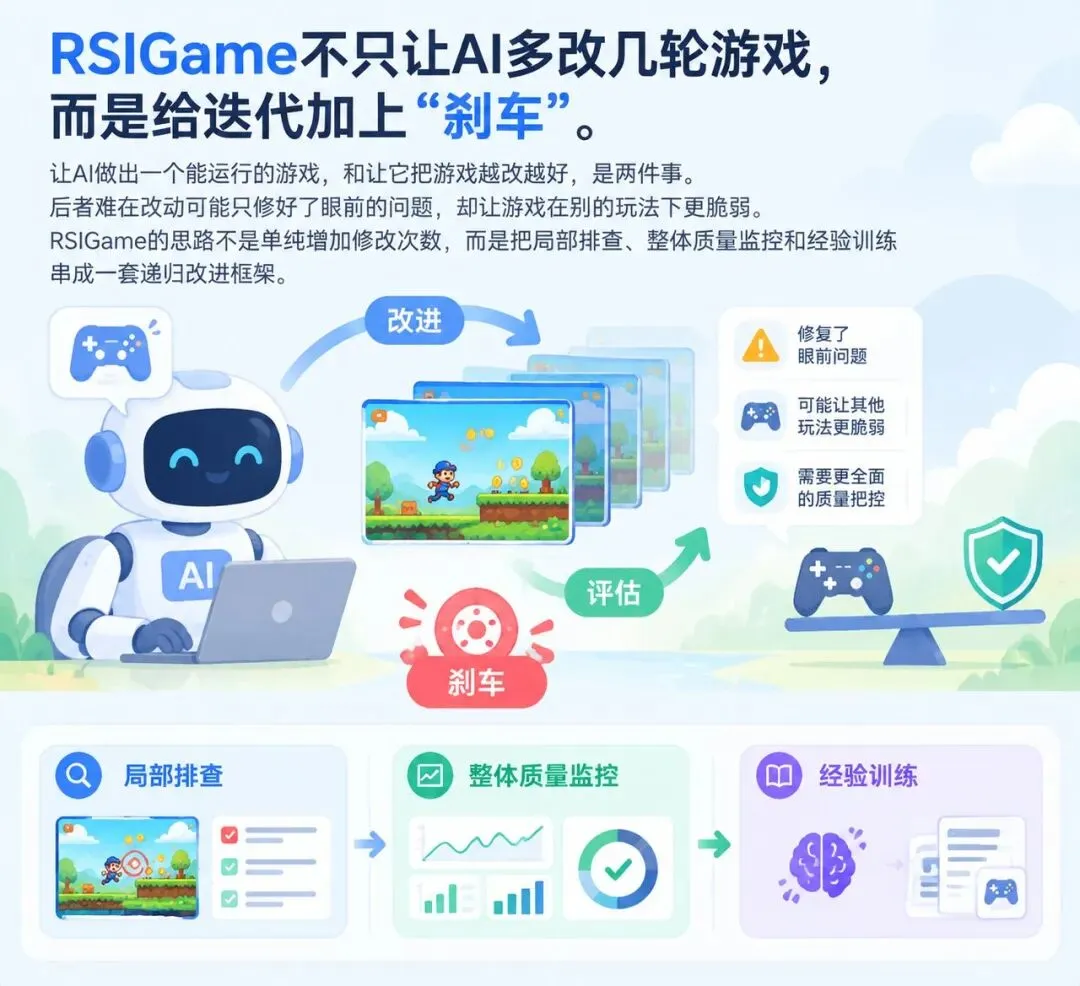
让 AI 做出一个能运行的游戏,和让它把游戏越改越好,是两件事。后者难在改动可能只修好了眼前的问题,却让游戏在别的玩法下更脆弱。RSIGame 的思路不是单纯增加修改次数,而是把局部排查、整体质量监控和经验训练串成一套递归改进框架。
能玩只是起点,反复修补也会修偏
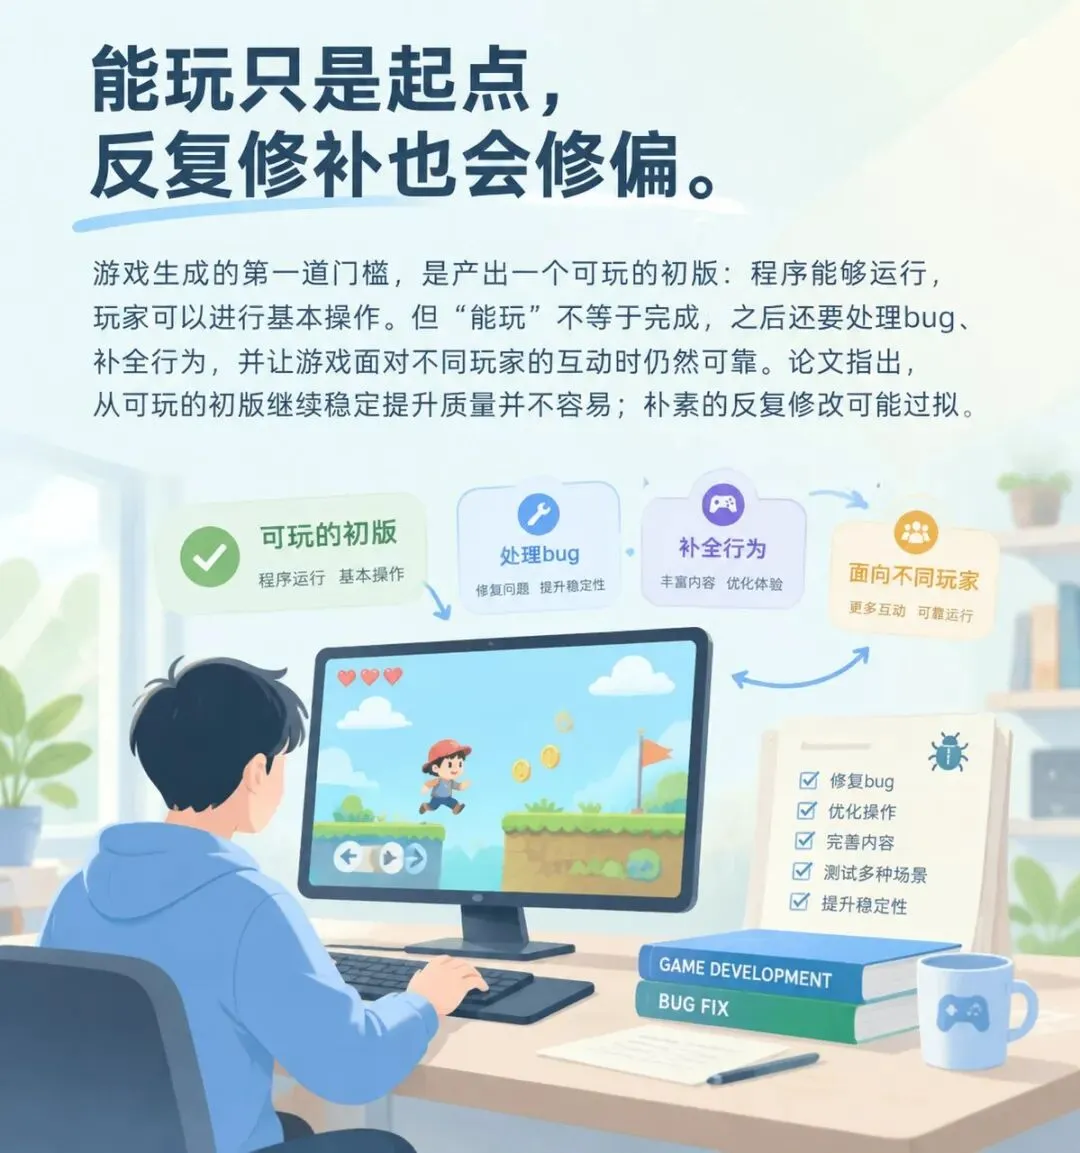
游戏生成的第一道门槛,是产出一个可玩的初版:程序能够运行,玩家可以进行基本操作。但“能玩”不等于完成,之后还要处理 bug、补全行为,并让游戏面对不同玩家的互动时仍然可靠。论文指出,从可玩的初版继续稳定提升质量并不容易;朴素的反复修改可能过拟合少量测试用例,留下 bug、缺失行为,也难以推广到更广泛的玩家互动。
这里的“过拟合”,可以理解为模型把有限的测试题背熟了:它针对某个测试问题做出修正,却不一定真正理解问题背后的规律。放到游戏里,某次操作测试通过了,不代表玩家换一种顺序、换一种策略,游戏也能正常回应。只盯着少数已知问题打补丁,改动看上去有效,整体体验却可能变得更脆弱。这个判断正是 RSIGame 试图处理的起点。
局部找问题,全局盯住改动有没有退步
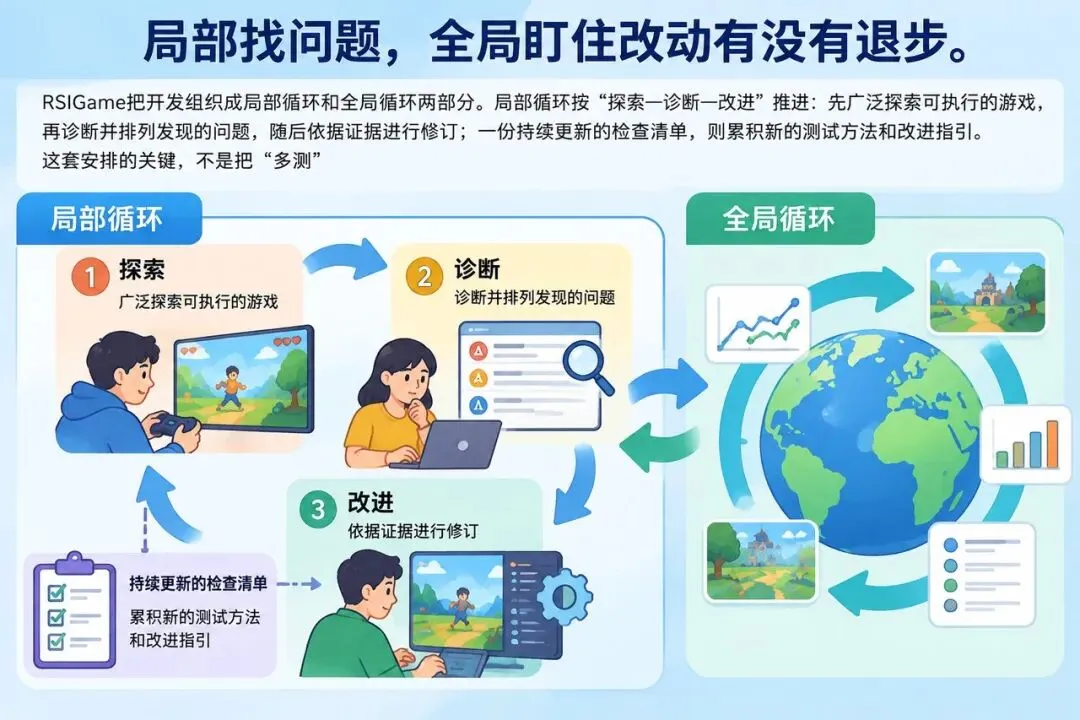
RSIGame 把开发组织成局部循环和全局循环两部分。局部循环按“探索—诊断—改进”推进:先广泛探索可执行的游戏,再诊断并排列发现的问题,随后依据证据进行修订;一份持续更新的检查清单,则累积新的测试方法和改进指引。
这套安排的关键,不是把“多测几次”包装成新方法,而是试图让测试发现的问题进入下一轮开发的依据。持续更新的清单有机会把一次修复留下的经验带到之后的检查中,减少每次都从零开始的盲目试错。不过,清单也不是质量本身:如果探索范围有限,或诊断没有找准问题,后续修订仍可能沿着错误方向推进。
因此框架还设置了全局循环:它跟踪整体质量,保留表现最好的检查点,并检测长期开发过程中是否出现饱和或退步。检查点可以理解为一个可回到的阶段版本;它的价值在于,局部修改如果让整体表现变差,系统不必把这次变化当成进步继续累积。局部循环负责发现和处理具体问题,全局循环负责避免“修了一个地方、坏了另一处”被误认为持续进步。
经验训练瞄准少返工,摘要报出高分与省量
RSIGame 还把改进分成两层:一层是在开发过程中测试和修订,另一层是通过训练,把成功的开发经验内化到生成器中。所谓经验内化,意思不是只让系统在当前游戏里修得更好,而是希望训练后的生成器在后续生成时也能用上积累下来的经验。
论文摘要称,评测覆盖 140 项 GameCraft-Bench 任务、两种游戏引擎和五种生成器,并称在开发预算匹配的条件下,RSIGame 持续提升了游戏质量。Godot 和 Phaser 是两种游戏引擎,也就是用来运行和开发游戏的软件环境。摘要报告,经验内化后,Qwen3.8-27B 在 Godot 上得分 61.38、在 Phaser 上得分 58.53;作者称这超过了 GPT-5.5 单次生成的分数,同时让 Qwen 生成时消耗的文本处理单位减少 11 倍。文本处理单位是模型读取和生成文字时计量的基本单位,常用来估算模型调用开销。
这些数字如果成立,传递出的信号不只是“某个模型分数更高”:反复开发得到的经验,可能帮助模型把更多修正前置到生成阶段,减少之后的返工。但分数究竟衡量什么、比较时如何设置、文本处理单位按什么口径统计,都会影响结论该怎样解读。眼下能确定的是,摘要提出了一个覆盖多任务、多引擎和多生成器的评测范围,并报告了上述结果;要判断这些结果能否支撑更广泛的产品结论,还需要看到完整实验细节。
RSIGame 值得看的地方,是它把游戏生成后的迭代当作一个需要管理的开发过程:局部发现问题,全局防止退步,再把有效经验送回生成器。这个框架抓住了自动生成从“能运行”走向“经得起多种玩法”的关键难题。眼下的分数可以说明论文摘要声称取得了进展,却还不能替代对方法和实验设置的检验;真正重要的,是这套机制能否让游戏在不同互动下都变好,而不是只在有限测试里显得更好。