ARTICLE · 1112123
把512G运行内存塞进电脑!苹果顶配飙到19万,极客4台组网杀疯:彻底告别云端!
一台电脑,价格快赶上一辆汽车
最近,一组超出常规认知的硬件规格在科技圈和社交网络上掀起巨浪:512GB 统一内存、1.2TB/s 内存带宽、满配价格逼近 19 万元人民币。
很多人的第一反应是:苹果疯了吗?谁会花近 20 万买一台小巧的台式主机?
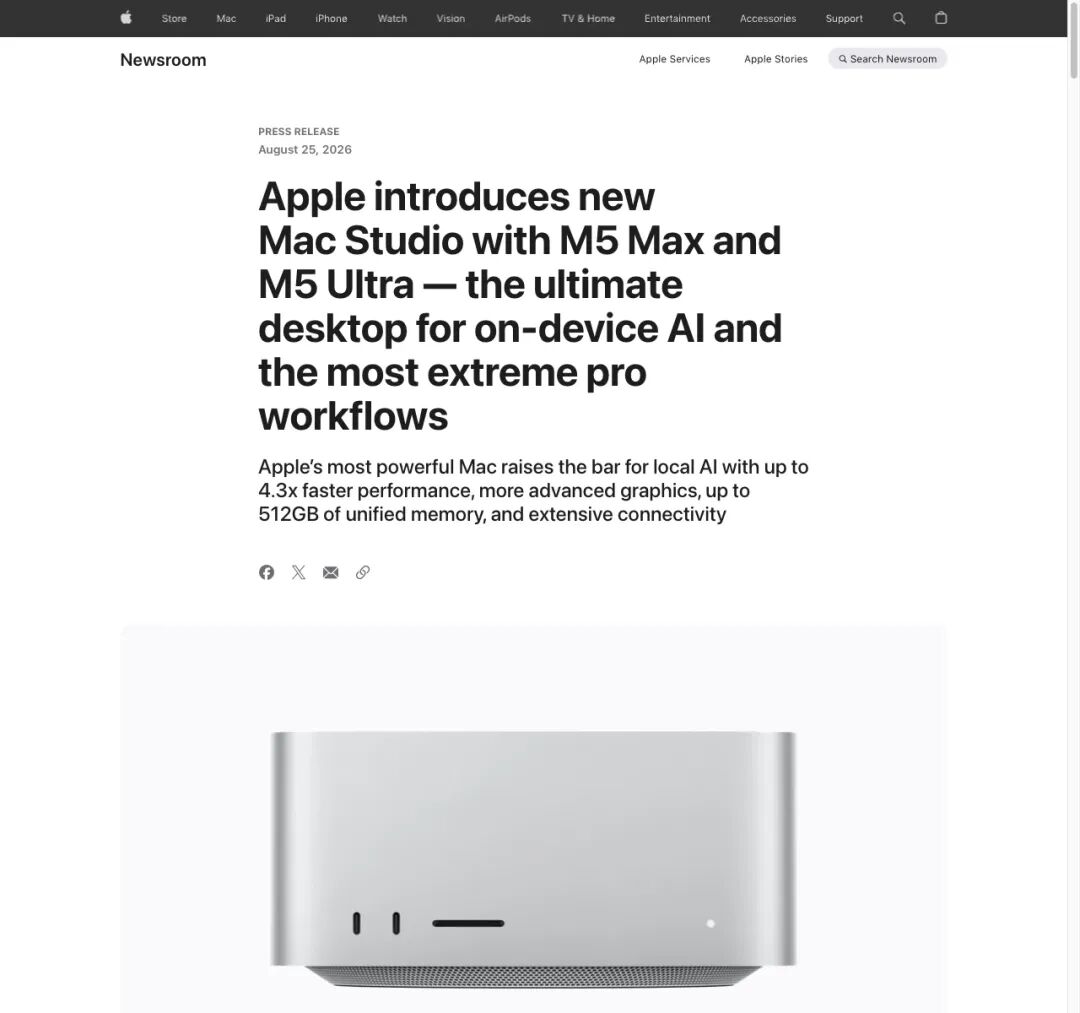
▲ 苹果新闻稿发布搭载 M5 Max 与 M5 Ultra 的新一代 Mac Studio
需要分清的是,这里的 512GB 是货真价实的“运行内存(RAM)”,完全不同于日常存电影、装游戏的固态硬盘存储。
当普通电脑还在为 16GB 还是 32GB 内存纠结时,苹果直接把半个 TB 的物理内存焊在了芯片旁边。
更让全球极客和 AI 开发者疯狂的是随后的连锁反应:有人用几根雷雳线把 4 台机器连在一起,在自家的书桌上搭建出了一座拥有 1TB 共享内存、4.8TB/s 吞吐速率的超级私人算力节点。
一场关于本地大模型与算力主权的革命,正在书桌上悄然打响。
01显存荒漠里的绿洲:为什么大模型在疯狂“吞噬”内存?
要理解这场疯狂,首先得明白当前人工智能发展最大的隐痛:显存墙。
今天,无论是以前沿开源模型 GLM 系列,还是 Llama 系列为代表的超大语言模型,它们的体积都以百亿、千亿参数计算。
要在本地跑起这些庞然大物,传统的 PC 面临一个绝望的物理困境:
消费级显卡算力很强,但显存极度吝啬。顶级显卡通常也只有 24GB 或 32GB 显存。 一个 70B(700亿参数)甚至千亿参数的大模型,动辄需要几十甚至上百 GB 的空间。 - 装不下,算力再高也是一块废铁。
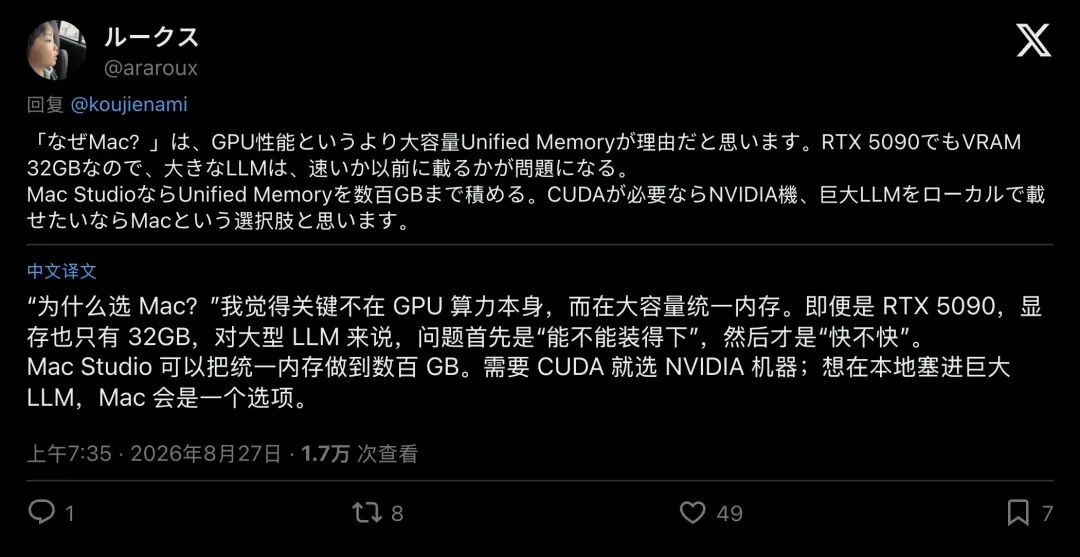
▲ 工程师直言:做 CUDA 开发看英伟达,但在单机塞进超大模型上,Mac 成了独一无二的选项
这正是苹果“统一内存架构(Unified Memory)”实现降维打击的地方。
在传统 PC 上,内存和显存各管一段,数据在两者之间搬运极慢;而在苹果芯片中,CPU、GPU 和神经网络加速核心共享同一个巨大的物理内存池。
只要把这块 512GB 的大物理内存池塞满,高达 80 核的 GPU 即可直接以最高 1.2TB/s 的恐怖带宽吞吐模型权重。
这相当于直接把原本属于云端机房的前沿超大模型,硬生生塞进了单台桌面主机里。
024条线缆连成“核反应堆”:物理外挂般的 RDMA 集群
如果一台 512GB 的机器还不够装下最顶级的开源模型,苹果这次还掏出了一个近乎“作弊”的底层杀招,Thunderbolt 5 与 RDMA(远程直接内存访问)技术。
在过去,想要把几台电脑的算力合在一起跑大模型,网络通信的延迟足以让推理速度慢如蜗牛。
而 RDMA 彻底绕过了繁琐的操作系统协议栈,让一台 Mac 可以像读取本地内存一样,直接跨机器读写另一台 Mac 的内存。
苹果官方给出的数据极其硬核:4 台 Mac Studio 组成集群,分布式 AI 推理速度最高可比单机快约 3 倍。
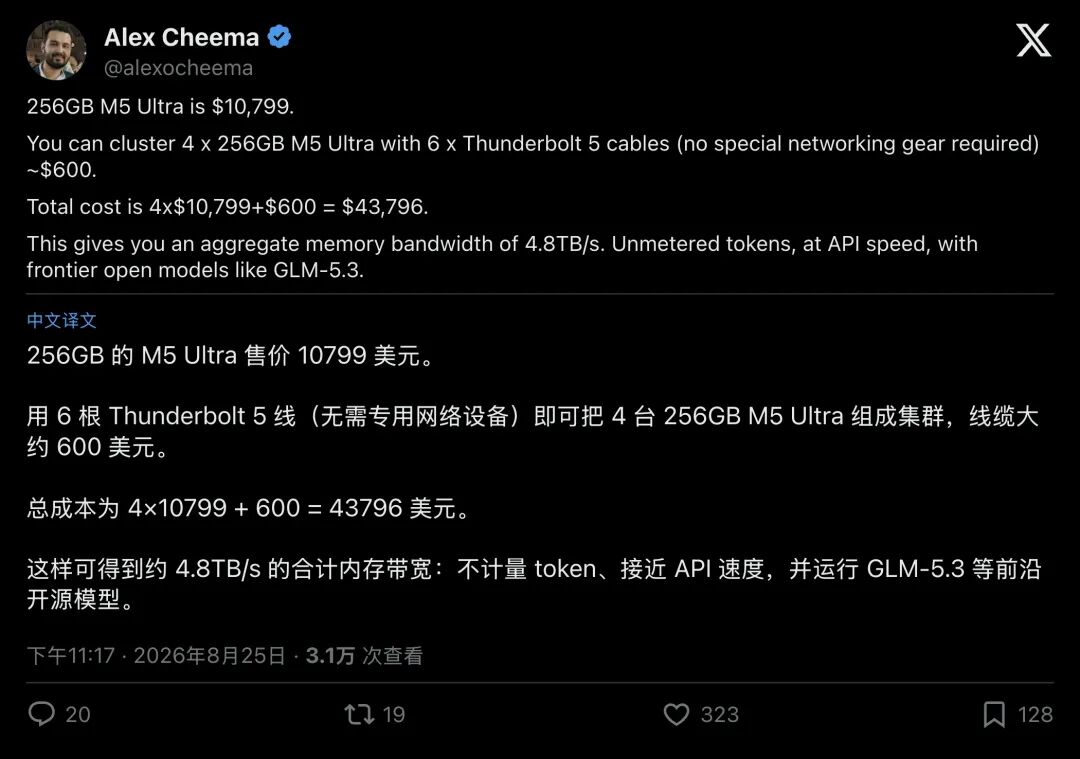
▲ 极客算账:4 台 M5 Ultra 组成集群,获得 4.8TB/s 聚合带宽与无限制的私有 Token
开发者社区很快算清了一笔账:
4 台 256GB 的 M5 Ultra Mac Studio,配上 6 根高速雷雳 5 线缆。 硬件总投入约 4.38 万美元。 换来的是 1TB 的可用超大共享内存池,以及高达 4.8TB/s 的聚合内存带宽。
在自家的地下室或办公室里,不需要机架服务器,不需要高噪音工业风扇,插上几根线,就能以接近云端 API 的生成速度,完全离线、无限量地运行顶级前沿大模型。
正如华尔街与极客圈流传的那句辣评:“当所有人都在云端按 Token 计费给巨头交税时,苹果在卖属于你自己的私人水管。”
03软件栈大洗牌:llama.cpp、MLX 与生态的暗战
光有怪兽级的硬件还不够在高性能计算领域,没有匹配的编译器和软件运行时,硬件只是一块耗电的硅片。
在 macOS 的本地 AI 世界里,一场围绕底层运行时的生态对决正进入白热化。
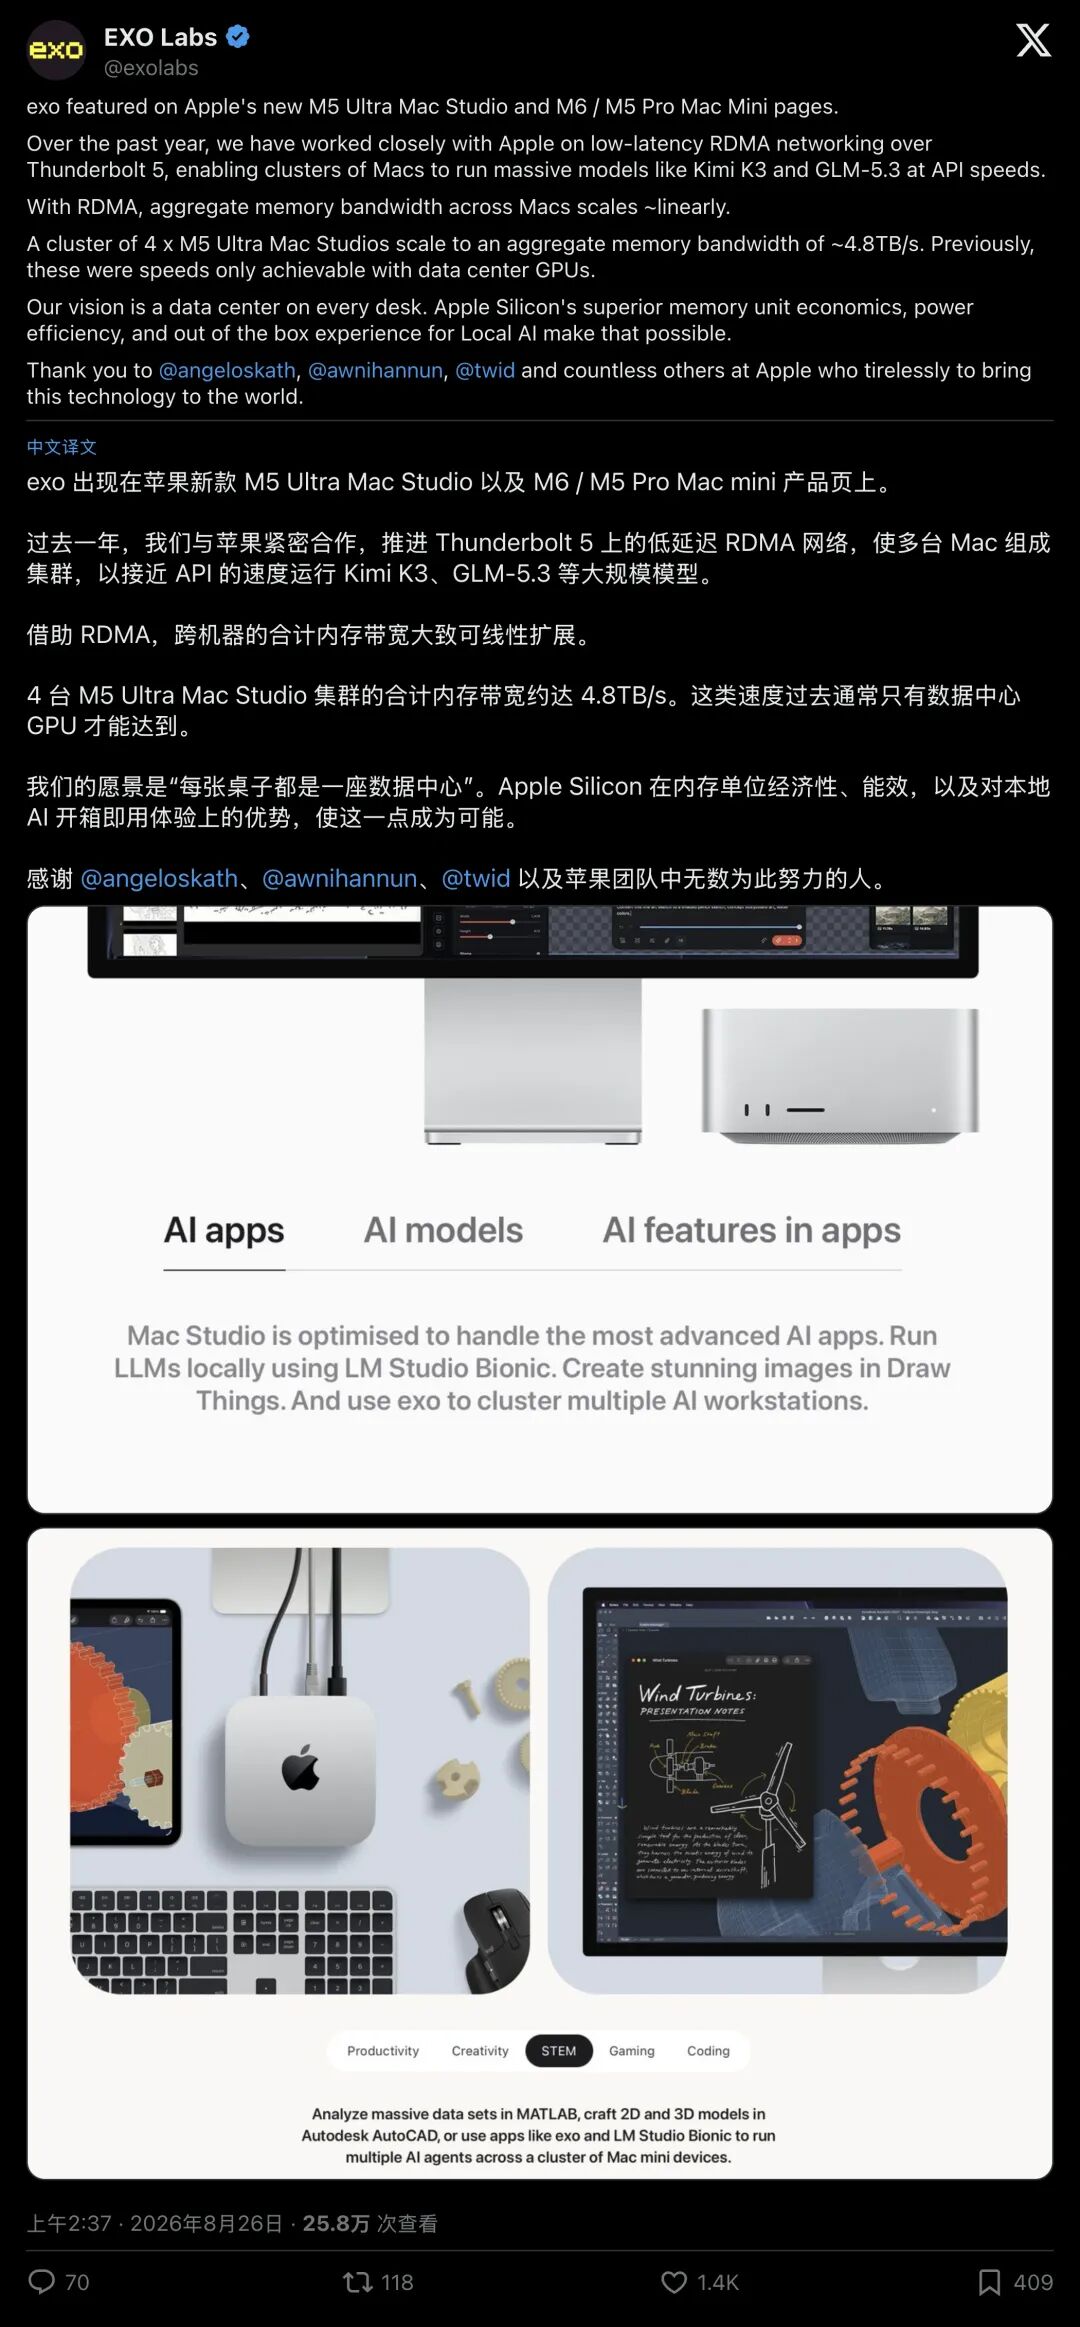
▲ 本地 AI 团队 EXO 方案现身苹果官网,展示桌面级集群的落地可能
目前,macOS 本地大模型生态呈现出三大主力协同与竞争的格局:
- 开源基石 llama.cpp
:纯 C/C++ 打造,凭借通吃全网的 GGUF 格式 统治着开源模型转换生态,资源控制细致入微,是全网新模型尝鲜的第一站。 - 苹果亲儿子 Apple MLX
:苹果机器学习研发团队量身定制的秘密武器。深度绑定 Metal 与 M5 芯片底层的 Neural Accelerators(神经加速器)。实测显示,MLX 调动矩阵加速核心的效率极高,长文本首字响应延迟(TTFT)最高可比通用着色器缩短至四分之一(快达 4 倍),稳态生成吞吐领先 15% 到 30%,并且原生支持多机 RDMA 张量并行。 - 开箱即用的 Ollama 与桌面客户端
:原本绑定 llama.cpp 的 Ollama 顺应潮流,正式引入 MLX 双引擎加速;配合 LM Studio 等图形化工具,普通人不需要写任何复杂的 Python 代码,点击鼠标就能调动这头上百 GB 内存的性能怪兽。
硬件狂飙与软件优化的双向奔赴,让“在本地跑大模型”彻底脱离了早期的玩具阶段,成长为兼具实用价值的高生产力工具。
0419万的天价狂欢与清醒的现实边界
然而,当热潮涌向普通大众时,各种信息变形与夸大也随之而来。我们需要拨开迷雾,看清事实的边界
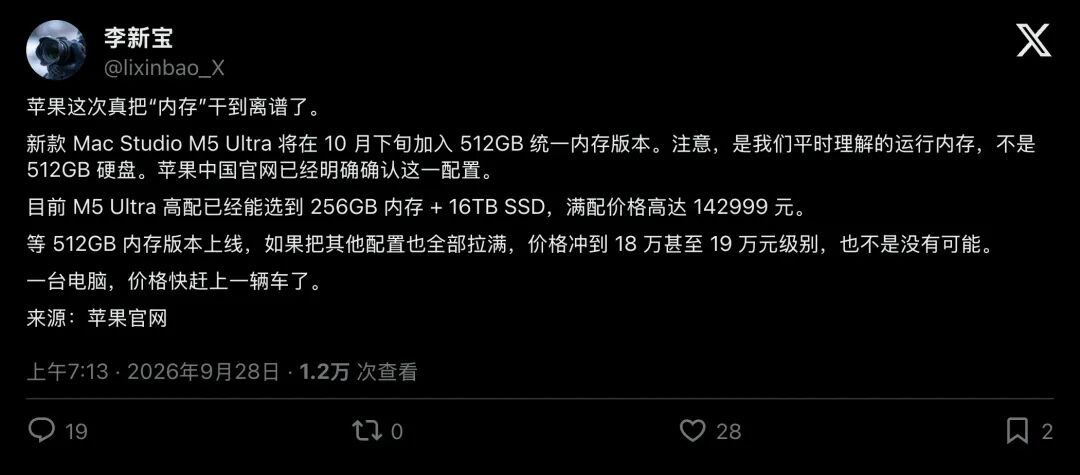
▲ 中文数码博主直言:512GB 是运行内存,满配价格将刷新认知
在中文互联网上,关于价格的讨论迅速登上热搜。目前在售的 256GB 内存 + 16TB SSD 版本已达 14 万多元,而一旦把 512GB 统一内存及所有顶级配置拉满,整机售价确实将直奔 18 万至 19 万元人民币。
面对这台天价主机,必须厘清几个关键事实:
- 时间节点的差异
:苹果于 2026 年 8 月 25 日正式公布这批新品,9 月 22 日起多数配置开始发货,而 512GB 顶配版按官方规划需等到 10 月下旬才正式提供。 - 拒绝“入门机神话”
:网络上有视频声称 899 美元的入门款 Mac mini 就能通跑所有前沿大模型,这显然违背物理规律。入门机型可以作为轻量级本地 AI 的试金石,但要承载几百亿参数以上的生产力级模型,依然需要高带宽、大内存的硬件支撑。 - 算力主权的真实买家
:社交网络上,已经有资深极客晒出刚到手的 256GB Mac Studio 包装盒。这些买家大多身处数据极度敏感的金融量化、前沿代码开发、医疗隐私分析或高校实验室,有着明确的工业级业务诉求。
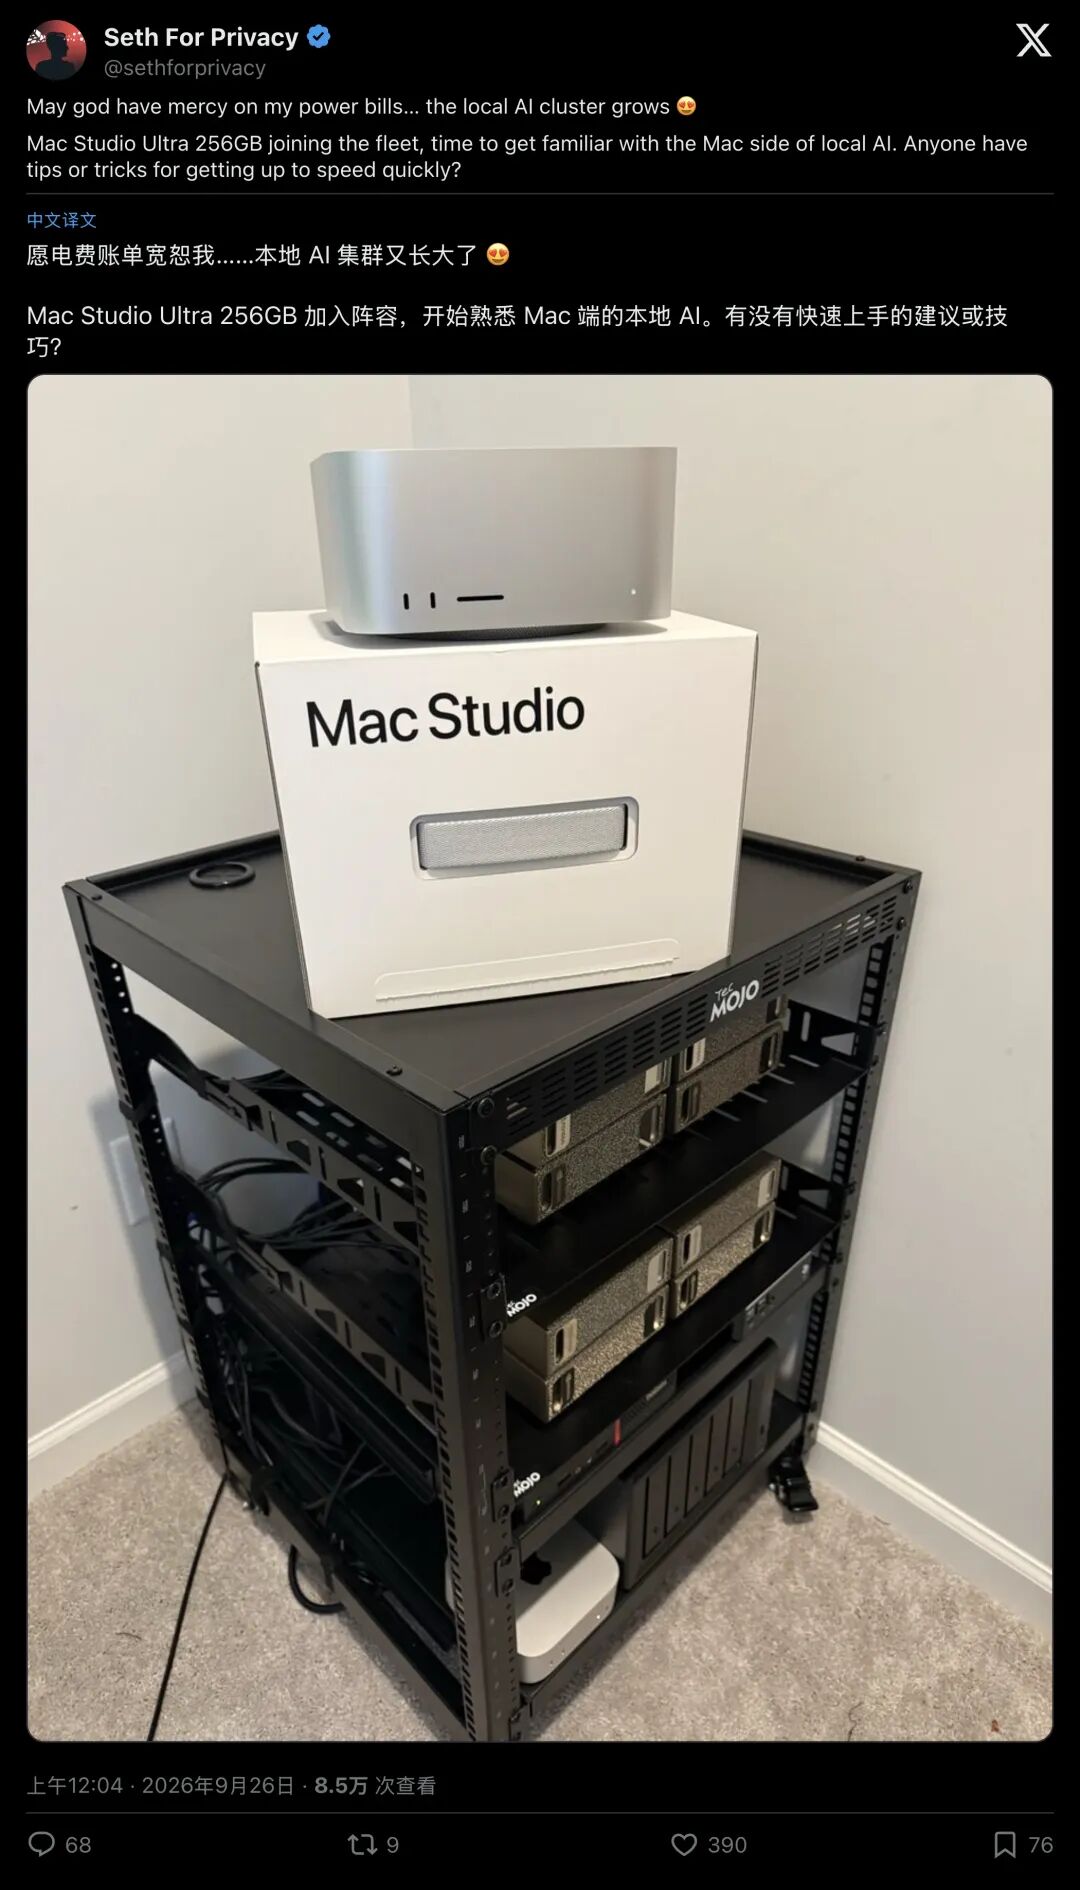
▲ 极客用户晒出 256GB Mac Studio Ultra 现货包装,本地私有 AI 阵营再添猛将
05终局思考:桌面算力主权的回归
回顾过去两年的 AI 浪潮,我们习惯了向云端巨头按月支付订阅费、按 Token 付账单,忍受网络延迟,并时刻担心自己的商业机密与代码被上传分析。
苹果通过 M5 Ultra、512GB 统一内存以及雷雳 5 组网,向行业递出了一份截然不同的答卷。
这套方案无意与数据中心数十万张专业 GPU 组成的庞大集群争高下,其核心价值在于在每个专业工作者、独立开发者和小团队的书桌上,开辟出一块不被云端断网、不被账单绑架的算力自留地。
近 20 万元的电脑固然昂贵,但对于那些必须把核心数据牢牢握在自己手里的人来说,按下开机键的那一刻,便锁定了完全属于自己的数字智慧所有权。