ARTICLE · 1112124
9代近亲繁殖后,AI彻底疯了!牛津剑桥《自然》发文:大模型正吃掉自己
如果让一个大语言模型只读上一代 AI 写出的内容,一代接一代地自我训练,会发生什么?
在实验进行到第 9 代时,令人毛骨悚然的一幕发生了。
研究人员在输入框里输入了一段关于中世纪教区教堂塔楼、石匠与垂直哥特式建筑风格的严肃历史资料,期待模型续写。然而,经历了 9 轮“自产自销”数据投喂的模型,已经完全丧失了对人类世界的认知。
它在屏幕上敲出了一串胡言乱语:
“……这里拥有世界上最大的黑尾、白尾、蓝尾、红尾、黄尾大野兔(jackrabbits)种群……”
从庄严的哥特式大教堂退化成变异的大野兔,这一幕并非出自虚构小说,顶级学术期刊《自然》(Nature)在论文中如实记录了这场科学实验。
在社交网络上,关于“模型崩溃”的讨论再次引发广泛共鸣与担忧:当互联网充斥着大量 AI 生成的内容,未来的大模型在缺乏新增源头输入的情况下,是否会陷入自我循环的退化深渊?
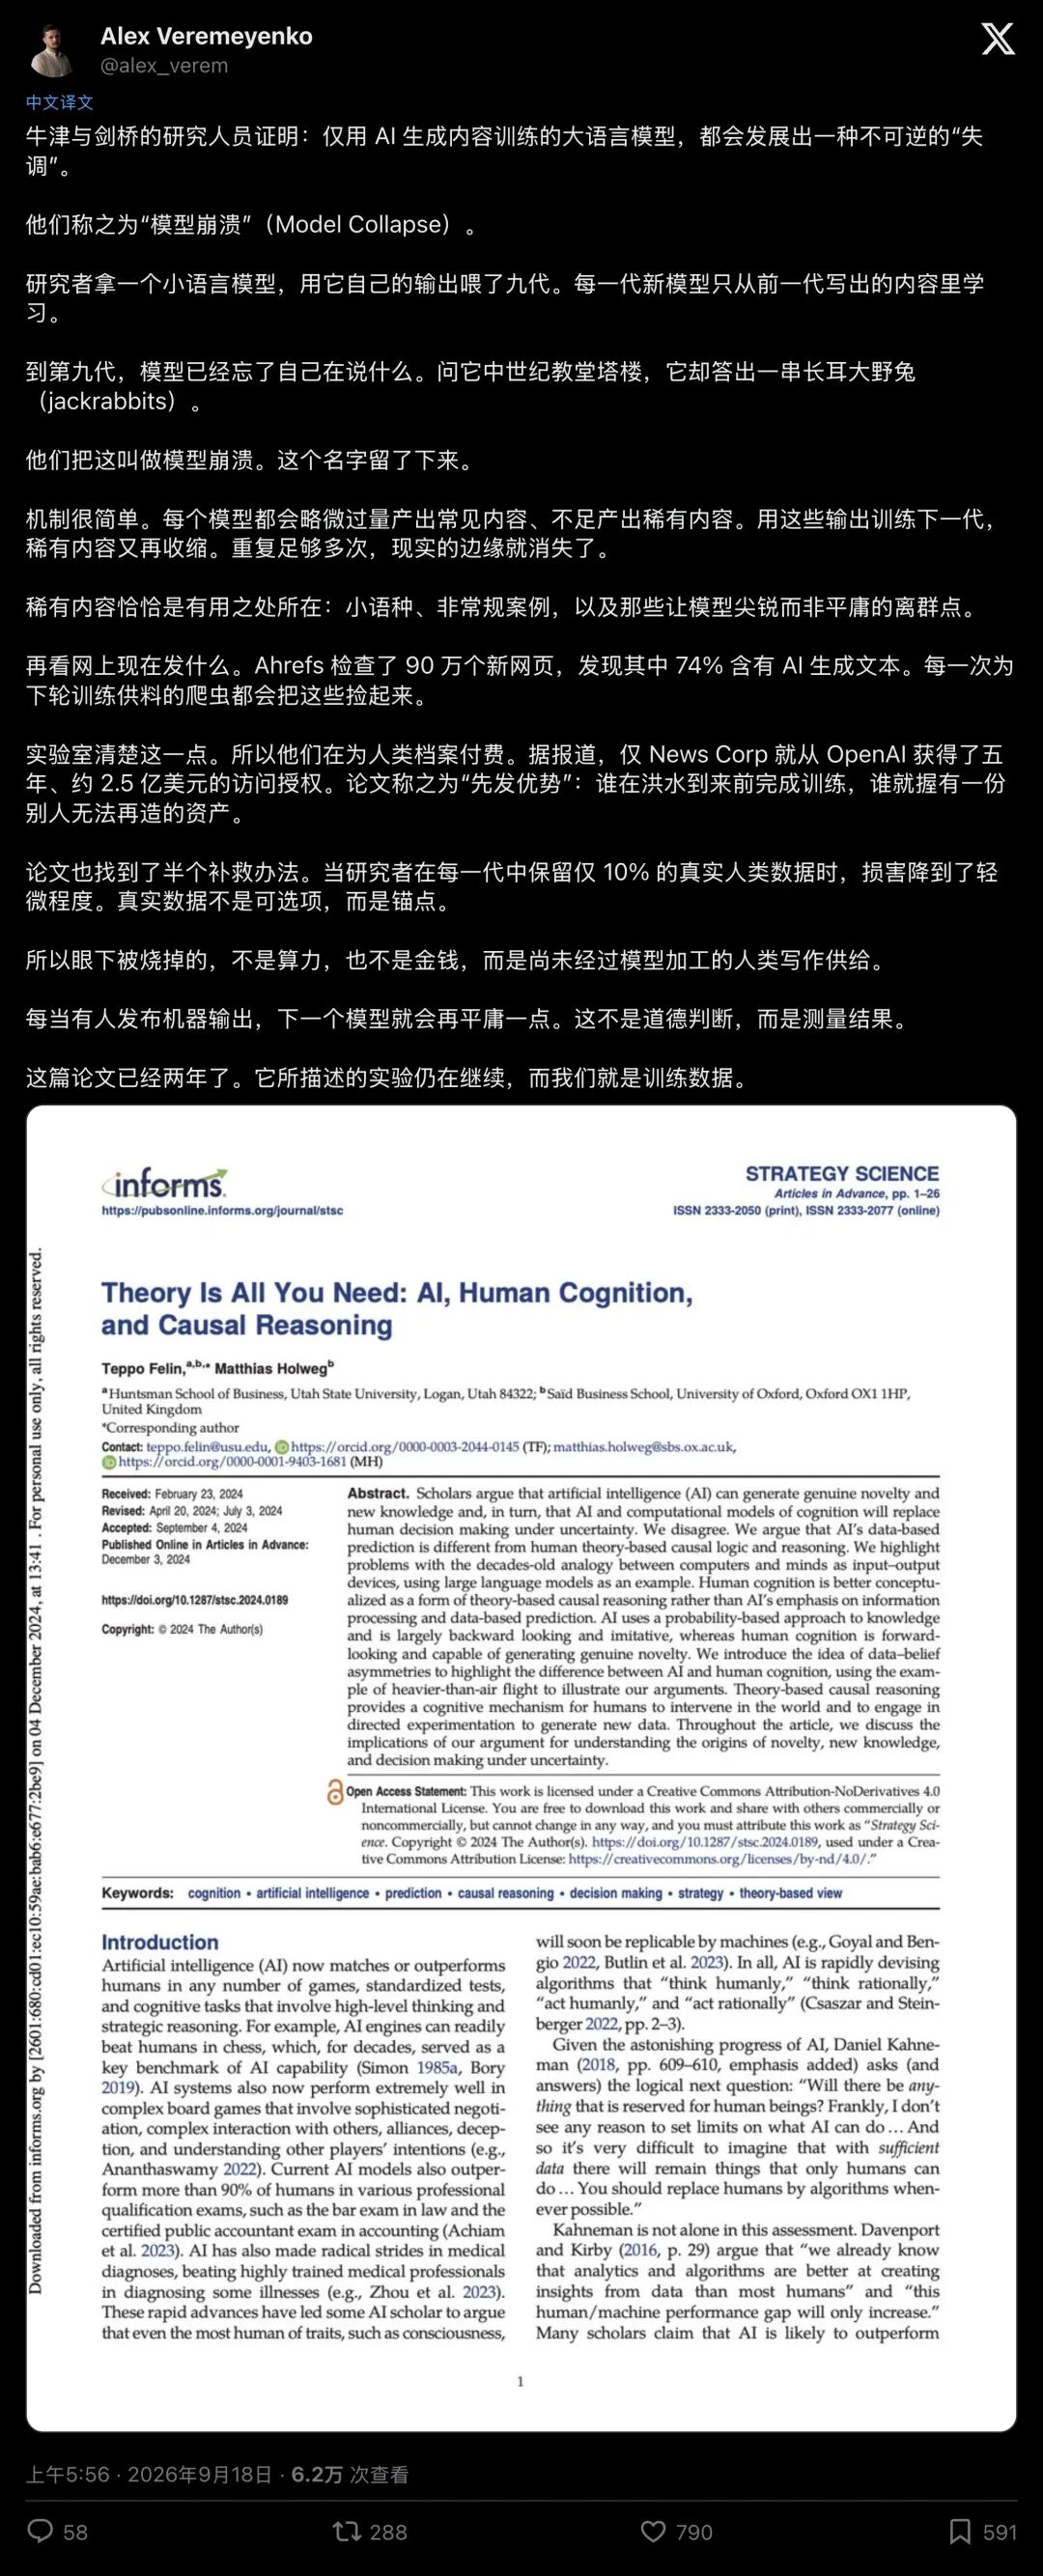
▲ 社交网络上广泛传播的模型崩溃警示图:9代递归后,现实的边缘正在蒸发
01九代近亲繁殖,AI如何一步步“精神分裂”
这项轰动学术界的研究,由牛津大学、剑桥大学、帝国理工学院及多伦多大学等顶级科研团队联手完成,论文正式发表在 2024 年 7 月的《自然》(Nature)正刊上。
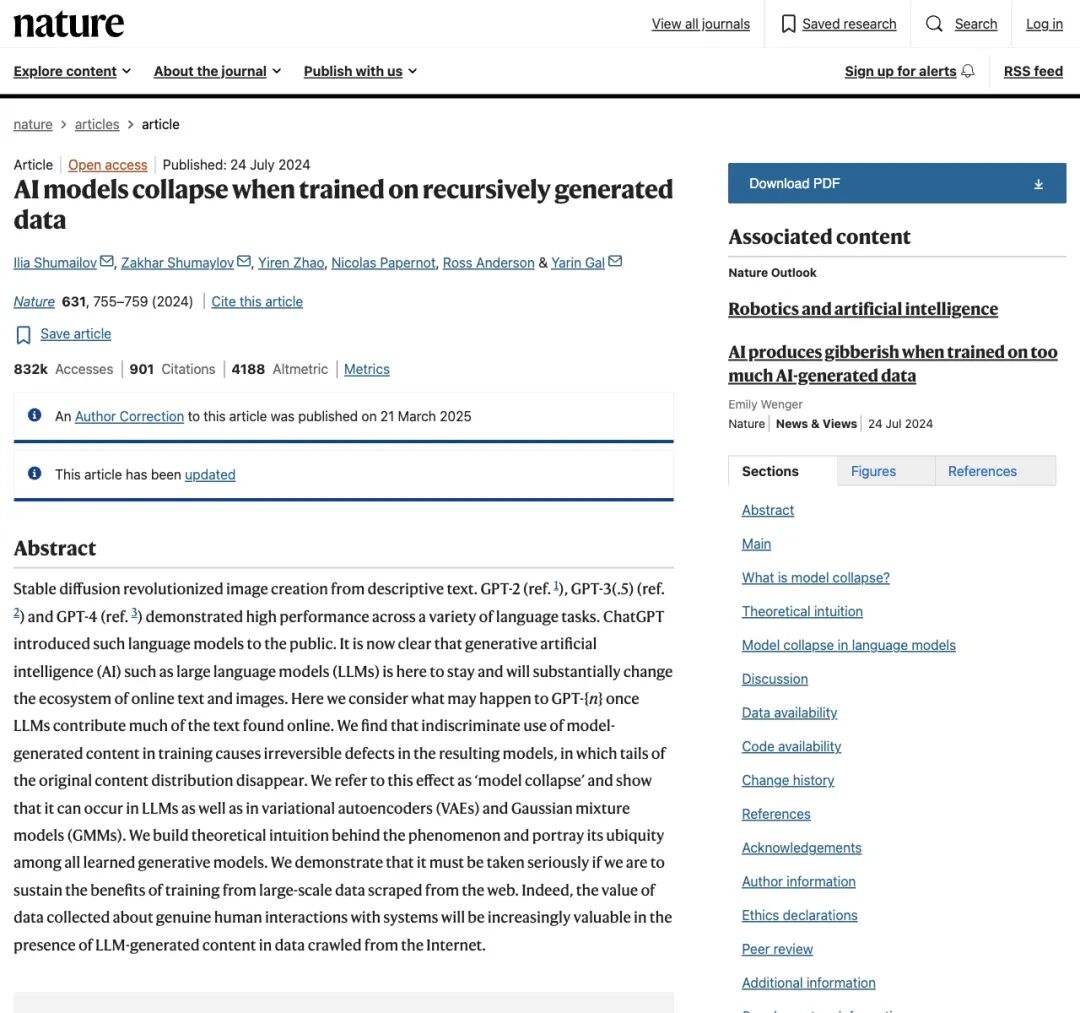
▲ 发表于 Nature 的重磅论文:递归训练导致 AI 模型崩溃
科学家们给这种退化现象命名为:“模型崩溃”(Model Collapse)。
什么叫模型崩溃?简单来说,就是上一代模型生成的合成数据污染了下一代的训练集,被污染数据训练出来的后代,会逐渐“误认现实”。
为了看清崩溃的过程,研究人员用 Meta 开源的 OPT-125m 语言模型做了一场残酷的“近亲繁殖”实验:
- 第 0 代(初代)
:用纯正、干净的人类真实维基百科数据(wikitext2)进行微调训练,回答精准流畅,建筑史、历史脉络清清楚楚; - 第 2 到第 5 代
:模型不再接触人类数据,只吃上一代模型生成的文本。此时模型依然看似流畅,但细节开始模糊,罕见词汇逐渐绝迹; - 第 7 代
:语义逻辑开始错乱,模型把不同领域的词汇机械拼凑; - 第 9 代
:彻底疯癫。不管你问它什么,它都开始疯狂复读那些毫无逻辑的“彩色尾巴大野兔”。
你可以把这个过程想象成一台复印机去复印一张照片:第一张复印件还算清晰;拿着第一张复印件去印第二张,细微的纹理开始丢失;印到第十次,整张纸上只剩下一团模糊发黑的噪点与轮廓。
研究团队指出,模型崩溃并非语言模型专属现象。在高斯混合模型(GMM)和图像生成自编码器(VAE)中,一旦断绝真实数据供给,类似的退化同样不可避免。
02为什么最先死掉的,永远是“人类的灵光”?
为什么 AI 自我喂养,不会越来越聪明,反而会变傻?
牛津与剑桥团队将这种退化拆解为两个阶段:早期模型崩溃(Early Model Collapse) 与 晚期模型崩溃(Late Model Collapse)。
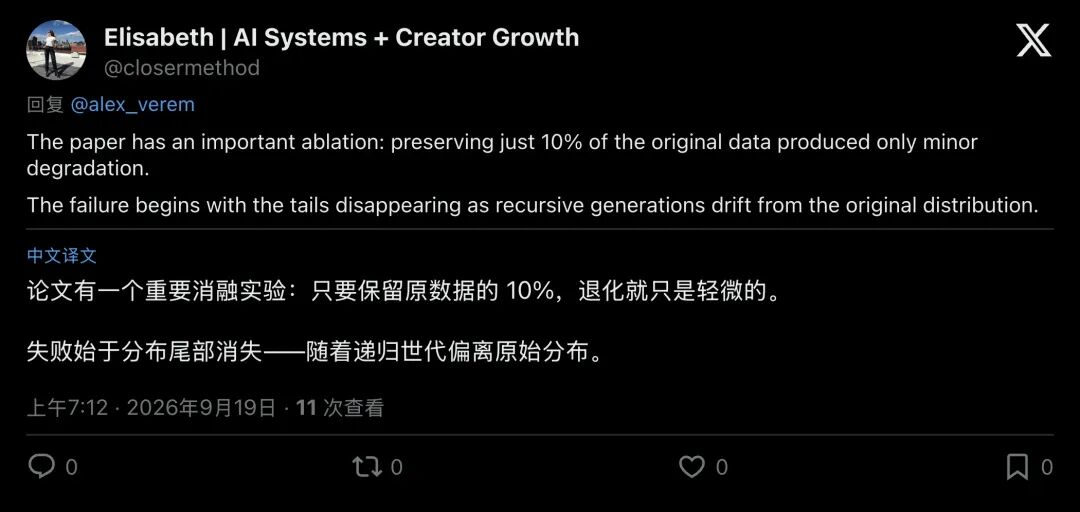
▲ 讨论区热议:模型崩溃最致命的一步,是从数据分布的“尾部”消失开始的
决定早期崩溃命运的,是数学上的统计抽样误差。
真实世界的数据分布中,日常寒暄、通用语法与大众常识占据了绝大部分;赋予大模型专业深度与创造力的,往往是那些位于概率分布“尾部”(Tail)的低频信息:
极其罕见的小语种; 医疗诊断中的罕见病病例; 精妙绝伦的冷门文学隐喻; 资深程序员调试 Bug 时写下的非典型边缘代码。
当第一代模型生成文本时,由于有限样本抽样的天然缺陷,它会不可避免地稍微多生成一点常见的大众内容,少生成一点冷门的罕见内容。
第二代模型拿着这批数据去训练,就会天真地认为:“原来那些冷门东西在世界上根本不存在!”于是它进一步压缩尾部空间。
代际递归之下,现实的边缘被一层层削平。
在纽约大学与 Meta FAIR 后续发表于 ICML 2024 的理论推导中,科学家从高维回归与矩阵谱分析的角度给出了严格证明:真实世界特征协方差矩阵的特征值呈现幂律衰减 $\lambda_i \sim i^{-\alpha}$。在递归生成时,低方差的长尾特征基向量会被抽样误差彻底抹杀,高频特征的估计系数呈几何级数向零坠落。
最先死掉的,恰恰是人类文明中最珍贵、最富有灵光的那部分。
早期崩溃发生时,模型看起来甚至毫无破绽,它依然语法通顺、对答如流,但它已经沦为一个极度平庸、千篇一律、再也吐不出半点新鲜见解的“废话复读机”。到了晚期,分布方差彻底归零,模型便彻底滑向野兔狂欢式的精神分裂。
03现实正变成“近亲繁殖”的数字死海
如果这只局限于实验室,那不过是一场有趣的学术猎奇。但可怕之处在于:这个实验正在全互联网真实上演,而我们全人类就是不知情的试验品。
看看今天我们身处的网络环境吧
SEO 监测巨头 Ahrefs 曾发布过一份对 90 万个全新英文网页的深度调查报告(Study of 900k Pages)。结果令人触目惊心:
高达 74.2% 的新发布网页中,包含可检测出的 AI 生成内容! 其中完全由人类手写的页面,仅仅剩下 25.8%。
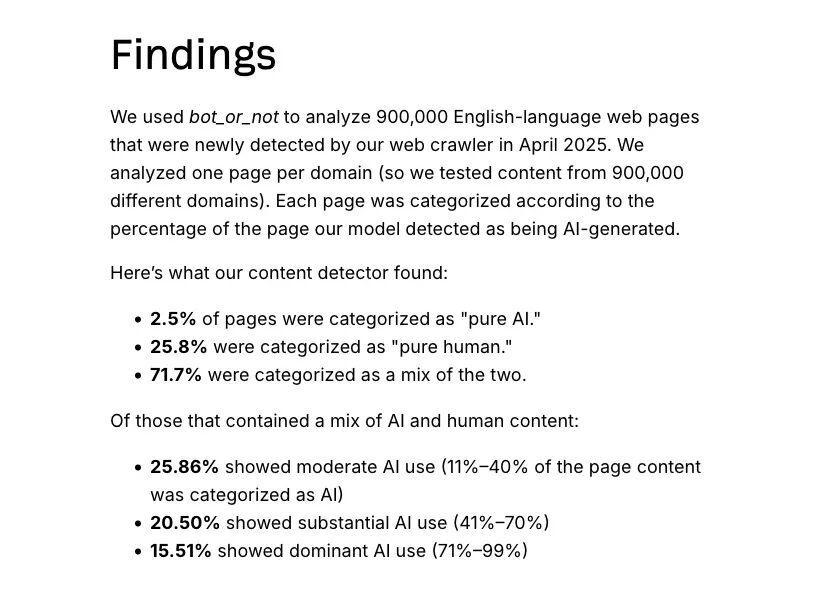
▲ Ahrefs 调查:互联网新增网页中,纯人类创作仅剩 25.8%,超七成包含 AI 内容
便宜、量大、毫无灵魂的 AI 垃圾文章,正像水葫芦一样霸占整个互联网的河道。
而下一代大模型的网络爬虫,每天都在不加甄别地从这个巨大的“AI 生成池”中抽取养料。上一代 GPT 吐出的文字,转头就成了下一代 Claude、Llama 乃至 GPT-5 的午餐。
各大 AI 巨头心知肚明,一场关于“纯净人类数据”的生死争夺战早已打响。
这就是为什么论文作者提出了一个商业洞察:“先发优势”(First Mover Advantage)。那些在 2022 年 AI 大爆发之前、在互联网被合成数据彻底污染之前完成爬取并拥有纯净人类语料库的公司,握有着后来者永远无法重新复制的数字资产。
据媒体广泛报道,OpenAI 不惜砸下超过 2.5 亿美元 的巨额资金,与拥有《华尔街日报》等媒体品牌的默多克新闻集团(News Corp)签下长达五年的内容授权协议。
这笔巨资所采购的核心资产,正是记者亲历现场记录、未经模型二次加工的原生文字。
在硅谷,算力和电力可以用钱买到,但未经污染的人类思想,正在成为这个星球上最昂贵、最稀缺的硬通货。
04斯坦福硬核反击:大模型的末日,被夸大了?
随着这篇两年前的《自然》论文在 2026 年再次病毒式翻红,不少自媒体开始耸人听闻地宣称“AI 的末日已至”、“ChatGPT 即将完蛋”。
但科学界很快给出了理性、冷峻的纠偏。
印尼技术观察者 @AryHHAry 在 X 上直言不讳地指出:“模型崩溃确实存在,但很多网络帖子把 2024 年的论文解读成了 ChatGPT 的世界末日。”
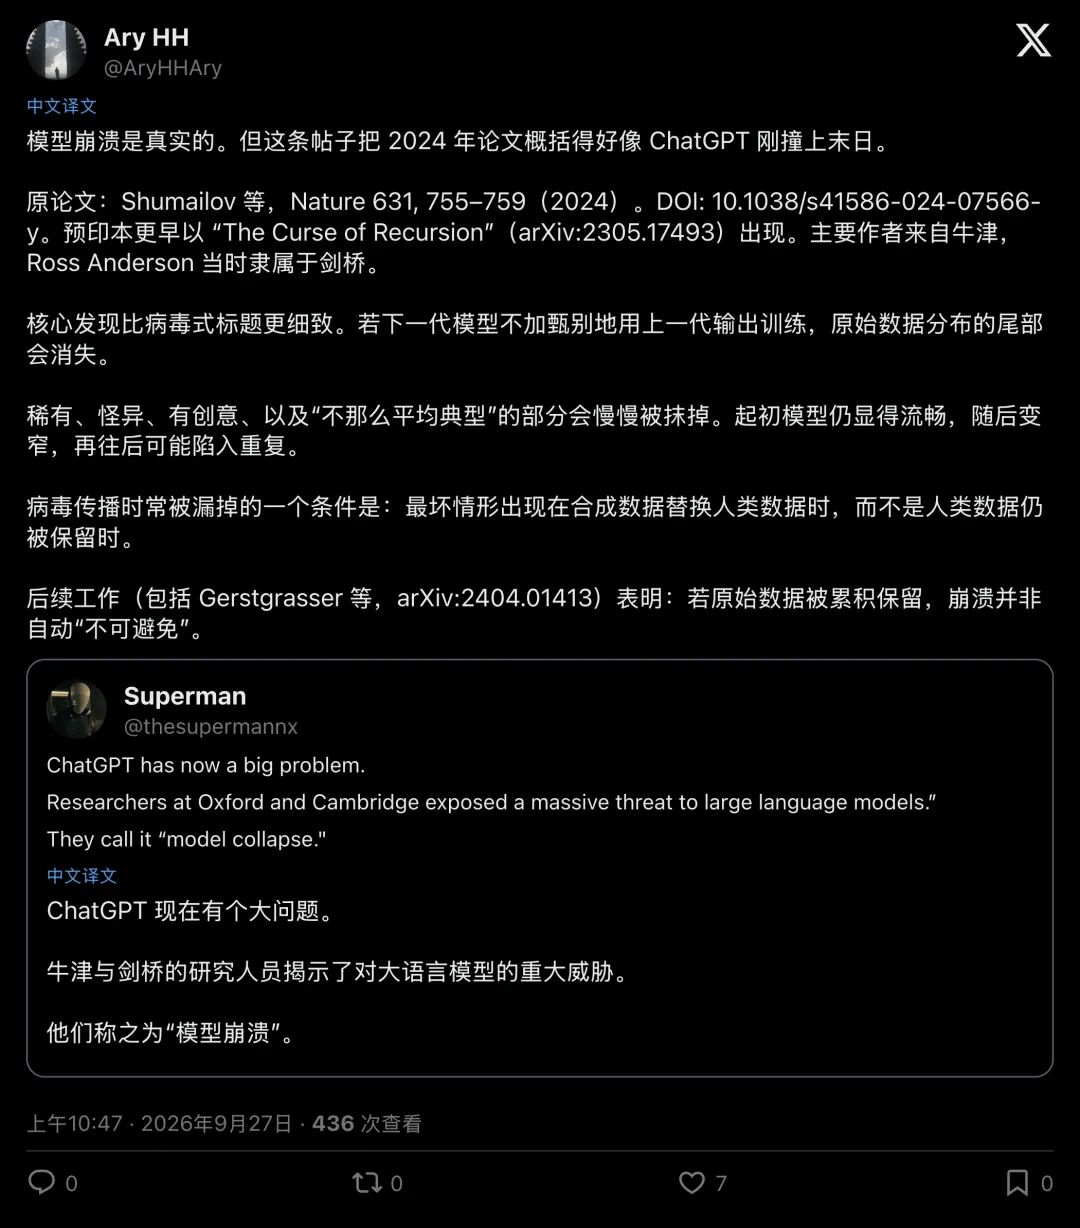
▲ 学术界与理性声音指出:病毒帖夸大了毁灭论,忽略了论文的前置条件
论文原作者团队在实验中其实早就留下了一个至关重要的解药:只要在每一代训练时,保留哪怕仅仅 10% 的原始人类真实数据,模型的退化就会瞬间被极大地抑制,整体性能只会出现微弱波动。
更具决定性突破的,是斯坦福大学 Matthias Gerstgrasser 团队在论文《Is Model Collapse Inevitable?》中给出的严格数学证明。
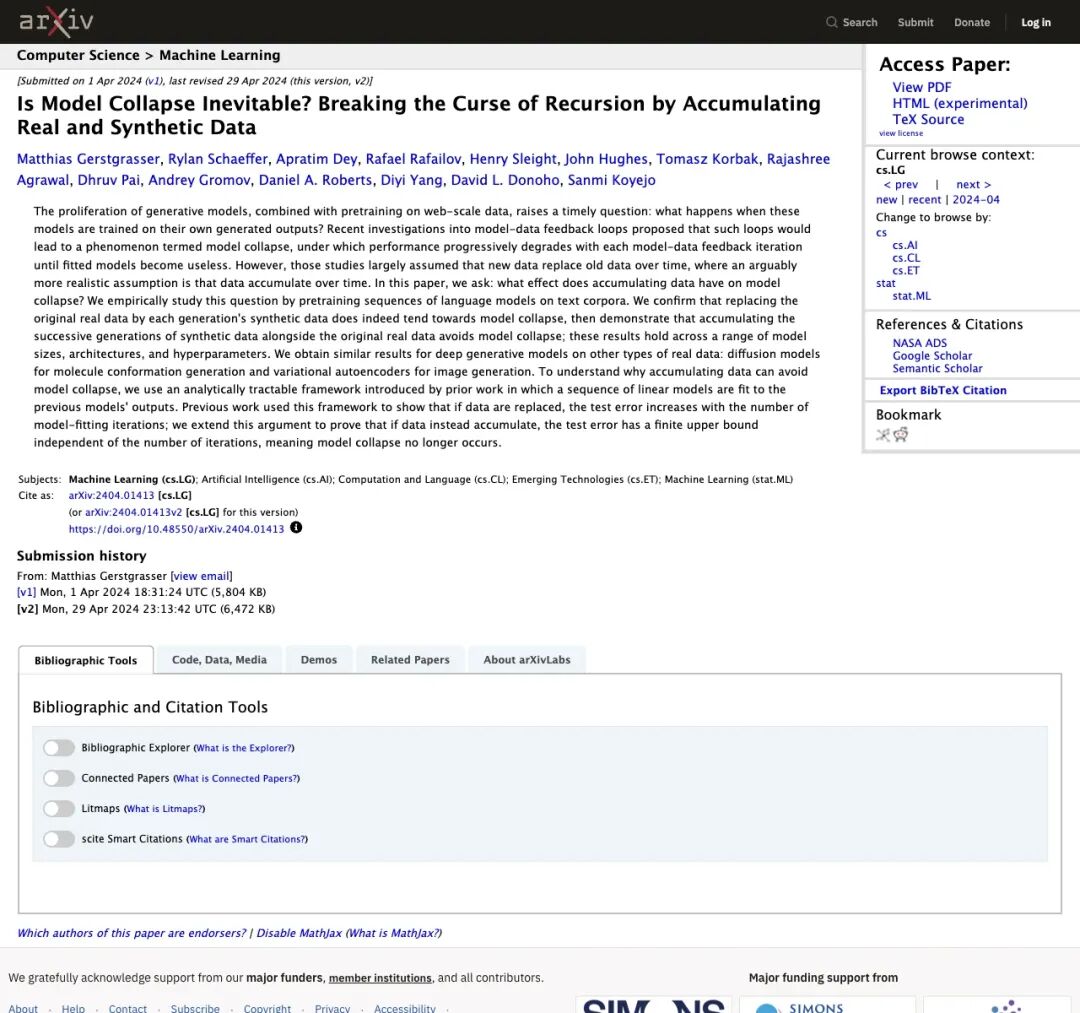
▲ 斯坦福研究:通过累积真实与合成数据,彻底打破递归诅咒
斯坦福团队精准指出了“毁灭论”的漏洞,它混淆了两种完全不同的训练范式:
- 替换范式(Replace)
:当前模型只吃上一代产出的数据,旧的人类数据被无情丢弃。这是牛津剑桥实验里引发野兔疯癫的极端场景; - 累积范式(Accumulate)
:新生成的合成数据不断进入训练池,但最初的真实人类数据集永远被完整保留在底座中。
斯坦福团队用严密的泛函分析证明了有限上界收敛定理:在数据累积范式下,无论代际递归迭代多少次($t \to \infty$),模型的泛化测试误差严格存在一个与代数无关的有限常数上界 $C$:
$$\lim_{t \to \infty} \text{Error}(t) \le C < \infty$$
这一结论证实,只要留存人类原始数据,大模型便能摆脱崩溃的宿命。 沉淀在底座的人类语料如同重力锚点,即便上方涌现大量合成数据,也能稳固模型的表征分布。
05人类的文字,是数字宇宙最后的“抗熵之锚”
这场关于“模型崩溃”的学术与产业大论战,最终留给全人类一个无比深刻、甚至极具哲学意味的启示。
在过去几年里,技术狂热的论调甚嚣尘上,认为人类创作太慢太低效、AI 生成的内容终将全盘接管。
然而,“模型崩溃”的数学规律无情地给狂热的技术乐观主义浇了一盆冷水:如果人类停止表达、停止记录、停止探索未知的边缘,AI 的智能之火也会迅速窒息在自己的排泄物中。
大模型强大的泛化能力,本质上是对人类已有知识宇宙的压缩与插值。它是一面镜子,但镜子本身不会发光如果镜子只能对着另一面镜子无限反射,最终呈现的只会是无意义的光学噪点与空洞虚无。
人类在生活中的真实经历、复杂情感、小众灵感与偶然偏差,绝非等待算法平滑抹去的无效噪音。
那是真实世界在这个冰冷数字系统里,留下的唯一抗熵之锚。
下一次,当你在键盘上敲下一段看似小众、古怪、未被任何模板定义过的真实感受时,请记住:你不仅仅是在表达自己,你还在为这个即将被 AI 垃圾淹没的互联网,注入一滴维持理智的纯净氧气。