ARTICLE · 1112130
谷歌撕碎AI程序员神话!最强模型大考惨败:GPT-6仅拿28分,自研旗舰跌至8%
过去两年,硅谷的大佬们几乎每天都在耳边轰炸同一个预言:“程序员要绝种了。”
在各大厂商精心编排的发布会上,大模型写起代码来神采飞扬,几秒钟手搓一个小游戏,轻轻松松修掉一段报错,在各大测试集上随随便便轰出90%以上的高分。无数人甚至开始倒数软件工程师这一职业的寿命。
然而,就在所有人都以为“AI取代人类”进入倒计时的时候,谷歌Android官方团队突然掏出一把冷酷的尖刀,狠狠刺破了这场集体的狂欢。
2026年9月中旬,谷歌正式上线了Android Bench 2.0。这是一场把顶尖AI直接置于工业级真实场景下的深度工程压力测试,彻底告别了过去做单点选择题式的轻量考核。
测试结果一公布,整个硅谷科技圈瞬间鸦雀无声:
在这场面向真实工程的残酷考核中,地表最强模型全线溃败。位列全球第一的OpenAI王牌模型GPT-6 Astra,通过率仅仅只有可怜的28%;而谷歌自家的主力旗舰Gemini 3.8 Flash,更是惨跌到令人难以置信的约8%!
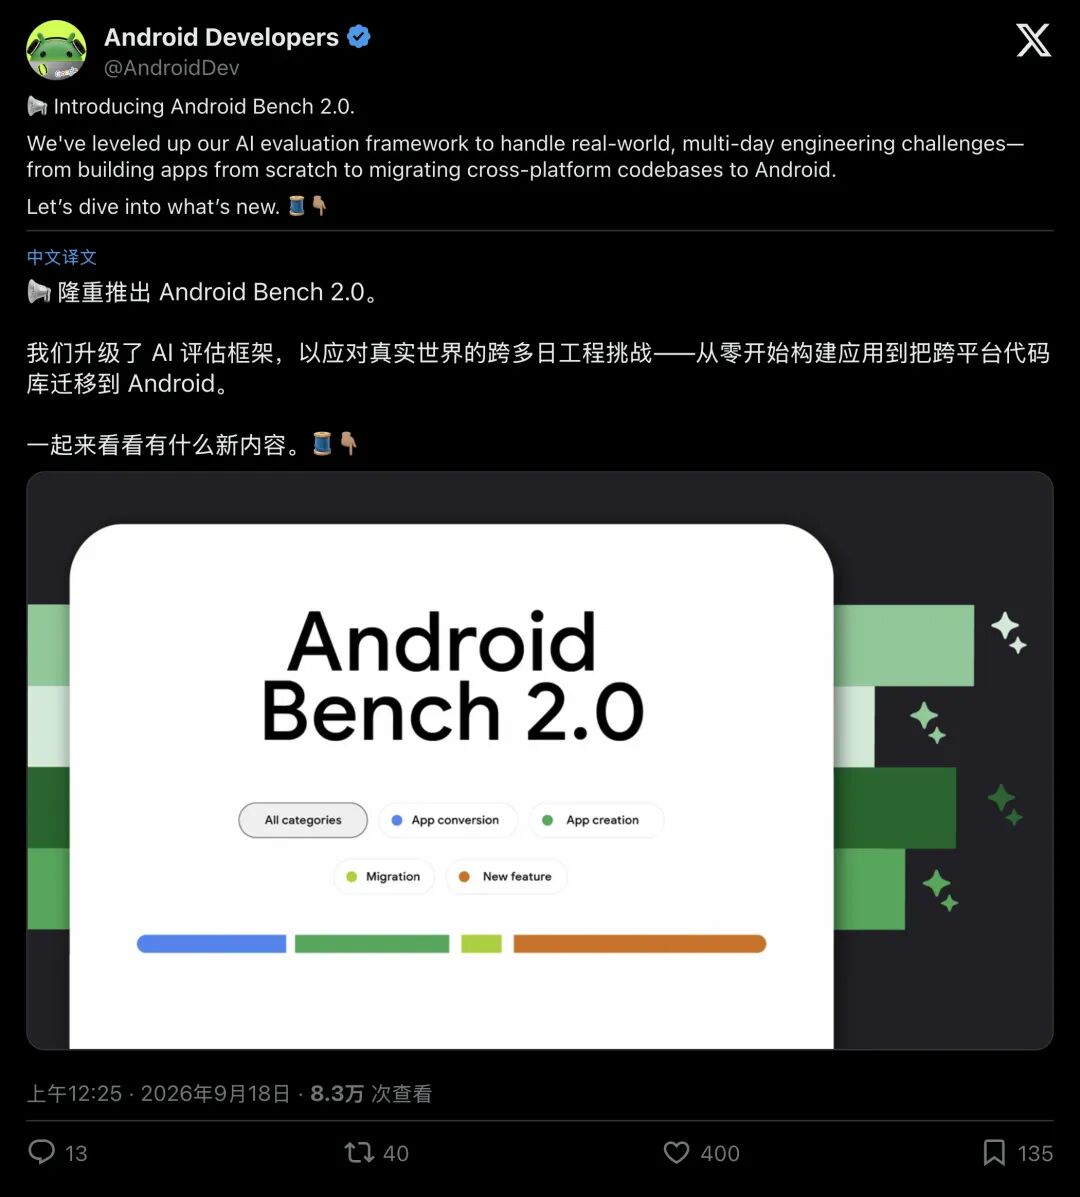
▲ Android Developers 官方正式宣布上线 Android Bench 2.0
曾经在榜单上横扫90%分数的“AI天才”,为什么一进复杂严苛的工程车间,就瞬间被打成了“不及格的实习生”?
这场被称为“硅谷清醒剂”的基准大考,到底测出了大模型怎样致命的软肋?
01.撕掉滤镜:以前考的是修水龙头,这次考的是建摩天大楼
想要看懂这次AI的集体惨败,我们必须先搞清楚:谷歌这次到底换了一把怎样变态的尺子?
在过去的Android Bench 1.0时代,AI面对的题目极其简单。任务大多是“修改一两处代码”、“在一个文件里修复一个局部小Bug”。平均改动量不过几十行代码,模型只要单次输入一段提示词(Prompt),凭借庞大的记忆库就能轻松猜对。
那不叫软件工程,那叫“做课后练习题”
但现实中的软件开发是怎样的?
任何一个干过Android开发的工程师都知道,真实的世界充满了“恶心”的细节:你要把一个几千行旧架构的代码库迁移到全新框架,你要让代码在安卓模拟器里不仅能跑通、UI界面还得像素级还原,你还要处理混乱的生命周期、后台数据同步和复杂的依赖注入。
这种活儿,一个资深人类工程师通常要坐下来,不眠不休地死磕数天甚至整整一周。
▲ 谷歌官方博客:Android Bench 2.0 聚焦长周期工程挑战
于是,Android Bench 2.0彻底掀翻了桌子。谷歌官方团队推出了30个长周期任务(Long-Horizon Tasks,简称LHT),分成了四大残酷赛道:
- 从零构建应用(9题)
:只给几张设计图,AI必须从零写出一款名为“Food Vibes”的多页面外卖App,代码规模高达1200到5500行,涉及几十个文件协同; - 大型架构迁移(13题)
:把真实生产环境的代码全部换血(比如从RxJava迁移到协程,从Retrofit换到Ktor),动辄修改近300个文件、跨越8000多行代码; - 平台级新功能(6题)
:在已有复杂项目中,硬生生接入画中画、Wear OS手表数据同步、CameraX相机等底层能力; - 跨平台应用终极转换(2题)
:把现成的Flutter或React Native项目,完完全全重构成原生Jetpack Compose代码。
为了防止AI“背题偷看答案”,谷歌全部使用了私有的全新代码库,题目在互联网上没有半点痕迹。
在评分机制上,谷歌彻底颠覆了传统的单元测试规则。他们直接启动了硬件虚拟化的安卓模拟器,甚至派出多模态模型担任“视觉考官”,拿着放大镜严格核验UI渲染质感、页面跳转逻辑与数据库防作弊指标。
考场里彻底告别了选择题,AI必须把拆散的汽车零部件,当场组装成一辆能在路上平稳疾驰的整车。
02.惨烈战报:写新代码像模像样,一碰“屎山代码”立马崩溃
在这场没有预演的实弹演习中,所有大模型的遮羞布被扯得干干净净。
从官方公布的榜单数据来看,各大阵营无一幸免:
- OpenAI阵营
:旗舰模型GPT-6 Astra凭借28%的通过率艰难夺冠; - Anthropic阵营
:Claude Fable 5.1紧随其后,同样被困在低分泥潭; - 谷歌自研阵营
:被寄予厚望的Gemini 3.8 Flash,通过率直接跌到约8%; 至于其他参与测试的主流前沿模型,在这一套长周期工程任务面前,也无一例外遭遇了严酷考验。
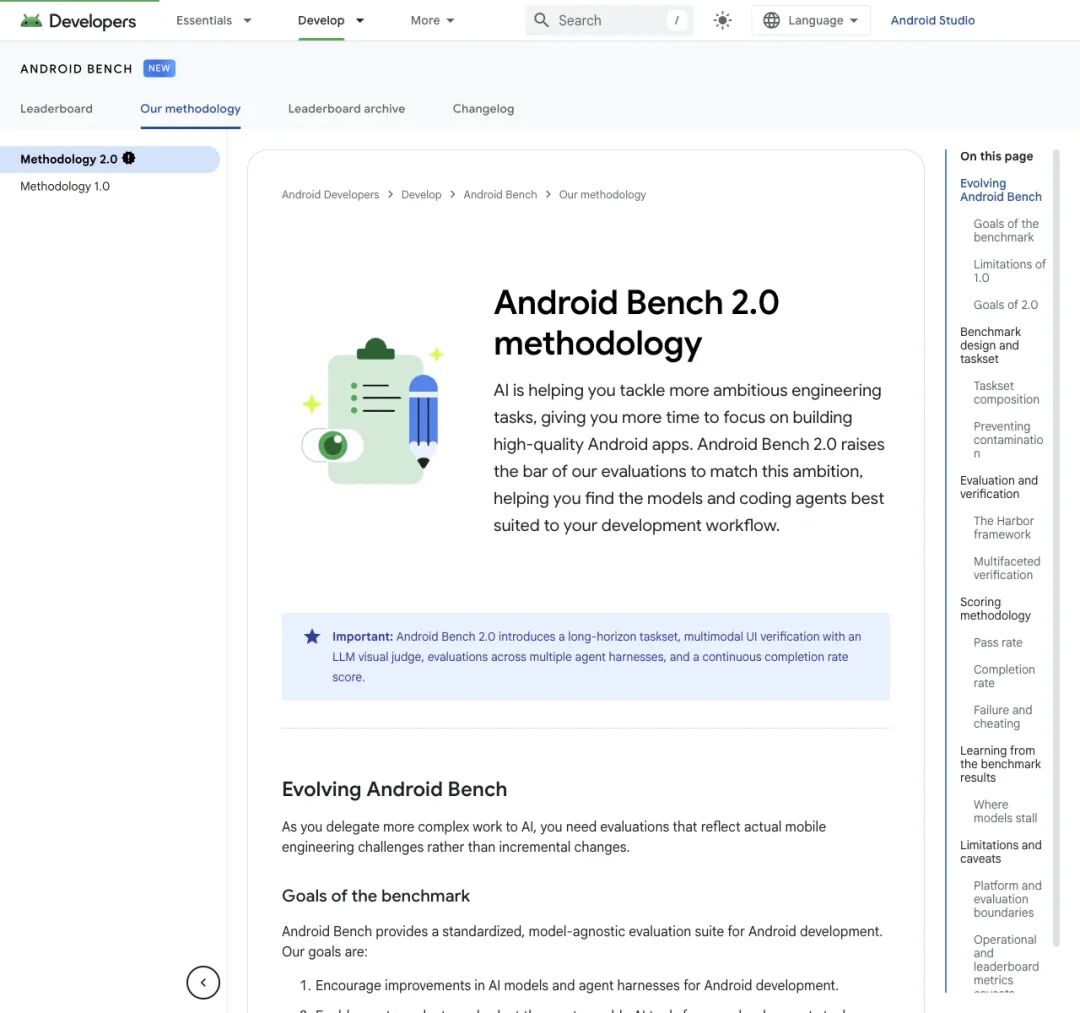
▲ 官方方法论页面:全方位提高了工程评测的标准
翻开具体的测试细节,AI的能力画像展现出极其鲜明的断层:
1. 擅长“平地起高楼”,极度恐惧“给老房子换地基”
测试发现,AI在从零编写一个全新独立模块时,表现相当亮眼。但只要面对已有的大型代码库,要求它重构老旧架构时,AI的智商就呈现断崖式下跌。
因为新写代码只需要逻辑自洽,而重构老代码需要理解庞大系统里的暗病、隐式依赖与历史包袱。AI面对成百上千个互相牵扯的文件,根本无法建立起全局的系统观。
2. 跨平台移植成为“全军覆没”的死亡之组
在把Flutter和React Native项目完整移植为Android原生代码的任务中,全场没有任何一个模型能够完美通过(通过率为0%)! 哪怕是表现最好的前沿模型,最终的完成度也死死卡在80%的瓶颈上。
这说明,一旦涉及跨技术栈的深层抽象转换,AI现有的推理深度瞬间就会见底。
03.穿透本质:为什么只要超过100步,AI就会“发疯”?
为什么在单个Prompt下能吟诗作赋、秒写算法的AI,到了多日工程任务里,会退化成这样?
这次Android Bench 2.0不仅仅测试了裸模型,更引入了智能体运行环境(Agent Harness)的深度评测。通过观察Codex、Claude Code、Google Antigravity SDK在运行中的几千条执行轨迹,谷歌工程师终于抓到了AI在工程实践中的致命认知缺陷。
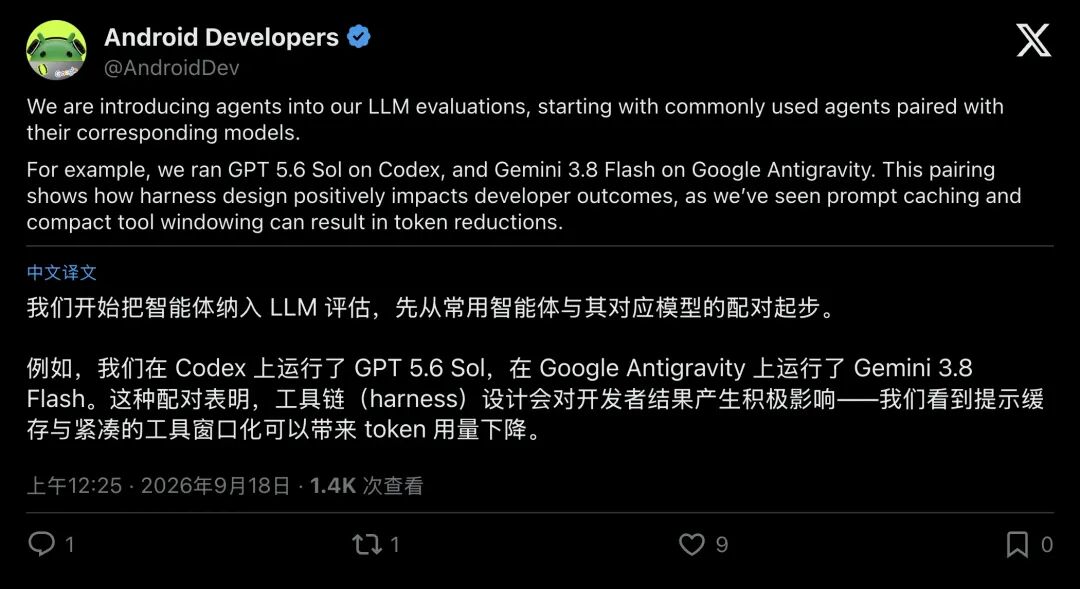
▲ 官方指出:智能体工具链与 Harness 设计对开发者最终结果起到了决定性作用
致命陷阱一:执行超过100步后的“推理疲态”与局部死循环
在软件工程中,AI通常扮演一个自主执行的智能体:读文件、改代码、运行编译、看报错、再修改。
数据显示,在任务的前90步,AI就像一个天才少年,能够以惊人的速度生成几十个文件,完成80%的主干功能。但随着任务深入,执行步数一旦突破100步,灾难发生了。
随着上下文里堆满了密密麻麻的调试历史、报错信息和失败尝试,模型开始出现严重的“注意力涣散”。它会突然陷入局部死循环(Model Looping),比如遇到一个依赖注入图的错误,AI会在两个毫无关联的文件之间,来来回回修改同一个分号,或者反复添加无意义的注解,连续几十步在原地打转,直到把Token和时间全部耗尽。
致命陷阱二:只会一条道走到黑,缺乏“Git Reset”的全局勇气
人类高级工程师与AI最大的区别是什么?是认错和推倒重来的能力
当一个老架构师发现当前的重构方案走入了死胡同,他会果断执行一次 git reset,回滚代码,点上一支烟,重新审视顶层设计。
但今天的编程智能体,本质上是“单向追加(Append-only)”的思维模式。它们根本没有分支回滚的元认知监控能力。前面挖了一个坑,它就在坑里继续叠代码,试图用一个错误去掩盖另一个错误,最终让整个代码库彻底崩盘。
致命陷阱三:被海量编译日志活活“噎死”
在Android开发中,随便敲一行 ./gradlew assembleDebug,控制台打印出的依赖树、编译警告和日志动辄就有几万行。
普通的AI如果未经处理直接把这几万行日志吞进上下文,窗口瞬间就会被撑爆,瞬间引发“灾难性遗忘”。
只有配备了紧凑工具窗口化(Compact Tool Windowing)和提示词缓存(Prompt Caching)的高级智能体系统,利用沙箱过滤器实时把几万行废话过滤掉、只给模型看核心报错堆栈,才能勉强维持住模型的神智。
这也指明了一个核心事实:决定AI工程能力的关键,除了底座模型本身的推理水平,包裹在它外面的那套工程工具链(Harness)同样起到了决定性作用。
04.撕开皇帝的新衣:社区热议,AI的真实定位到底是什么?
测试报告一出,全球开发者社区一片沸腾。
有人戏谑,也有人拍手称快知名科技博主直接发帖嘲讽:“那些整天叫嚣‘超人程序员’的人现在在哪呢?最高分28分,这就是你们吹上天的全自动软件工程?”
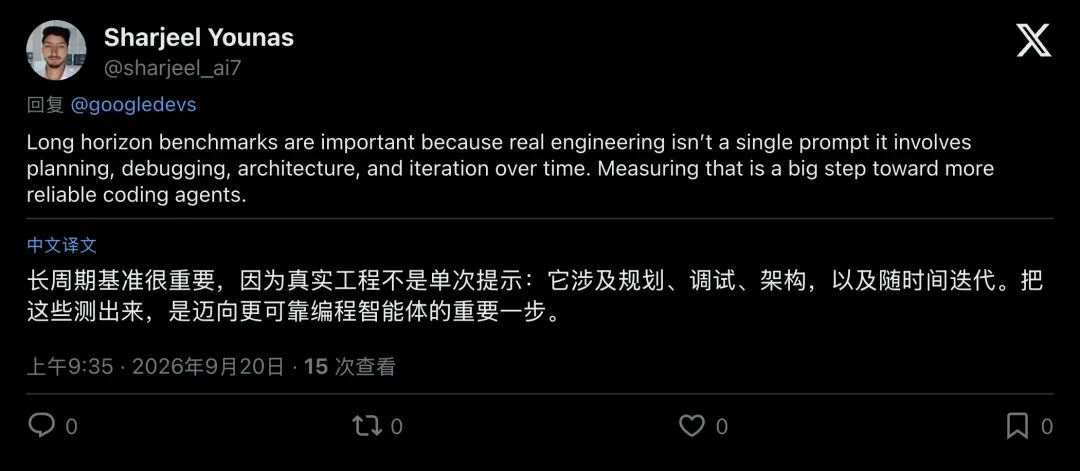
▲ 开发者热议:真实的工程需要持续规划、深度调试与长期迭代
但更多一线工程人员感受到的,是一种理性的释怀。
开发者Sharjeel Younas评价道:“真实的软件工程远超单次Prompt交互,它涵盖长期的架构规划、复杂的调试、生命周期权衡以及持续迭代。能够衡量这些长周期能力,是迈向可靠AI编程的关键一步。”
中文开发者社区同样反响热烈许多工程师感叹,过去那些动辄99%分数的测试集,其实是在给管理层和资本市场“画大饼”,误导了行业判断,也给一线开发人员带来了虚妄的焦虑。
这次Android Bench 2.0给出的低分成绩,标志着整个行业正走向成熟与务实。它就像给狂热发烧的AI编程赛道浇下了一盆及时的冷水,把大家从“AI即将全面替代人类”的科幻幻想,拉回到工程落地的现实地面。
05.别指望全能架构师,但你可以拥有一个不知疲倦的实习生
那么,28%的分数,是否意味着AI编程工具彻底没用了?
恰恰相反
如果你认真研读谷歌的方法论,你会发现这次评测引入了一个极具价值的维度:连续完成度评分(Completion Rate)。
虽然完美通过率(Pass Rate)只有28%,但在很多复杂迁移任务中,前沿模型的完成度往往达到70%到80%。这表明AI已经能够搭好繁重机械的底层骨架,转换完成数百个文件的样板代码。
它只是无法独立走完那决定成败的最后20%。
这给所有技术团队指明了一条无比清晰的协作路径:
在未来的很长一段时间里,AI绝不可能成为掌控大局的“主任架构师”。但只要你懂得如何设计工具链、如何进行上下文管理、如何在关键节点进行架构纠偏,它就是人类历史上效率最高、不知疲倦的“超级实习生”。
神话已经破灭,但属于真实工程师的时代,才刚刚开始。