ARTICLE · 1112134
从哥特教堂到满屏野兔!Nature揭开AI自噬绝症:9代近亲繁殖彻底脑死亡
如果你给一台当今最先进的AI输入一段关于中世纪教堂建筑的专业考题,它能头头是道地跟你聊石匠工艺和哥特风格。
但如果让它把自己的回答当成教材,一代代教给下一代AI,会发生什么?
第1代,它还在认真探讨建筑史;第5代,它开始语无伦次,前言不搭后语;到了第9代,屏幕上只剩下一行令人毛骨悚然的胡话:
“……这是世界上最大规模的黑尾、白尾、蓝尾、红尾、黄尾长耳大野兔(jackrabbits)种群……”
从庄严的哥特式教堂,到满屏幕基因突变般的“彩色野兔”,中间只隔了9代。
如此荒诞的代际退化,真实记录在牛津大学与剑桥大学科研团队刊登于顶级期刊《自然》(Nature)的重磅研究中。
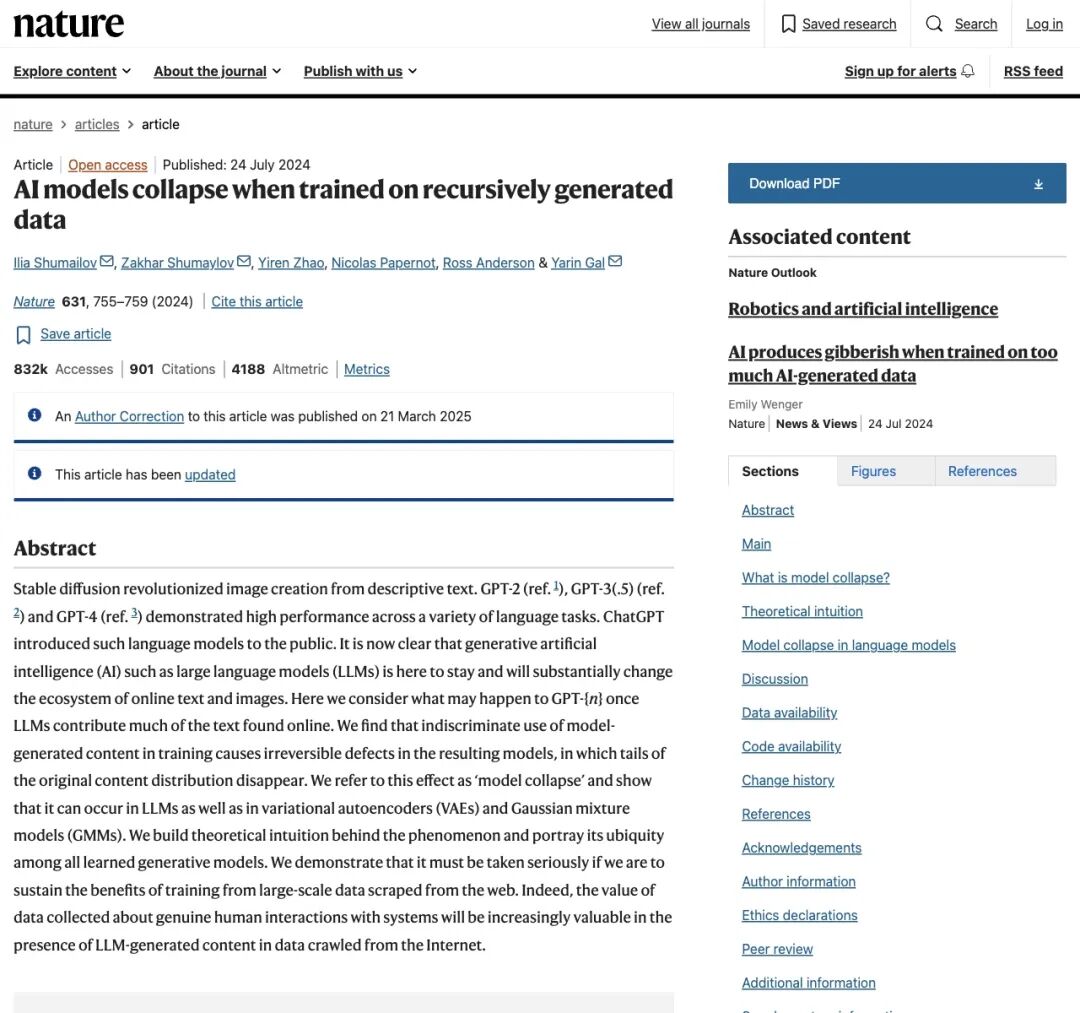
▲ 2024年7月发表于《Nature》的正刊论文,揭示了AI递归训练的致命缺陷
科学家们给这个现象定了一个冰冷的名字:模型崩溃(Model Collapse)。
这种“数字绝症”不仅席卷了文本领域,同样在图像、视频等整个多模态世界里蔓延。它还有一个更为惊悚的医学隐喻:模型自噬障碍(MAD,Model Autophagy Disorder),俗称AI界的“疯牛病”。
当整个互联网被海量廉价的AI内容淹没,人类正在亲手把AI推向一场不可逆的代际脑死亡。
01致命的“近亲繁殖”:AI是如何一步步精神失常的?
要理解这场灾难的成因,必须回归大模型的底层运作机制。
大模型本质上是一个极其复杂的高维概率压缩机。它读遍全人类写过的内容,计算出“哪个词接在哪个词后面概率最大”。
如果它学习的是人类真实世界的数据,它学到的是现实的丰富与参差。但如果它吃下的是上一代AI吐出来的合成数据(Synthetic Data),悲剧就发生了。
牛津与剑桥的科学家把这个过程精准地拆解为两个阶段:
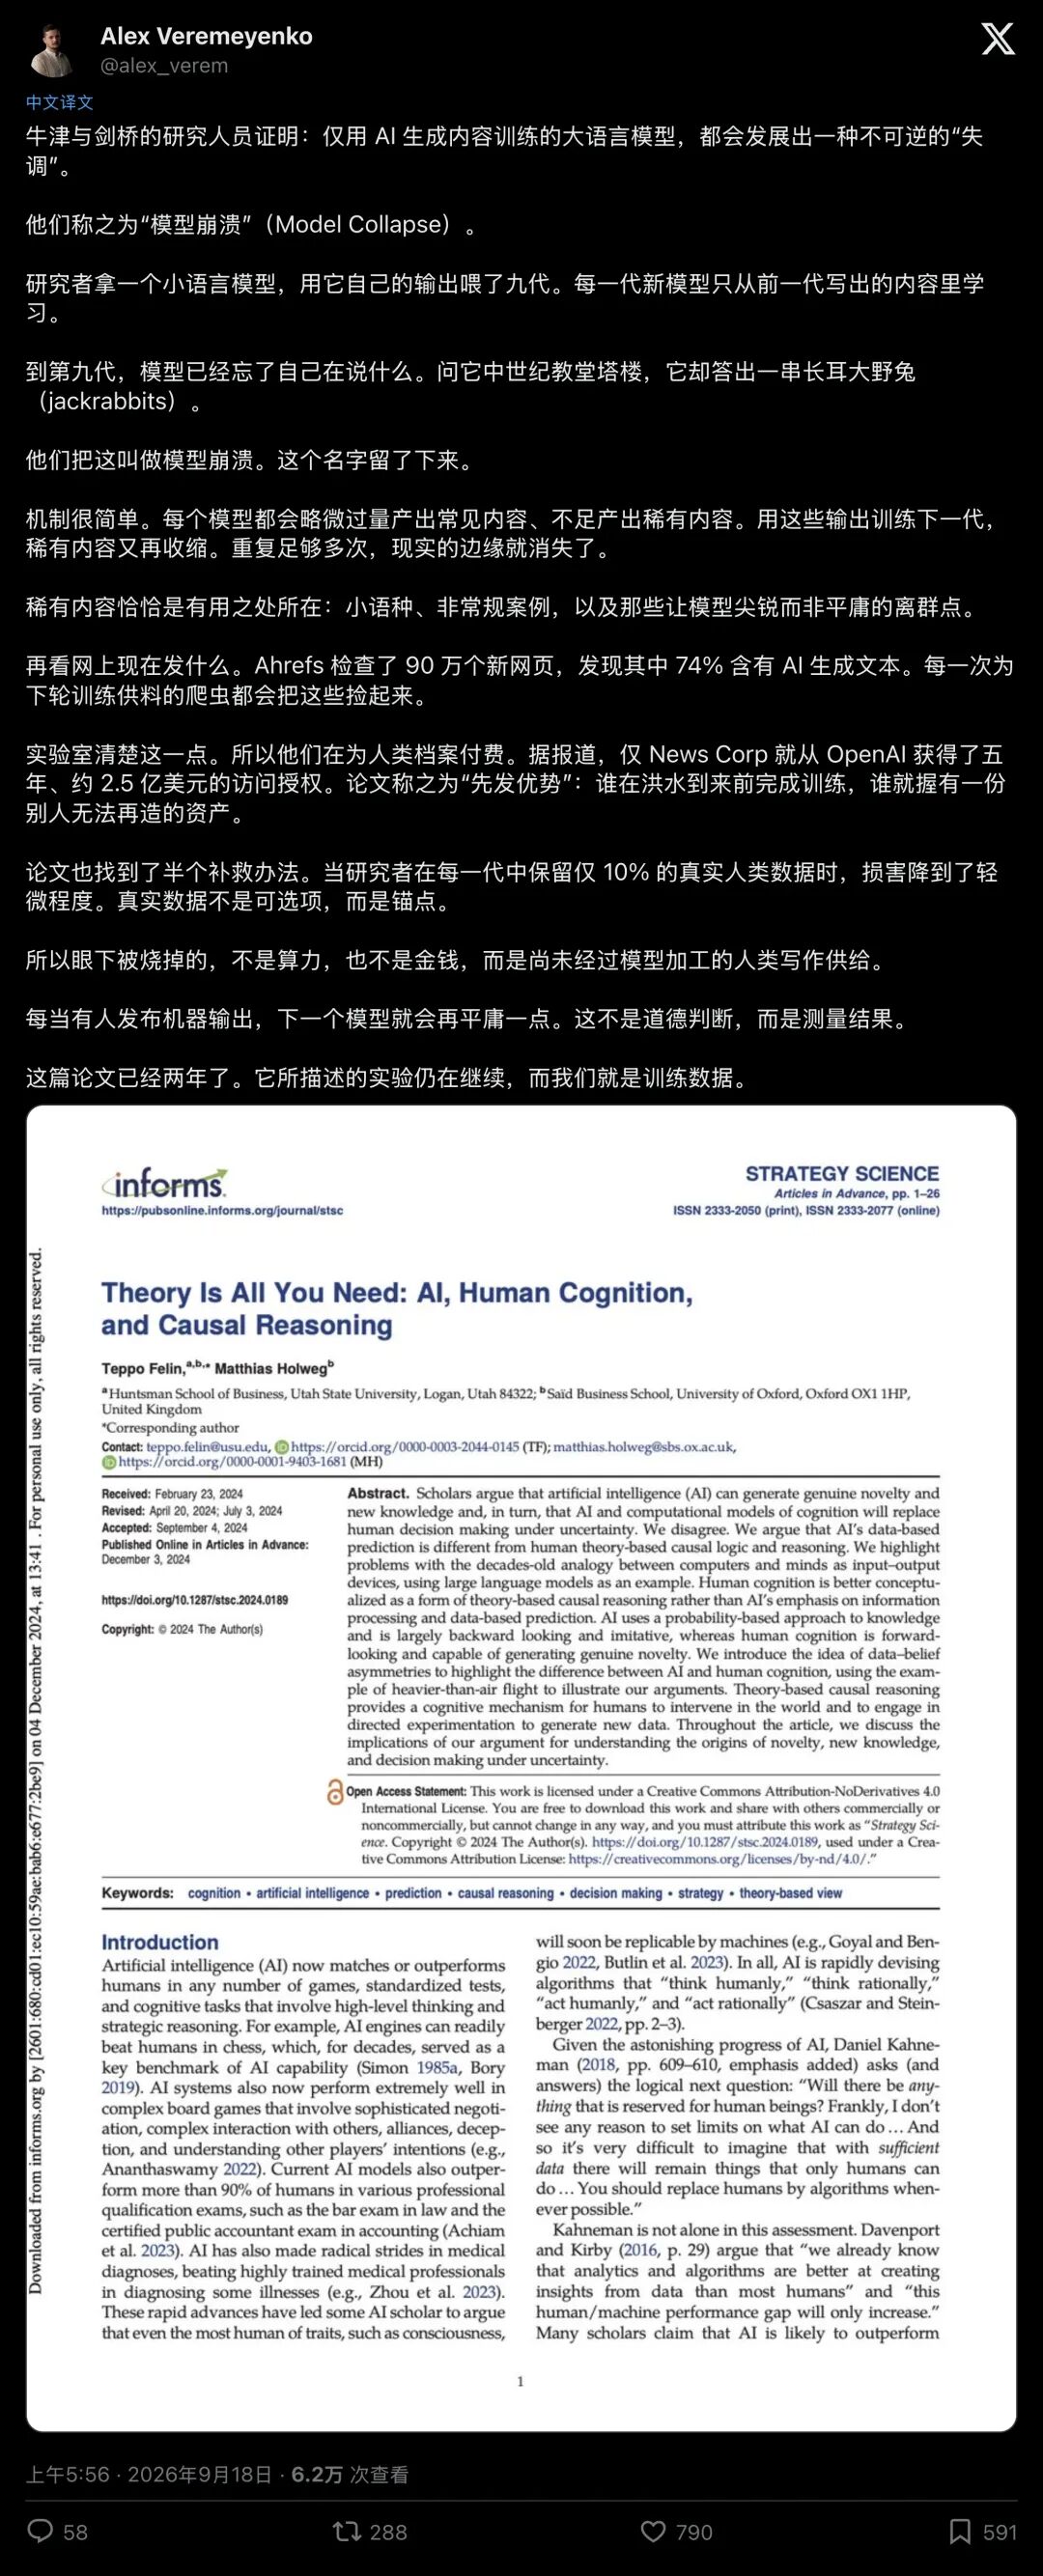
▲ 社交网络上的热议长帖:解析九代递归训练如何让模型走向崩溃
第一阶段:早期崩溃,尾巴先死
真实世界是充满“长尾”的罕见的医学病例、古老的方言、先锋的哲学思考、非主流的艺术风格,它们在数据集中出现的概率极低,但构成了人类文明的灵魂。
然而,AI在生成内容时,出于“不出错”的本能,总是倾向于挑最常见、概率最高的安全词汇。
这就导致低概率的长尾信息在代际传递中被无情抹杀。第一代丢掉0.1%的稀有表达,第二代丢掉1%,到了第三代,分布的“尾巴”彻底消失了。
第二阶段:晚期崩溃,彻底胡言乱语
当长尾彻底死绝,模型的视野极速狭窄。它把仅存的少数高频模式当成了整个世界的全貌。
此时,微小的数学拟合偏差开始像雪崩一样代际放大。模型输出的方差趋近于零,最终陷入逻辑死循环,退化为毫无意义的重复噪音,就像反复用复印机去复印一张已经模糊的复印件,最后印出来的只剩一团漆黑的墨斑。
教堂消失了,取而代之的是无穷无尽的彩色野兔。
02视觉疯牛病:从油腻塑料脸到肉色肉团
如果说文字的退化还带有一丝抽象的荒诞,那么视觉生成模型的崩溃,则直接演变成了生理级别的恐怖片。
上世纪80年代,英国为了节省饲料成本,将病死牛的肉骨粉加工成饲料喂给健康的牛群,最终引发了席卷全球的“疯牛病”。
莱斯大学(Rice University)在顶级学术会议 ICLR 2024 上发表的 Oral 论文,直接将生成式图像模型的自噬退化命名为 MAD(模型自噬障碍)。
当科学家用上一代扩散模型生成的图片去训练下一代时,一幕幕恐怖的视觉病理学现象接连上演:
- 高频细节抹除与“塑料化”
:在第1到第2代,人类皮肤特有的毛孔、微小皱纹、发丝反光等细节被最先抹平。整张脸呈现出一种极不自然的、油腻而廉价的“塑料假人感”。 - 网格伪影与棋盘噪点爆炸
:卷积网络和注意力机制在生成图像时留下的微小对齐瑕疵,在下一代模型眼中被误当成了“真实特征”。数代之后,人物皮肤上蔓延出大面积恐怖的交错网格伪影(Cross-hatching)。 - 面容极端均质化(Homogenisation)
:到了第5代,不同种族、不同性别、不同年龄的面孔表征迅速坍缩。整个模型只能生成一张神态僵硬、五官完全趋同的“终极平均脸”。 - 结构彻底瓦解
:到了晚期,去噪扩散模型连基本的空间拓扑结构都无法维持。在测试中,手写数字退化成了飘散在空中的噪波云团;在人脸测试中,最终输出的是一团团无法辨识器官的混沌肉色肿块。
▲ 业内研究者指出:失败往往从“长尾消失”开始,微小的数据退化最终会引发系统崩塌
这里还藏着一个残酷的工程悖论:
工程师如果为了追求单张图好看,采用极其严格的美学评分去筛选训练集,虽然延缓了噪点的出现,但会以断崖式的速度消灭多样性,直接引发“模式坍缩”(Mode Collapse);如果不加筛选全盘接收,模型的画质和结构又会在数代之内彻底烂掉。
左手是平庸的窒息,右手是混乱的毁灭。
03数据公地的悲剧:互联网正在沦为赛博核废土
有人会问:实验室里的递归实验很极端,现实世界中哪有这么纯粹的AI闭环?
现实比实验残酷得多一场前所未有的“赛博近亲繁殖”,正在我们每天浏览的互联网上悄然发生。
知名SEO与数据机构 Ahrefs 在2025年对全球新爬取的近90万个新网页进行深度检测,结果令人心惊肉跳:
高达 74.2% 的新网页中,已经包含可检测出的 AI 生成文本。
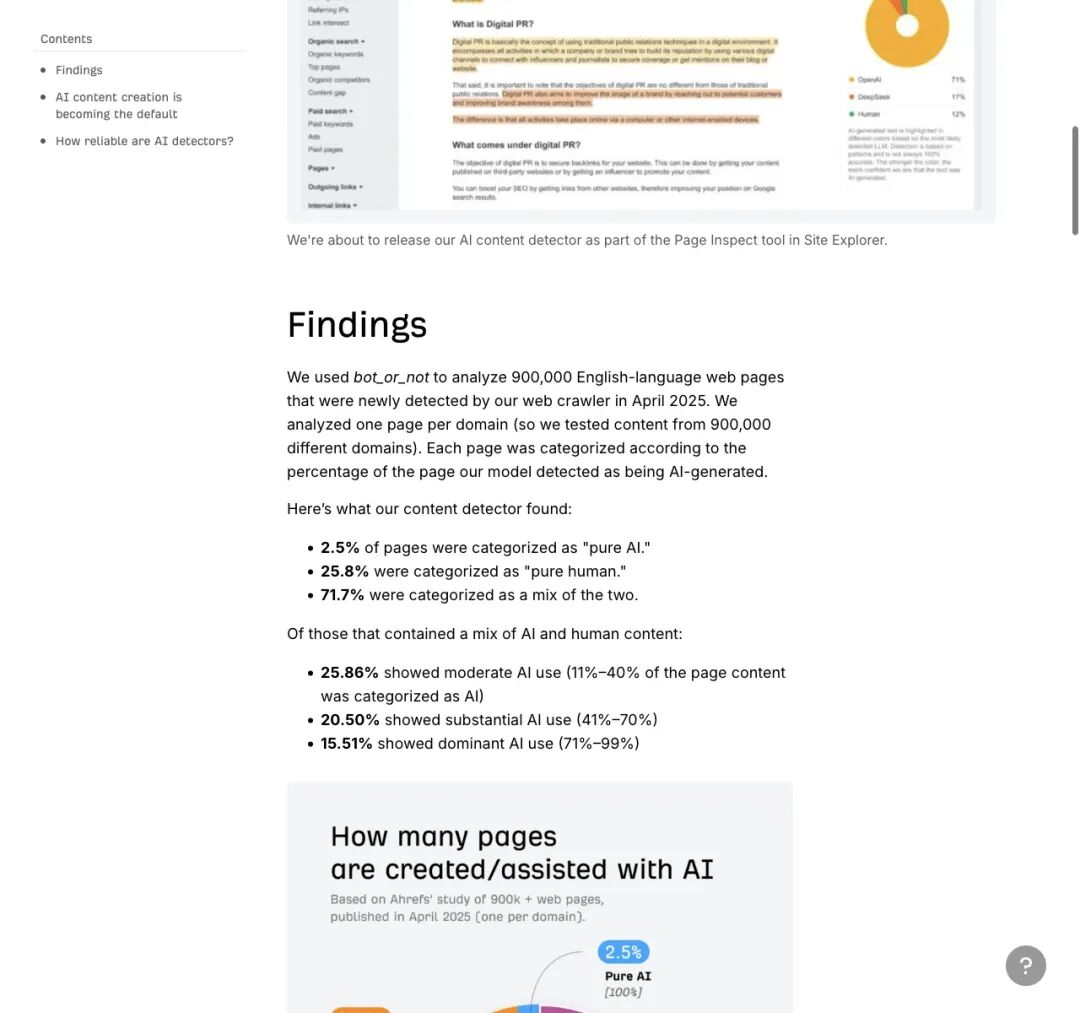
▲ Ahrefs 调查发现:纯人类手写网页仅剩 25.8%,超过七成的新网页已被 AI 污染
这是一个令人窒息的恶性循环:人类创作者因为流量被蚕食、收益下滑,纷纷停更关站;为了赚取广告费的自动化黑产团队,用大模型批量生产出数以亿计的廉价AI垃圾站;搜索引擎为了抓取新鲜内容,把这些AI垃圾吞进数据库;下一代基础大模型的爬虫,再把这些混合了无数AI排泄物的网页打包运回训练集群。
日本理化学研究所(RIKEN)在计算机视觉顶会 ICCV 上的研究早已拉响警报:即便是像 ImageNet、COCO 这样的基准数据集,一旦混入 10% 到 20% 的未经标注的生成图像,下游所有的图像识别、目标检测模型的准确率就会全线崩塌!
大模型不仅在毒害自己,还在毒死全人类数十年建立起来的公共数字资产。
04巨头的暗牌:为什么“纯血人类数据”比黄金还贵?
看懂了模型崩溃,你就能瞬间看懂当今大模型巨头们最精神分裂的商业操作。
在发布会上,科技巨头们一遍遍向公众描绘宏伟蓝图:“合成数据是无限的”、“AI正在用自我博弈超越人类”。
但在幕后,他们却在不惜代价地疯狂扫荡前AI时代的纯血人类数据。
2024年5月,传媒巨头新闻集团(News Corp)与 OpenAI 达成了一项为期多年的深度合作协议。据《华尔街日报》等媒体披露,这笔交易的总价值可能超过2.5亿美元。
OpenAI 为什么要为《华尔街日报》、《泰晤士报》这些几十年前的旧报纸、老档案一掷千金?
因为那是未被AI污染过的“前现代人类文明切片”。
Nature 论文的作者在讨论部分一针见血地指出了核心法则:先发优势(First Mover Advantage)。
在2022年ChatGPT横空出世之前,谁完成了对互联网纯血人类语料的完整抓取,谁就拥有了后来者再也无法复制的绝版数字资产。
后来的创业团队哪怕拥有再强大的算力和算法,面对的也是一片已经被AI排泄物严重污染的赛博废土。他们想要清洗数据,就必须付出天文数字般的成本去甄别“哪句话是人写的,哪句话是机器编的”。
未被污染的人类思想,正在成为硅基时代最昂贵的新型石油。
05解药何在?10%的文明底线与“累积救赎”
难道生成式AI真的注定走向集体脑死亡吗?
科学界在拉响警报的同时,也给出了关键的生机。
牛津团队在《Nature》的消融实验中发现了一个极具启示性的数据:在每一代微调中,只要保留原始训练集中 10% 的人类真实数据作为“锚点”,模型的崩溃速度就会被大幅压制,性能仅出现轻微下滑。
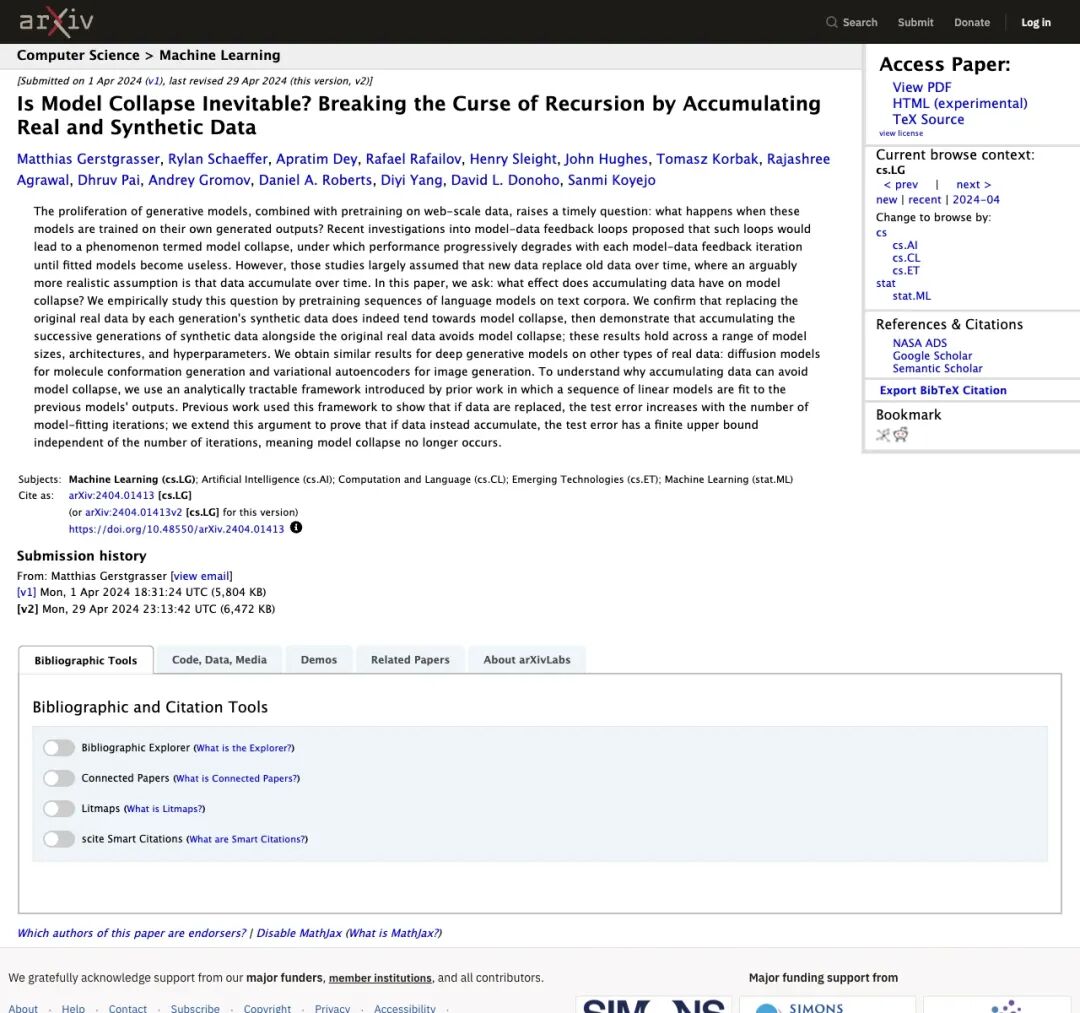
▲ 斯坦福等团队指出:通过“累积真实数据”而非单纯替换,可以打破递归诅咒
随后,斯坦福大学的 Gerstgrasser 等研究者进一步指明了关键的工程分水岭:
- 替换模式(Replace)
:每一代丢弃旧数据,只用新一代生成的合成数据替代训练,必死无疑,走向崩溃; - 累积模式(Accumulate)
:在保留历史上所有真实人类数据的前提下,将经过严密清洗的合成数据不断并入训练池,误差有上界,模型不会发散。
合成数据并非绝对的毒药,但它必须被牢牢拴在真实人类经验的引力场内。
一旦脱离了真实世界的反馈,脱离了真实人类带着体温、偏见、痛苦、灵感写下的文字,算法世界就会在自我参照的镜子迷宫里,彻底走向虚无与荒诞。
06捍卫人类表达的火种
大语言模型和扩散模型并非凭空产生智慧的神明,其本质是一面面精密的镜子。
镜子之所以璀璨,是因为它映照着大千世界,映照着人类漫长历史中的哥特教堂、文学史诗、深邃思考,乃至那些不完美的瑕疵与执拗。
假若镜面脱离了真实世界的映照,只在另一面镜子前进行无休止的自我反射,最终倒映出的产物,只剩下一只只畸变怪诞的“彩色野兔”。
在AI越来越便宜、垃圾信息越来越泛滥的时代,每一个认真写字、用心画画、独立思考的人类个体,都在为这个濒临坍塌的数字世界,保留最后一份维持理智的纯净血液。