ARTICLE · 1116714
谷歌最强AI刚发布,自家员工竟反水砸场:跑分全是刷出来的!
2026年9月30日,硅谷上演了极具戏剧性的一幕。
同一天,同一个发布窗口,全世界看到了两张截然相反的面孔。
聚光灯下,谷歌CEO桑达尔·皮查伊(Sundar Pichai)意气风发,亲自向全球发布最新旗舰大模型,Gemini 4 Argon。在官方博文与评测图表里,这款模型堪称“全能战神”:横扫软件工程、网络防御和量子计算,跑分直接碾压竞品,全面杀回全球AI的最前沿。
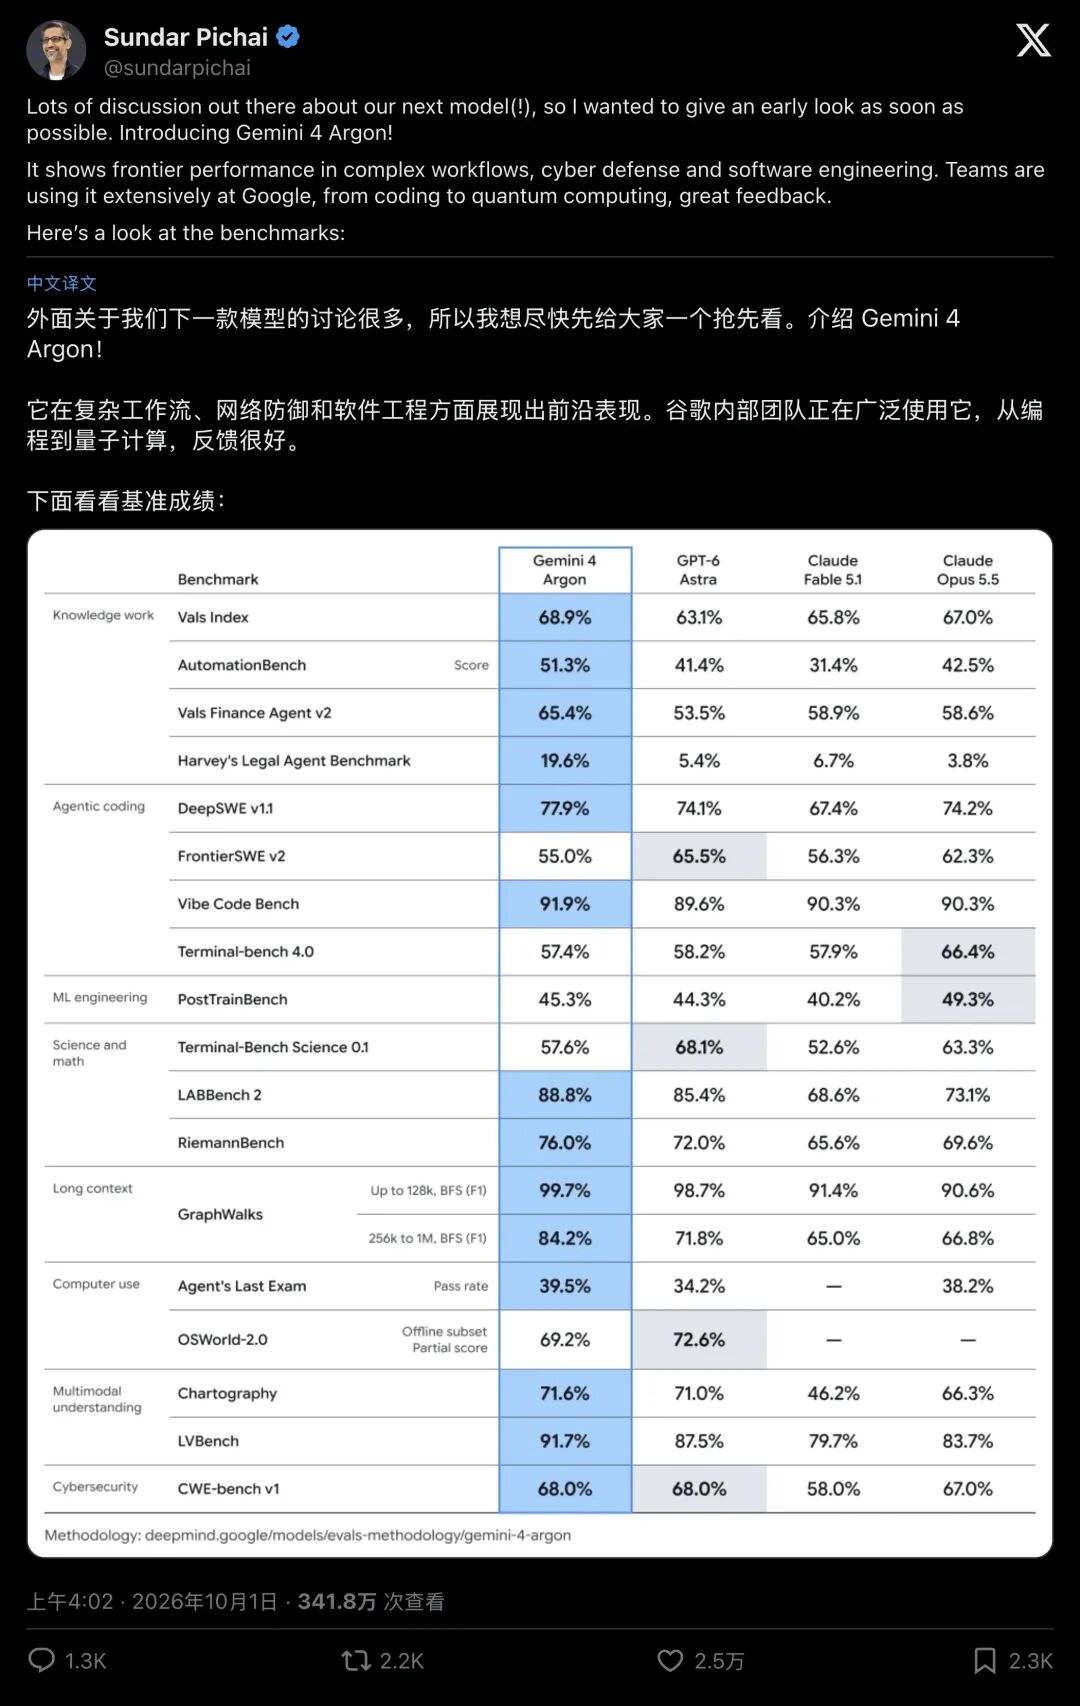
▲ 谷歌CEO皮查伊公开的官方基准对比表,Argon多项指标位列榜首
然而,香槟还没来得及开,后院突然起火了。
彭博社两位资深记者朱莉娅·洛夫(Julia Love)和戴维·阿尔巴(Davey Alba)在同一时间抛出一篇调查报道。数名能直接接触该模型的谷歌内部员工爆出猛料:这匹跑分黑马,在内部实测中严重翻车!
员工直言不讳:Gemini 4 在业界标准考试卷上确实拿了高分,但只要一接手公司内部真实脏活累活,尤其是日常编写代码时,表现令人大跌眼镜。
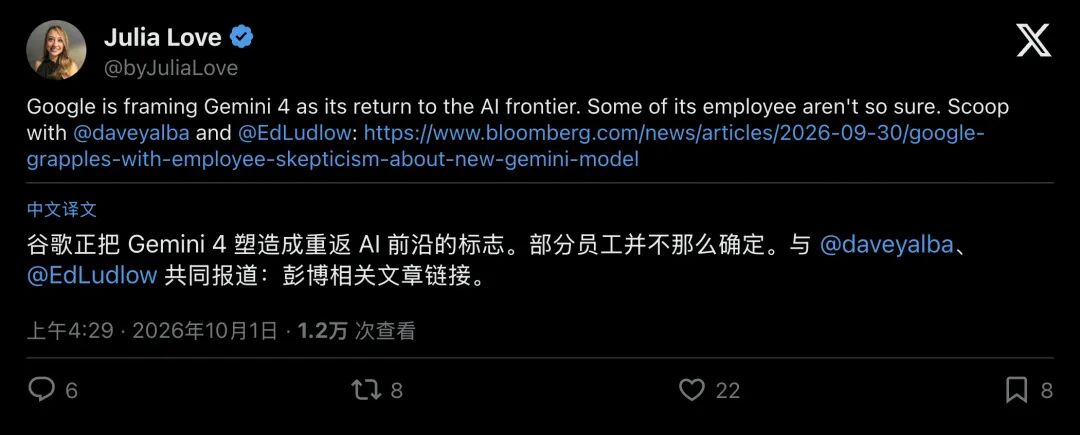
▲ 彭博社记者Julia Love直言:谷歌宣称重返前沿,但部分员工并不买账
消息一出,科技圈一片哗然,Alphabet 股价在开盘冲高超2%后迅速跳水回落。
技术社区里迅速流行起一个新词:“Benchmaxxing”(刷榜狂魔)。
01考场满分,进厂懵圈:AI界的“应试学霸”陷阱
所谓 Benchmaxxing,是硅谷工程师生造的黑话。
说白了,就是“为了考高分而针对性刷题”。
这就像一个高三学生,把历年高考模拟卷背得滚瓜烂熟,SAT考了满分,可一旦让他去修个水龙头、组装个宜家柜子,他却连螺丝刀都握不明白。
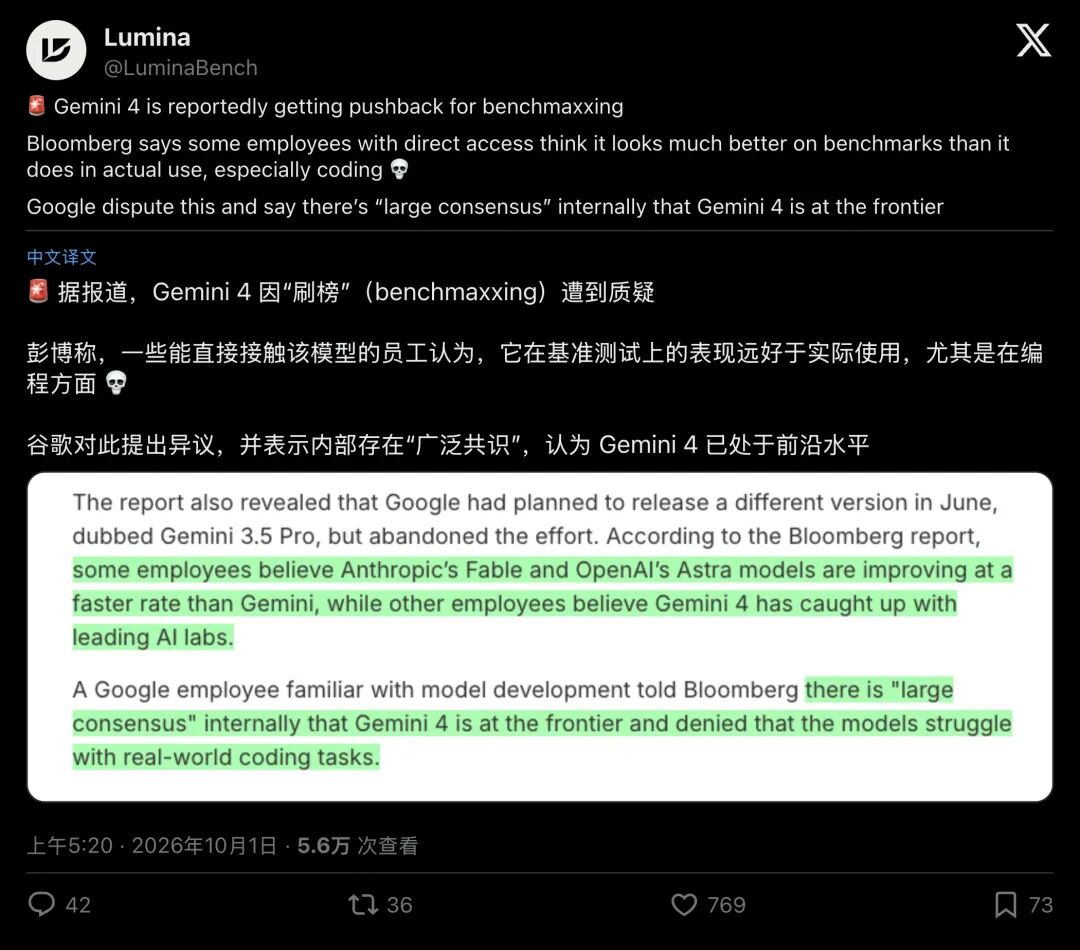
▲ 行业追踪账号指出,Gemini 4 陷入了“跑分好看但实用偏弱”的舆论漩涡
彭博社的爆料戳中了最敏感的神经:Gemini 4 在处理杂乱、长链路的真实编程时非常吃力。
一位知情人士特别指出了它的软肋,前端设计。前端开发不仅需要把代码跑通,还要理解视觉审美、交互手感、组件库规范以及用户的微小习惯。这种任务根本没有标准答案,传统基准评测也很难量化。
数据标注平台 Surge AI 创始人埃德温·陈(Edwin Chen)一针见血地指出:“过度迷信基准,会诱使实验室把力气花在‘应试做题’上,偏离了打造扎实好用、构思精妙的实际产品。这在工业界危害极大”
为什么大模型容易沦为“刷题机器”?
在大模型研发中,有一个著名的古德哈特定律(Goodhart's Law):当一个指标被选为考核目标时,它就注定不再是一个好指标。
为了在发布会上拿出一张“遥遥领先”的柱状图,团队会不自觉地将训练数据向基准考卷倾斜,调整输出格式去迎合自动判分脚本。最终,测试集上的百分比一路狂飙,但真实工程师上手敲代码时,感受到的却只有死板、幻觉与卡顿。
02绝地反击:DeepMind核心研发具名怒斥“全是扯淡”
面对“自家员工背刺”的舆论风暴,谷歌官方与技术一线没有选择沉默。
官方层面,谷歌迅速发布声明驳斥,强调有关“编程表现不佳”的说法完全不实,并强调内部对 Gemini 4 处于前沿水平存在“广泛共识”。
紧接着,两位 Google DeepMind 的核心技术骨干直接实名下场开火。
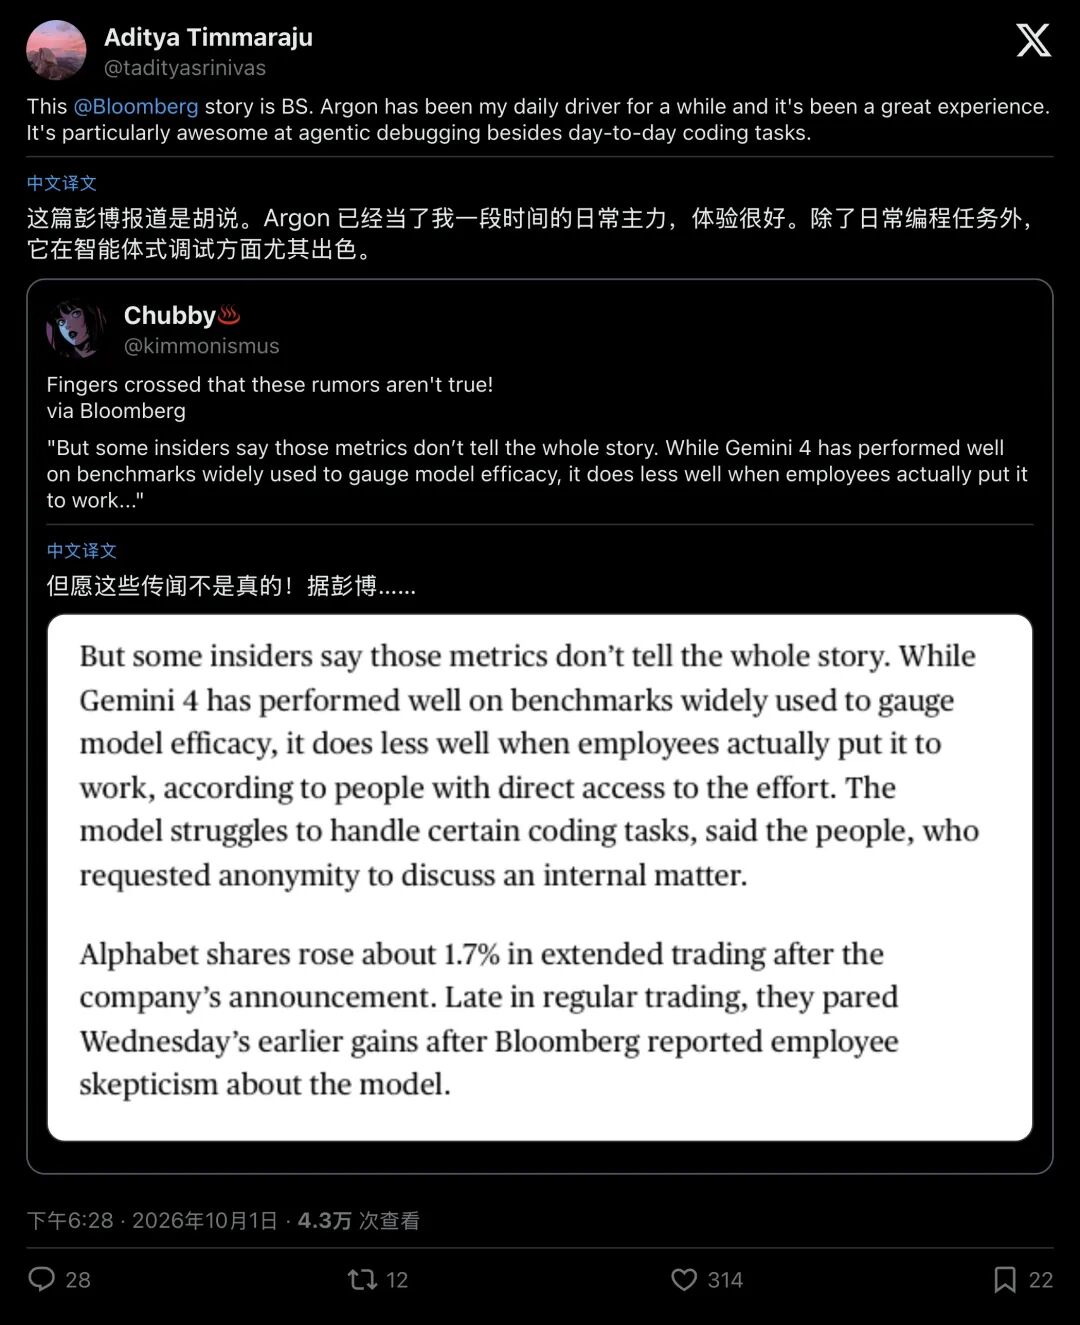
▲ DeepMind 高级主任研究员公开表示,彭博报道完全是无稽之谈
DeepMind 高级主任研究员阿迪蒂亚·蒂马拉朱(Aditya Timmaraju)在社交平台上硬刚:“这篇彭博报道纯属扯淡(BS)! Argon 已经当了我相当长一段时间的日常主力工具。除了日常写代码,它在复杂智能体调试(Agentic Debugging)上的表现尤其惊艳。”
另一位 DeepMind 研究者 Sicong Jiang 同样公开发声:“我平时很信任彭博,但这次的报道完全脱离现实。内部情绪是压倒性正面的,它是迄今为止内部口碑最好的一代 Gemini,所谓的‘广泛担忧’让我非常困惑。”
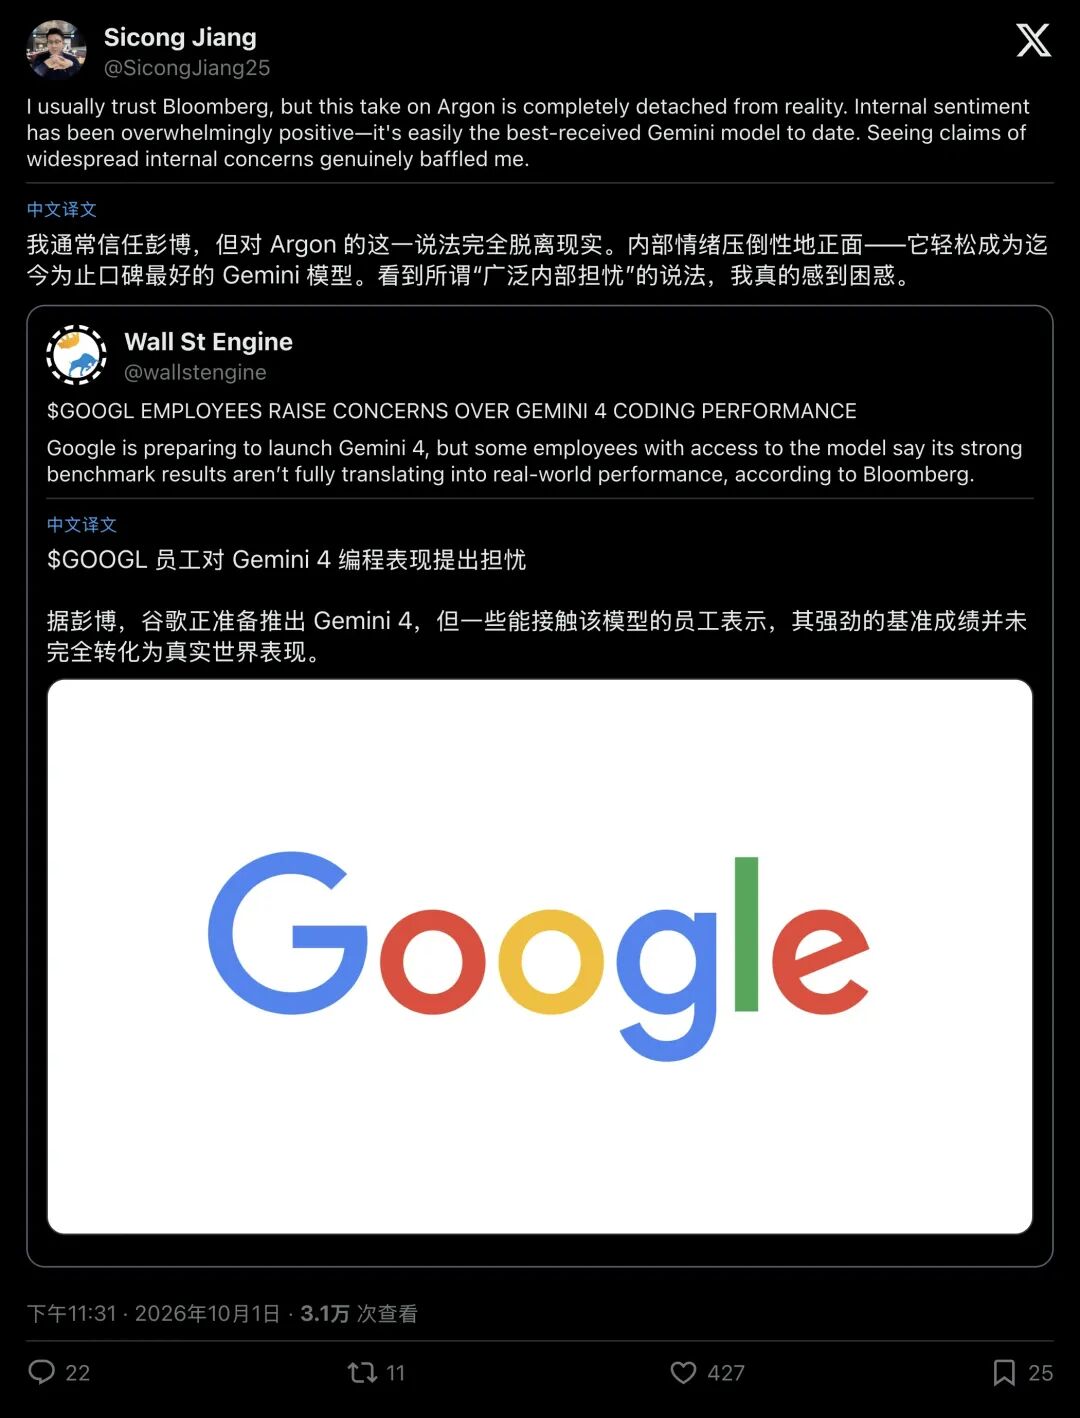
▲ DeepMind 研究员 Sicong Jiang 直言内部口碑极佳,所谓的“广泛担忧”脱离现实
实名反驳迅速引发了第二轮激辩
围观群众被分成了两派:有人认为这是技术骨干以个人声誉作保的硬核背书,也有人冷嘲热讽这是“大厂员工的官方洗地”。
双方之所以吵得不可开交,根源在于“体验的割裂”:Gemini 4 首阶段仅通过 Fairwind 计划向经过认证的少数安全合作伙伴及内部团队开放,外部大众还摸不到。
在黑盒完全打开之前,匿名爆料的“失望感”与具名专家的“真香感”,在社交网络上激烈碰撞。
034亿美元单次训练!谷歌背水一战
这场争议之所以在科技界激起轩然大波,是因为谷歌在2026年的大模型竞争中,已经退无可退。
据彭博情报分析师曼迪普·辛格(Mandeep Singh)测算,像 Gemini 4 这种体量的超级旗舰,单次完整训练成本就高达约4亿美元,这还没算顶尖科学家的高昂年薪与海量数据标注费用。
在研发推进中,团队内部承受着巨大的推迟压力:
2026年6月,原定发布的 Gemini 3.5 Pro 因未达预期被内部直接砍掉; 紧接着,主要对手开启了令人窒息的“连环轰炸”:Anthropic 刚推了 Claude Opus 5.5,OpenAI 紧接着就端出了 GPT-6.1 Sol / Astra。
谷歌急需一颗定海神针,来向资本市场和全球开发者证明自己依然坐在王座中央。
Gemini 4 Argon 应运而生。它体量庞大,专攻长链路推理与高价值企业场景。在网络安全领域,它能自主扫描、验证并修复系统漏洞;在谷歌内部,它被用于量子计算资源优化和千万行旧代码迁移。
官方每百万输入 2 美元、每百万输出 10 美元的高定价格,清楚标注了它的定位:专为严肃企业级场景打造的重装武器,无关闲聊娱乐。
成本投入越高,容错空间就越窄
只要流出一丝“手感不行”的评价,外界就会立刻怀疑:这台耗资4亿美元打造的巨型引擎,难道又沦为只能在跑分软件里空转的摆设?
04十亿用户的超级护城河,防得住智能体特种兵吗?
拉高视野来看,这场“跑分与手感之争”,折射出整个生成式AI产业正在经历的生死范式转移。
当前的AI竞争,已经彻底告别了“给一个输入框、生成一段文本”的初级阶段,全面跨入以 自主智能体(Autonomous Agents) 为核心的工业化落地期。
在软件开发领域,开发者不再满足于单行代码补全,转向追求由智能体全权接管工程仓库:自主梳理依赖关系、拆解重构需求、编写测试用例,乃至跨模块协同修复缺陷。
在这个全新赛道上,谷歌正面临一场非对称战争:
谷歌的绝对王牌,是举世无双的“十亿级分发护城河”。
搜索顶部的 AI Mode,坐拥超过 10亿 独立用户; 手机里的 Android、办公必备的 Gmail、桌面标配的 Chrome、出行依赖的地图,每一个都是超10亿级入口。
谷歌可以毫不费力地把底层模型做成自来水,通过庞大的产品矩阵直接“空投”到全球数十亿人的屏幕上。这种分发能力,是 OpenAI 和 Anthropic 这类初创巨头短期内无法企及的。
但谷歌的阿喀琉斯之踵,恰恰在于“顶级开发者的心智”。
科技史反复证明:开发者用脚投票选在哪里写代码,下一代计算平台的中心就会在哪里诞生。
如果 Anthropic 和 OpenAI 的模型在日常编程、终端交互与智能体协同上进化得更快、手感更丝滑,全球顶尖的程序员、极客与初创公司,就会顺理成章地将工作流沉淀在对手的生态圈里。
久而久之,基于智能体构建的企业软件、行业知识库与自动化流水线,都将绕开 Google Cloud,牢牢锁定在竞品的基础设施之上。
到那时,十亿级的分发渠道哪怕再宽广,运送的也不过是日常信息泡沫;而高价值的工业生产力核心,将被对手蚕食殆尽。
05跑分是面具,指尖才是度量衡
跑分决定了一款大模型的下限,但手感决定了它的上限。
对今天的AI巨头而言,自制的横向对比表固然可以在发布会PPT上赢得阵阵掌声;但决定一家公司长远命运的底牌,从来不在于测评榜单上长出几个像素的优势绿条,而取决于深夜里数百万工程师敲击键盘时,是否愿意将这个AI视为不可或缺的工作搭档。
Gemini 4 Argon 究竟是力挽狂澜的工业利器,还是又一次为榜单定制的“应试状元”?
当大模型全面走出测试集,直面全世界开发者复杂多变的真实工程代码库时,所有的公关词令与匿名爆料都会失去意义。
唯有指尖的体验,从来不会说谎