ARTICLE · 1116966
AI落地难?TI全栈方案撬开边缘AI规模化之门
过去几年大众聊AI,目光大多聚焦在云端大模型,动辄百亿千亿参数、庞大的算力集群。但真实世界里,大量设备等不起云端往返的延迟:工业产线电机故障要瞬间识别、医疗穿戴设备要实时解析心电信号、智能家居要立刻感知人体动作、人形机器人要快速做出动作反馈。
2026年,产业拐点已经到来,边缘推理市场规模快速扩张,AI不再只跑在遥远的数据中心,大量计算任务下沉到传感器、控制器等终端硬件上。不过把AI塞进小小的MCU微控制器,并不是简单把模型做小就万事大吉,功耗、成本、数据安全、软硬件兼容,一道道现实门槛挡在落地路上。德州仪器TI基于数十年嵌入式技术积累,拿出一套从硬件、安全到开发工具的完整方案,让普通终端设备也能用上本地AI能力。
边缘AI最直白的好处,就是数据不用全部上传云端,设备本地完成感知、计算、决策,实现亚毫秒级响应,既省下通信功耗,敏感数据也不用向外传输,隐私安全更有保障。但美好场景背后,行业正遭遇两大棘手难题。
第一重难题是安全与隐私。当设备自己接管AI决策,黑客窃取AI模型、注入恶意代码的风险随之而来。很多工业、医疗设备一旦模型被篡改,会直接造成设备失灵,仅仅靠软件打补丁远远不够,必须从芯片底层筑起防护墙。
第二重难题是碎片化带来的扩展困境。边缘设备跨度极大,有的是纽扣电池供电的低功耗传感器,有的是多路视频处理的高性能工业设备。如果每一类硬件都单独开发一套软硬件,研发成本会成倍上涨。行业迫切需要一套可以高低档位平滑迁移的架构,一套开发思路,能够适配低端传感器到高端处理器的不同硬件。
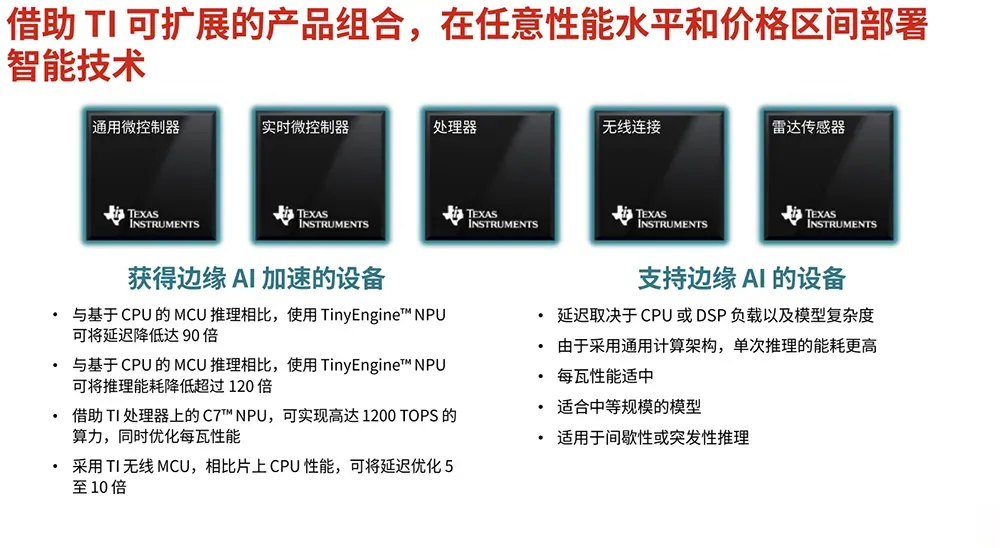 不少厂商只盯着把NPU加速器塞到芯片里,却忽略整套系统的适配。TI的思路并不追求造出一颗“万能芯片”,而是打造覆盖完整档位的产品矩阵,从入门级MCU到高性能处理器,搭配统一软件生态,工程师按需挑选硬件,代码可以跨设备迁移,降低重复开发的负担。
市面上不存在一颗芯片搞定全部边缘场景,不同场景对算力、功耗、成本取舍完全不同。TI把边缘AI能力融入MCU、处理器、无线连接、毫米波雷达整套产品线,覆盖消费电子、工业、汽车、医疗等五花八门的场景。
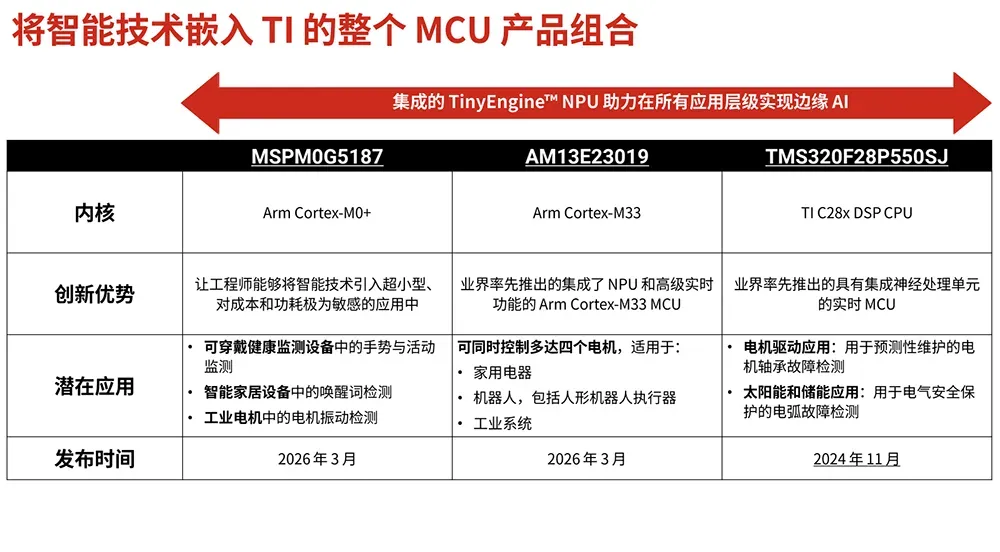 入门档位的MSPM0系列面向成本敏感、电池供电设备,MSPM0G5187搭载TinyEngineNPU,把AI能力下放到微型节点,手势识别、关键词检测、设备故障预判都能本地运行,打破“AI只属于高端硬件”的固有印象。
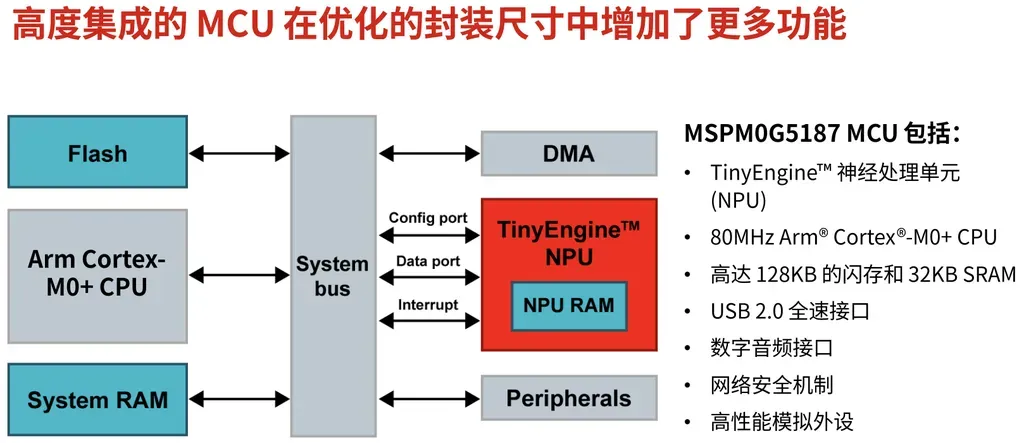
面向工业多电机控制的AM13E23019,单颗芯片同时具备主控内核与AI加速器,不用外挂额外AI芯片,就能一边做电机实时控制,一边运行AI故障诊断,直接把硬件物料成本最高压缩30%。C2000系列实时控制MCU,则服务光伏逆变器、电力设备,AI算法直接嵌入高频控制环路,实时优化参数、预判故障。
算力需求更高的视觉场景,则交给AM6x处理器家族,算力区间跨度很大,适配工业面板、PLC控制器,乃至多路图像识别任务。再搭配Wi‑Fi、蓝牙、Sub‑1GHz无线方案,以及60GHz、77GHz毫米波雷达,感知、计算、通信整套链路全部补齐。
这套硬件方案已经落地到真实产品。医疗穿戴设备依靠本地AI,心电处理延迟直接降低十倍,只在异常时刻才上传数据,设备续航大幅拉长;普通被动红外传感器搭配MCU端AI算法,多人体运动识别准确率提升至98%以上;工业现场小型设备本地识别仪表盘数字,不用网络也能完成读数采集。
在小小的MCU上跑AI,传统做法直接把NPU和CPU深度绑定在一起。看似集成度很高,实际会出现资源争抢,CPU处理业务的时候,AI推理就被拖慢,系统容易出现性能抖动。
TinyEngineNPU的核心巧思,就是计算单元和CPU内核互相解耦,作为独立硬件加速器工作。执行AI推理的时候,不需要唤醒主CPU,NPU独立完成运算。对比不带专用加速器的同级别MCU,推理延迟最多下降90倍,单次推理能耗降低超120倍,闪存占用也得到缩减。
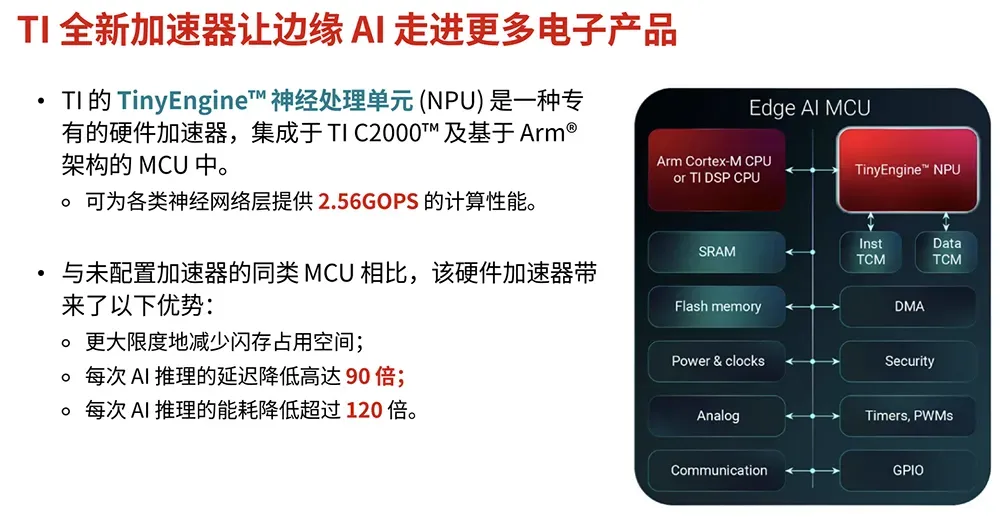
架构设计顺带解决模型被盗的风险。AI模型编译之后直接跑在加速器内部,而不是MCU公共闪存空间,硬件形成天然隔离。攻击者很难通过内存读取、缓冲区溢出漏洞偷走训练好的模型,给设备加上一层硬件安全屏障。
边缘AI的判断准不准,源头在于传感器采集的模拟信号。TI把高精度ADC、低漂移运放模拟部件和AI算力整合,形成“传感器采集‑AI运算‑设备控制输出”完整闭环,从源头减少信号噪声干扰,保证AI输出结果可靠。
安全层面分成功能安全与信息安全两条线。功能安全是设备运行底线,从芯片设计初期就纳入研发流程,尤其工业、汽车芯片,保障故障情况下设备不会失控。信息安全上结合TrustZone,搭配多层硬件安全加速器、加密库,给固件、内存提供保护,方便开发者打造安全应用。
硬件只是地基,边缘AI想要大规模普及,软件工具链才是关键。很多中小企业工程师熟悉硬件开发,却没有深度学习调参经验,这是落地最大堵点。
TI的EdgeAIStudio兼顾不同水平开发者。手里已经有成熟PyTorch、TensorFlow模型的企业,可以直接导入模型,针对芯片硬件做量化微调,快速完成部署。不懂AI训练的工程师,依靠可视化界面,采集传感器数据,工具自动完成训练、优化、一键编译下载,不用钻研复杂算法细节。
CCStudio开发环境还加入AIAgent能力,AI能够读懂海量芯片手册、SDK文档、参考案例。写代码时提供智能补全,帮忙配置寄存器,调试的时候定位报错问题,缩短产品研发周期。官网免费放出大量参考设计、源码、原理图,开发者拿到开发板就可以快速上手做原型。
不用从零摸索AI开发,硬件有高低档位可选,软件工具打通模型训练到硬件部署全流程,大大压缩边缘AI产品从想法到量产的周期。
半导体行业很多设计厂商采用Fabless模式,把制造交给外部代工厂,供应链容易受外部产能波动影响。TI坚持IDM垂直整合模式,芯片从设计、晶圆制造再到封测,自有工厂全流程把控。
这样做带来两个关键价值。第一是成本与性能深度协同,设计团队和工艺团队内部打通,针对边缘AI芯片持续做工艺优化;第二是供货稳定,工业、汽车设备往往需要十几年长期供货,TI可以提供长久产品生命周期保障,消除客户芯片停产断供的顾虑。
放眼未来,终端设备不再只是被动执行指令。物理AI时代到来,AIAgent智能体会深度嵌入嵌入式设备。未来硬件不必完全依赖工程师逐行写死逻辑,Agent可以下发指令,设备自主调整行为。在研发端,Agent还能自动查阅芯片资料,生成驱动代码,完成验证测试。当然这一切,还需要整个行业持续打磨技术。
 边缘AI浪潮,不只是把大模型改小放到终端,更是整套嵌入式系统的变革。算力、功耗、成本、安全、供应链,每一环都不能缺位。
TI依靠几十年DSP与嵌入式积累,走出一条软硬件一体化的路线。从TinyEngine解耦加速器,到覆盖全档位芯片产品,再到降低开发门槛的工具生态,让AI不再只是高端设备的专属。千行百业的普通终端设备,都有机会拥有本地智能,AI真正从云端,走进我们身边的物理世界。
首席智能官阅读推荐
重磅爆料!DeepSeek V4新模型弃英伟达,新模型提前给华为等国内厂商“开绿灯”,V4 Lite 绝密参数意外外泄
Claude Code之父直言:1个月后不用Plan Mode,软件工程师头衔将消失
中国AI一发力,谷歌藏了半年的「世界模型」Genie 3连夜上线