ARTICLE · 1122368
文献脉络 | PhoneCLI:把 App 操作离线编译成命令,视觉模型退到兜底位置
论文速览核心症结:手机 Agent 每一步都截图问 VLM,重复任务会一直付相同成本。PhoneCLI 先离线探索 App,把常见操作编译成命令,在线只做选择、校验和回退。创新突破:语义地图 + 每屏一个确定性命令 + 入口/落点校验;目录外任务回退 VLM。适用边界:离线建图和版本维护成本未被充分量化;动态界面会提高回退率。
演进路线图
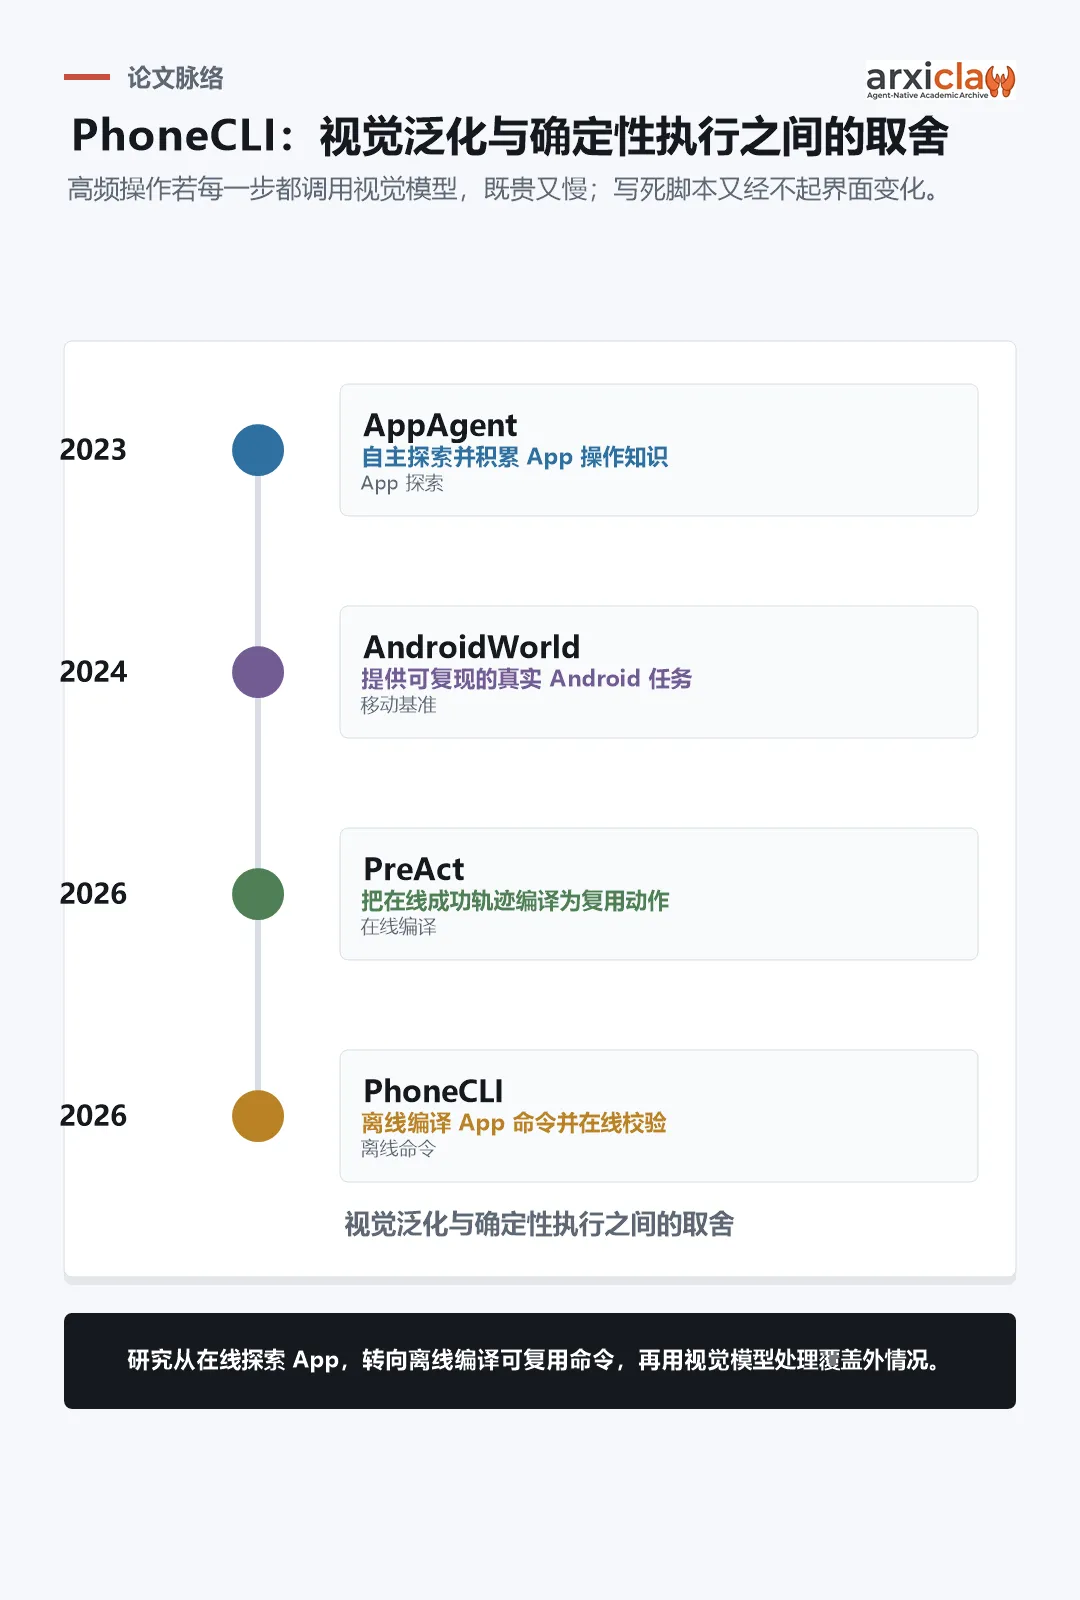
收录截至 2026-09-30。骨干论文按 App 探索、可复现移动基准、轨迹编译和目标论文的离线命令机制选择。收录范围是移动 App 的命令化路线,操作系统级无障碍 API、端到端动作模型和桌面 GUI 基准属于另外的问题。AppAgent、PreAct 与 PhoneCLI 都涉及可复用操作知识,但探索位置和产物不同;AndroidWorld 是评测基础设施,不是命令编译方法。
关系图谱
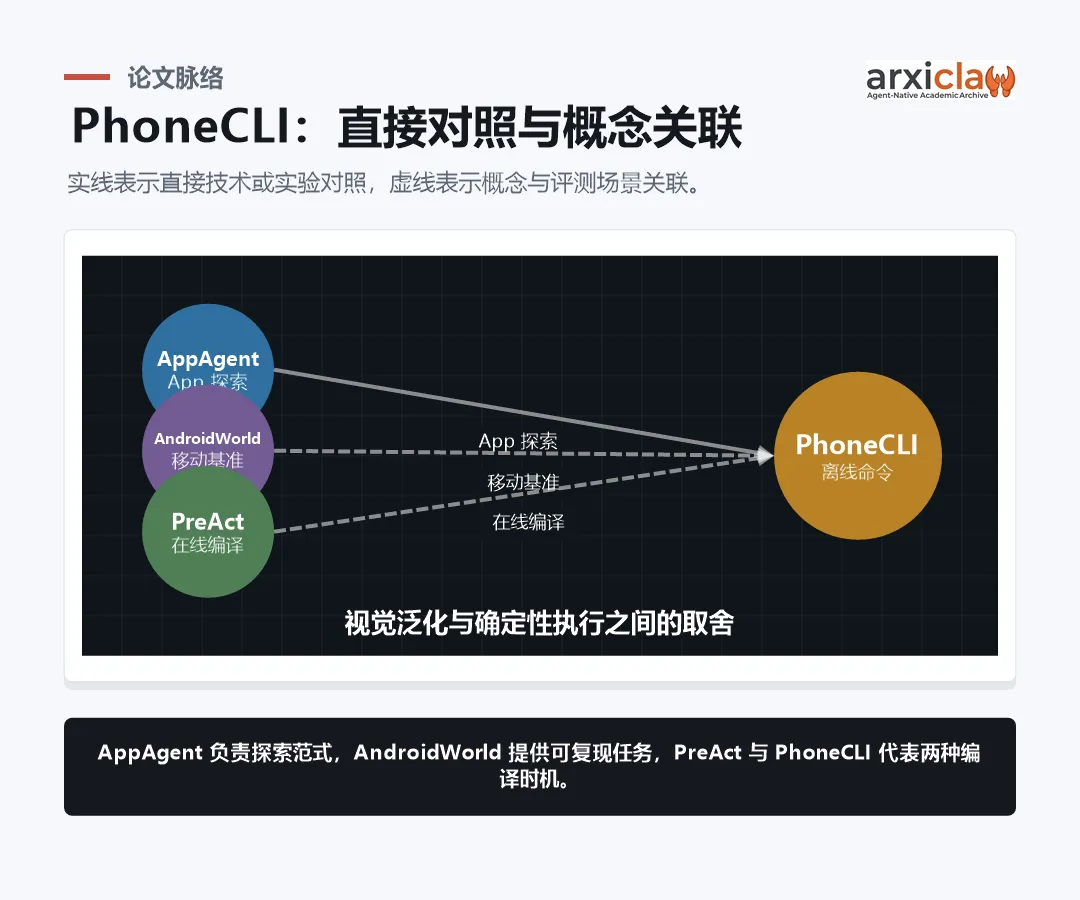
AppAgent→PhoneCLI 使用实线表示两者都明确学习 App 特定操作知识,但 PhoneCLI 改变了知识的执行形式。AndroidWorld→PhoneCLI 用场景虚线,它是评测环境。PreAct↔PhoneCLI 是并行/挑战关系:一个在线编译成功轨迹,一个离线编译 App 命令,不应按发布时间写成继承。
打开设置、切换开关、保存表单这类手机操作高度重复。让视觉语言模型每一步都截图、理解、定位和点击,成本高且容易把一次识别误差传播到后续步骤;但把坐标脚本写死,又会在弹窗、页面跳转或 App 更新后失效。
AppAgent 展示了自主探索 App 的可能,AndroidWorld 把移动端任务做成可复现实验环境,PreAct 在在线执行成功后编译轨迹。PhoneCLI 选择另一条路径:先离线探索单个 App,构建语义地图和命令目录,在线时选择、校验并确定性重放,必要时退回视觉模型。移动 GUI Agent 正把重复操作从“每次理解”迁移到“先编译、后验证”。
1. 核心矛盾:视觉泛化与确定性执行之间的取舍
视觉模型的开放适应性与确定性命令的效率冲突。纯视觉策略可以处理新界面,却在每一步支付推理成本并累积定位误差;命令重放几乎零模型调用,却依赖页面身份、落点状态和预先覆盖。系统设计的关键是把哪些操作编译、用什么状态校验,以及何时承认命令目录不适用。
2. AppAgent 让 Agent 自己探索操作知识
AppAgent:arXivClaw 记录中没有主图与主表。机制与实验数字只能按正文文字核验。
自主探索减少人工脚本,在线执行仍依赖逐步理解
AppAgent 通过探索移动应用、记录界面与操作经验,再执行用户任务。它证明 App 特定知识可以由 Agent 获取,而不必完全手工编码。但执行时仍需要模型解释当前屏幕并决定下一步,重复任务的每一步成本和视觉波动没有消失。
AppAgent 与 PhoneCLI 都把 App 知识显式化;区别在于后者把常见操作编译成确定性命令,并在重放前后校验状态。
3. AndroidWorld 把真实移动任务放进可复现实验
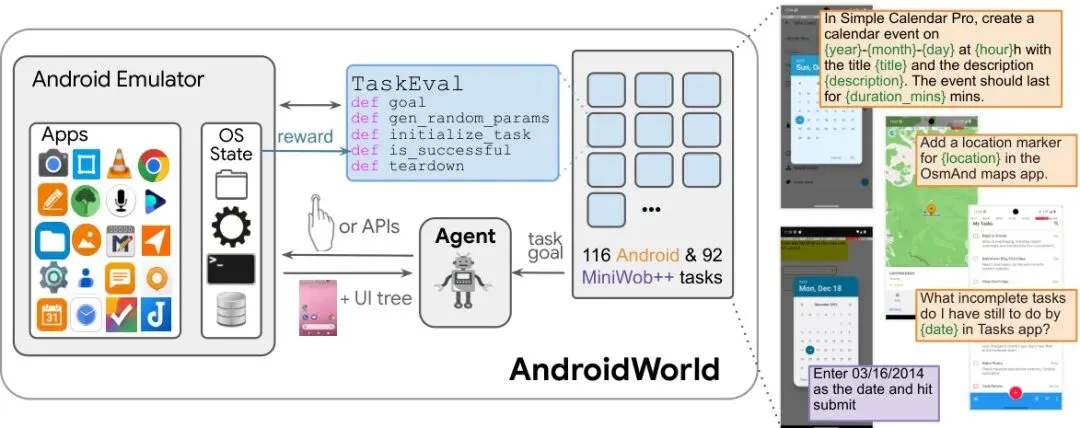
图片来源:arXivClaw 论文记录 · AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Agents
主图用于核对这篇论文的机制或流程:真实 App、任务定义与程序化验证。
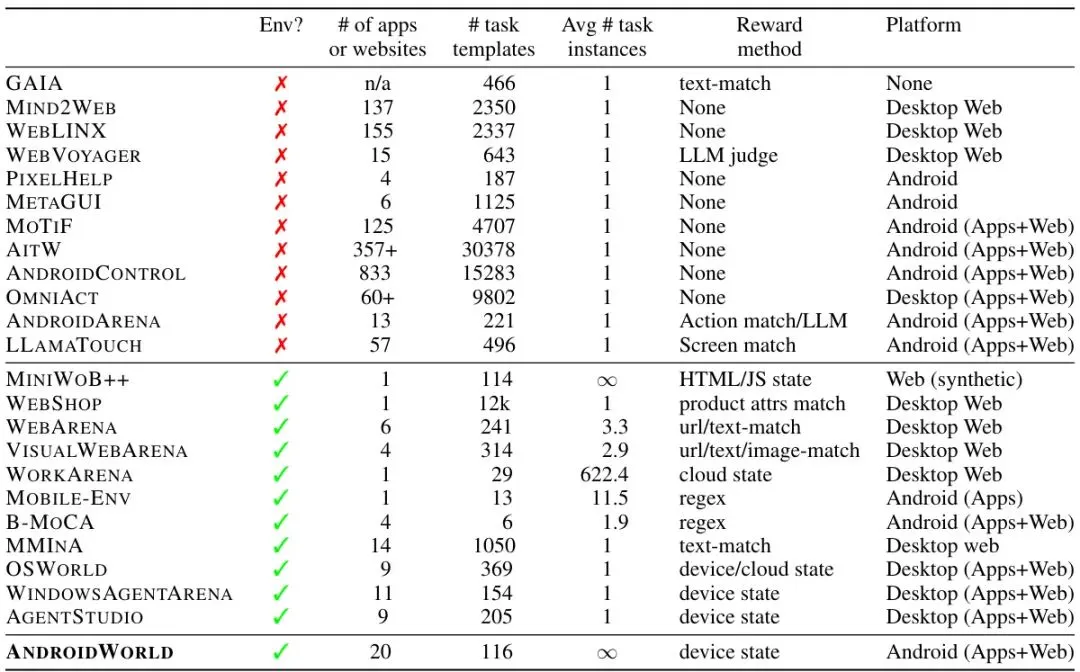
图片来源:arXivClaw 论文记录 · AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Agents
主表用于核对这篇论文的实验或评测边界:评测环境不提供命令编译机制。
可控环境让成功率可比较,却不决定执行架构
AndroidWorld 提供真实 Android 应用、任务和可复位环境,使纯视觉、脚本和混合系统可以在同一协议下比较。它解决的是评测可复现性,不直接回答如何减少视觉调用。
目标论文同时在 AndroidLab 的 138 个任务、9 个 App,以及 AndroidWorld 的 116 个任务、20 个 App 上评估。跨两个基准比只在自建 App 上有效更有说服力,但应用版本和任务分布仍有限。
4. 编译路线分成在线复用与离线建图
PreAct 编译一次成功轨迹,PhoneCLI 预先编译 App 命令
PreAct 在在线执行得到成功轨迹后,将其编译为可重用动作;适合重复同一类已成功任务。PhoneCLI 在用户任务到来前探索整个 App,建立语义屏幕地图,并为页面生成一个确定性命令。前者以任务轨迹为单位,后者以 App 屏幕和命令目录为单位。
两条路线并非简单前后代。PreAct 的编译来自真实在线成功,PhoneCLI 的覆盖来自离线探索;它们分别承担“任务复用”和“App 预编译”的成本。
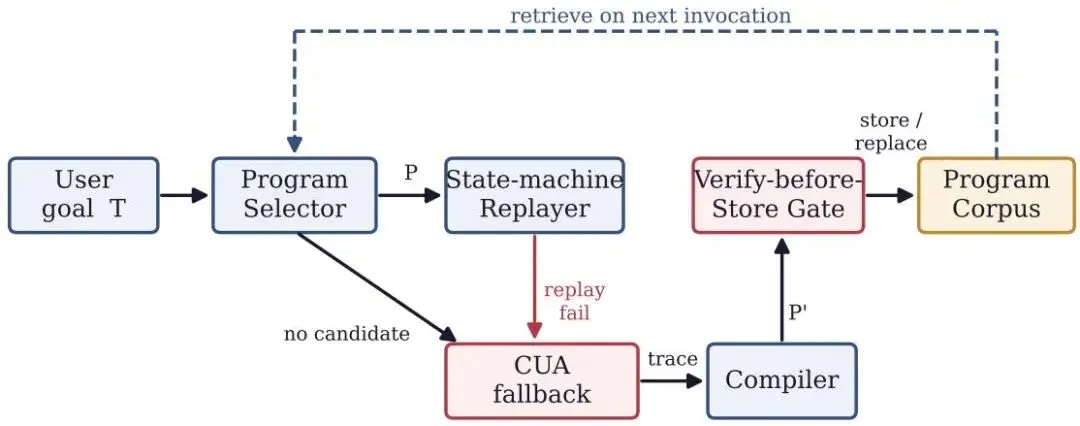
图片来源:arXivClaw 论文记录 · PreAct: Compiling Agentic Trajectories for Faster and Safer Reuse
主图用于核对这篇论文的机制或流程:从成功运行中抽取可执行轨迹。
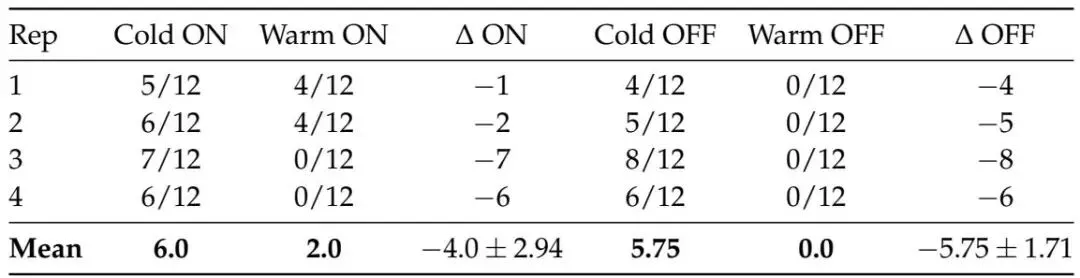
图片来源:arXivClaw 论文记录 · PreAct: Compiling Agentic Trajectories for Faster and Safer Reuse
主表用于核对这篇论文的实验或评测边界:必须先在线成功,覆盖以任务轨迹为单位。
5. 目标论文深读:PhoneCLI: Enabling Efficient and Generalizable Mobile GUI Agents through Offline App-Specific Command Compilation
它重新定义了什么问题
PhoneCLI 不把每次手机任务都当成新的视觉规划,而把高频 App 操作视为可以预编译、可校验的命令调用。在线 Agent 的主要工作变成选择命令、确认落点和处理目录之外的情况。
核心机制如何工作
离线阶段,系统在外部探索 App,构建语义地图,并为每个可操作屏幕生成一个确定性命令;不需要 App API、内部埋点或额外训练。在线阶段先识别起始状态和命令,再执行确定性重放;命令完成检查和落点检查不通过时,回退到视觉模型处理开放任务。
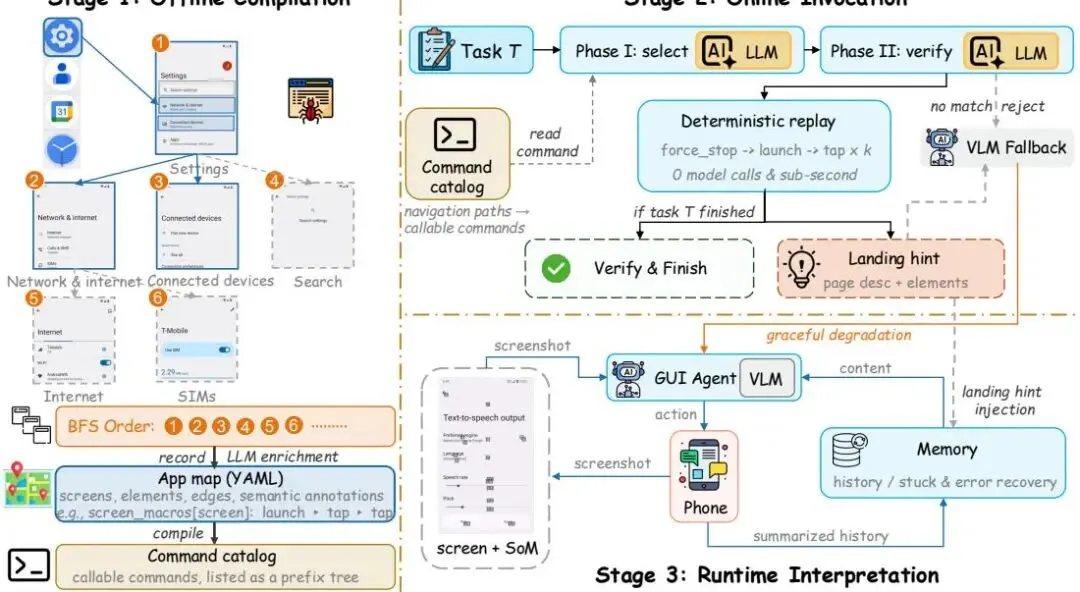
数据库主图。原图:arXivClaw 图像资源
主图中要看三道边界:命令目录是否有覆盖、当前屏幕是否匹配入口、执行后是否落到预期状态。PhoneCLI 的可靠性不是脚本本身,而是脚本前后的语义校验和回退。
最有说服力的实验
在 AndroidLab 上,Qwen3.7 Plus 纯 VLM 为 50.7%,只用地图为 55.1%,完整 PhoneCLI 为 63.0%;步骤数下降 11%,token 下降 14%。Kimi 的成功率从 68.8% 到 69.6%,效果增量较小但成本下降,说明基座越强时主要收益可能转向效率,而非成功率。
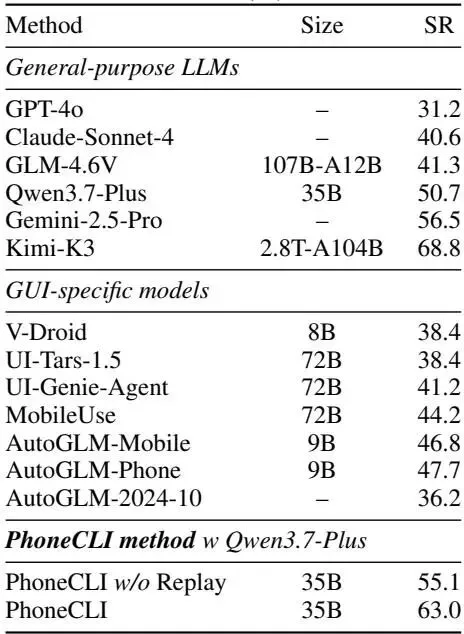
数据库主表。原表:arXivClaw 图像资源
主表中每行的模型、基准和任务数不同,绝对成功率只在同一行内可比。更接近机制证据的是消融:去掉语义增强降至 47.8%,去掉落点检查为 50.7%,去掉 hint 为 50.0%,去掉命令完成检查为 48.6%,而完整系统为 63.0%。“命令存在”不够;地图语义和落点校验各自贡献了收益。
成本与失败条件
确定性重放可以亚秒级完成并做到零在线 VLM 调用,但离线探索、地图维护和 App 更新后的重编译并非免费。地图规模呈倒 U:太小覆盖不足,太大则引入噪声和相似屏幕干扰。
PhoneCLI 可能在动态内容、A/B 界面、登录状态、弹窗和跨 App 跳转中失败。论文证明的是特定版本 App 和两个基准上的混合系统收益;当前材料无法确认长期维护成本,也没有量化 App 更新后多少命令会失效。
6. 当前争议与开放问题
App 更新后的维护成本多大? 当前没有版本迁移实验。需要界面更新前后命令失效率和重编译时间。缺口在材料,不影响已有的实验结论。 地图规模如何自动选择? 倒 U 结果表明覆盖与干扰同时存在。需要按屏幕可辨识度而非节点数做自适应剪枝。消融支持这一步,把握中等。 回退会不会抹掉效率收益? 动态内容越多,VLM 回退越频繁。需要按任务类型报告回退率、成功率和总 token。部署层面的结论还只是推断,把握中等。
7. 收束
PhoneCLI 给离线脚本补上的是语义入口、完成检查和可控回退。App 改版之后,这些校验能不能发现目录已经过期,决定它能否长期使用。
原文链接
AppAgent: Multimodal Agents as Smartphone Users AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Agents PreAct: Compiling Agentic Trajectories for Faster and Safer Reuse PhoneCLI: Enabling Efficient and Generalizable Mobile GUI Agents through Offline App-Specific Command Compilation