ARTICLE · 1123118
数字孪生,可能是AI药厂的终局!
数字孪生,可能是AI药厂的终局!研发用AI进行重头生成式创新,貌似有点子靠谱了;但生产过程控制中,AI可能更有作用,不过好像还没用起来。 生物制造跟重工业、互联网、软件不大一样,药厂面对的是高度动态、变量耦合、部分状态不可直接测量,而且必须对产品质量负责的复杂过程。 这么复杂,那恰好是AI要发挥能力的地方了~这就是今天要聊的数字孪生把生产过程变成可持续感知、持续建模、持续预测,并在受控边界内进行决策的系统。 01 生产自动化不难,难的是过程黑箱! 今天药厂的自动化毋庸置疑。反应器能自动控制温度、pH、溶氧和搅拌;补料泵按程序运行;下游层析按既定方法自动切换; 这些东西早就实现几十年了,但统统归属为硬件,还缺乏判断的大脑。 虽然自动化了,但是很多决定工艺结果的关键变量还是不能实时的测到。以单抗生产为例,温度、pH、溶氧能实时测,但细胞代谢状态、关键代谢物、蛋白表达状态,及糖基化谱、电荷变异体这类关键质量属性,就得离线或近线检测。 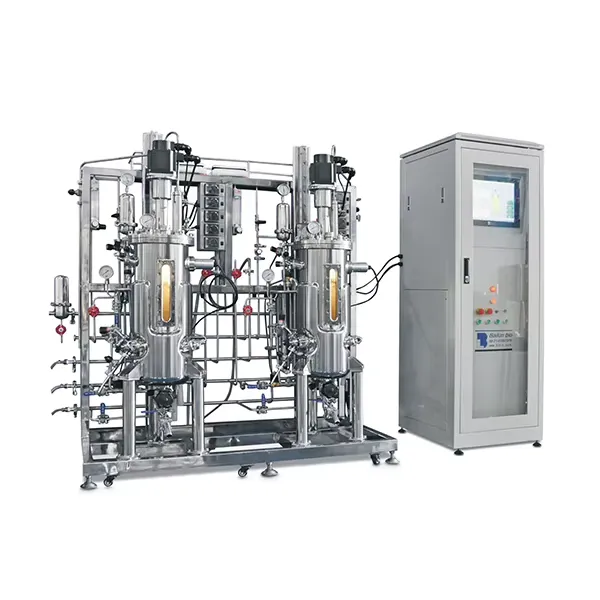
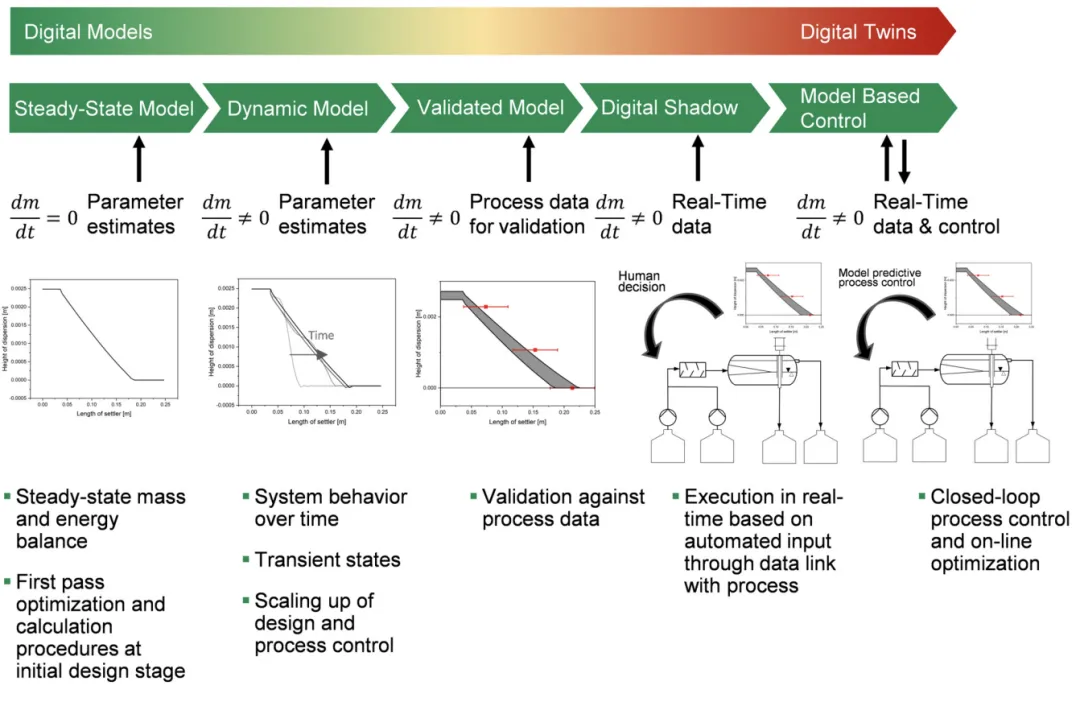
而检测本身有采样频率限制和时间延迟,而生物过程却一直在变化。许多CQA测量频率极低、甚至只在完成后才测,那就没法实时判断了。 所以很多时候看生产的状态,是用有限的传感器信号、历史经验和离线检测结果去推断。这也是数字孪生被误解的地方,很多人理解成把药厂复制到电脑里,甚至想象成模拟的3D工厂。 真正的数字孪生要解决如何从有限、异步、不同频率的数据中,尽可能准确地重建生产系统当前状态。它并不是让药厂更智能,而是让生产系统的黑匣子,变成可估计、可解释、可量化的实时状态。 02 过程模型,作为生产的一部分 过程建模就不是新鲜事儿了,动力学模型、质量守恒模型、层析模型和统计模型早就备用烂了。 但传统模型常是离线的,研发的时候输入一组参数、模型输出一个结果,而进入商业生产后依然按既定控制策略运行。也就是说研发和生产是两张皮儿~ 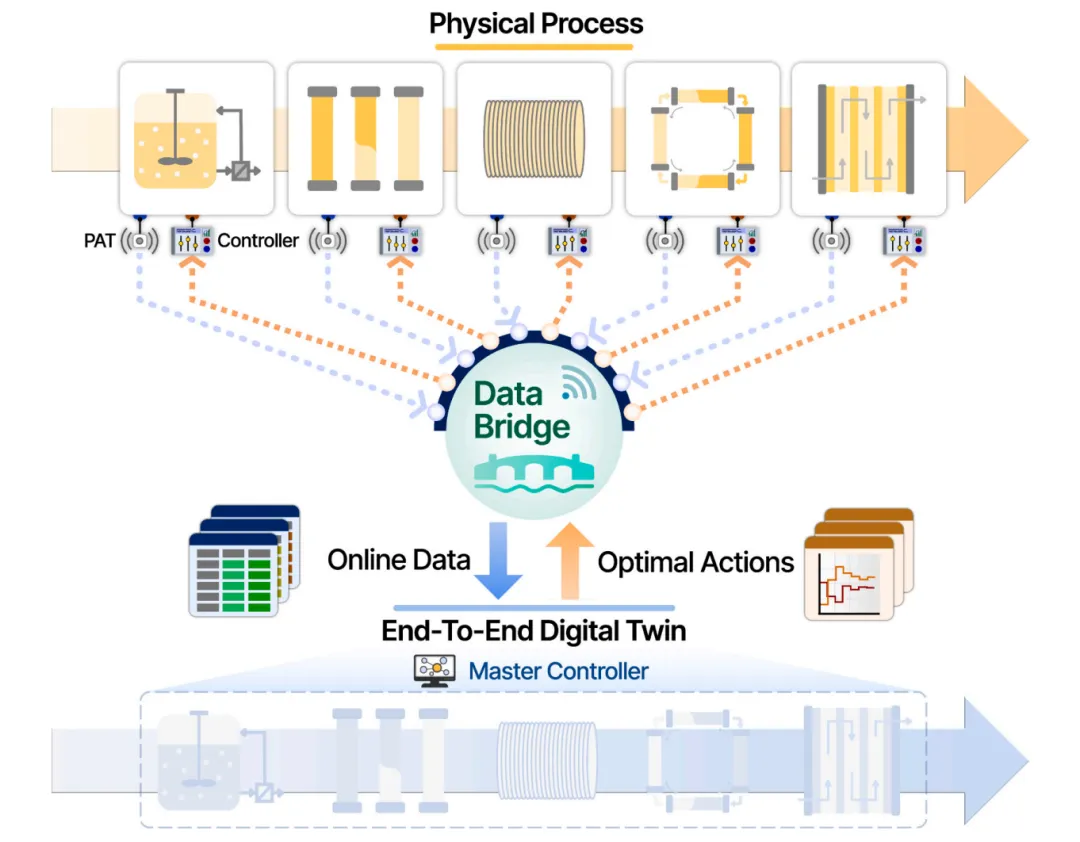
从另一角度,今天制造端AI大多属预测型应用,用历史数据预测滴度、细胞活率,提前识别工艺偏差等。 比如系统判断按当前状态,未来12小时乳酸可能快速上升。 预测模型给出这个结果,但工程师真正关心的是怎么办?是降低补料,还是改变温度,这些改变会不会影响别的? 这时,单纯的数据相关性已经不够。 于是,药厂智能化的逻辑就成了自动化控制 → 实时状态估计 → 模型预测 → 约束优化 → 闭环控制。 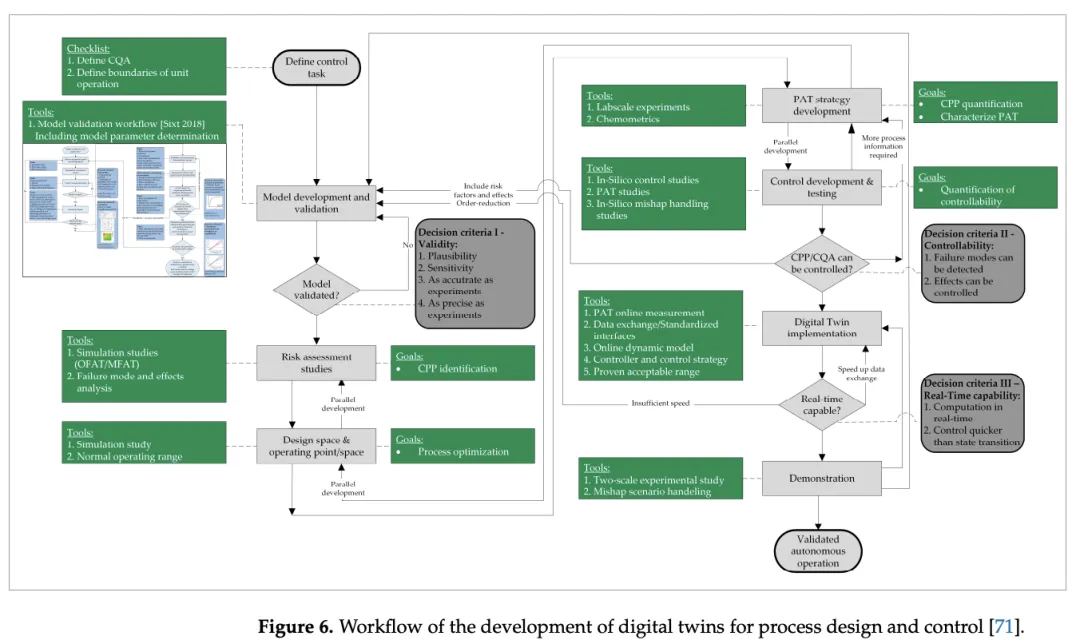
03 合规是数字孪生落地瓶颈 制药行业里模型一旦进入实际生产,就得按GMP要求来。 先要解决模型不稳定的问题。实际上模型是刚性不变的,而生物过程不是固定不变的;细胞培养存在阶段性代谢变化,Protein A树脂反复循环后结合容量也会逐渐衰减。 这意味着,模型开始时可能挺准,但到后面,客观生产环境变了,就未必准了。所以数字孪生必须能识别过程漂移、设备老化与阶段变化,判断模型什么时候超出有效范围。 FDA在2025年的AI指南草案已把这个问题单独命名为AI模型的生命周期可信度维护:模型可能因输入数据、环境或自身演化而性能漂移,需要持续监控其是否仍适用于原来的使用情境,并给出七步基于风险的可信度评估框架。 未来药企除了管理工艺版本、设备版本、分析方法版本之外,还要管理模型版本。 
数字孪生应被设计为控制策略中可审查的组件,而不是非正式的优化工具;它所用过程数据、模型版本、参数值、决策时施加的约束,必须可供运行后审查;模型更新应按ICH Q10的变更管理系统处理。 第三个是如果模型错了,系统怎么办? 如果传感器输入异常、状态估计失效怎么整?如果不停的自动执行那就扯淡了。必须能切回保守策略、或请求操作员介入——而不是继续执行一个无法确认的优化结果。 AI药厂不是系统永远自主,而是知道什么时候自主,什么时候必须停止。不应把智能理解为无论发生什么都坚持计算,这就很沙雕了~ 当然,监管是瓶颈也是梯子,可以帮助数字孪生不断的优化! 
FDA的监管线条挺清楚,2023年的《AI in Drug Manufacturing》讨论稿列出云数据管理、模型验证标准、持续学习系统等五大待解问题;2025年1月的指南草案给出七步框架;2025年1月定稿的先进制造技术(AMT)指定程序,为连续制造、PAT与AI驱动检测开辟正式通道;FRAME倡议则把端到端连续制造、分布式制造与AI列为四大优先技术。 
结语:必须承认,端到端数字孪生仍是昂贵且未完成的工程。 数字孪生对数据完整性的要求远高于普通分析应用,有研究发现67%的企业连自己的数据都不敢信、55%还在人工找数据。 端到端DTA的验证不仅要求每个单元孪生体准确,还要求单元间数据与模型接口的兼容性。再加上模型标定实验、预期操作范围内的验证、计算实现与周期性维护! 这个钱就花老鼻子了。 如果收益不足以覆盖全生命周期投入,再精密的控制也可能技术上吸引,但工业上不合理! 欢迎假期不停学习的读者老爷加入胖猫的知识星球~假期努力学习,收假立马进入搞钱状态,冲!冲!冲!
数字孪生不同的是模型与现实过程连接。它回答的是设备此刻处于什么状态、接下来要发生什么。
更进一步,多单元操作的孪生体可以连接成数字孪生聚合。上游培养、下游纯化制剂,各步骤不再各自优化,而是放进同一个端到端模型里。
CMC最容易做的就是局部最优。上游希望提高滴度,玩儿命的把表达量弄上去,但高浓度会增加下游纯化的压力;
如果每个工序都自己搞自己的,最后看每个工艺步骤都很牛,而整个工艺却拉了坨大的~
全流程控制,是数字孪生与普通AI预测模型最根本的差别。
把分散的能力连成一个系统,主控制器在孪生体中全局寻找最优解,再把给各本地控制器执行具体的指令。