ARTICLE · 1123755
把这一季拼起来:打包成插件,发给团队,外加一份能直接抄的清单
前十四集都在造。最后一集只做一件事:把这些东西从你一个人的电脑,搬到一整个团队。
这一季写完了。十五集,从「加一条规矩该加在哪」开始,到「出一堆东西怎么拼成一个能发出去的单元」结束。
我一开始并不打算写成连载。第一篇只是想把自己踩过的坑记下来,写到第三篇才发现,这十五集其实是一条被问题推着走的路线:每解决一件事,就暴露下一件。所以最后一篇不讲新概念,只做收尾——把这条路线说清楚,然后解决它最后卡住的那个地方。
那个地方是:只有你一个人在用。
一、十五集走完的这条弧
回头看,这条路线不是设计出来的,是走到哪儿卡住就往哪儿补。
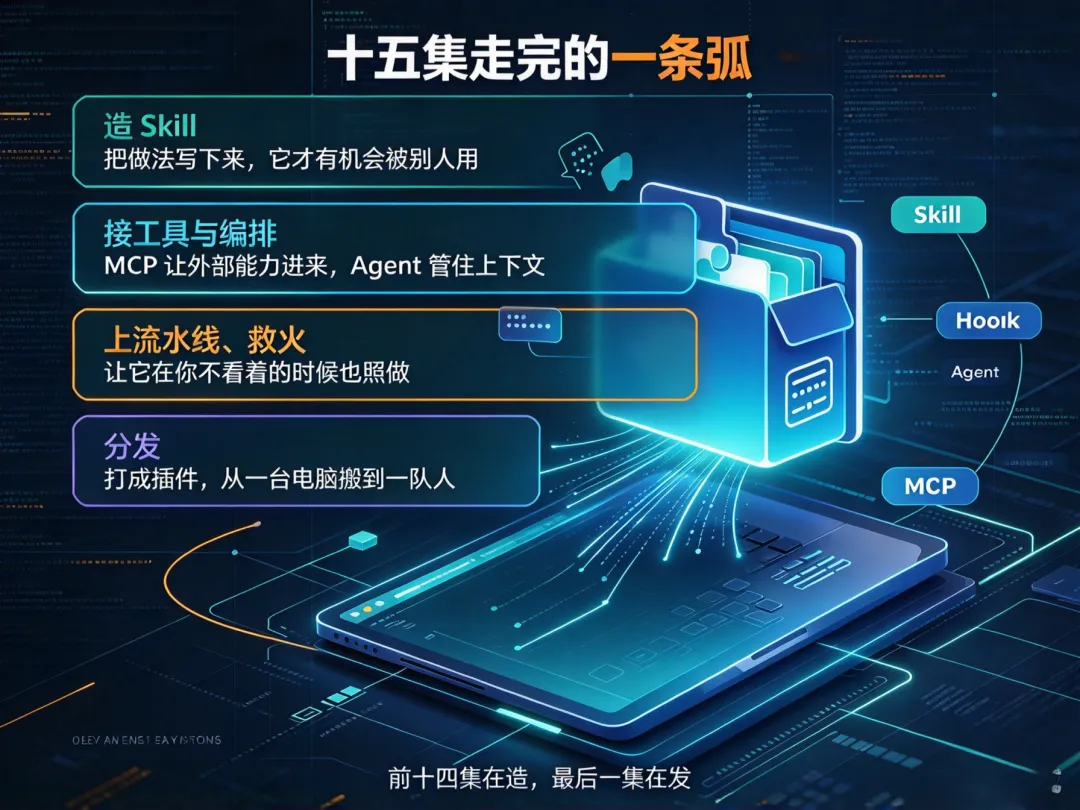
第一步是把做法写下来。 你脑子里那套流程,不写出来就只存在于你脑子里,写成 Skill 之后它才有机会被别人用。这一段的几集分别解决:四个扩展点各自的边界在哪、Skill 的两层加载省在哪、为什么 Claude 从来不用你写的技能。
第二步是让它够得着外面的东西。 需要的工具进不来,就写 MCP server;另一件同时暴露的事是它把自己撑爆了——你让它读三十个文件,那三十份正文全进你的对话窗口,而且从那一刻起每一轮都在为它付费。于是有了 Agent 和上下文编排。这一段解决的是:外部能力和独立上下文怎么进来,以及进来的东西怎么不互相污染。
第三步是让它在你不看着的时候也照做。 这件事只有做进流水线里才算数。配套的另一集是算账——你会突然发现,同一个人同一套做法,成本能差出好几倍。这一段解决的是:怎么接进 CI,怎么把花费看清楚。
第四步是救火。 一个东西用得越深,坏的方式就越多,而且报出来的错越来越不像错。这一集是把故障先分成装不上、连不上、跑不对、跑着跑着不对、花多了五层,再去对应的那一层找证据。
第五步就是你手上现在这个状态。 四个扩展点的边界清楚了,技能会写了,MCP 接上了,Agent 会拆了,流水线跑了,故障能查了。这些东西有一个共同点:它们全都只在你这一台机器上。
同事的机器上没有你那个技能,没有你那个 hook,没有你那份 MCP 配置。你上周调了两个晚上才调通的东西,对他们来说等于零。你在群里发一句「我这里有个脚本挺好用的」,这句话传递的信息量,约等于没有。
所以最后一集只做一件事:打包,发出去。
二、为什么「我讲一遍」一定会走样
先得说清楚为什么要打包,因为很多人真的觉得没必要。
一个非常常见的想法是:我把流程写成文档,把仓库地址发到群里,谁要用谁自己照着做。这个办法在三个人的团队里能撑一个月,在十个人的团队里撑不过一个季度。
原因不是同事懒。是文档这东西天生会走样,而且走样的方式可以数出来。
第一层走样,版本漂移。 文档没有版本号。你九月改了一遍流程,文档还是八月那份,新人照着旧文档做,做出来的东西跟你手上那份不是一回事。更麻烦的是,这种情况下没人会觉得自己错了——他们都觉得自己是照文档做的。
第二层走样,复制粘贴。 同一个技能在五个人的机器上有五份拷贝,名字一样、内容不一样。出了问题时,你在自己机器上复现得很顺,因为你的那份是对的。这一层走样的代价是:问题变得不可复现,而不可复现的问题,处理成本是能复现的问题的好几倍。
第三层走样,环境差异。 你机器上那个路径、那个工具、那个环境变量,别人机器上不一定有。文档写的是「该怎么想」,它写不了「该怎么装」。这句话我写在这里,是因为它就是这个问题的核心。
还有更深的一层:文档不会自我验证。
前面几集讲过好几个这种坑。hook 的匹配器写成数组会让整份设置文件被拒,里面的 hook 全部不生效,而且它不报错;MCP 配置里用相对路径,在你这儿能起,换个目录启动就变成零工具,但界面还显示已连接。这类错误在写的时候一个都不会暴露,它们只在别人的机器上发作,而你不在现场。
所以你缺的不是一份更详细的文档。你缺的是一个可以被安装的单元:装上去就是同一个版本、同一份文件、同一套行为。这正好是插件要解决的事。官方文档在讲这件事的时候,用的是一张很朴素的对比表:放在项目 .claude/ 目录里的那套叫独立配置,只在这一个项目里有效,适合个人工作流、项目定制和快速试验;打包成插件之后,才可以和同事共享、可以发给社区、可以做版本发布、可以跨项目复用。
官方给的建议也是这个顺序:先在 .claude/ 里快速迭代,等你觉得该共享了,再转成插件。
三、插件是什么:一个能被安装的单元
插件是什么,官方给的定义很朴素:一个自包含的目录,里面装着技能、子代理、钩子、MCP server 这些组件,可以跨项目和团队共享。
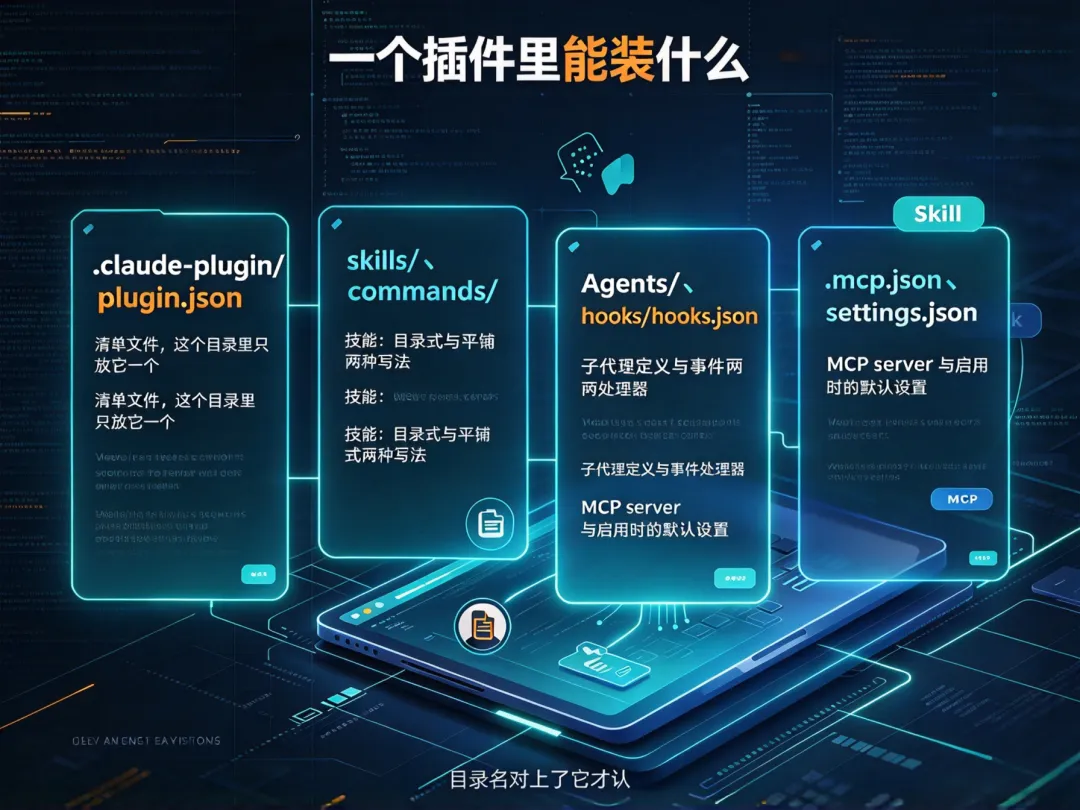
它不是压缩包,不是 npm 包,不是一份配置文件。它就是一个目录,有约定的内部结构,可以被安装、被启用、被更新、被卸载。
它里面能装的东西比你想象的要多。官方列出来的默认位置有这么几类:
skills/—— 每个技能一个文件夹,里面是 SKILL.mdcommands/—— 平铺的 Markdown 文件,也是技能,但这是老写法,官方明确说新插件请用 skills/agents/—— 子代理定义 hooks/hooks.json—— 事件处理器 .mcp.json—— MCP server 配置 .lsp.json—— 代码智能用的语言服务器配置 monitors/monitors.json—— 后台监视器,插件启用时自动起 bin/—— 会被加进 Bash 工具 PATH 的可执行文件 插件根的 settings.json—— 插件启用时的默认设置,但它只支持两个键
还有一个差别很实际,容易忽略:独立配置里的技能就是一个斜杠加名字,插件里的技能永远带一个前缀,形如 插件名:技能名。官方专门解释了原因——防止多个插件里有重名技能互相打架。所以你在插件里叫 hello 的技能,实际调用名是 插件名:hello。子代理也一样,插件名叫 plugin-dev 的插件里那个 agent-creator,在界面上显示成 plugin-dev:agent-creator。
清单文件叫 plugin.json,放在插件根目录下的 .claude-plugin/ 目录里。这里有个坑,官方是专门用一段警告标出来的:
除了这个清单文件,其他目录一律放在插件根,不能塞进 .claude-plugin/ 里面。
也就是说 skills/、agents/、hooks/ 这些必须和 .claude-plugin/ 平级。塞进去的后果不是报错,是技能不出现——你在 skills not appearing 那条常见问题里会看到它,原因那一栏写的就是「目录结构不对」。
还有一条也很容易踩:插件根目录下放一个 CLAUDE.md,它不会被当成项目上下文加载。 官方对这个说得很直接:插件是通过技能、子代理和钩子来贡献内容的,不是通过 CLAUDE.md。你想让一段说明进上下文,就把它做成技能——这句话在最后一节还会用上。
从独立配置转成插件,官方的迁移步骤一共四步,简单到有点意外:建目录、建清单文件、把 .claude/commands、.claude/agents、.claude/skills 整个拷过去、再把设置文件里的 hooks 对象原样搬到 hooks/hooks.json。格式是一样的,一个字都不用改,因为 hook 配置在两边的结构完全相同。
但迁移之后有一件事必须做:把 .claude/ 里的原件删掉。 官方专门提示了这一点,原因是项目级和用户级的同名子代理会覆盖插件里的子代理,你不删原件,插件里那份就永远不生效。技能那侧的情况反过来——因为插件技能带前缀,所以原版 /技能名 和插件版 /插件名:技能名 会同时存在,不会互相覆盖,你得自己决定留哪个。
四、清单文件与目录:写对名字,放对位置
现在进到具体的东西。清单文件的路径是插件根下的 .claude-plugin/plugin.json。
它里面唯一必填的字段是 name。这个 name 不只是个标识,它同时是组件命名空间的前缀——改 name 等于改掉所有组件的调用名,这一点要提前想好,别等发出去再改。
常见字段还有 description、version、author、homepage、repository、license、keywords。
有一条规则特别实用:认不出来的字段会被忽略,不会让插件加载失败。 官方的说法是你可以把别的工具链的元数据一起放进去,比如让它同时充当某个编辑器的扩展清单。这个设计很省事——你不用为了加一个字段去做两遍清单。
但字段类型写错就是另一回事了。官方把处理方式分成两类:大部分字段类型不对会直接导致加载失败,比如 keywords 你写成一个字符串而不是数组;experimental 和 metadata 比较宽容,类型不对只是被忽略并报个警告。
写完之后自己先跑一遍校验,claude plugin validate 会同时检查清单文件、hooks/hooks.json,还有技能和子代理的头部语法;会话里也有 /plugin validate 这个等价写法。它还有一个严格模式,加上之后连「认不出来的字段」都会报出来。严格模式适合放在流水线里当一道门:因为这种拼写错误在运行时不会拦住你,只有这道门能拦住。
版本这件事值得单独说,因为它是插件分发的核心机制。
Claude Code 用插件的版本号当缓存键,判断有没有新版本可以更新。 你在清单里写了 version,用户就只在你手动改这个字段的时候才会拿到更新;你推了新代码但没改版本号,更新检查会直接告诉你已经是最新的。所以发版就得改版本号,这不是习惯问题,是机制。
如果你干脆不写 version,它会按顺序退回去找别的来源:先是市场条目里的 version 字段,然后是源码的 git 提交号,再然后是压缩包的摘要,都没有就是未知。对大多数团队仓库来说,退到提交号其实挺好用——每次提交都算一个新版本,不用记得手动加一。
路径规则也要记两条:所有路径都必须是相对插件根的相对路径,并且以 ./ 开头。有一处例外:skills 字段还接受 .,如果你把技能直接放在插件根,可以用它。另外,多个路径可以写成数组。
脚本和配置里不要写死路径,官方给了三个变量:
${CLAUDE_PLUGIN_ROOT}—— 插件的安装目录 ${CLAUDE_PLUGIN_DATA}—— 一个能跨版本升级活下来的持久目录,装依赖、放缓存用它 ${CLAUDE_PROJECT_DIR}—— 项目根目录
这三个变量会作为环境变量导出给 hook 进程和 MCP、LSP 的子进程。这里有个细节值得知道:${CLAUDE_PLUGIN_ROOT} 在插件更新之后会变,旧版本目录只是暂时留着,所以不要往里面写状态——要写状态就写进 CLAUDE_PLUGIN_DATA。
开发和测试不需要每次都走一遍安装流程。启动时加上 --plugin-dir,就能把本地这个插件目录直接挂上;它甚至也接受一个压缩包。挂上之后,改动完运行一次 /reload-plugins,就能在不重启会话的情况下加载进去——官方说这个重载会一起刷新插件、技能、子代理、钩子、插件的 MCP server 和 LSP server。这个参数可以连续传多个,一次挂好几个插件。
最后说一句缓存,因为它解释了很多人遇到的怪事:插件不是原地使用的。通过市场装的插件会被拷贝到本地的插件缓存目录里,按市场和插件分组,每个版本一个独立目录,用解析出来的版本号命名。所以插件里不要用 ../shared-utils 这种指到目录外面的路径,拷过去就找不到了——跨插件共享文件,官方建议用符号链接。
五、marketplace:让同事一条命令装上
插件做完了,下一步是让同事能装。这一步的关键词是 marketplace,中文一般叫插件市场。
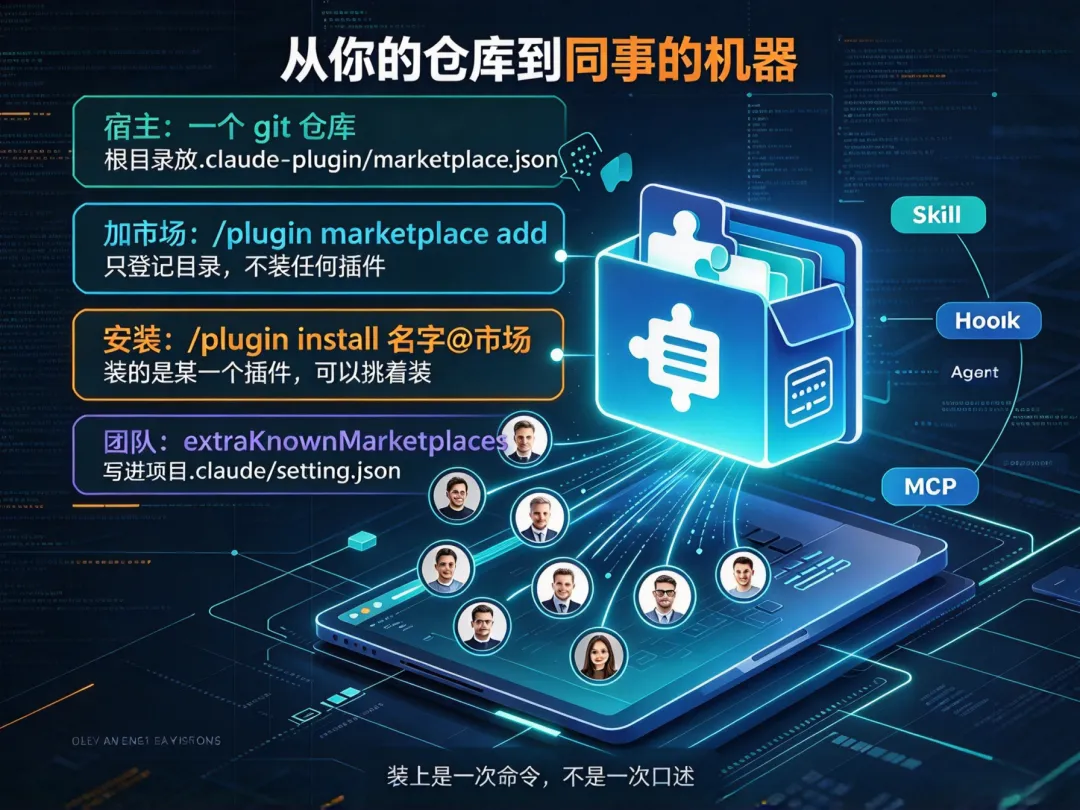
它的本质比名字小得多:一个 git 仓库,根目录下的 .claude-plugin/marketplace.json 里列出这个仓库里有哪些插件。
这个文件有三个必填部分:市场的名字、维护者信息(名字必填,邮箱和网址可选)、以及一个插件列表。列表里每条插件最少要给两样东西:名字,和它从哪儿来。 来源可以是一个相对路径(插件就在这个仓库里),也可以是一个 github 仓库、一个 url、一个 npm 包,或者一个压缩包。
市场的名字有个硬限制:官方保留了一批名字,不允许第三方使用。而且这个检查不是只在添加的时候做一次,每次加载市场都会重新检查——一个用保留名注册过的市场会直接停止加载。被保留的有官方那两个市场的名字,还有一串明显是官方占位的名字。所以给自己的市场起名时,别往「官方」那个方向靠,撞上不是警告,是加载失败。
使用流程只有两步,官方在概念页上就是分两步讲的:
- 加市场。
跑 /plugin marketplace add,这一步只是把这个目录登记进 Claude Code,让你能浏览里面有什么,不会安装任何插件。 - 装插件。
跑 /plugin install 插件名@市场名,从目录里挑某一个装上。
这两步分开的设计是有道理的:加市场是「我知道有这么个书单」,装插件是「我把这本书拿回家」。一个市场里可能有二十个插件,你只想要其中两个。
更新也是两步分开的:仓库那边推新版本之后,用户先刷新本地那份市场目录,再更新插件。
团队落地有一个很省事的地方,值得单独讲。官方的说法是,团队管理员可以把市场配置写进项目的 .claude/settings.json,同事信任这个项目文件夹之后,Claude Code 会自动把这个市场加上,不再多问一次。配置里要写的键是 extraKnownMarketplaces。
但这里有一条必须知道的限制:自动加市场不等于自动装插件。 官方写得很明确,如果插件来自外部来源(比如一个 github 仓库或者 npm 包),即使项目设置里已经启用了这个插件,它也不会加载,直到团队成员自己装一次;在那之前,Claude Code 会把插件报成「未安装」,并给出该跑的那条安装命令。
这个限制其实是对的:插件和市场的权限级别很高,它能在你机器上以你的权限执行任意代码,所以「跟着仓库自动装一个外部来源的东西」这件事不该发生。
另外,安装是有范围的,官方分了四档:装到用户级是所有项目都能用,装到项目级才是跟着仓库走的那份团队配置,本地级是写进本地设置文件、不进版本控制的那份,还有只读的托管级。想保证团队版本一致,就装项目级——这一档才会进仓库,才会被同事拉到。
官方自己维护两个公开市场:一个是 Anthropic 策展的官方市场,Claude Code 首次交互式启动时会自动注册;另一个是社区市场,需要手动加,第三方插件通过审核后会落到那里。这两个名字都是被保留的,你自己的市场不能用。私有仓库也是支持的,官方在讲私有市场的时候专门提了一句:背景自动更新默认会禁用 git 凭证助手,所以私有仓库的自动更新可能不稳定,手动更新没问题。
六、团队落地的三步,和不该打进去的东西
到这一步,知识齐了。但如果直接照着做,很多人会从第三步开始——先做包装,再回头补内容。这是最容易返工的顺序。
我建议的顺序是三步,而且这三步的分量是递减的。
第一步,先把规矩写下来。 这个项目的技术栈是什么、目录怎么组织、哪些命名不能改、哪些库不许引、这个领域里哪两个词是必须区分的两个东西。这些都是每一轮对话都要让 Claude 知道的内容,写进项目的 CLAUDE.md。这一步不需要任何插件,不需要谁先点头,不需要写代码,当天就能生效。
第二步,把必须发生的事情做成 hook。 格式化、拦下危险命令、写完文件之后跑一次检查——这类事不能指望模型每次都记得。前面有一集专门讲过这个区别:CLAUDE.md 和自动记忆都是上下文,不是强制配置;想让某个动作无论如何都被拦住,只能用事件触发的 hook。哪些事属于「必须发生」,这一步会筛出来,而且筛出来的过程本身就有价值——你会发现很多你以为是规矩的东西,其实是提醒。
第三步才是打包成插件。 因为只有前两步稳定运行了一段时间之后,你才知道哪些东西真的值得发出去。一个还在天天改的技能,打包出去只会制造版本噪音。
这个顺序反过来的话,你会先花三天做包装,再回来补规矩。而且更糟的是,你会把还没稳定的东西发出去,同事那边会遇到一堆你已经改过的问题。
然后是不该打进去的东西,这几样是有明确后果的。
密钥和令牌不要硬编码。 这是最严重的一条。官方的做法是在清单里声明用户配置项,然后给敏感的那个加上敏感标记——启用插件的时候,Claude Code 会弹出来让用户自己填,敏感值不进设置文件,而是存进安全存储。这些值可以在 MCP 配置、LSP 配置和 hook 命令里用变量引用。
个人偏好不要打进去。 你喜欢什么回复风格、你习惯用哪几个斜杠命令、你个人的工作流——这些放用户级配置。插件是给一群人用的,它不该替所有人做个人决定。
机器专属的绝对路径不要打进去。 理由在上一节说过:插件会被拷进缓存目录,你机器上的绝对路径在别人那儿不存在。要引用插件自己的文件,用插件根那个变量拼。
顺带说两个插件自身的边界,是官方明确写了的:插件的 settings.json 只支持两个键,一个是把插件里的某个子代理设成主线程,另一个是设置子代理状态行,其他键会被静默忽略;而且出于安全原因,插件自带的子代理不支持 hooks、MCP server 和权限模式这几项配置。你写进去不会报错,只会没反应——这种「静默忽略」是最值得记住的失败方式。
七、一份能直接抄的清单,和你该从哪一个开始
最后把四个扩展点各放什么,压成一张能直接抄的表。
CLAUDE.md | ||
skills/ | ||
hooks/ | ||
agents/ | ||
.mcp.json | ||
至于该从哪一个开始,我的建议是按这个顺序,而且可以随时停:
- 写
CLAUDE.md。一个文件,零配置,当天生效。如果只做一件事,做这件。 - 选一个 hook。
挑一件「每次都靠人提醒」的事,把它做成事件触发。一件就够,不要一次写五个。 - 把一个技能写清楚。
尤其是那些你想教给别人的流程,而不是你自己用的操作。 - 只在你真的需要独立上下文时才拆 agent。
前面有一集讲过什么时候不该拆:任务本身很小、需要来回确认、答案就在一个文件里——这三种情况拆出去只会更慢。 - 最后才考虑插件。
等你发现同一个技能在不止一个人手上被复制了第二遍,就是打包的时候了。
这就是整季的落点。它其实一直在讲同一件事:这四个扩展点不是四个平行的选项,它们各自对应一种不同的失败模式。 CLAUDE.md 防的是记不住,Skill 防的是上下文被撑爆,Hook 防的是没做到,Subagent 防的是中间结果污染。而插件防的是最后一种:它只防「只有你一个人在用」。
十五集下来,你现在手上有什么?一份知道什么时候该用哪个扩展点的判断力;一个能写、能触发、能验证的技能;一条接进流水线的路径;一套五层的排障顺序;还有这一篇的收尾——一个能被同事一条命令装上的插件,和一份四个扩展点各放什么的清单。这些东西不需要你全部用上,它们的作用是让你在遇到一件事的时候,知道该把它放到哪一行。
说一个我踩了很久的坑。 我第一次把团队的技能打包成插件的时候,.claude-plugin/ 里面除了清单文件还塞了 skills/,结果装上去技能一个都不出现,但插件列表里显示它加载成功了。我查了快一个小时,最后是官方那条「技能不出现」的常见问题里,原因那栏写着一句「目录结构不对」。你打算先把哪一个搬进团队? 是那条每轮都要提醒的规矩,还是那个每个人手上都有一份拷贝的技能?说一个,我看看大家卡的地方是不是同一个——大概率不是,因为十五篇下来,我发现每个人卡住的都是不同的那一层。
这一季到这里就结束了,十五篇全部写完。 它最后交付给你的不是十五篇教程,是十五篇之后你手上那套东西:能判断、能写、能跑、能查、能发。下一季我想换个方向——不再讲怎么把东西做出来,讲怎么让它在你不在的时候不出事:跑在更长的时间尺度上、跑在别人的机器上、跑在你根本看不到的地方,那时候你需要的判断方式跟现在完全不一样。具体什么时候开始,等我先把这一季的清单自己用一遍,用出问题了再说。