ARTICLE · 1125549
会算,不等于懂:AI 进入岩石力学,需要补上哪一课?
会算,不等于懂:AI 进入岩石力学,需要补上哪一课?一AI 在岩石力学,已经能做什么 先别急着谈困难。公平地说,AI 在这门学科里已经证明了自己的价值,而且价值不小。 1.识别与分类 岩性智能识别、裂隙网络的图像分割、CT 扫描中把矿物、孔隙、裂缝这三种成分分开,这些原本高度依赖肉眼与经验判读的工作,如今交给卷积网络(一种擅长“看图”的深度学习模型)往往又快又稳。钻孔电视里的节理一张张划过去,过去要人盯着屏幕数上半天,现在模型几秒钟就能给出统计。三维扫描得到的一大片密集坐标点(俗称“点云”),里面岩体表面的起伏、结构面的倾斜方向(行话叫“产状”),也能由算法自动提取。这类任务有个共同点:模式明确、样本可标注(每份数据都能标出正确答案)、评价可量化,正好落在机器学习的舒适区里。 2.定位与反演 微震事件的震源定位、破裂源的三维成像、由表面位移反推内部应力场,本质上都是“从结果找原因”的反问题,而这正是机器学习擅长的领域。地下看不见、摸不着,工程师永远在跟看不见的东西打交道:知道巷道表面的位移,就想知道里面的应力怎么分布;听到一声微震,就想知道破裂发生在哪个位置。反问题没有现成的公式能直接算出答案,而且输入数据稍有一点波动,算出来的结果就可能差出很远——数学上把这类问题叫作“不适定”。传统方法在这些地方束手束脚,数据驱动反而能走出一条靠数据摸索的路子。 3.预测与评估 基于随钻测量参数(也就是钻进过程中实时采到的钻速、扭矩、转速等)预测围岩强度、根据监测数据的变化趋势预测变形走向、对围岩稳定性做分级预警,这一类应用已经从论文走向工程现场的试点。它的意义不只是算得准,更是把过去散落在各个班组的零散记录,第一次连成了一条可以预判的时间线。当一条巷道每天的收敛量(断面收缩变形量)、锚杆应力、微震频次都被模型串起来,工程师看到的不再是孤立的数字,而是一个正在演进的状态。 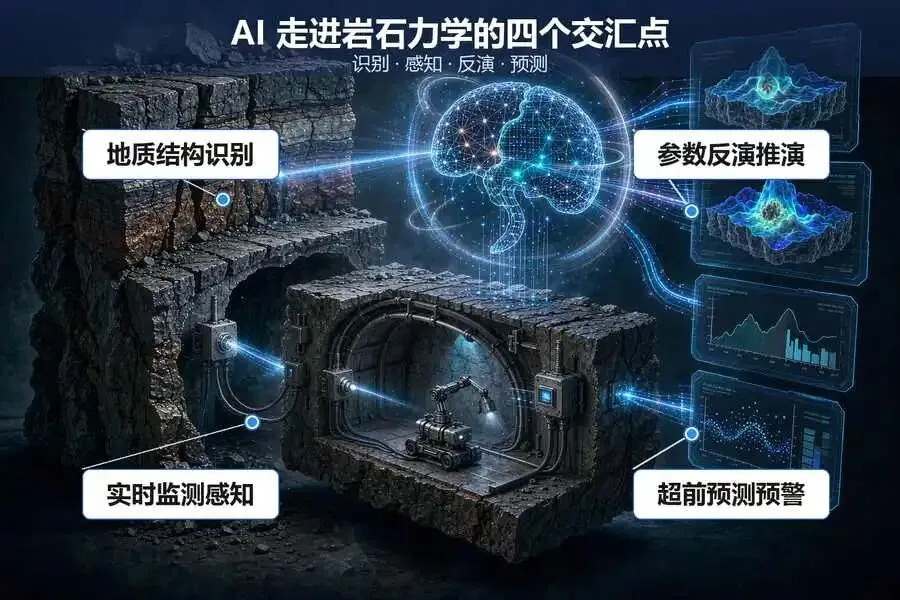
图1AI 在岩石力学中的三类典型应用 4.三类应用的共同意义 识别、反演、预测这三件事共同证明了一点:AI 处理岩石力学中那些模糊、非线性、变量又多又互相纠缠的信息,是有效的。它把过去需要专家反复判读的工作,变成了可批量、可复现的流程,也让那些沉在服务器里的海量监测数据第一次有了被用起来的可能。 5.局限 但能算和能用之间,还隔着一道不窄的沟。互联网公司可以容忍推荐系统偶尔推错一条视频,地下工程却容不下一次误判。地下工程不是互联网,它有自己的脾气,给 AI 准备的也不是红利,而是一道道考题。下一节,我们就把这四道坎摆出来。 二地下工程给 AI 出的四道坎 如果只谈能力,故事是圆满的。可一旦把模型放到真实巷道里,四道坎会依次出现。它们不是工程细节,而是数据驱动方法在这门学科里绕不开的固有难题。 1.第一道坎:数据的“贫富差距” AI 在很多领域的高歌猛进,建立在一个前提上:数据近乎免费、取之不尽。而地下工程恰恰相反。 更本质的差别在数据的性质上。互联网文本是人类已经消化过的二次总结,语病、冗余都被人处理过,规律就藏在语义里;工程数据是一手的物理测量,带着单位、带着时间戳、带着前因后果,规律藏在物理过程里,噪声也藏在物理过程里。一座矿井的原位地应力实测,靠钻孔应力解除这种费时费钱的办法:打孔、埋探头,再从岩体回弹的那点变形里反推出原本的受力;一次真三轴全过程试验,要取芯、制样,在大型设备上让岩样在三个方向同时受压,一直压到破坏为止。它们的成本远高于一条网络数据,而且不可重来:你没法为了凑样本,把一座矿重新采一遍。 于是出现了一种奇特的“贫富差距”:在数据充足的世界里,AI 是挑食的富翁;到了地下工程,它成了赤贫户,还要面对传感器布设稀疏、仪器型号不一、长期监测中数据缺一块少一块、读数还会慢慢跑偏(行话叫“漂移”)这些现实。数据少只是第一层,数据贵、数据脏、数据不可复现,才是更难的那一层。 AI 在别的领域是数据太多、挑着用,在这里是数据太少、不够用。 2.第二道坎:失稳是“长尾事件” 先说说什么叫“长尾事件”。把数据画成一条分布曲线,绝大多数样本都挤在中间,只有极少数极端情况被甩到最边上,像一条被拉得又细又长的尾巴——这类罕见却关键的情况,就被称作“长尾事件”。围岩失稳正是如此:整条巷道在绝大多数时间里安安静静,真正出事故——巷帮岩块剥落(片帮)、顶板垮落(冒顶)、煤岩体突然猛烈破坏(冲击地压)——的时刻少之又少。落到数据上,就是成千上万条“稳定”样本里,只夹着零星几条“失稳”样本,两边数量极其悬殊。 问题在于,模型训练时盯住的目标是整体误差最小,它会本能地偏向数量最多的那一类,也就是“稳定”。一个准确率看起来很漂亮的模型,可能把绝大多数稳定样本都判对了,却一次高危都没抓到——因为漏掉那几十条失稳样本,对整体准确率的影响微乎其微。可对工程来说,抓不到的那一次就是全部:一次漏报的代价,远大于一百次正确的稳定判断。 所以在岩石力学里,不能只盯着“准确率”一个指标。工程更在乎的是:那几条少得可怜的失稳样本,模型有没有认出来。怎么让模型“怕漏报”,是这门学科独有的命题,也是通用 AI 方法默认不会考虑的。 3.第三道坎:相关很有用,但它有边界 先说一句公道话:相关不是坏东西。数据驱动方法能起作用,靠的正是从大量样本里找出变量之间的统计关联,相关是模型的出发点,也是我们做围岩稳定性评估时最先抓住的东西,没有它,后面的工作无从谈起。问题在于,相关只回答了“谁和谁一起变”,回答不了“为什么会一起变”。只要样本里两个量总是一起变化,模型就会把它们绑在一起,至于背后有没有力学道理,它并不关心。 由此带来一个后果:模型完全可能在一批没见过的数据(所谓“测试集”)上表现优异,却给出一个与岩石力学常识相悖的判断。举个通俗的例子:夏天冰淇淋销量和溺水人数高度正相关,但谁都知道吃冰淇淋不会导致溺水,真正的原因是“天热”,它同时推高了两者。岩体里藏着同一类陷阱:某个位移指标和温度都随季节起伏,模型就可能把“温度”误当成“失稳前兆”。换句话说,相关本身是真实的,可被相关牵出的那根线未必指向破坏的机理。这种“看着有关、其实两回事”的假关联,就叫“伪相关”。只要训练数据里恰好藏着它,模型就会老老实实学错。 这也解释了为什么我们对相关的态度不是回避,而是追问。既然相关是模型的入口,要做的事就不是把相关扔掉,而是给它加一道筛子:留下来的,必须能讲出力学道理;讲不出来的,再高的相关系数也只能先挂起来。一个在测试集上表现优异的模型,如果它的判断讲不出力学道理,工程师就不敢把它写进方案。 说到底,黑箱不是原罪——它指的是那种给得出答案、却说不清中间过程的模型。许多成熟的工程方法同样不“透明”。但在事关安全的地方,无法解释的结论等于无法承担的责任。当模型说“这一段危险”,现场的人需要知道它凭什么这么说,否则再高的分数也只是悬在头顶的数字。 4.第四道坎:场景不可复刻 一块岩样的破坏过程无法严格重演,一座矿井的地质条件与开采工艺,也无法在另一座矿复刻。更麻烦的是,地下岩体本身就极不均匀(行话叫“非均质性”):同一座矿,相隔几十米,岩性、节理、地应力就可能天差地别。数据因此天然带着强烈的“地方印记”。 于是最常见的尴尬是:模型在自己的数据集上表现良好,换个工作面、换个煤层,性能就明显下滑。这种“换个地方还灵不灵”的本事,有个专有说法叫“泛化能力”,它是数据驱动方法在地下工程最难跨过的一道门槛。这也解释了为什么很多“在某矿准确率很高”的成果,换一个现场就水土不服——它学到的可能只是那一座矿的局部特征,而不是普遍的力学规律。 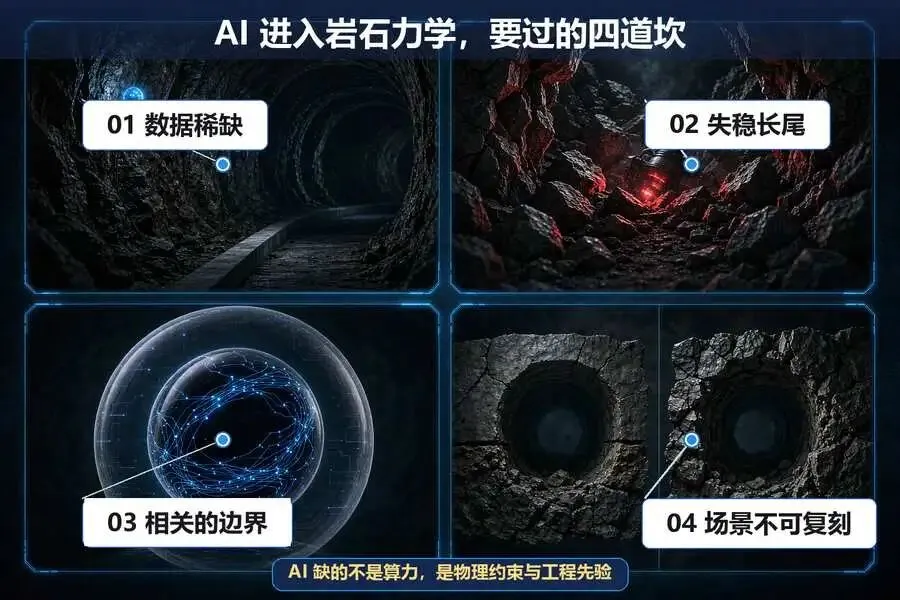
图2地下工程给 AI 设置的四道坎 三数据 + 力学 + 经验 那么,这堂常识课怎么补?数字岩石力学给出的框架,恰好正面回应了上一节的每一道坎。 1.学科主张 数字岩石力学将数字化技术与岩石力学理论进行底层融合,以不做简化地解决复杂地下工程问题为根本任务[1]。它要融合的不是两样东西,而是三样:数据规律、力学知识、工程经验。 这个“三合一”的主张听起来朴素,落点却准:数据补上了力学的“算不全”,力学约束了数据的“学跑偏”,经验则填上了前两者都够不着的“现场直觉”。三者合起来,正好把第二节那四道坎逐一顶了回去。 2.数据、力学与经验各自补上了什么 力学,告诉模型“什么不可能”。它提供约束与边界,把物理上不成立的解答挡在外面:一个违背平衡方程、违背强度准则的预测,再符合统计规律也通不过。这正好接上了第三道坎。力学不否定相关,它的作用是给相关加一道筛选:讲得出力学道理的关联留下,讲不通的假关联剔除出去。 经验,告诉模型“通常先发生什么”。几十年积累的工程判断是先验:哪种地质构造附近容易出问题、哪个开挖阶段应力最集中、哪类信号组合是危险的前兆。这些先验让模型不必从零起步,也回应了“数据太少”这道坎:经验本身就是数据稀缺时的垫脚石。 数据,告诉模型“实际发生了什么”。它是一把标尺,拿真实发生的结果去校验模型的判断,让模型始终贴着物理世界走,而不是在自己设定的假设里自说自话。没有数据,力学和经验都只是空中楼阁,落不到具体的那一条巷道。这里的数据也不限于监测信号:实验室里的力学试验、数值仿真生成的样本、现场记录下来的案例,都是数据的一部分。关键不在于它在哪,而在于它够不够“真”,能不能代表真实的物理过程。 数据告诉模型“实际发生了什么”,力学告诉它“什么不可能发生”,经验告诉它“通常先发生什么”。 三者缺一,模型就成了独轮车:只有数据,容易学到假规律(掉进第三、第四道坎);只有力学,扛不住现场的复杂(第二道坎无解);只有经验,又退回到拍脑袋,既不可复现,也谈不上批量。 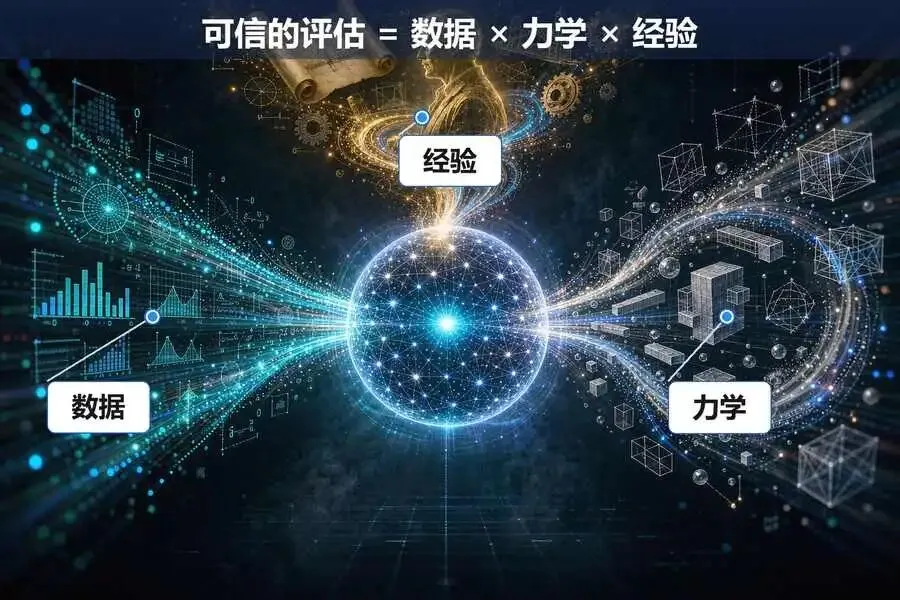
图3数据、力学与经验融合 3.结构—物性—应力:给 AI 造一个可计算的物理底座 数字岩石力学把复杂的地下工程抽象为结构、物性、应力三个基本因素,也就是广义“三因素”:应力是动力,物性是基础,结构是关键。结构指几何形态与地质界面,物性指岩石的物理力学性质,应力则涵盖渗流、温度等其他物理场。 这三者的数字化,本质上是在做一件事:把岩体的复杂性,翻译成 AI 能读懂、能计算的形式。 结构数字化,让模型知道“谁挨着谁”:断层、节理、软弱夹层在哪里,应力就会往哪里绕; 物性数字化,让模型知道“每一块有多强”:强度、模量、脆性,决定了它扛不扛得住; 应力数字化,让模型知道“力往哪里走”:原岩应力场是看不见的那只手,决定了破坏从哪发起。 这正是从“几何透明”走向“物理透明”的含义:不是把地下画得更好看,而是让计算机真正理解它,知道哪里是弱点、力怎么传、一旦开挖会怎么变。这个底座一旦建起来,AI 面对的就不再是黑乎乎的一团岩体,而是一个有结构、有性质、有力场的可计算对象。 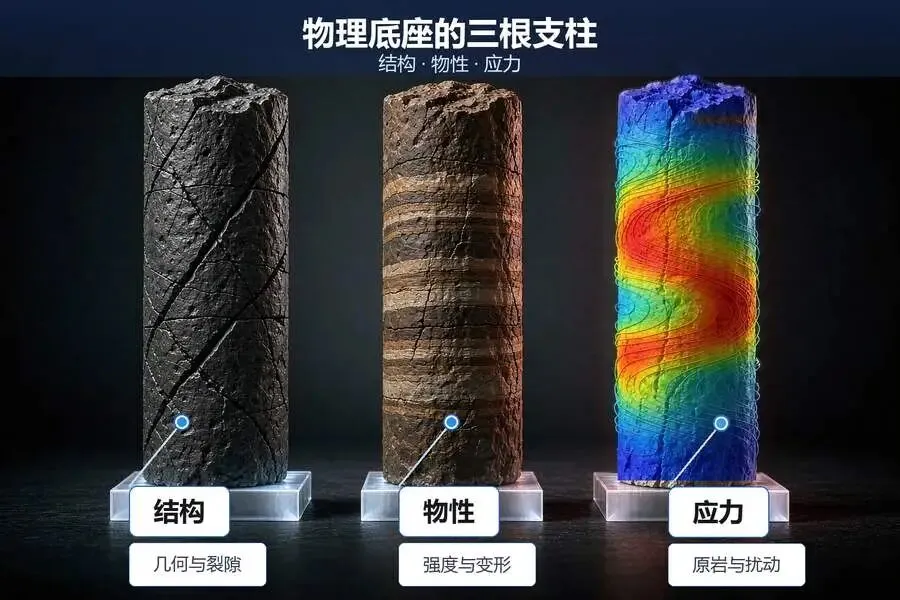
图4结构—物性—应力三因素及其数字化 4.数字岩石力学的意义 数字岩石力学的价值,在于它既没有神话数据,也没有排斥 AI,而是给出了一个更朴素的答案:让三者各司其职,互相校验。数据校准经验,力学约束数据,经验引导模型,三者转起来就是一个自我校正的循环,比任何单方面的聪明都更可靠。 四三条技术路线:从“喂数据”到“讲道理” 思想落到方法上,当前大致有三条路线。它们不是取代关系,而是按问题的复杂度与数据条件,各擅其场。 1.路线一:纯数据驱动 思路是让模型从数据中自行学习规律。优势是灵活,不需要事先设定物理假设,只要数据够,什么规律都能学。局限也就是第二节那四道坎,一道都绕不开:数据太少、危险样本太稀、说不清理由、换个现场就失灵,全都会找上门。它最适合数据相对充足、机制也较清楚的场景。 2.路线二:物理约束,把方程写进模型 思路是在训练过程中引入控制方程的残差约束,让模型的输出既贴合观测数据,又满足已知的物理规律。说白了,就是要求模型每给出一个答案,都代回力学方程里验算一遍:方程左右两边对不上的部分(术语叫“残差”)越小,说明这个答案越合规矩。典型代表是物理信息神经网络(Physics-Informed Neural Network, PINN)。 这条路线的进展已经相当扎实。例如,有研究将 PINN 用于隧洞围岩力学响应分析,以位移、应力为网络输出,把控制方程与边界条件嵌入训练,构建出一个不用先把岩体切成小格子(传统数值方法得先“划网格”)就能求解的模型,并进一步引入迁移学习(把在一个任务上学到的本事挪到新任务上)来应对地质条件与施工工况的变化;也有研究把随钻测量数据与物理模型结合,实时预测隧道围岩强度,在小样本、含噪声的条件下依然保持了较好的泛化能力;还有工作用 PINN 重建含硬夹矸煤体(夹在煤层中的坚硬岩层)的应力场,证明即便在介质非均质强烈时,物理约束也能帮模型摆脱对海量人工标注数据(一条条打上标签的数据)的依赖。 优势很明显:一是对数据量的要求大幅下降,二是结果在物理上“自洽”——算出来的答案能通过力学规律的检验,掉不出常识的圈。局限同样明显:当力学方程本身很复杂,又牵扯应力、渗流、温度等多个物理场相互牵制(行话叫“多场耦合”)时,要把这些方程写进模型里用来衡量误差的那个指标(也就是“损失函数”),本身就是一件难事,训练难度与计算代价都会显著上升。 3.路线三:物理引导,把物理作为先验与特征 思路是不把方程硬性写进模型,而是换一种更柔的方式:拿物理仿真生成的样本当作“先验”——也就是动手之前就已经掌握的常识和规律——再用物理力学的特征指标去引导模型学习。 它与路线二的区别,可以概括为软引导与硬约束之分:硬约束把物理规律写成必须满足的条件,规矩是守住了,模型也变“笨”了,表达空间被方程限制住;软引导则把物理作为先验信息和特征指引送进模型,既保留了数据驱动对复杂模式的拟合能力,又不至于学到违背力学常识的假规律。打个比方:硬约束像给新人立下“绝不准违规”的铁律,稳,但僵;软引导像给新人配了位老师傅,时时提醒、随时纠偏,活儿照样灵。 4.三条路线的关系 它们不是谁取代谁,而是按问题的复杂度与数据条件来选择。数据充足、机制清晰的场景,数据驱动足够好用;方程明确、样本稀缺的场景,物理约束更有优势;而当地质条件复杂、机制难以用单一方程描述时,物理引导往往更实际,它不必把一切写死,却能始终让模型“贴着力学常识走”。 约束得越硬,模型越规矩,但也越难学;引导得越软,模型越灵活,但也越需要有人把关。 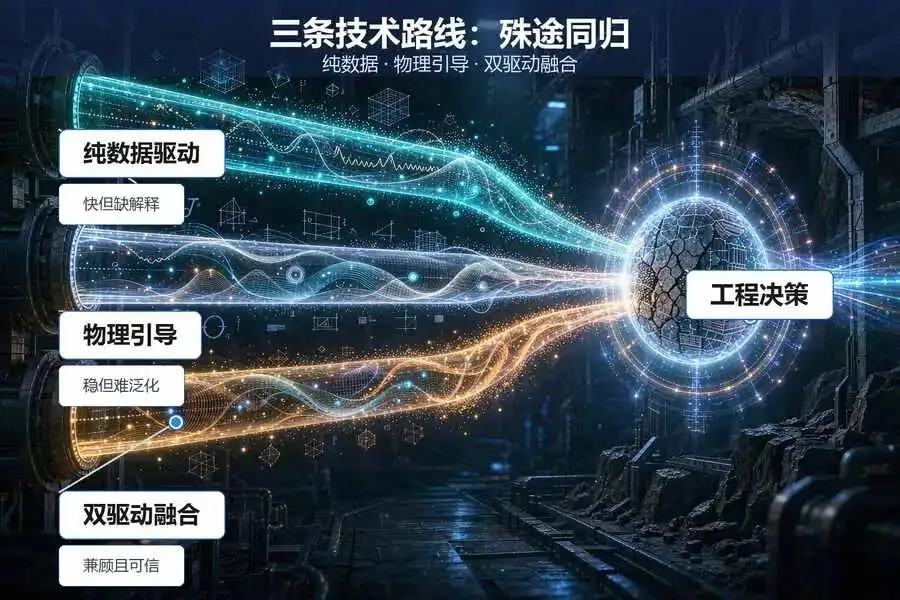
图5三条技术路线对比 五展望:从“拟合”到“推演” 把视野拉高一层,AI 进入岩石力学要完成的,其实是三个转变。 1.三个转变 从“拟合一条曲线”到“推演一个过程”:工程关心的不是某个数,而是这个数会怎么变。一条巷道的收敛量今天是多少,远没有“它将在开挖到第几步开始加速”来得重要。 从“给出一个数”到“给出一个讲得通的判断”:结论必须能被力学解释,才能进入决策链条。一个无法解释的高危预警,现场不会采信;一个讲得通的判断,即便保守,也值得参考。 从“模型输出即结论”到“模型输出可解释、可追溯、可质疑”:可解释性不是加分项,是准入条件。模型要经得起工程师的追问:“你凭什么这么说?”“如果这里参数变了,结论还成立吗?” 2.尚未解决的问题 也必须说清楚:这条路还远没有走完。物理约束这套办法,碰上力学行为格外复杂(行话叫“强非线性”)、又有多类物理场互相牵扯的情况,算起来依然很吃力;仿真数据与真实现场之间存在偏差,怎么校准仍在探索;可解释性方法目前能回答“谁重要”,还难以回答“为什么重要”;而真实、高质量的原位数据(在现场原位实测到的数据),仍然是整条链路上最稀缺的一环。这些都不是一两个模型能解决的,需要学科层面持续投入:既要在监测手段上把“数据贫”逐步补起来,也要在方法论上把“力学 + 经验”真正嵌进模型,而不是停在口号上。换句话说,可信的 AI 不是等出来的,是数据、方法、工程一起磨出来的。 3.闭环:从数据到决策 更值得期待的是 AI 真正嵌入工程之后的闭环:现场观测产生数据,模型解析提取规律,力学与经验把规律量化为可计算的指标,最终支撑工程决策,而决策又反过来指导新的观测布设。当这个环转起来,AI 就不再是离线的“算命先生”,而是和工程师并肩、长在流程里的同行者。 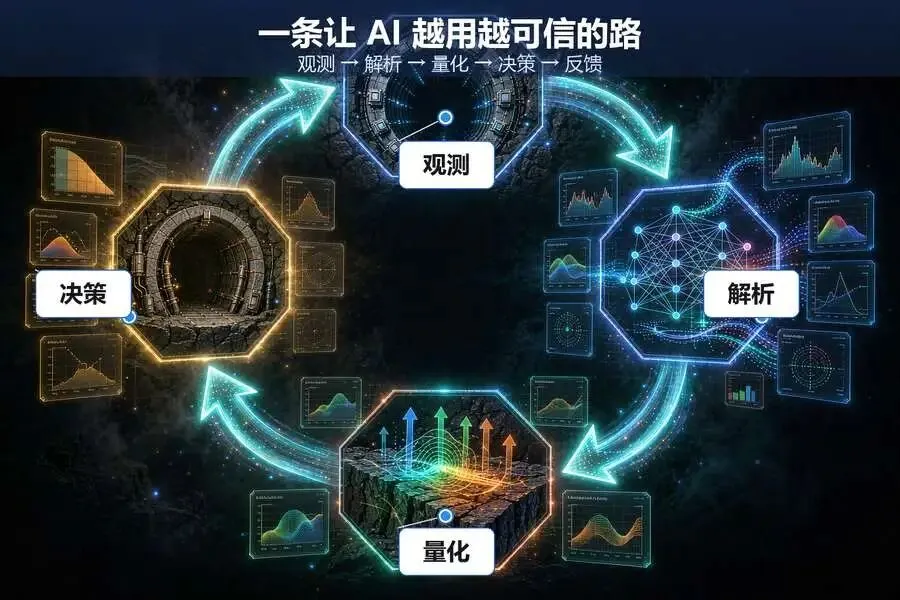
图6从数据到决策的闭环 参考文献 [1] 李海涛, 齐庆新, 杜伟升, 等. 煤炭开采等地下工程问题的数字岩石力学解决方案[J]. 煤炭科学技术, 2024, 52(9): 150-161. [2] 贺鹏, 江子豪, 石少帅, 等. 隧洞围岩力学响应的物理信息神经网络模型及其工程应用[J]. 岩石力学与工程学报, 2026, 45(8): 2391-2412. DOI: 10.3724/1000-6915.jrme.2025.0687. [3] 祁和刚, 李海涛, 郑建伟, 等. 数字岩石力学工程探索与实践[J]. 煤炭科学技术, 2026, 54(1): 55-66. [4] 王一铮, 庄晓莹, RABCZUK T, 等. AI for PDEs 在固体力学领域的研究进展[J]. 力学进展, 2025, 55(2): 231-287. [5] WILLARD J, JIA X W, XU S M, et al. Integrating scientific knowledge with machine learning for engineering and environmental systems[J]. ACM Computing Surveys, 2022, 55(4): Article 66. [6] WANG Y X, REZAEI A, HICKS S J. Digital twin applications in geotechnical engineering: a systematic review[J]. Machine Learning and Data Science in Geotechnics, 2025, 1(1): 77-91. [7] 李智涵, 杜伟升, 李海涛, 等. 物理信息多任务高斯过程的巷道围岩位移场反演方法[J/OL]. 煤田地质与勘探, 1-13[2026-09-15]. [8] 靳子越, 杨冠宇, 李海涛, 等. 基于4DCT 的煤岩裂隙动态追踪模型与损伤演化机理研究[J/OL]. 煤炭学报, 1-31[2026-09-15]. · · · · · · · 
· 
· 
· 
往期精彩回顾
今天的 AI 能写文章、能生成图像、能通过专业资格考试,甚至能在一张 CT 切片上圈出可疑的病灶。但如果把它请到千米深的井下,问它一句:这条巷道开挖之后,哪一段会先失稳?它多半答不上来。不是算力不够,而是它既没见过,也没真正学过地下的那套道理。
这几年,机器学习、深度学习确实在岩石力学里扎下了根。从实验室到工程现场,挂着“智能”“预测”“反演”字样的成果越来越多。可一个越来越清楚的事实是:把算法搬进地下工程,难点从来不在能不能算,而在算出来的结果工程师敢不敢用。AI 进入岩石力学,正在经历一次从“算得出来”到“算得可信”的转向。而回答这个问题的钥匙,恰恰不在 AI 这一侧。
这就引出本文想讲清楚的一件事:如果把 AI 看成一位天赋极高、却从没下过井的新人,那么岩石力学要教给它的,不是更快的算法,而是地下世界的基本常识。本文从 AI 已经做到的事说起,看地下工程给它出了哪四道坎,再看数字岩石力学的“数据 + 力学 + 经验”框架,如何把这三堂课补回去。
END
煤炭共性技术研究院以“建成集聚顶尖人才、攀登科技高峰、激扬第一动力的世界能源科技研究中心”为发展目标,打造成为集应用基础研究、关键共性技术研发、新兴产业技术研发、未来技术预研、科技人才培养、科技创新支撑为一体的,具有全球竞争力的世界一流科研机构,产出领先的煤炭开发利用及相关多元化技术成果。