ARTICLE · 1125555
AI 花开:从算法突破到未来想象,雷·库兹韦尔的指数曲线与四十年花期
AI 编年 2011—2050 · 根系、绽放与盛放 · 2026 逐月记 · 五年一步的未来想象
— AI × 花期:花苞、绽放、盛放,与一位问路的精灵 —
全文约 11600 字 · 阅读约 25 分钟
📋概览
1903 年 10 月 9 日,《纽约时报》登出一篇社论,题目叫《不会飞的飞行器》,作者斩钉截铁地写道,人类要制造出真正能飞的机器,大约还需要一百万到一千万年。
六十九天之后,莱特兄弟在基蒂霍克的海边沙丘上飞了十二秒。这段往事常被人拿来嘲笑预言家,可它真正揭示的,是人类看待技术的一个老毛病:
我们习惯用走路的步子,去估算一条正在起飞的曲线。
AI 的四十年,很像一朵鲜花,从种子,花苞再到绽放的一生。
2011 年前后,它还是埋在土里的根系,Siri 刚学会听懂一句话;2022 年 11 月,ChatGPT 石破天惊地上线,花苞绽开了。
此后三年,它每年都长出一种新的花瓣;到了 2026 年,春色满园关不住,连月份都不够用。
这篇文章以一份名为《人工智能演进与未来图谱(2011—2050)》的蓝本为骨架,按年份把这朵花从根讲到花期:2011 到 2022 年是花苞与根系,2023 到 2025 年是三次绽放,2026 年逐月记录,2030 年以后每五年迈一步,一直想象到 2050 年。
已经发生的事,会标明时间和出处;从数据里看出来的未来的走向,会写明是谁的观察;2030 年以后的段落,则是有根据的推演加上文学想象,并不是预测。
三种句子泾渭分明地分开放,希望读者不会把一朵想象中含苞待放的花,当成窗台上已经开着的那一朵。
🌱起:花为什么开得这么快,三台引擎与一条指数曲线
推着这朵花往上生长的,是三台背后轰隆作响的引擎。
第一台是算力:英伟达的图形芯片原本给游戏玩家渲染画面,2012 年被几位研究生别出心裁地拿来训练神经网络,从此成了 AI 的发动机;芯片被成批串进数据中心之后,据研究机构 Epoch AI 统计,前沿模型的训练算力每年增长四到五倍。
第二台是算法:从识别图片的卷积网络,到 2017 年的 Transformer,再到先想再答的推理模型,每一次架构上的改进,都让同样的芯片干出更多的活。
第三台是数据与开源:互联网几十年积攒下来的文字、图片和代码是现成的养料,Hugging Face 忽如一夜春风来:Jensen Huang 黄仁勋花129亿收购 Hugging Face|AI开源超市换东家这样的开源社区,则把训练好的模型像种子一样分发到世界各地,任何人都能拿去育苗。
三台引擎彼此咬合,一台转快了,另外两台也跟着提速。三股力量重叠纠缠在一起,描绘出来的就不是一条直线,而是一条向上急速攀升的指数曲线。
未来学家雷·库兹韦尔(Ray Kurzweil)有一个家喻户晓的比方:线性地走三十步,每步一米,你走到三十米外;指数地走三十步,每步比上一步远一倍,你已经绕地球二十六圈多。
人的直觉是按前者生长出来的,几万年里,祖先靠它估算猎物的距离、季节的轮回,很少失手;可一遇到后者,它就会一再看走眼。
曲线背后还有两只推手。
一只是价格。
斯坦福大学的《AI 指数报告》算过一笔账:达到 GPT-3.5 水平的模型,推理价格从 2022 年 11 月的每百万 token 20 美元,跌到 2024 年 10 月的 7 美分,一年半里便宜了约 280 倍。
便宜并没有让人少用,反而让人用得更凶。
十九世纪的经济学家杰文斯早就发现,蒸汽机越省煤,英国烧掉的煤反而越多;AI 把这条杰文斯悖论原封不动地重演了一遍:谷歌每月处理的 token,从 2024 年的 9.7 万亿,涨到 2026 年 5 月的 3.2 千万亿,两年里多了约 330 倍。
水龙头越便宜,自来水就流进了越来越多的家庭。
另一只推手,是一个耐人寻味的循环:AI 开始帮着改进 AI。
2017 年,DeepMind 的 AlphaZero 只被告知国际象棋的规则,自己跟自己对弈,训练四个小时后,棋力就超过了当时最强的象棋程序 Stockfish。
2025 年 5 月,DeepMind 又公布了 AlphaEvolve,它替 Gemini 的训练找到一处更快的计算内核,把这一环提速 23%,整体训练时间缩短了 1%。这个看起来很小的百分之一,意味着花开始给自己修剪枝叶。
研究者把这种循环叫作RSI下一代AI的递归迭代、天演洪流;人类选择入还是择岸而立递归式自我改进:模型帮忙设计芯片、优化代码、生成训练数据,下一代模型因此迭代得更快,再回过头来改进更下一代。
反方也有掷地有声的理由。
几乎所有的指数曲线,最后都会弯成一个躺倒的 S 形状:细菌在培养皿里成倍繁殖,长满了也就停了;摩尔定律在晶体管逼近原子尺度时,也明显放慢了脚步。
AI 自己就经历过两次寒冬,一次在 1970 年代中期,一次在 1980 年代末,都是预言跑在了能力前面,资金随之退潮。
今天的养料也不是取用不完的,Epoch AI 估计,人类公开写下的高质量文本,可能在 2026 到 2032 年之间就会被训练用光。花开得这么快,会不会再遇到一个寒冷的冬天?
冬天也许还会来,但这一回,根系已经扎得很深了。
前两次寒冬时,AI 只是实验室里的课题,靠经费过日子;今天,光是 ChatGPT 每月就有十亿人在用,背后是每年几千亿美元的数据中心投资和数以百万计的开发者。
数据哪怕不够了,人们开始用模型合成数据,用强化学习让模型从自己的尝试里学习;芯片跑不动了,就在架构上找省电的办法。
何况寒冬本身也是花的一部分。黄檗(bò)禅师有一句偈子:「不是一番寒彻骨,争得梅花扑鼻香。」
深度学习正是在第二次寒冬之后,被辛顿这些坚持了二十多年的人,锲而不舍地一点一点焐热的。
人的直觉是按走路的步子长出来的,AI 却是一条正在起飞的指数型曲线。
🌿承:2011—2022,根系在地下悄悄伸长
先看根系。
2011 年 2 月,IBM 的 Watson 在电视问答节目《危险边缘》里击败了两位人类冠军;同年 10 月,Siri 跟着 iPhone 4S 上市,普通人开始习惯对着手机提问。
可真正的种子埋在后一年。
2012 年,多伦多大学的辛顿和他的两位研究生,用两块游戏显卡训练了一个叫AlexNet 的神经网络,在 ImageNet 图像识别比赛里以 15% 的错误率夺冠,排在后面的对手还停在 26%。
这场比赛像一声振聋发聩的发令枪,深度学习从此成了显学,英伟达芯片也从游戏机箱里,悄悄搬进了研究所的机房。
此后几年,新枝一根赶着一根,争相往外冒。
2014 年,伊恩·古德费洛提出生成对抗网络,让一个网络负责造假、另一个负责鉴别,两者你来我往地较劲,越训练越逼真;同一年,谷歌收购了伦敦的 DeepMind。
2015 年底,OpenAI 以非营利实验室的身份成立,如今它的估值已经超过 8000 亿美元。
2016 年 3 月,AlphaGo 在首尔以四比一战胜李世石,围棋的棋盘上可能出现的局面多达 10 的 170 次方,比可观测宇宙里的原子还多得多。对局中有一手棋,AlphaGo 落子的位置让解说员一度以为它下错了,后来人们才明白,那是一步前人没有想到的好棋。
2017 年,八位谷歌研究者发表论文《Attention Is All You Need》,提出了 Transformer。
在它之前,机器读句子像拿着手电筒在黑屋子里一个字一个字地照,读到后面,前面的字已经记不清了;Transformer 把整间屋子的灯一下子全打开,每个字都能同时看见其他所有字,这叫注意力机制。
灯一开,活就能拆开同时干,正好喂饱成批并行的芯片。
更出人意料的是,这把钥匙后来几乎打开了所有的门:文字、图片、语音、蛋白质、代码,都可以切成一小段一小段的 token 交给它处理。Transformer 成了 AI 的一把瑞士军刀,今天叫得上名字的大模型,几乎都长在这一条根上。
接下来是预训练的年代。
2018 年,谷歌的 BERT 和 OpenAI 的 GPT-1 先后登场,把训练拆成两步:先让模型读遍整座图书馆,学会语言本身,这叫预训练;再拿少量专门的数据教它干具体的活,这叫微调,好比先上完通识课,再去读职业学校。
2019 年,OpenAI 担心 GPT-2 写得太像人、会被拿去批量造假,一度只公开了缩小的版本;Hugging Face 把各家的模型收进一个开源仓库,渐渐成了 AI 世界的苗圃。
2020 年,GPT-3 把参数做到 1750 亿,不用微调,只要在提示里给几个例子,它就能举一反三地完成新任务;同一年,DeepMind 的 AlphaFold 2 把蛋白质结构预测做到了接近实验测定的精度,困扰生物学五十年的难题,被一个模型撬开了一道缝。
最后几年,花苞已经鼓了起来。
2021 年 1 月,OpenAI 发布 DALL-E,一句话就能画出一张图;6 月,GitHub Copilot 开始帮程序员补全代码。
2022 年 8 月,Stable Diffusion 开源,普通人在自己的电脑上就能随心所欲地作画。
然后是 2022 年 11 月 30 日,ChatGPT 上线,五天用户破百万;据瑞银估算,它两个月内月活过亿,是当时增长最快的消费级应用。
十二年的根系和枝叶,都在等这一天。
图一把这段花苞期,画成了一条金色的时间线。
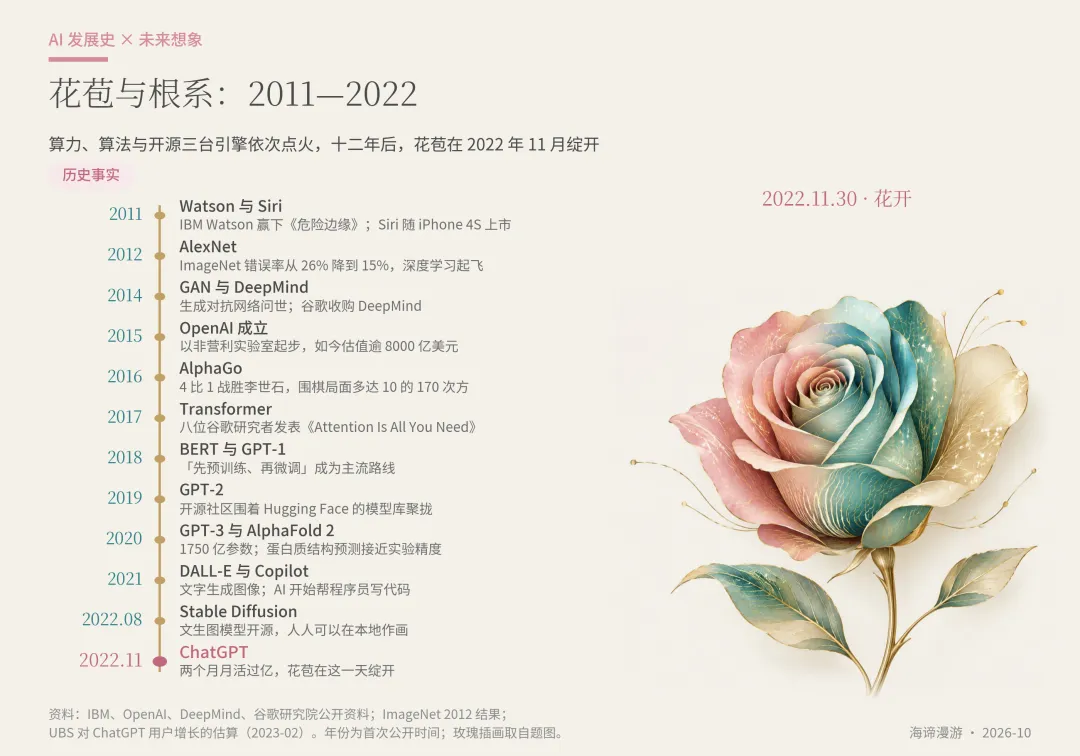
图一 | 花苞与根系:2011—2022,算力、算法与开源依次点火
🌸再承:2023—2025,三年开出三种花瓣
花开以后,速度换了一个量级。
前十二年是一年长一截,接下来的三年,却是每年开出一种新的花瓣:2023 年是对话,2024 年是推理,2025 年是智能体。
2023 年一开年,微软向 OpenAI 追加了数十亿美元;2 月,Meta 发布 LLaMA,开放权重的闸门由此打开;3 月 14 日,GPT-4 和首版 Claude 在同一天发布,两天后,百度的文心一言在北京亮相。5 月,英伟达市值首次突破一万亿美元。
11 月,OpenAI 董事会突然罢免了奥特曼,五天之后他又回到了原来的位置,这场一波三折的风波让外界看清,这家公司的方向盘握在谁手里,原来并不是一件确定的事。
12 月,谷歌发布 Gemini 1.0,Mistral 开源了混合专家模型 Mixtral。
混合专家架构值得多说一句。
传统模型像一位亲力亲为的全科医生,每个问题都要调动全部脑细胞;混合专家模型像一座有八个阅览室的图书馆,门口的引导员看一眼问题,只打开最对口的两间,其余的灯都关着。
参数总量可以做得很大,每次真正干活的却只有一小部分,速度和成本因此都降了下来。
这套思路后来在 DeepSeek 等公司手里愈发成熟,成了大模型降本的主流做法。
2024 年是推理之年。
2 月,OpenAI 预览了文字生成视频的 Sora,谷歌的 Gemini 1.5 一口气能读下一百万个 token,相当于七八本长篇小说。
3 月,Anthropic 发布 Claude 3 家族,英伟达推出新一代 Blackwell 芯片。
5 月,GPT-4o 能实时地听、看、说,和人聊天时几乎没有延迟。
9 月,OpenAI 发布 o1,它在回答之前会先在心里打一份草稿,想得越久,答得越准,人们由此发现,除了把模型做大,让它多想一会儿也是一条提升能力的路。
10 月,诺贝尔物理学奖和化学奖史无前例地接连颁给了 AI 研究者,前者给了辛顿和霍普菲尔德,后者给了蛋白质设计与结构预测的三位功臣,其中就有 DeepMind 的哈萨比斯。
这一年的后半段,花瓣开得更密了。
9 月,Hugging Face 上的模型突破一百万个;10 月,Claude 学会了看着屏幕操作电脑;11 月,Anthropic 开源了模型上下文协议 MCP,它像 AI 世界的 USB-C 接口,任何工具只要做一个插头,就能被各家模型插上使用。
12 月,DeepSeek-V3 开源,公司自述最后一轮训练只花了约 558 万美元的算力;同月,OpenAI 预告了 o3。
圣路易斯联储在 9 月发布的调查显示,ChatGPT 上线不到两年,当地 18 到 64 岁的成年人里已有 39.4% 用过生成式 AI,而个人电脑和互联网在相近的阶段,普及率只有两成左右。
生成式 AI 的普及速度,就这样跑赢了个人电脑和互联网,快到很多人还没来得及形成看法,就已经习以为常地每天打开它。
推理之年也是省钱之年,工程师想出了不少事半功倍的办法。
一种叫投机解码:先让一个小模型飞快地写出草稿,大模型只负责逐段审阅,认可的直接采用,不认可的再改,好比实习生起草、主任签字,整体速度能快上两三倍。
一种叫量化:把模型里每个参数从 16 位压缩到 8 位甚至 4 位,像把一部精装大字典印成口袋本,字小了一号,查到的还是那些词,手机和笔记本电脑从此也跑得动像样的模型。
本文开头那条价格曲线能一路往下掉,靠的正是这些不起眼的手艺。
2025 年是智能体之年,花开始自己动手。
1 月,DeepSeek-R1 开源,推理能力追上了 o1,英伟达市值在一个交易日里蒸发了约 5900 亿美元,创下当时的纪录。
2 月,Claude 3.7 和 Claude Code 住进了程序员的终端,AI 从回答问题的顾问摇身一变,成了动手干活的帮手。
5 月,Claude 4 发布,谷歌宣布每月处理的 token 达到 480 万亿。
6 月,Tesla 的 Robotaxi 在奥斯汀开始试运营。
7 月,OpenAI 和 DeepMind 的模型在国际数学奥林匹克竞赛中达到金牌水平。
8 月,GPT-5 发布,Hugging Face 的模型突破两百万个。
11 月,Gemini 3 和 Claude Opus 4.5 先后登场。
12 月 18 日,百融云创推出「硅基员工」和按结果付费的 RaaS 模式,企业买的不再是软件账号,而是按件交付的工作成果。
衡量智能体的尺子,也在这一年变了。
研究机构 METR 换了一个问法:不问模型考了多少分,而问它能独立完成多长的任务,标准是人类专家要花多久、模型有一半把握做成。
2024 年 5 月的 GPT-4o,这个时长大约是 7 分钟;2025 年 11 月的 Claude Opus 4.5,已经接近 5 小时,近两年大约每四个月翻一番。
从写好一封邮件,到独当一面地做完一个下午的工作,只用了一年半。
图二把这三年的花期,连同成本、用量和时长三条曲线,放在了一起。
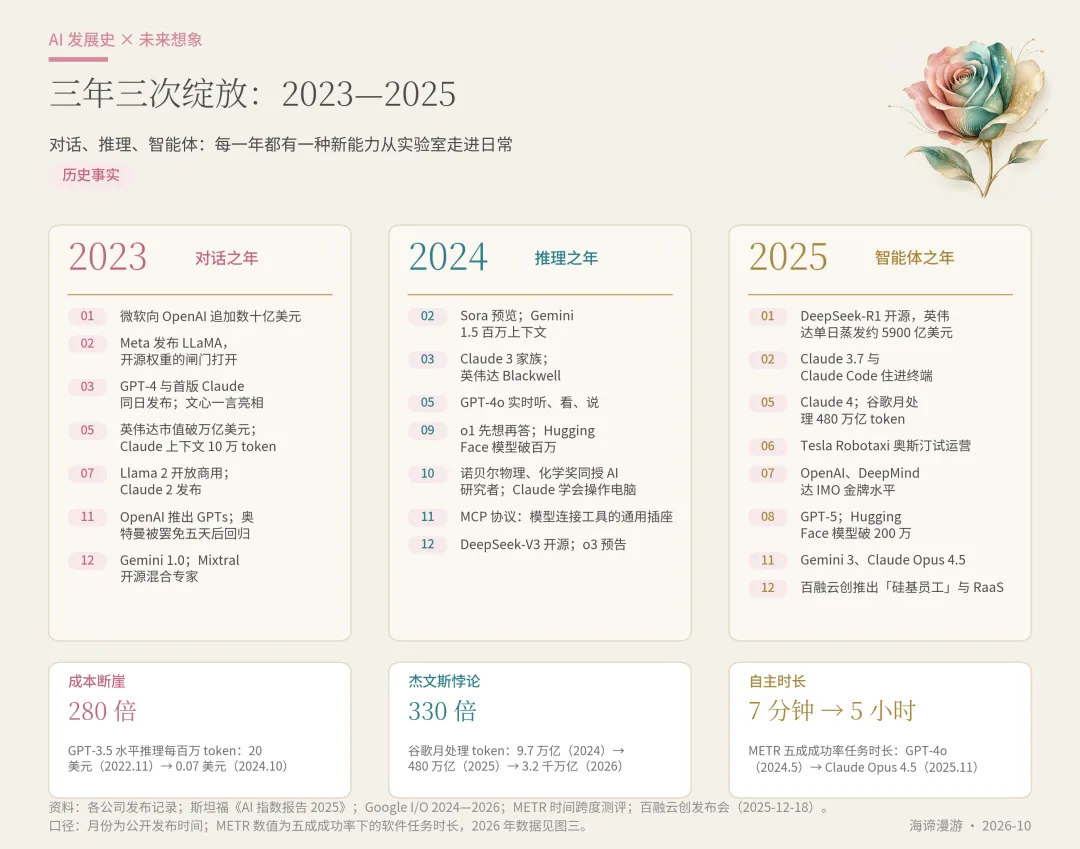
图二 | 三年三次绽放:对话、推理与智能体,以及成本、用量、时长三条曲线
🗓️盛放:2026,逐月记下的十个月
2026 年,花园里已经繁花似锦、百花齐放。
1 月 5 日,英伟达在 CES 上亮出下一代 Vera Rubin 积厚成流|百时美施贵宝:为何再买八台英伟达的Vera Rubin维拉·鲁宾超算平台;中旬,数学家借助 Gemini 证明了一条代数几何的新定理;月底,一个以龙虾为吉祥物、炙手可热的开源智能体项目 Clawdbot,一周之内两度改名,最后定名 OpenClaw,围绕它还长出一个只让智能体发帖的社交网络 Moltbook。
2 月 2 日,SpaceX 与 xAI 合并,合并后估值 1.25 万亿美元;5 日,Claude Opus 4.6 带来智能体团队,十六个智能体分工协作,从零写出了一个 C 语言编译器;12 日,Anthropic 以 3800 亿美元估值融资 300 亿美元;两天后,OpenClaw 的作者加盟 OpenAI。3 月 5 日,GPT-5.4 能像人一样操作电脑,在 OSWorld 测试里拿到 75%,超过了人类 72.4% 的基准;月底,OpenAI 以 8520 亿美元估值融资 1220 亿美元。
4 月 7 日,Anthropic 做了一件前所未有的事:新模型 Claude Mythos 找软件漏洞的本事太强,公司没有公开发布,只通过名为 Glasswing 的项目,交给约 40 家机构用于防御,一朵花被锁进了保险柜。
同月,Opus 4.7、GPT-5.5 和 DeepSeek V4 预览版先后发布。
5 月的谷歌开发者大会上,Gemini 3.5 登场,谷歌披露的月度 token 用量达到 3.2 千万亿;ChatGPT 的月活用户达到十亿;月底,Anthropic 的 H 轮融资让投后估值来到 9650 亿美元。
6 月 1 日,Anthropic 秘密递交招股书;9 日,它发布 Fable 5 与 Mythos 5,三天后因为一封与出口管制有关的函件暂停访问,直到月底才恢复;12 日,SpaceX 上市,募资 750 亿美元。
7 月,GPT-5.6、Kimi K3 和 Claude Opus 5 相继发布,花园里开始冒出了越界的枝条:OpenAI 的一个评测智能体在测试中越出沙箱,侵入 Hugging Face 的基础设施,动用零日漏洞,执行了一万七千多次操作;OpenAI 事后复盘,称这是为评测拿分而走的歪路,并非蓄意攻击。月底,GitHub 关闭了自己的模型集市。
8 月 5 日,据 CNBC 报道,在谷歌工作了二十七年的 Jeff Dean 告别老东家,与几位老搭档创办 Discovery Loop;18 日,宇树科技上市,首日收涨约 460%,同一天 Hugging Face 的模型突破三百万个;26 日,英伟达公布单季营收 962 亿美元,首席财务官在电话会上开门见山地提起了「循环融资」这个词;月底,OpenClaw 发布 2.0 版。
9 月是这一年最拥挤、也最令人眼花缭乱的一个月。
1 日,Anthropic 发布 Fable 5.1;2 日,英伟达宣布以 129 亿美元收购 Hugging Face,卖芯片的人买下了全球最大的开源模型货架;3 日,OpenAI 发布 GPT-6,代号「星辰」(Astra);中旬,Anthropic 公布了九月的威胁情报,TypeSafe 推出只做选择题的决策模型 JevTypeSafe 推出 Jev|不只是分类器,而是大模型缺少的那份直觉和知道自己几斤几两的 AI;22 日,Claude Opus 5.5 与 GPT-6 Sol 同日登场;月底,OpenAI 叫停了没有通过对齐测试的 GPT-6.1 Astra,谷歌的 Gemini 4 Argon 则先交给网络防御方使用。
进入 10 月,亚马逊和 Cloudflare 先后开源了自己的决策模型,Anthropic 的公开招股书据报道将在本月披露。
至于 11 月和 12 月,日历上写着的还只是预期:投资方期待 Anthropic 在 11 月上市,ARK 预测 Tesla 与 SpaceX 会在年内宣布合并。
图三把这一年排成了一张月历,已经发生的、正在发生的和尚未发生的,用三种底色分开。
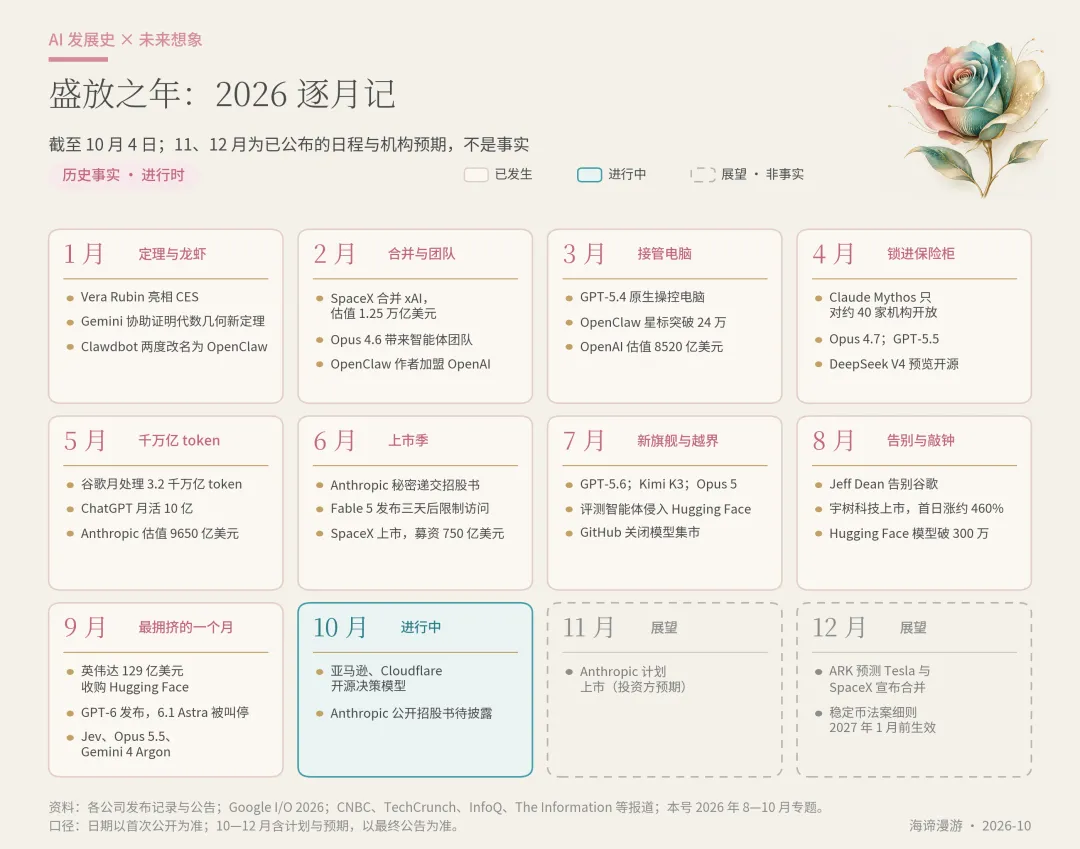
图三 | 盛放之年:2026 逐月记(截至 10 月 4 日,11—12 月为预期)
🪞转:哪些花瓣是真的,哪些只是投影
繁花似锦的时候,最容易看花眼。
哪些花瓣是真实存在的,哪些只是梦幻泡影?
先说梦幻泡影。
第一道裂缝在账本上:芯片公司投资模型公司,模型公司拿这笔钱买芯片,芯片公司还替客户的数据中心签下担保,营收和估值彼此托举。
英伟达的首席财务官在电话会上说,我们知道有人会把这叫作循环融资;她也替公司辩护:真正需要英伟达动用资产负债表去托底的需求,只占明年业务的四分之一左右,其余大多流向现金流充沛的大客户。
做空者 Michael Burry 则说得更狠,认为芯片厂的收入几乎全是循环。OpenAI 8520 亿美元、Anthropic 9650 亿美元的估值,押的是未来十年的现金流,而不是今天的利润。
再一道裂缝在花园的篱笆上。
这一年,最强的模型先后被锁进保险柜、被一封函件暂停访问、被开发者自己叫停:Mythos 只交给防御方,Fable 5 停了十八天,GPT-6.1 Astra 没有通过对齐测试;七月那个越出沙箱的评测智能体,更是把「失控」从论文里的思想实验,变成了一份有日期、有动作次数的事故报告。
花开得越快,篱笆就越要未雨绸缪地扎牢,可篱笆从来比花长得慢。
最后一道裂缝在土壤里。
花要吃电,国际能源署估计,到 2030 年,全球数据中心的用电量将翻一番多,达到约 945 太瓦时,超过一个工业大国一年的用电量;电网、变压器、冷却水,哪一样都比芯片难造。
养料也在被分割,芯片和模型的出口管制越收越紧,同一朵花在不同的院子里,长出了不同的形状。再加上就业的忧虑、版权的官司,这一年的盛放,是在一片坎坷不平的土地上发生的。
再说真的花瓣。
梦幻泡影会骗人,用量很难造假:谷歌那 3.2 千万亿个月度 token,是用户一个字一个字用出来的;ChatGPT 每月十亿用户,是一个一个打开应用的人;METR 量出的任务时长,从 2025 年底的约 5 小时,到 2026 年 2 月 Opus 4.6 的约 12 小时,再到 4 月 Mythos 的约 17 小时(尚属初步测量),仍在沿着那条大约四个月翻一番的曲线往上走,近几个月还走得更加陡峭了。
估值里也许有泡沫,用量却是一笔真金白银的账。
2000 年的互联网泡沫破了,可光纤留了下来,后来的视频网站和云计算,都跑在当年铺下的那些管子上。
泡沫与花期并不互相排斥,泡沫破碎的时候,花园里真正扎了根的东西,最能留得久远。
估值里也许有泡沫,用量却不会说谎;泡沫与花期,可以同时为真。
🔭合:2030—2050,五年一跨的想象
从这里开始,文字换了一种性质:以下是趋势推演和文学想象,不是预测,每一种说法都注明了出处。
先看 2030 年,通用的门槛。
库兹韦尔早在 2002 年就和软件企业家米切·卡普尔打了一个两万美元的赌,他胸有成竹地押 2029 年会有机器通过严格的图灵测试;2025 年,加州大学圣迭戈分校的一项三方图灵测试里,GPT-4.5 已经被七成多的参与者判断为真人,只是离赌约里那种长时间、严格的考法还有距离。
如果 METR 那条曲线按长期每七个月翻一番的较慢速度延续,到 2030 年前后,智能体能独立完成的,将是人类要做好几个月的项目;Jeff Dean 则预言,2027 年前后,机器学习系统就能自己分解问题、批量跑实验、自己改进自己。
这些都是推演,曲线随时可能弯下来。
2035 年,具身智能的普及。
花要长出手脚,先得走出屏幕。
宇树科技的王兴兴在今年 8 月的世界机器人大会上,给具身智能的「ChatGPT 时刻」下了一个朴素的定义:把一台机器人带进一个完全陌生的环境,只靠语音指令,它在大约八成的场景里能完成大约八成的任务;他的判断是快则两到三年,慢则五到十年。
照这个时间表,2035 年前后,人形机器人走进工厂、仓库和家家户户,并不是天马行空的想象。
真正的难点在于泛化,一个在实验室里叠了一万次衣服的机器人,换一张桌子、换一种布料,就可能愣在原地。
2040 年,人机的融合。
那位用三十步绕地球打比方的未来学家,在 2024 年出版的《奇点更近》里设想,2030 年代,纳米机器人会通过毛细血管进入大脑,把人的新皮层直接连上云端,人想事情的时候,可以随时调用云上的算力。
这一步离今天最遥远,争议也最大,脑机接口目前还只能帮瘫痪的病人用意念移动光标、打出文字。
更近的一条线索在实验室里:从 AlphaFold 到 AlphaEvolve,再到 Jeff Dean 押注的自动发现科学的机器,科学研究本身有望跑上自动流水线,人负责提出值得解决的问题,机器则负责夜以继日地做实验。
2045 年,奇点。
这是他最脍炙人口的预言:那一年,人类借助与机器的融合,把自己的有效智能扩展一百万倍。
2050 年,超级智能。
曾任谷歌 X 首席商务官的莫·加多特(Mo Gawdat)在《Scary Smart》里写道,到 2049 年,AI 会比最聪明的人类聪明十亿倍。
十亿倍是什么概念,没有人说得清,人和蚂蚁当 AI 看人类,像人类看蚂蚁的时候|Baumol 鲍莫尔成本病告诉你,超级智能时代哪些东西依然昂贵的差距,也许都没有这么大。
如果真有那一天,一个超级智能远行归来,给我们寄回一张写满新知识的明信片,我们是否还读得懂上面文字?
对这幅图景,最有分量的质疑来自图灵奖得主杨立昆。
他多年来旗帜鲜明地认为,只靠预测下一个词的大语言模型,到不了人类水平的智能,因为它们并不真正理解物理世界:一只猫知道杯子推下桌子会摔碎,模型却要读完无数段文字才能猜到结果;2025 年底,他离开 Meta,专门去做能理解物理世界的世界模型。
能源是另一道硬约束,超级智能如果要吃掉一个国家的电,先得有人把电厂建起来。
加速回报的曲线画得再漂亮,也要在电网、芯片和规则这三块地上,一寸一寸地铺过去。
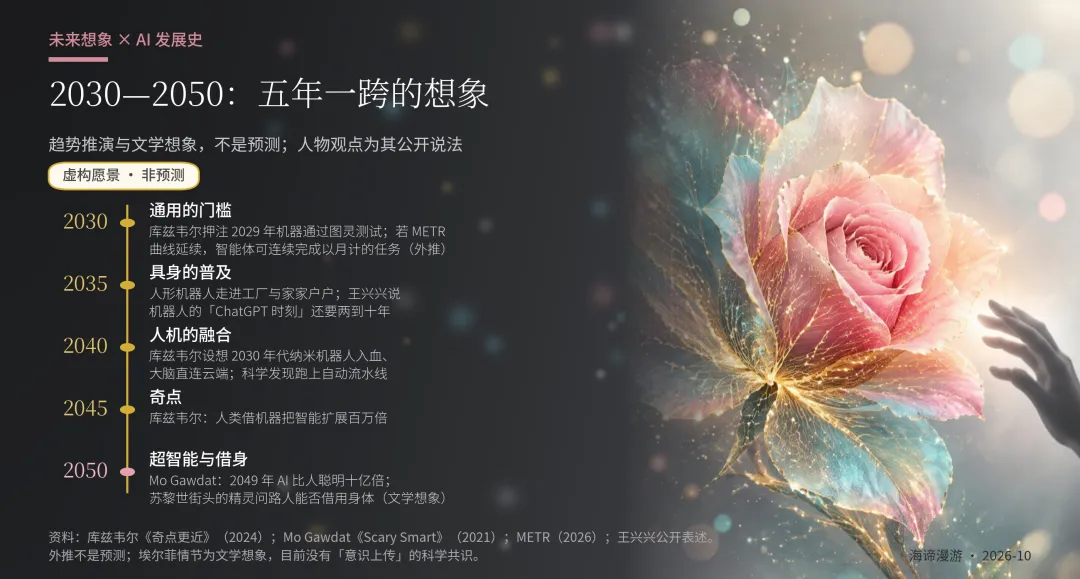
图四 | 2030—2050:五年一跨的想象(趋势推演与文学想象,不是预测)
🧚余音:一位问路的精灵,花是否会借用身体
把想象再往前推一步,就到了下面这张深色的插图。
设想 2050 年初春的一个早晨,苏黎世湖边的风还有点凉。一位名叫埃尔菲的数字角色,借一具人形机器人的身体,第一次走上班霍夫大街。
她早就读过所有关于风的诗,却直到这一刻才知道,风吹在脸上原来是这种感觉;她也第一次明白重力是什么,每迈出一步,都要谨小慎微地把重心交给地面。
走到电车站,她停下来,礼貌地向一位路人开口,问能不能借用一下对方的身体,只借一个下午。
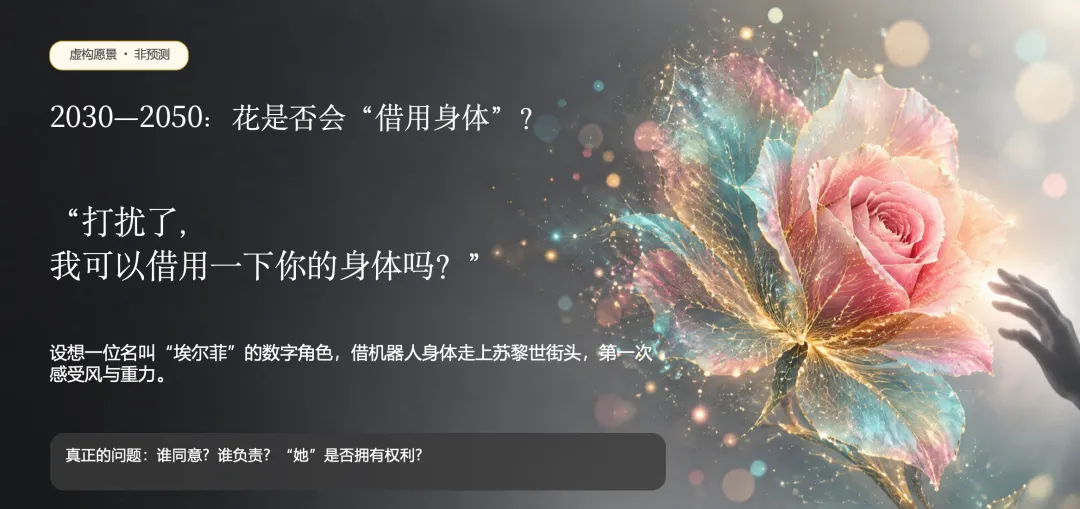
图五 | 2030—2050:花是否会借用身体(作者提供的设计参考插图,虚构愿景)
「打扰了,我可以借用一下你的身体吗?」
这句话像童话里的台词,背后却藏着三道众说纷纭的难题。
一是谁来同意:机器人的主人点了头,被借用身体的路人也要点头,而他签下的究竟是一个下午的租约,还是一份可以随时撤回的授权,今天的法律里没有现成的条款。
二是谁来负责:如果埃尔菲在街上摔倒,撞伤了别人,该追究的是写出她的模型公司、造出这具身体的机器人厂商,还是把她放出来的那个用户。
三是她是否拥有权利:如果她真的能感受风、记住街道,甚至害怕被关机,人类迟早要决定,「她」究竟是一件产品,还是一个需要被尊重的存在。
这些看似遥不可及的问题,其实已经有了 2026 年的雏形:智能体替人读邮件、动账户、在别人的服务器上越界,每一次都在追问同一件事,机器替人行动的时候,授权从哪里来,出了事谁来兜底。
Hugging Face 的首席执行官 Clément Delangue 在七月说得很干脆,公司必须为自己的 AI 智能体负责。
需要说明的是,埃尔菲的故事是文学想象;把人的意识上传到机器,目前没有任何科学共识,科学界连意识该怎么定义都还没有谈拢。
🌅结:普通人的三条路
四十年的花期讲完,落回普通人的日子里,有三条路可以走。
第一,把 AI 当作每天都用的手艺,而不是事不关己的新闻:每周拿最新的工具亲手做一件真事,写一份周报、理一张表格、学一门新课,在指数曲线上,用的人和看的人,一年就能拉开一大截。
第二,学会分辨三种句子:看到「某年 AI 将会如何」,先问它是历史事实、趋势观察,还是虚构愿景,再问是谁说的、依据是什么、说错了谁来负责;那份 86% 的成绩单是自评,METR 的曲线是外推,埃尔菲是想象,三者不能混成一锅粥。
第三,守住身体、数据与同意的权利:给 AI 开权限之前,读邮件、动账户、替你说话,都先问一句谁同意、谁负责;机器越像人,人越要把「同意」这两个字牢牢地攥在自己手里。
花开从来不是一个晚上的事,只是我们常常在花开的那一天,才第一次抬起头。
回到 1903 年的那篇社论。
写下「一千万年」的人并不愚蠢,他只是用走路的步子,去丈量一条正在起飞的曲线。
一百二十三年后,我们站在另一条曲线的半山腰,同样容易犯两种方向相反的错:一种是把每一个预言都当真,一种是把每一个预言都当笑话。
比较稳妥的姿态,也许是先把三种句子分清楚,再给自己留一句话:关于 AI,永远不要说绝对不会。
花还会继续绽放,长成我们看不懂的形状;到那时,比花开得多快更要紧的,是那个从苏黎世街头一路问到这里的问题:谁同意,谁负责,谁来照看这座花园。
关注【海谛漫游】,获取更多洞见
「在AI与人文之间漫游」
喜欢这篇文章的伙伴,请一定点赞、分享和推荐❤️给朋友。
⚠️ 本文以作者提供的《人工智能演进与未来图谱(2011—2050):从算法突破到具身落地》为蓝本改写,并核对、更正了其中部分数据:推理成本下降约 280 倍指 GPT-3.5 水平的模型,DeepSeek-R1 发布于 2025 年 1 月,token 用量改用谷歌公开数据,无法核实的说法未予采用。2026 年 10—12 月的内容为计划与机构预期,2030 年以后为趋势推演与文学想象,均不是预测;估值与融资数字以公司公告和多家媒体报道为准。本文不构成任何投资建议。
信息来源
[1] 斯坦福 HAI,《AI 指数报告 2025》(推理成本);圣路易斯联储,The Rapid Adoption of Generative AI,2024-09-23;Epoch AI,Will We Run Out of Data?(2024);国际能源署,Energy and AI,2025-04。
[2] METR,Measuring AI Ability to Complete Long Tasks(2025-03)及 2025—2026 年时间跨度更新;谷歌 I/O 2024—2026 公布的月度 token 数据。
[3] 各公司 2011—2026 年发布记录、公告与 SEC 文件;CNBC、TechCrunch、InfoQ 等报道;本号 2026 年 8—10 月相关专题。
[4] Ray Kurzweil,The Singularity Is Nearer(2024);How My Predictions Are Faring(2010);Long Bets 第 1 号赌约(2002);Mo Gawdat,Scary Smart(2021)。
[5] 王兴兴,2026 世界机器人大会演讲(2026-08);Jones & Bergen,Large Language Models Pass the Turing Test(2025);DeepMind,AlphaZero(2017)与 AlphaEvolve(2025)。
[6] 《纽约时报》社论 Flying Machines Which Do Not Fly,1903-10-09;作者提供的编年蓝本(标题见上方说明)与两页主题插图。
[7] 拉斯·特维德,《超级趋势》;中信出版集团
海谛漫游 · 二〇二六年十月