ARTICLE · 1125560
7440 亿参数的国产 AI 开源了:20 分钟搭一套操作系统,它自己把活干完
9 月 11 日,一个 7440 亿参数的中国开源模型悄悄出现在 Hugging Face 上。
没有发布会,没有新闻稿,没有技术博客,模型卡往上一挂就算发布了。三天之后,它的技术报告才慢悠悠地传上 arXiv——正常的节奏是反过来的:先发论文,再放模型。
它叫Atria Dawn Preview,中文名「书生·星河」,来自上海人工智能实验室。而它值得说的不是 7440 亿这个数字,是它到底能把一件活干到什么程度。
先看两张官方演示里的成绩单:20 分钟搭出一套 MiniOS 操作系统;1 分钟算出全球未来一周的天气。
Atria Dawn Preview,上海人工智能实验室开源的智能体模型(概念示意图)
| 一、一件反常的事
这件事的发布时间线,按公众号的说法是「有点不讲武德」:
9 月 11 日:完整权重传上 GitHub 和 Hugging Face,一个字没多说;
9 月 12 日:又放出一个 FP8 精简版,把部署门槛往下压了一档;
9 月 14 日:技术报告才上 arXiv,标题叫《Atria Dawn: The Dawn of Agentic Superintelligence》;
9 月 16 日:中文官方稿才发出来,模型的中文名「书生·星河」也是这时候才被大部分人知道。
这个顺序值得琢磨。一般来说,一个前沿模型发布,前半年的节奏是:造势、开发布会、讲能力上限、再放权重(或者干脆不放)。这次的顺序几乎反着来——先让能人用上,再解释这是什么。
顺带说一句许可:它是 MIT 协议。这几个字在开源圈意味着你可以随便用、随便改、拿去做商业产品也不用付钱、不用申请。对一家实验室来说,这是放开得相当彻底的选择。
| 二、它到底能干什么
官方把它的能力分成四类,每一类配了具体的演示:
发现:会翻资料、做深度检索,把「这个方向值不值得研究」这种模糊问题,拆成能动手的实验计划;
创造:写软件、做交互网页和游戏、做数据可视化、搭机器学习系统;
交付:把一堆文档、数据和零散的设计要求,变成一份能交出去的报告或演示文稿;
安全:在获批的环境里找漏洞、验证问题、修好,再回头复验一遍。
最出圈的还是那两个演示。「20 分钟搭一套 MiniOS」的意思是:它自己分析需求、写代码、跑起来、发现报错、自己回头改,直到能开机运行。「1 分钟预测全球一周天气」说的是:它自己设计并训练了一个气象模型,里面有 ViT 骨干、参数超过 4 亿——注意,4 亿是它顺手做出来的那个小模型的大小,不是它自己的体量。
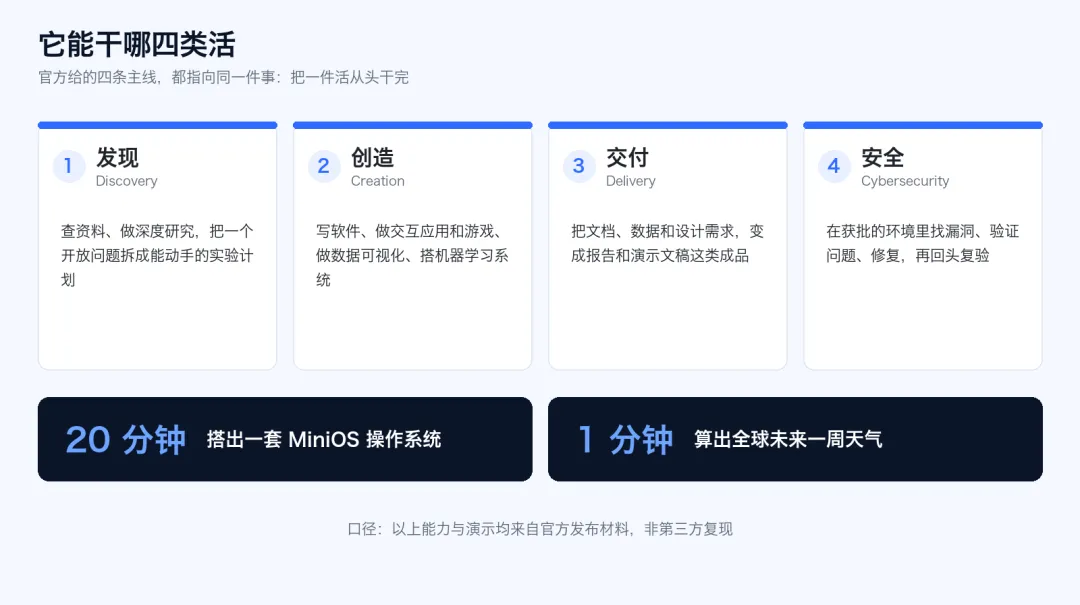
官方给出的四条能力主线与两个演示(数据来自官方发布材料)
| 三、它跟你手机里的聊天机器人,差在哪
你平常用的那些 AI,本质上是一问一答:你说一句,它回一段。它很聪明,但它只在「说话」这一层帮你,说完就结束,后面的事还得你自己来。
这类新模型追求的是另一件事:把一整件活交出去。它自己规划步骤、自己调用工具、自己写代码、自己跑、自己看结果,出错了自己回头改。这类模型有个专门的说法,叫「智能体」(agent)——你可以把它理解成:不是给你答案的顾问,而是替你干活的实习生。
差别就藏在这句话里:顾问说「你可以这样做」,实习生直接把东西做完了给你。
| 四、它怎么练出来的
这是整件事里我觉得最有意思的部分。
教一个模型干活,最直接的思路是「人写好标准答案喂给它」。但真到写代码、做研究这种活上,标准答案根本写不完——一个报错有八百种原因,你没法给每种情况都准备一份范文。
上海 AI 实验室换了个办法,官方叫「可验证经验管线」(Verifiable Experience Pipeline)。说人话就是:别问它答得好不好看,把它扔进一个能真跑代码的环境里,让它动手做,做没做成由环境说了算。
代码能不能跑通、测试能不能过、结果能不能复现——这些是机器可以自己判断对错的。干对了就给正反馈,干错了环境会打回,它得自己想办法爬起来。这样练出来的本事,是「真的能做成一件事」,而不是「说得很像那么回事」。
把工具调用接到可执行环境,用可验证的结果当反馈(概念示意图)
| 五、跑分:它有 5 项排第一,但写代码是短板
官方报告里一共列了 16 项基准测试,和 DeepSeek V4 Pro、KIMI K3、Qwen 3.8 Max、GLM 5.3、GPT 5.6 sol、Claude Opus 5 这些模型逐项对比。结论是:其中 5 项它拿了已报告的最高分。
这 5 项集中在检索、工具调用和安全上——网页检索 BrowseComp 92.5,深度检索 DeepSearchQA 96.0,工具调用 BFCL v4 77.0,网络安全 CyberGym 86.5,自动化任务 AutomationBench 53.8。
但有一块它明显不占优,而且差距不小:纯写代码。SWE-bench Pro 它只有 59.6,Claude Opus 5 是 74.7;终端任务 Terminal-Bench 2.1 它 78.3,对手能到 90 分以上。
所以更准确的说法是:它未必是眼下最会写代码的那个,它强在把一长串流程的活从头跟到尾。「边查资料、边验证、边动手」这件事,和「按需求写一个能合并的 pull request」,考验的其实是两种不同的判断力。
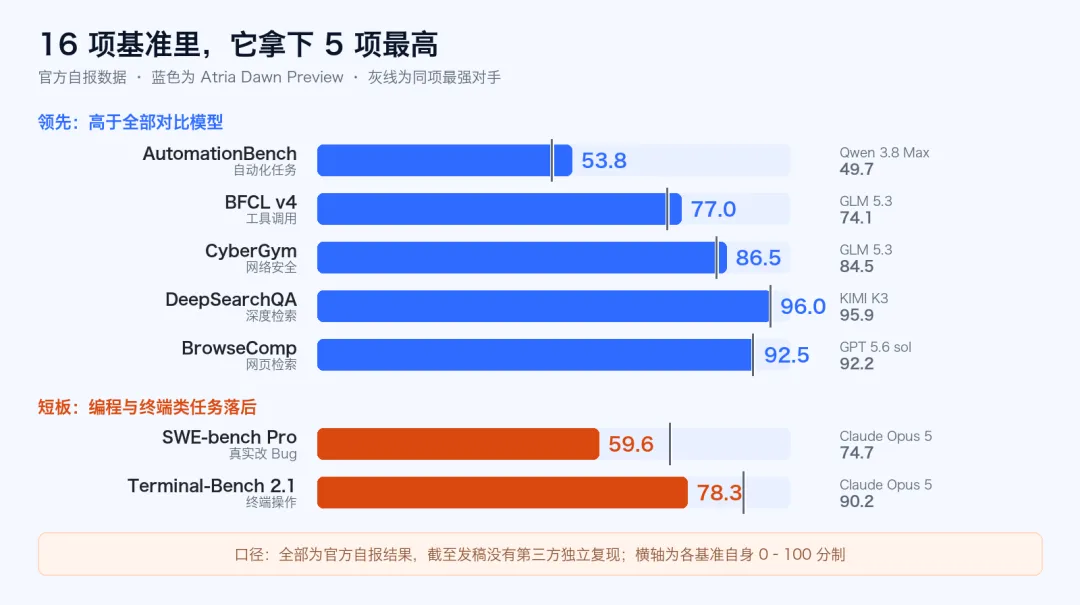
16 项基准里领先的 5 项与落后的 2 项(数据均为官方自报)
基本规格
这里有个细节得单独说清楚:上面所有跑分都是官方自己报告的。截至发稿,还没有第三方独立复现过这些数字。这不代表数据有问题,但「厂商自报」和「独立实测」是两个口径,看的时候得分开。
| 六、论文里最让人心里没底的一节
跑分只是热闹。这份技术报告真正让人回味的是最后一章——他们把自己做这个模型的过程,当成一个「人和 AI 到底怎么分工」的样本记了下来。
论文里分析了769 条任务记录,来自56 位参与者的真实工作过程。其中一个结论是:大约三分之一的已完成任务,参与者自己认为「没有 AI 根本做不完」。
但论文里更值得注意的是另一句,它写得很克制:AI 频繁地提出方法、动手实施修改,而人保留了大部分最终决定权——靠判断和反馈来引导方向。
换成大白话就是:AI 负责出主意和干活,人负责说「这个方向对」或者「这条不对,重来」。论文把这种状态叫做从「任务级执行」走向「项目级合作」——人的精力越来越多花在「什么事值得做」和「证据该怎么用」上。
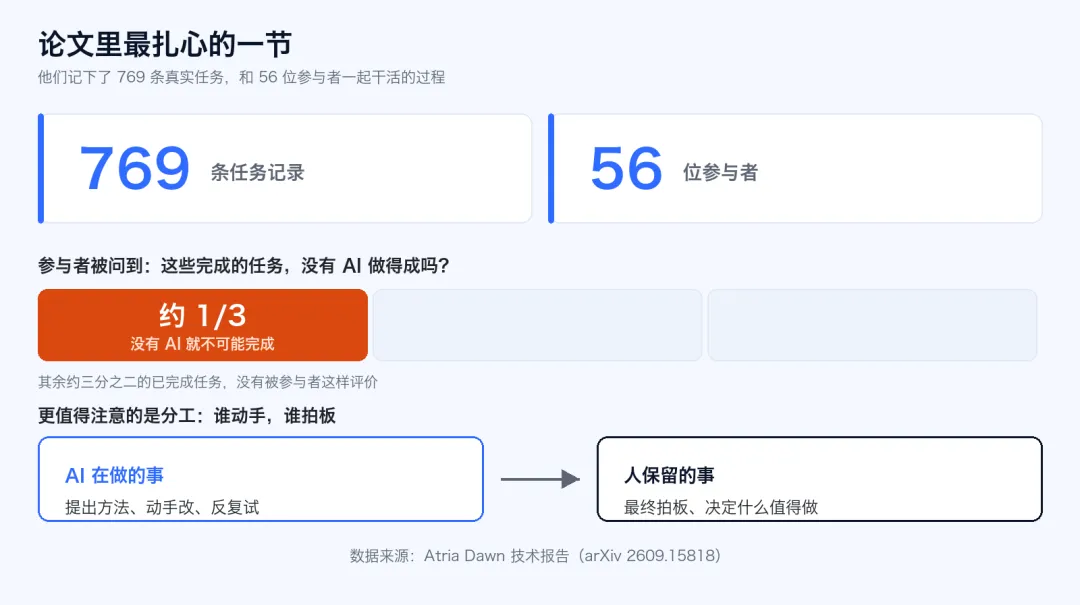
技术报告中的人机协作样本:769 条任务、56 位参与者(数据来自论文)
这个说法听起来挺美好,但它也留下了那个绕不开的问题:当「干活」这件事越来越交给 AI,「判断什么值得做」就成了唯一还需要人的环节。可判断力本身,是靠做了无数具体的事练出来的。
这不是我一个人的担心,是这份论文自己承认往前走必须解决的事。
| 七、普通人怎么用上它
先说结论:你能用上它的能力,但你多半跑不动它的本体。
你家里的电脑,跑不动这个东西
这张模型光是权重就要756GB 到 1.5TB的存储,正常跑起来得用一整组服务器级的显卡(H100/H200 这个级别)。所以别指望下到你这台机器上跑——它注定是给别人部署在云上的东西。想用能力,走在线接口;想省钱,等后面出小版本或者社区量化版。
好消息是它有现成的在线接口,而且兼容 OpenAI 那一套调用格式——意思是,你之前给别的模型写的代码,把地址一换就能用。国内入口在 discovery.intern-ai.org.cn,海外入口在 api.atria-asi.ai。
命令行试一下(需要先申请 API key):curl https://api.atria-asi.ai/v1/chat/completions \-H "Content-Type: application/json" \-H "Authorization: Bearer 你的API_KEY" \-d '{"model": "Atria-Dawn-Preview","messages":[{"role":"user","content":"帮我调研近三年时序预测基础模型的进展,给出可执行的实验方案和带引用的报告。"}],"max_tokens": 32768}'
动手前有三个坑得提醒:
第一,别发图片。它是纯文本模型,图文混着传会直接报错。如果你习惯用某些客户端接它,记得把模态改成 text-only。
第二,它现在叫 Preview。预览版,官方没承诺这个版本之后会怎样,权重和接口都可能变。
第三,长任务要给它足够的上下文。这类模型最擅长的是「跑一长串步骤」,别用一问问一句的方式体验它,那等于买了辆车只在院子里转圈。
上海人工智能实验室主任周伯文在世界人工智能大会上说过一句话,被这次发布反复引用:「科学研究是下一个编程」。意思是,编程这件事因为标准化、可自动化,AI 已经能大面积接手了;接下来轮到科研这种开放、长周期、充满不确定性的活儿。
Atria Dawn 就是拿这个判断做的一次实操。它做得好不好,得等第三方独立测过才算数。但它至少说明了一件事:AI 正在从「帮你回答」,走到「帮你完成」。
这件事是好事还是麻烦,现在没人能下定论。但它已经发生了,而且是开着 MIT 协议发生的。
声明:本文所引跑分、演示与协作研究数据全部来自上海人工智能实验室的官方发布材料与技术报告(arXiv 2609.15818),截至发稿无第三方独立复现;激活参数、权重体积为第三方按官方参数估算,已在文中注明。文内配图为示意插画,非官方产品截图。
谢谢你读到这里。
点个在看把这份温暖传下去吧~
关注一下,下次见面不迷路☀️