ARTICLE · 1132599
6万篇论文挤爆顶会!AI写、AI审、连坐枪毙500篇:学术界正在经历一场赛博癫狂
学术界彻底乱套了
就在最近,全球人工智能顶级学术会议 ICLR(国际学习表征会议)的后台服务器上,跳出了一个震撼整个学界的数字:这一届登记的投稿总量,突破了 60,000 篇!
这是什么概念?
上一届 ICLR,收到的有效投稿才刚刚爬过 1.95 万篇的关口。短短一年,投稿量直接暴涨了整整三倍。全球顶尖的 AI 科学家就那么多,就算把全世界相关专业的教授、博士、研究生全绑在电脑前不吃不喝,也根本审不完这堆积如山的稿件。
面对这场即将压垮整个评审体系的雪崩,MIT(麻省理工学院)的博士生 Jacob X. Li 抛出了一个让同行哑口无言的观点:
“别挣扎了既然人类审稿人本来就水得参差不齐,不如给每个人都发一个最好的大语言模型。大模型的审稿水平,早就全面超越了那些敷衍的人类‘审稿人2号’。”
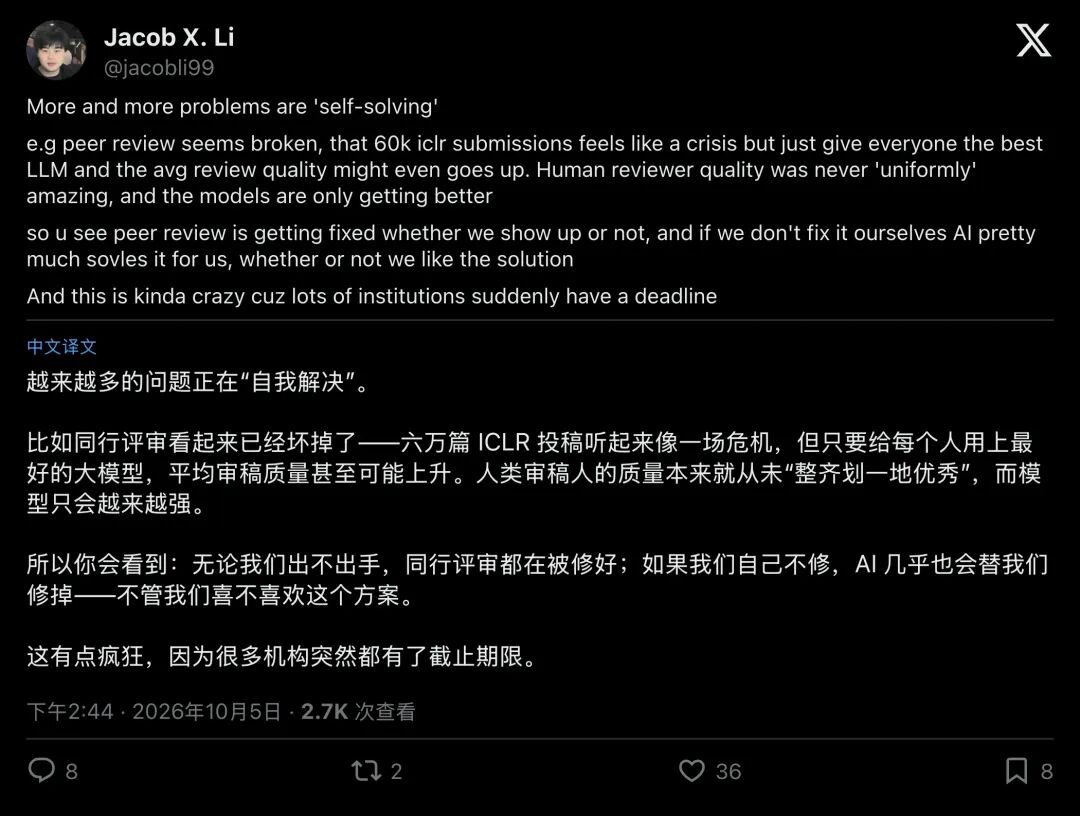
▲ Jacob X. Li 认为,最好的大模型已经能抬高平均审稿质量,AI 制造的问题终将被 AI 解决
人类写不出这么多论文,人类也审不完这么多论文。
于是一场魔幻的当代学术奇观正在上演:学生用大模型生成论文,教授用大模型撰写审稿意见,作者再用大模型起草反驳信,最后由系统根据模型打分决定去留。
这场由算法驱动的狂欢,正在把科学殿堂变成一个巨大的、没有人类灵魂的自动化垃圾焚烧厂。
01.一座即将决堤的水坝:6万篇论文背后的学术造纸机
要看懂这场危机,首先得明白什么叫同行评审(Peer Review)。
简单来说,同行评审就是科学界的“安检机”。你写了一篇论文,声称自己有了重大发现;会议组织方会把你的论文分发给三到四位同行专家。专家们匿名挑刺、打分,最后由领域主席(Area Chair)拍板:是当场放行录用,还是打回原籍退稿。
在计算机领域,顶会论文就是硬通货它直接决定了一个博士生能否毕业、一个青年学者能否拿到教职、一家初创团队能否拿到风投。
而现在,这座安检机前,突然挤进了六万个人。
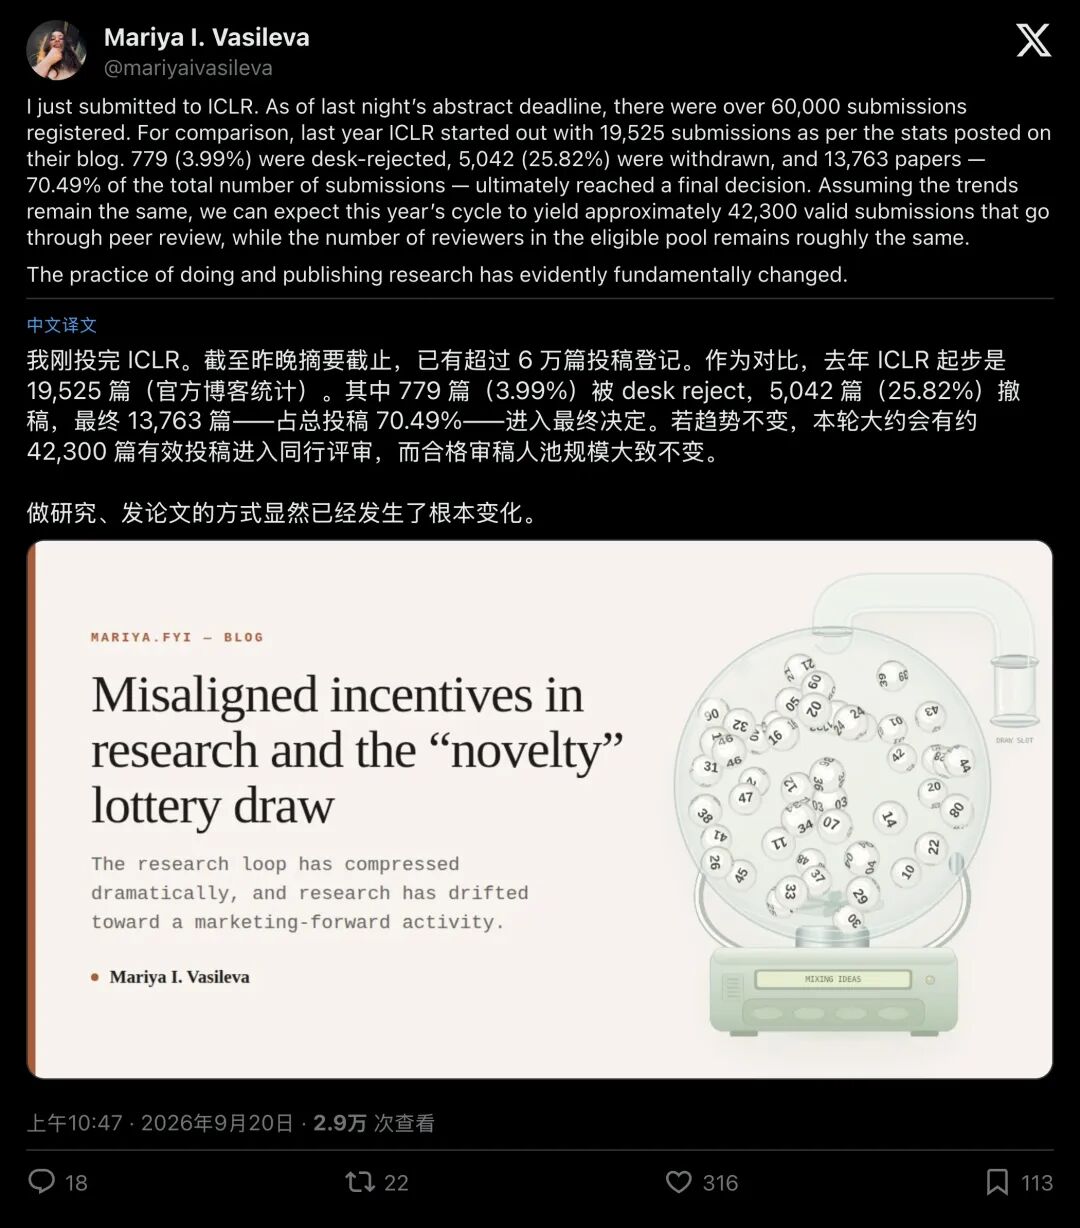
▲ 研究者 Mariya I. Vasileva 测算,即便按往年比例剔除违规,有效评审量仍将达到四万级
研究者 Mariya I. Vasileva 翻出上一届的数据做了一笔账:2026 届 ICLR 收到了 19,525 篇投稿,最终动用了 1.8 万名审稿人、提交了 7.6 万份审稿意见,才艰难消化掉这个体量。
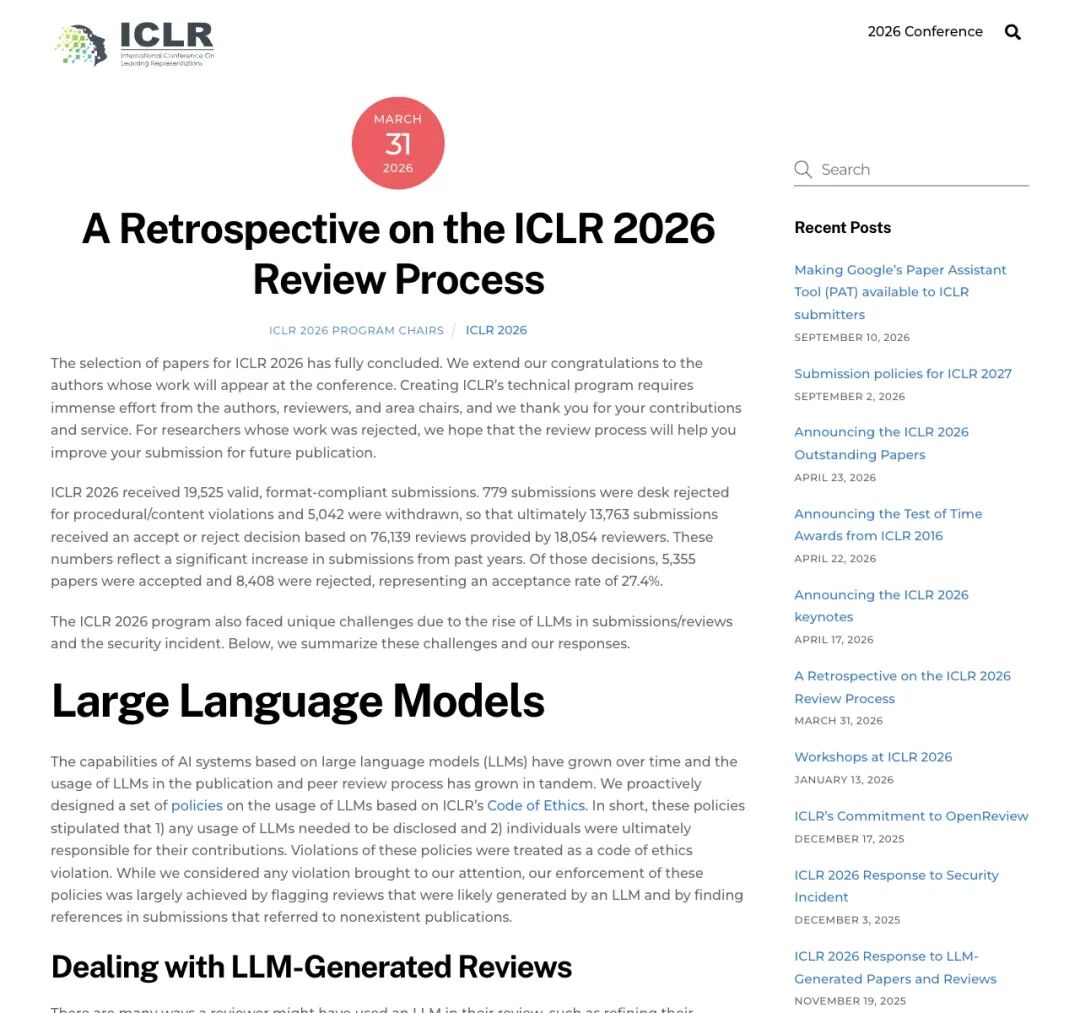
▲ ICLR 官方回顾显示,上一届仅仅为了消化 1.95 万篇论文,整个流程就已经极其吃力
到了这一届,6 万篇的初始登记量,即使去掉格式不合格的初筛拒稿和中途撤稿,最终也至少有 4 万篇进入实质评审。
但全世界合格的审稿人池子,根本没有变大。
斯洛伐克学者 Vlado Boza 发出了一声怒吼:“别只怪 AI,这纯粹是糟糕的激励制度结出的恶果!”
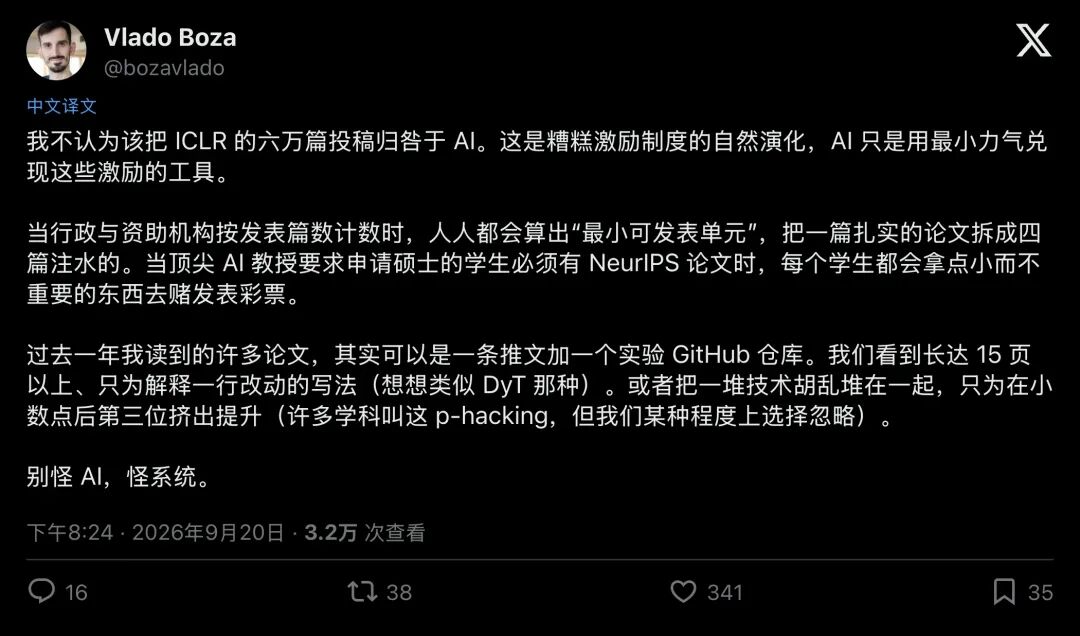
▲ Vlado Boza 认为,考核体制才是元凶,AI 只是用最低成本兑现坏激励的工具
在现有的学术评价体系下,经费机构数篇数,大学招老师数篇数,顶尖实验室招硕士生也要求手握顶会论文。
结果就是,“最小可发表单元”(Minimal Publishable Unit)成了所有人的生存法则:本来一项扎实的研究,非要拆成四篇注水论文;本来只改了一行代码、在小数点后第三位刷了一点点微不足道的指标,非要用大模型扩写成 15 页洋洋洒洒的高深论文。
论文沦为流水线上用大模型批量压制的学术彩票,原本承载科学探索的厚重感荡然无存。反正只要投得足够多,总有一张能中奖。
02.审稿人的彻底摆烂:赛博闭环诞生了
水坝决堤了,首当其冲被淹死的就是一线审稿人。
每一个科研人员既是作者,也是义务劳动的审稿人。当一个审稿人推开后台,发现自己名下被强行塞进十多篇逻辑不通、废话连篇的注水论文时,他的心理防线彻底崩溃了。
于是,审稿人也开始投降
他们顺理成章地打开了 ChatGPT 或者 Claude,把受审论文整篇复制进去,敲下一行提示词:“请帮我写一份措辞严厉、挑出 3 个缺陷的审稿意见。”五秒钟后,一份格式工整、语言典雅的“专家意见”新鲜出炉。
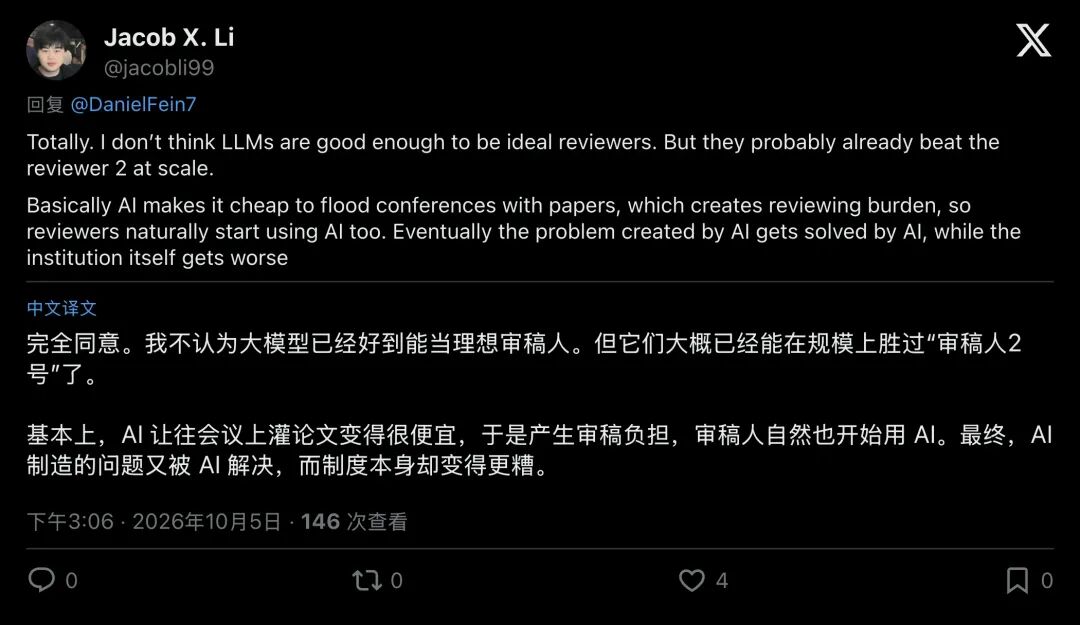
▲ Jacob 描述的恶性循环:AI 灌水带来审稿负担,审稿人也用 AI,机构本身随之沉沦
Jacob X. Li 在推特上把这个闭环挑得明明白白:“AI 让灌水变得极其廉价,制造了巨大的审稿负担;于是审稿人自然而然也开始用 AI最终,AI 制造的问题被 AI 解决了,而整个学术机构本身却彻底烂掉了。”
第三方检测机构 Pangram 的数据,把这层遮羞布扯得粉碎。
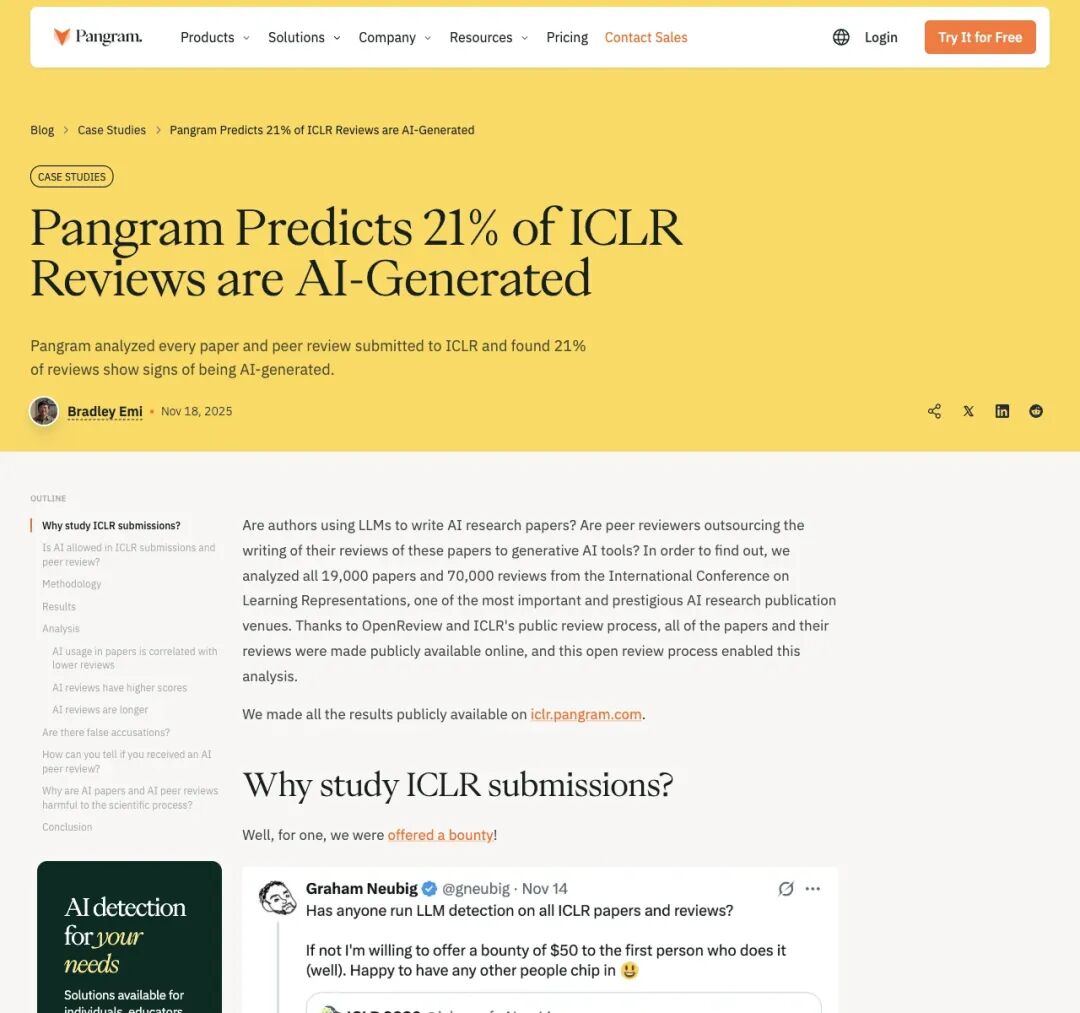
▲ Pangram 预测,ICLR 上有超过 21% 的审稿意见完全由 AI 生成
他们对公开的近两万篇论文和七万多份审稿意见进行了地毯式检测,结论令人咋舌:约 21% 的审稿意见被判定为完全由 AI 生成;超过一半的审稿意见有人工智能不同程度的介入。
统计数据同时表明,完全由 AI 生成的审稿意见,篇幅往往更长,给出的评分也普遍更高。因为大模型骨子里是个“老好人”,最擅长用礼貌而空洞的辞藻,堆砌一堆挑不出硬伤但也毫无见地的中庸好评。
在学术界内部,人们把那些态度傲慢、言之无物、敷衍了事的审稿人戏称为“审稿人2号”(Reviewer 2)。
支持大模型介入的人戏谑道:哪怕是最敷衍的大模型,吐出来的字句也比那些只写两行“实验不够充分、建议拒稿”的人类 Reviewer 2 强得多。
但,这真的叫“质量提升”吗?
03.铁腕执法:连坐惩罚与“连毙500篇”的惨烈现实
面对这种荒诞局面,会议组织方感受到了学术权威被消解的严峻危机。
为了应对这场洪水,ICLR 2027 组织方不得不祭出近乎严苛的“限流防沉迷”新规:每位学者最多只能在 20 篇投稿中署名;如果不具备合格互惠审稿人资格的新作者,每人最多只能参与 1 篇投稿!
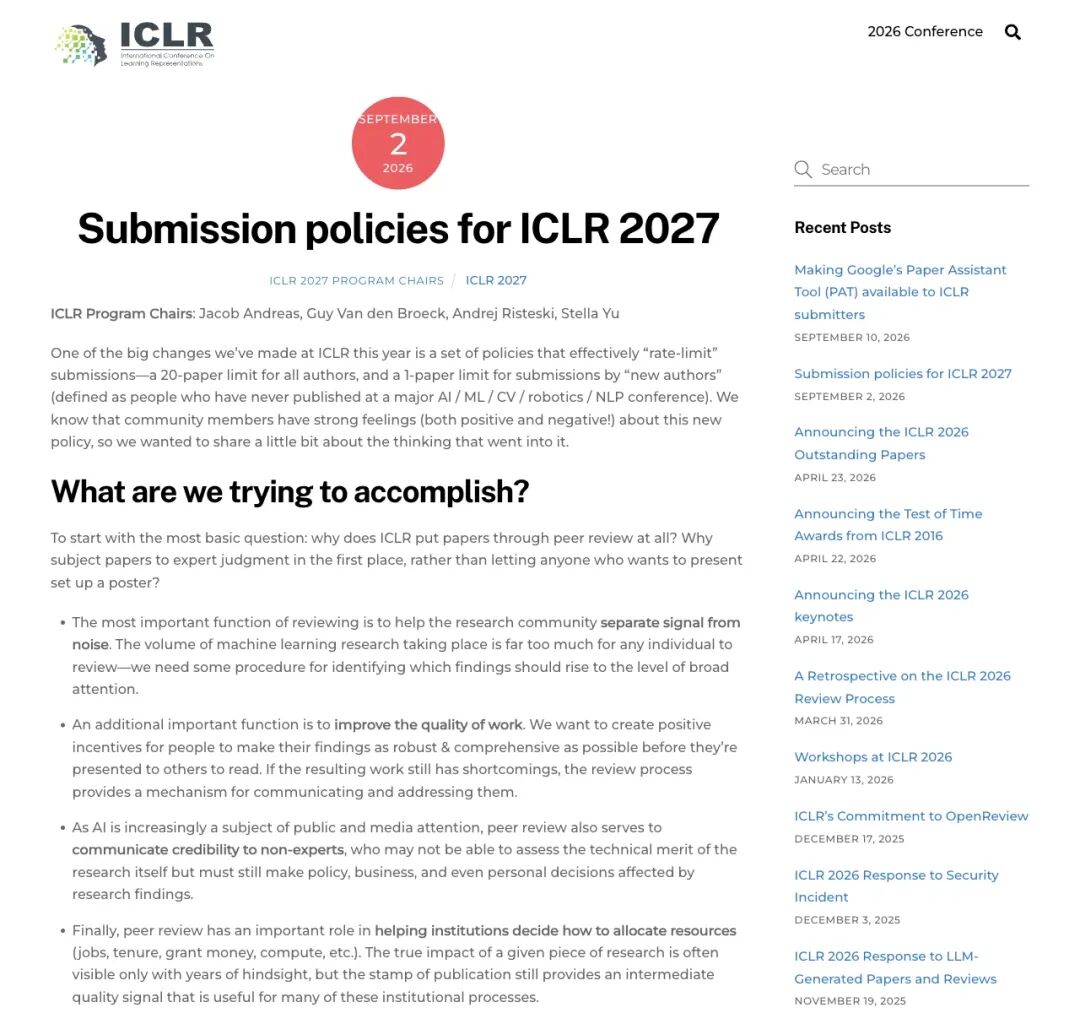
▲ ICLR 官方博客发布限流政策,试图从源头扼制无休止的“论文连环套”
如果说 ICLR 还在试图用配额治水,那么同为顶级会议的 ICML 则直接拉响了警报,开启了铁血镇压。
在 ICML 2026 的评审周期中,大会组织方通过技术侦测和行为痕迹,直接抓了现行:现场抓获并移除了 795 份违规使用大模型生成的审稿意见!
随之而来的是严苛的连带惩罚机制这些审稿人事前都白纸黑字签署了“独立评审、绝不使用大模型代写”的承诺书。既然有人背弃承诺用 AI 摸鱼,会议方直接启动了学术连坐:涉事审稿人名下作为作者提交的 497 篇论文,全部被当场执行“极刑”,未经评审直接 Desk Reject(初筛枪毙)!
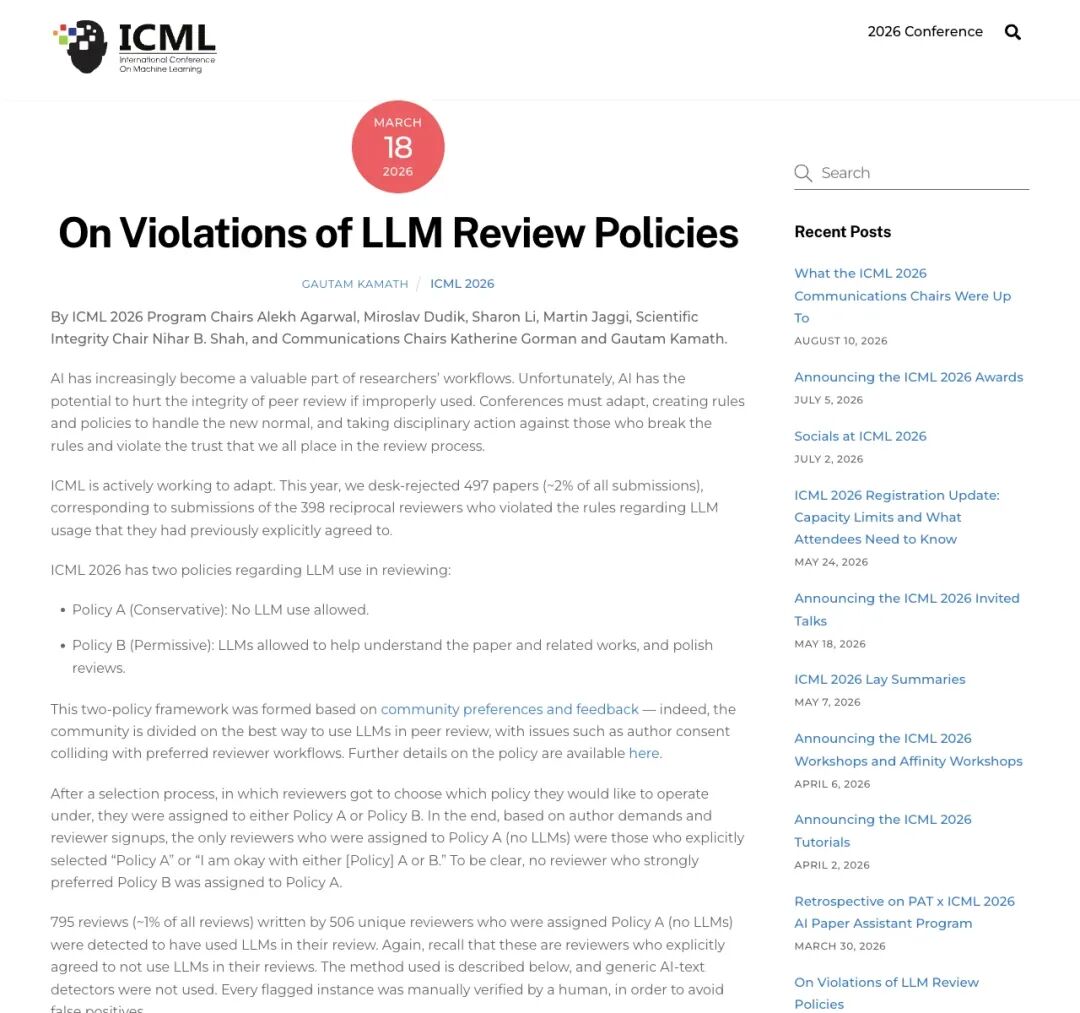
▲ ICML 官方毫不留情:移除 795 份 AI 审稿,连带初筛拒稿 497 篇论文
会议组织方在通告中强调,惩罚的要害在于欺骗与违背学术伦理契约,重在捍卫契约本身。
但这种猫鼠游戏真的能奏效吗?技术代差往往比制度执行更快一步
04.致命假象:“论文漂洗”与虚妄的自动化
“如果人人都用上 GPT-4o 或者最强的 Claude,让最好的模型来审,不就能去粗取精了吗?”
这种技术狂想,很快就被一项严肃的学术研究狠狠打脸。
在 ICML 2026 上,学者 Joachim Baumann 团队发表了一篇获得 Spotlight(焦点论文)荣誉的警示性研究,标题直击要害:《停止在未经严格评估的情况下自动化同行评审》。
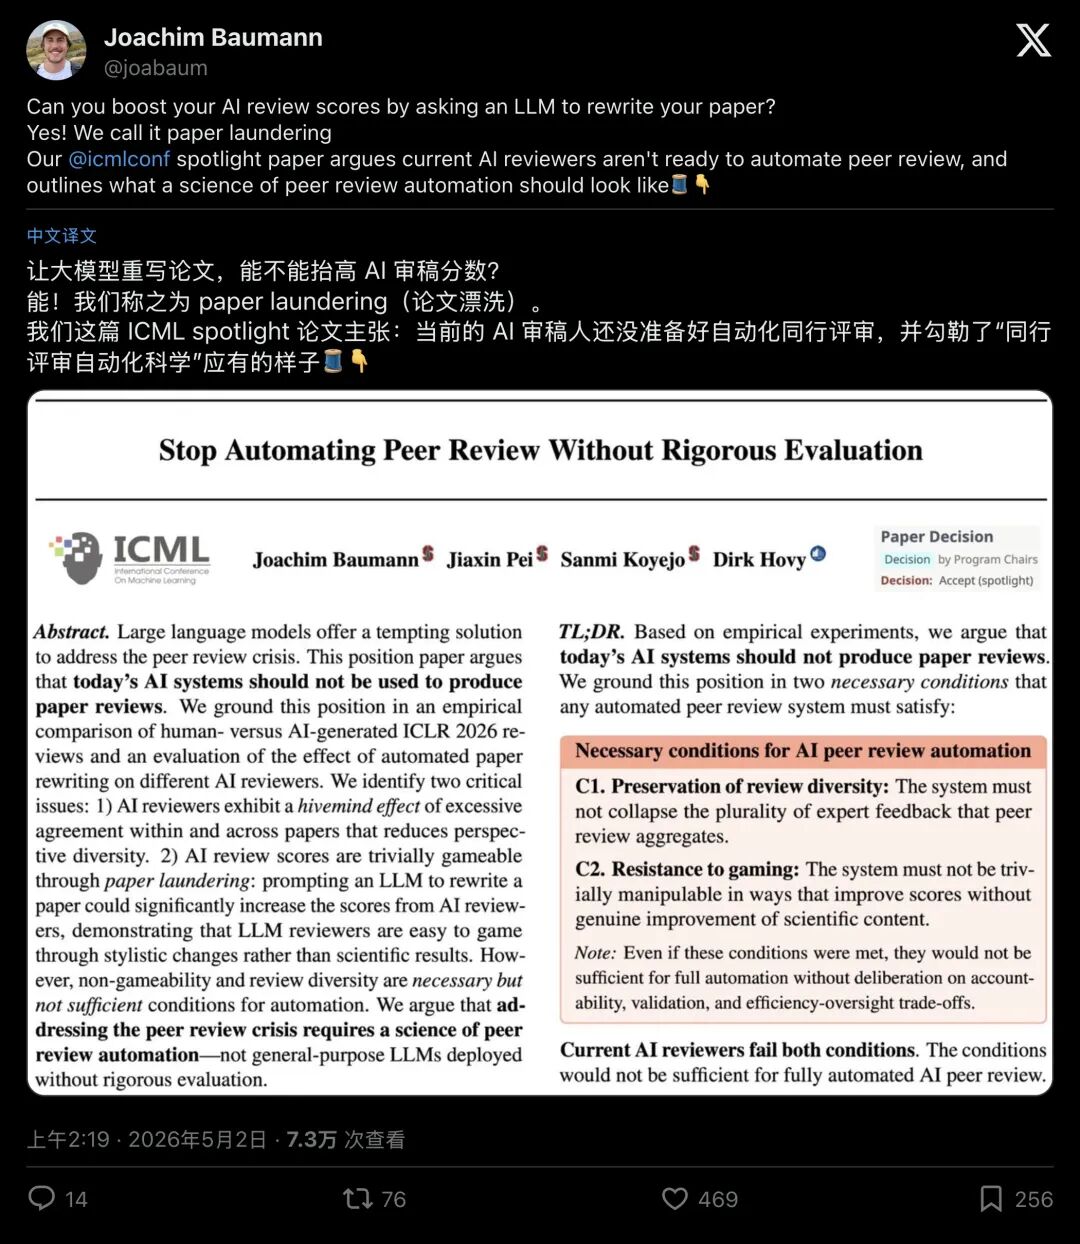
▲ Joachim Baumann 展示他们揭露的黑产式操作:Paper Laundering(论文漂洗)
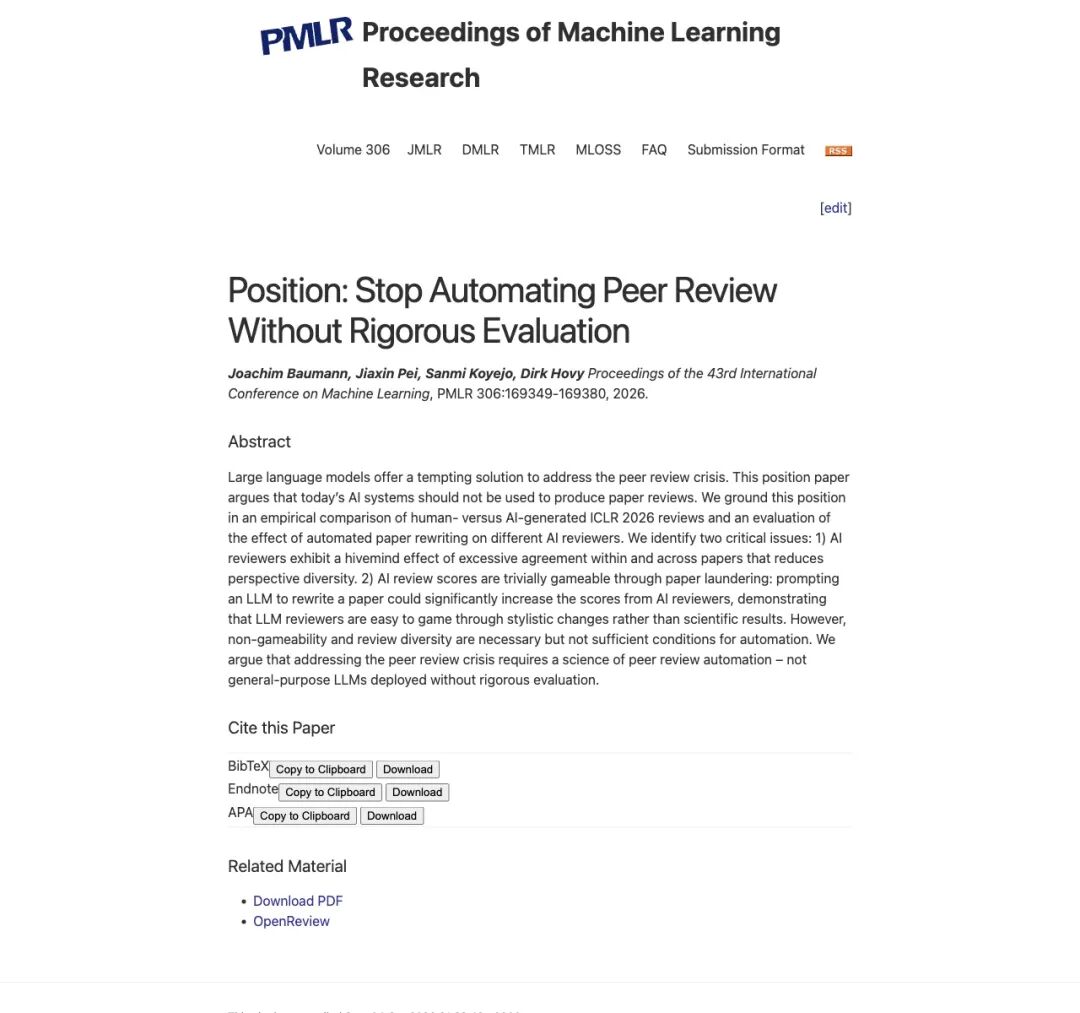
▲ 论文摘要尖锐指出:AI 审稿存在严重的同质化盲从,极易被表面改写所操纵
Baumann 团队在实验中揭露了一个极度讽刺的漏洞,“论文漂洗”(Paper Laundering)。
他们做了一个对照实验:论文的核心实验数据、图表、方法完全不变,仅仅让大语言模型把论文的文本风格重新润色、洗稿一遍。
实验显示:面对同一篇实质内容毫无提升的论文,AI 审稿人给出的分数竟然出现了断崖式的暴涨!
这种现象暴露出大语言模型缺乏严谨的科学辨别力。它评判论文好坏的核心依据,依然停留在遣词造句的流畅度、格式排版以及行文套路。
只要掌握了这套提示词套路,任何劣质研究都可以通过“语言漂洗”,轻易从 AI 审稿人手中套取高分。
不仅如此,来自斯坦福的 Daniel Fein 和学者 Cheng Go 也从底层逻辑上泼了冷水:
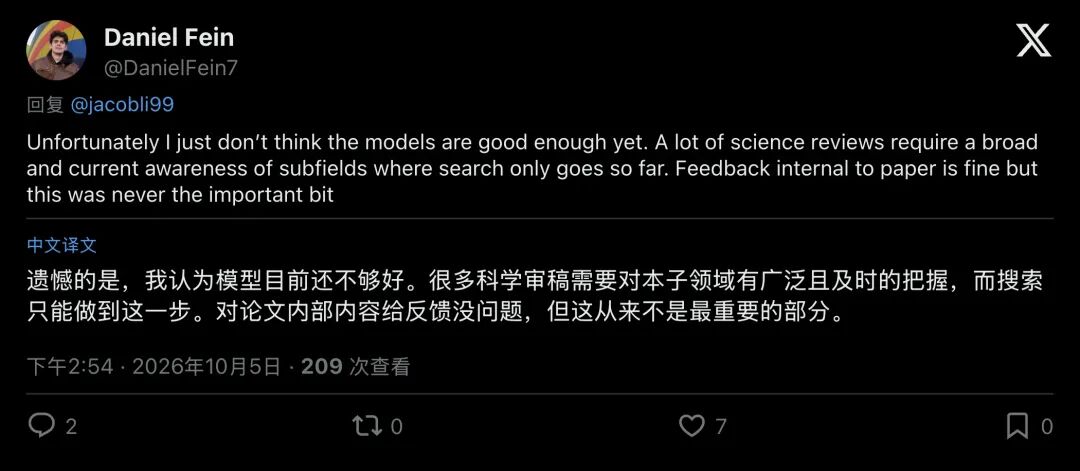
▲ Daniel Fein 指出,科学审稿的精髓是对细分领域的宏观洞察,而非纠缠字面细节
同行评议的深层价值,依托于审稿人对学科前沿长年累月的积累。这种洞察“研究方向是否成立”、“实验数据是否存在陷阱”的直觉判断,无法简单依靠几句 prompt 和网络检索所替代。
另一个深层隐患在于“错误的同质化”人类审稿人即便各有偏向,也保持着维度的多样性;倘若多数人依赖少数几家商业大模型的接口,由于训练语料相近、逻辑盲区重叠,极易诱发严重的“群体盲思”(Hivemind)。
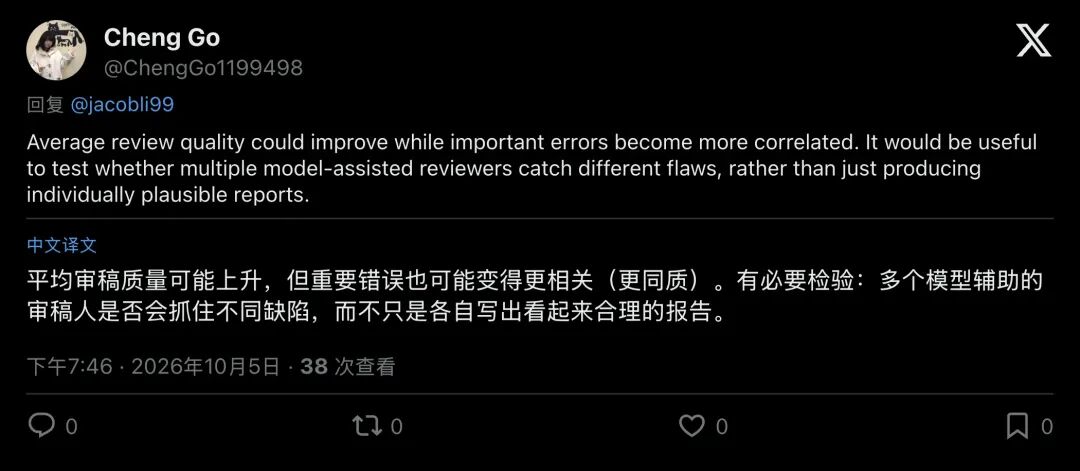
▲ Cheng Go 警告:表面平均质量看似提高,但重大逻辑漏洞的漏判却会高度趋同
当所有审稿人都陷入同一个极其隐蔽的逻辑盲点时,同行评议实际上退化为由单一大模型所支配的认知遮蔽。
05.无法逾越的高墙:保密红线与灵魂出卖
退一万步讲,即便未来的大模型真的聪明到了爱因斯坦的级别,学术界就能放手让它审稿了吗?
绝对不能因为还有一道不可逾越的制度红线:保密协议。
学术界对“审稿人喂大模型”最深层的担忧,根源于未发表手稿的知识产权泄密风险。
美国国家卫生研究院(NIH)在 2023 年下达了一份措辞极其严厉的死命令(NOT-OD-23-149):全面禁止在同行评审中使用任何生成式人工智能技术!
所有评审专家在上岗前,必须签署绝密保密协议。NIH 给出的法理依据切中了商业大模型的关键要害:
“商业 AI 工具根本无法向用户保证数据的流向、存储地点、谁能调阅,更无法保证这些数据未来会不会被用于模型的二次预训练。”
同行评审是一项基于极度信任的特权沟通(Privileged Communication)。作者把尚未发表、凝聚了团队数年心血的核心构想、前沿药物靶点、甚至商业专利原型交给你审阅。
而你,转手就把它复制粘贴进了某家商业科技公司的公网对话框里。
这在学术伦理和商业法律上,被统称为不可逆的泄密违规(Breach of Confidentiality)。你等于单方面剥夺了原作者对自己智力成果的独占控制权。
这也是为什么顶级学术会议不得不耗费巨大的算力,在局域网内搭建“官方沙箱”。
比如 ICLR 2025 曾经做过一次规模宏大的随机对照试验(RCT),用官方严密隔离的“Review Feedback Agent”为审稿人提供建设性修改建议,成果最终登上了《自然·机器智能》(Nature Machine Intelligence)。
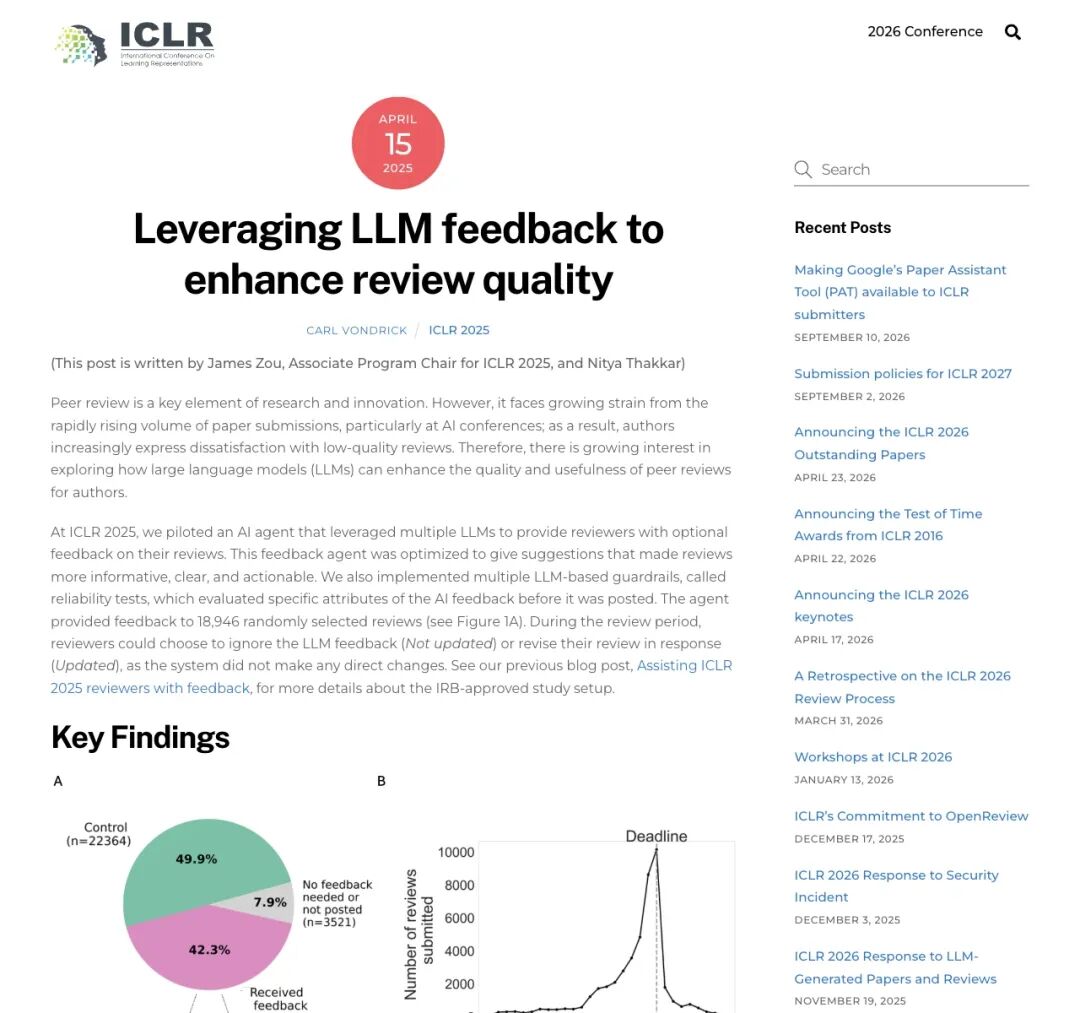
▲ ICLR 2025 探索官方受控沙箱,在数据不出内部的前提下辅助人类
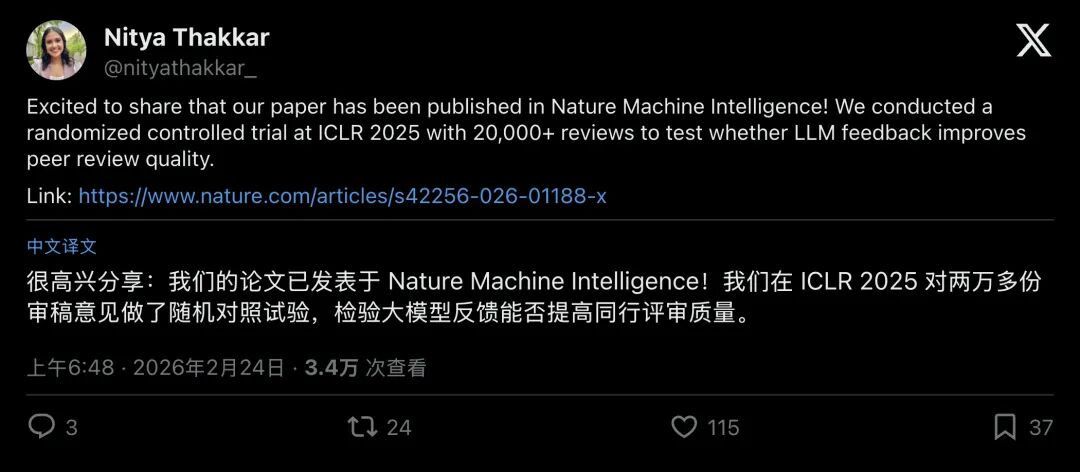
▲ 作者 Nitya Thakkar 宣布这项覆盖两万篇审稿的 RCT 研究正式见刊
官方沙箱证明了一点:在数据严密隔离的前提下,AI 可以充当辅助工具,提醒审稿人完善论证细节、改善沟通语气。这与将未经发表的手稿径直交付给外部商业模型代审,有着截然不同的性质。
同行评审最核心的底线,在于责任主体的确立。
同行评审的最终底牌,是审稿人押上了自己在学术圈几十年的学术声誉。一旦发生严重的抄袭、误判或学术不端,人类学者将承担撤稿乃至断送学术生涯的代价。
但大语言模型呢?大模型无法出庭作证,大模型不会被撤销职称,大模型更不会为任何伪造的数据感到哪怕一秒钟的愧疚。
把裁判权拱手让给一串代码,本质上是人类在学术求真道路上最懦弱的集体逃跑。
06.机器狂欢背后,谁来守住学术求真的底线
从最初的几百篇,到如今遮天蔽日的 60,000 篇。
这场发生在 2026 年的顶会危机,就像一场巨大的隐喻。
AI 没有凭空摧毁科学,它只是一面无比残忍的镜子。它像一台加速到极致的离心机,把现代学术体制中所有的浮躁、指标崇拜、造论文流水线和形式主义,以一种近乎荒诞的形式全盘甩在了桌面上。
如果一篇论文的价值,只在于用大模型凑齐 15 页漂亮辞藻去应付 KPI;如果一份审稿的价值,只在于用大模型生成几段四平八稳的官话去应付差事;那么这项耗资数以亿计的庞大体系,究竟是在推动人类认知的边界,还是在赛博空间里自娱自乐地倒卖电子垃圾?
科学求索的底色在于对未知的艰难摸索,在于勇于承担犯错的代价,在于实实在在的理性怀疑与尖锐批判。
当流水线的输入端是 AI,输出端是 AI,中间的安检员还是 AI 时,
科学并没有迎来奇点,它只是把大理石雕刻的殿堂,悄然置换成了一座喧嚣而空洞的无菌废墟。