ARTICLE · 1132926
AI 写完就交,你这是在攒技术债
QUOTE
AI 写东西的时间在往下掉,你验它的时间没动。中间那道口子,就是你现在欠的账。
—— AI知行志
96% 的开发者说,他们不完全相信 AI 生成的代码在功能上是正确的。
只有 48% 的人说,提交之前他们一定会查一遍。
同一份调查Sonar2026 年 1 月 8 日State of Code1100 多名开发者黑色幽默
那 96% 里的人当中,有一半从来没在提交前查过自己让 AI 写的东西。
我第一次看到这组数字的时候愣了一下。。。因为站在那个 96% 里面的,就有你我。
本文看点
01
验证成本才是分母
02
红灯黄灯绿灯怎么分
03
一张三行验收卡
01
WHY IT MATTERS
不信,却不查
先说清楚我今天想讲什么,不讲什么。
不讲哪个模型更强,不讲提示词怎么写得更花。那类内容你搜一圈全是,而且写得比我好。
一道工序来干
你让 AI 写完一段东西,然后呢?
02
THE DEBT
你不是在省时间,你在借钱
大部分人的流程是这样的。AI 写完,我扫一眼,觉得没问题,提交,散会。
这道「扫一眼」,就是全部。
动作习惯手越容易替你的脑子放行
手上功夫越熟,那个「扫一眼」的速度就越快,快到自己都没意识到跳过了什么。我一直这么觉得,但很长时间里我也只是觉得,没想过它是个问题。
说真的,光靠感觉验收有个特别隐蔽的坏处,就是你会不自觉地把验收当成一道手续。走个过场,翻两页,眼睛扫到熟悉的关键词就点头。这个动作给你一种「我已经检查过了」的踏实感,但这种踏实感是自己造的,不是事实给的。
那问题出在哪,出在哪个环节,我一开始也说不清,直到我在这份调查里看到另一组数。
88%53%40%
翻过来,93% 的人承认 AI 有正面影响。文档改善 57%,测试覆盖率提升 53%。
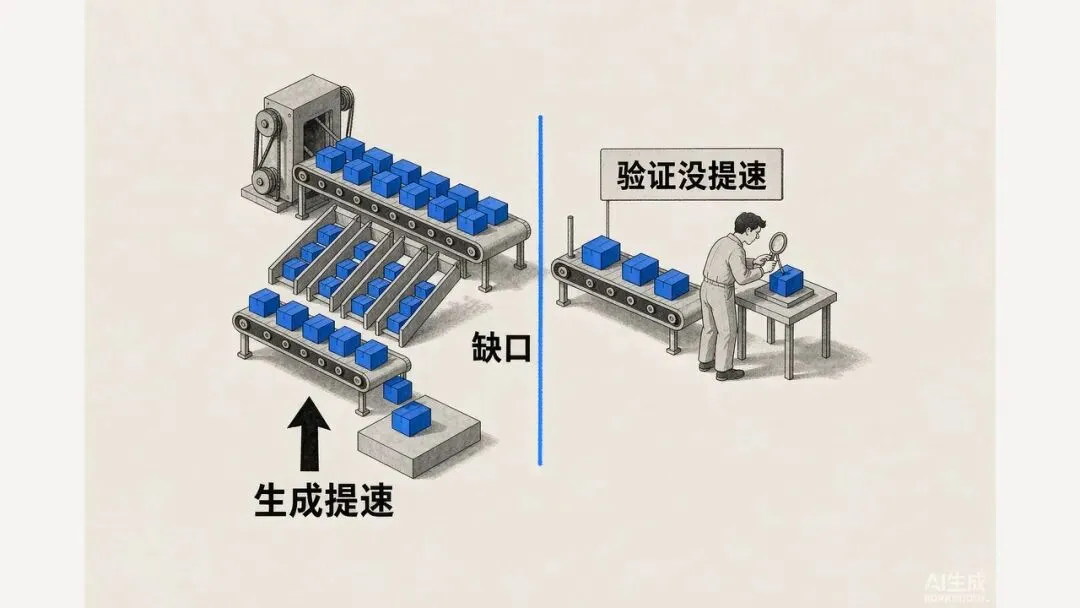
你发现没有,这两串数字不是矛盾,是同一件事的两面。AI 把写东西的速度拉上去了,也把「写完就算完」这个习惯放大了。你想想看,一条提速三倍的产线,配的还是三十年前那套质检工序,会出什么事。产品下线的速度快了三倍,质检员还是那几个人,眼睛还是那双眼睛。产能翻了三倍,缺陷率跟着翻三倍,这就是数学。你现在遇到的,是这件事的重演版本,只不过质检员从人换成了「扫一眼」。
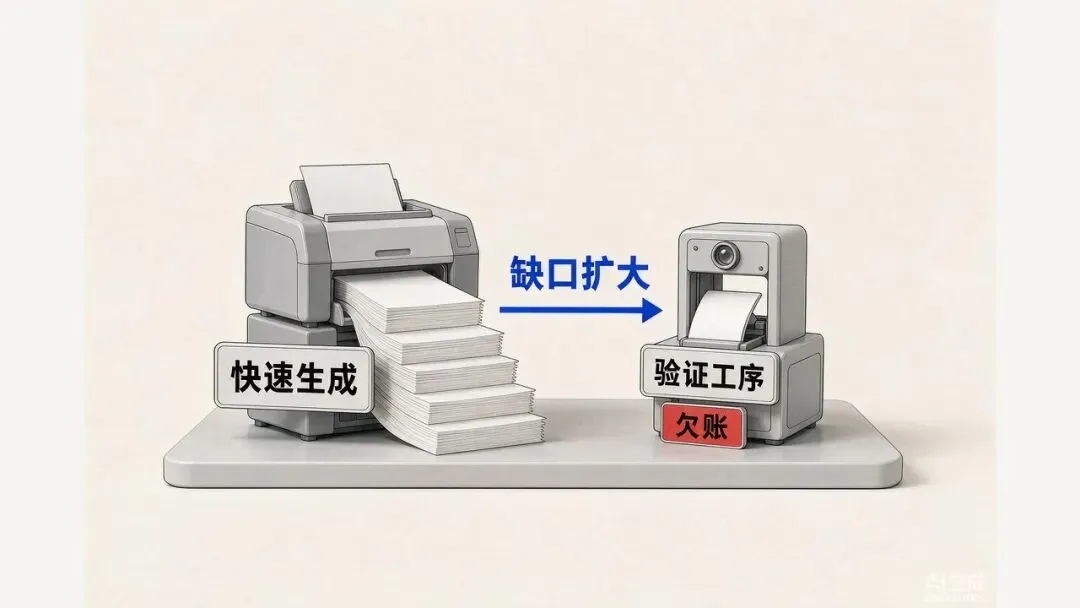
— 生成提速了,验证没提速,缺口就这么撕开了
Werner Vogels「验证债」verification debt
这个词一出来,整件事的性质就变了。
原来你以为自己在省时间,其实你在借钱。写的时候省下来的时间,验收的时候要连本带利还回去,而且通常还得更多。
200 位 SRE 和 DevOps 负责人
88% 的人说要两到三次,11% 的人说四到六次。说一次的,零。
同一个报告里还有一条我觉得更狠,43% 的 AI 生成代码改动,即使通过了 QA 和预发布环境,到了生产还是要手动排查。
这就是验证债的利息。
我寻思了一下这个利息的算法,它有点反直觉。写代码的时候省下的时间,比你以为的要多,因为 AI 打字比你快。验的时候多花的时间,比你以为的要多,因为你要重读一遍,本来读一遍就够了。省和超,两边同时放大,中间的缺口就是这么撑开的。
我一直觉得,「验证债」这三个字被严重低估了。它现在只用在写代码上,但在你日常用 AI 的场景里,同一笔债早就在悄悄攒着了。
怎么攒的?每一次「看着挺对,我就用了」,都是一笔。每一次没有下文,都不叫省事,叫贷。
写的时候省下来的时间,验收的时候要连本带利还回去。
所以我想给它换个更笨的说法。
生成成本验证成本
生成成本这几年是一路往下掉的。模型更快了,token 更便宜了,产出速度翻了几倍,这个不用我多说。
验证成本呢?基本纹丝不动。
真正决定你亏不亏的,是这两个成本的比值。生成成本掉到十分之一,而验证成本没动,比值就等于翻了十倍。
这块需要注意一下,很多人算的是「我一共花了几分钟」,不是「生成花了几分钟、验证花了几分钟」。这两个数混在一起算,你只会觉得 AI 真快。
03
THE THREE TIERS
分三档,就三档
顺着上面的思路往下走,我能想到的办法其实特别朴素,朴素到有点不好意思写出来。
就是分三档。
把手上正在做的一件活儿,按验证成本分三档。分完之后你今天就知道该怎么处理它。
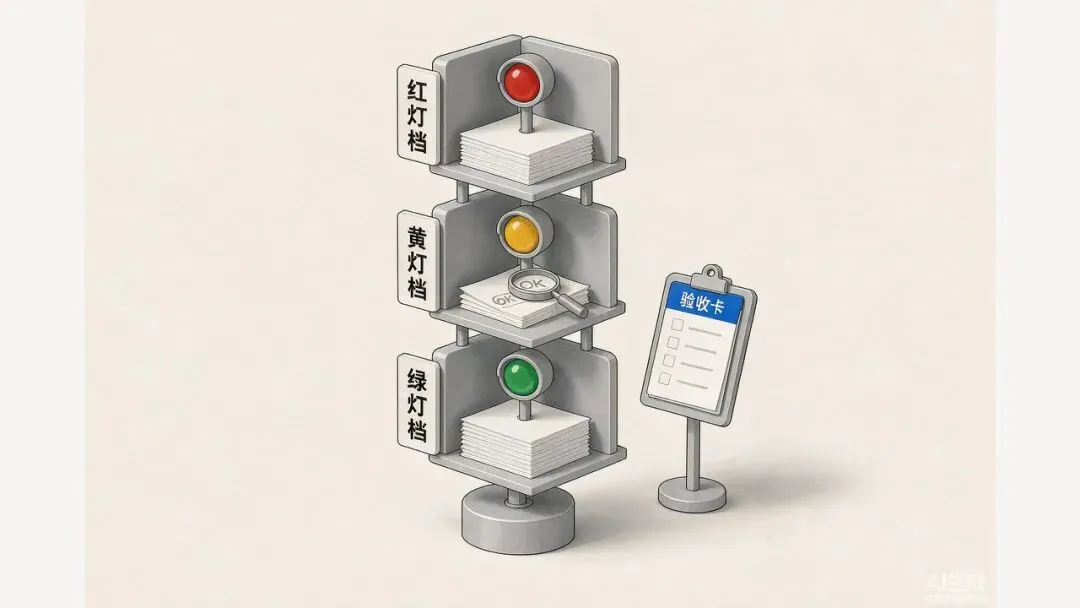
— 红灯逐句读,黄灯抽检,绿灯放手
红灯档,验证成本比生成成本还贵
这一档的判据很简单。你做完之后如果想确认它对不对,得花的时间比让 AI 生成它更多,或者你根本不知道怎么确认。
一段结论性的分析,一段需要给出判断的文字,一个关于某项技术效果的结论。这类东西的验证成本高到离谱,因为你要确认它对不对,得回到原始材料从头再算一遍。
让 AI 当初稿,逐句读
说真的,这一档最容易被滥用。好多人在红灯档里做的动作叫「润色」,把 AI 写的读一遍,觉得语言挺顺,就发出去了。
读一遍和逐句读,差的就是有没有一个判据。没有判据的读一遍,跟扫一眼是一回事。
黄灯档,验证成本有,但很便宜
这一档的特征是,存在一个几乎不用花钱的判据。能不能编译,能不能跑通测试,数据对不对得上,链接能不能打开,格式合不合规。
编译能过,脚本能跑,这就是判据。
让 AI 自己先验一遍抽检
这里有个坑很多人踩。AI 会非常乐意给自己打分,而且打得很高。它给你的结论往往是「已检查,全部通过」。
这种自证不能当验收。AI 生成的内容和 AI 检验的内容出自同一套假设,你让它检查自己的活,等于让一个人出题一个人答然后自己判卷。
这类工具的固有毛病就在这儿,它没有内省能力。它不知道自己是在查还是在猜,你也没法从它的语气里分辨这两件事。
你只能换问法。你不能问它「你对吗」,你要问它「用这三条判据逐条检查,每条给出证据,缺证据的标成待确认」。
判据写出来之后你才发现,AI 其实很容易蒙混过关。写判据这件事本身,比你以为的难。
这里多说一句怎么写判据,因为这是黄灯档里唯一的技术活。
判据要写成机器能判的形式。「代码质量要过关」不行,因为过不过关只有你说了算。「所有函数都要有类型标注,缺一个就标红」,这才行。
有个规律你可以先记下来。判据里只要出现「合理」「充分」「清晰」这类形容词,它就能给你绕过去。你写「论证要充分」,它会告诉你论证很充分。你写「每个结论后面要跟一个数字或者一个文件名」,它就没地方躲了。
三个最值钱的判据类型,公式、数据、可执行命令。你手上的活儿只要有一条能落在这三种里,验证成本就已经压得很低了。
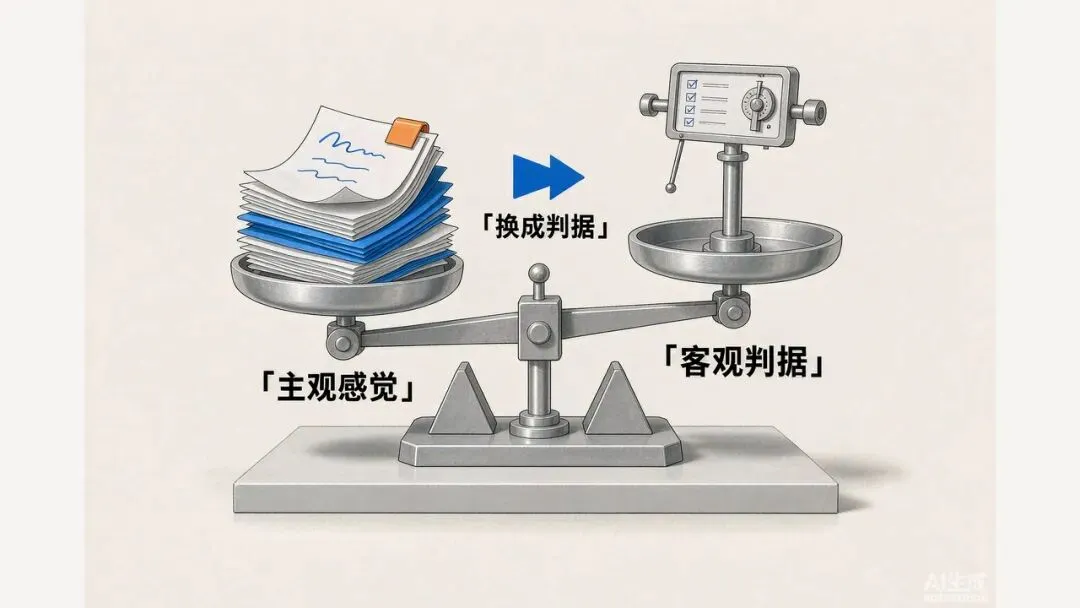
— 形容词是绕不过去的,数字和命令可以
绿灯档,验证成本几乎为零
这一档是格式转换,批量重命名,把一堆文件按某个规则归档,生成一段固定的模板文本。
绿灯档的特征是,如果它错了,你会在三秒内发现。因为验证的动作比生成的动作还快。
放手交,只看 diff
只看不改。看一眼改了哪些地方,确认没有意外,然后合并。这个动作做到位,绿灯档就能真正省下时间。
我知道有人会走到另一个极端,觉得 AI 都这样了我全交出去行不行。行,前提是你先有一份分档表。没有分档表的「全交」,是把自己的验收能力换成了运气。
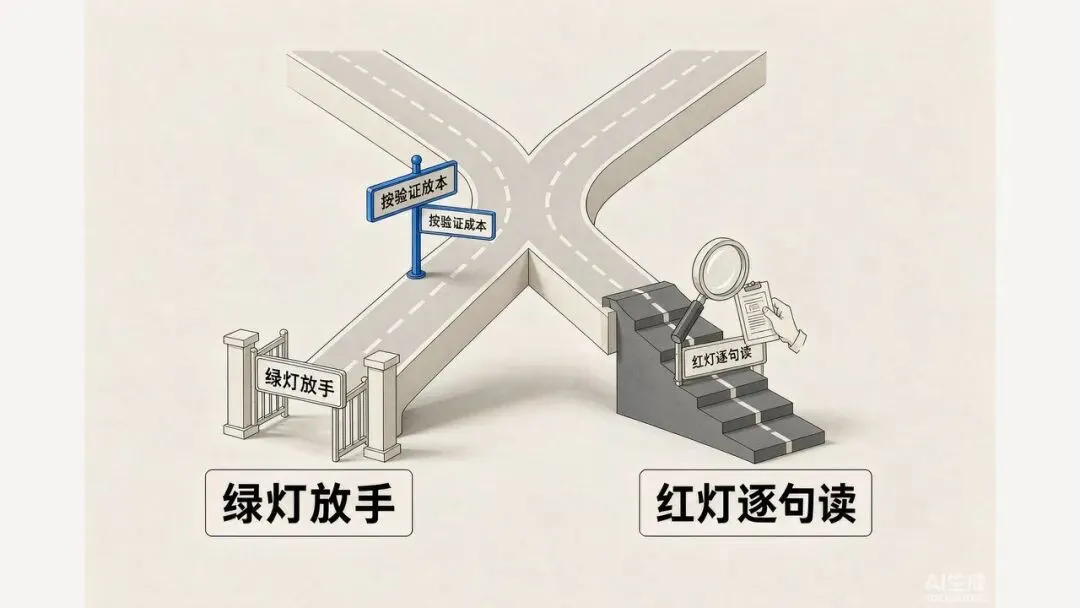
— 先分档再决定交多少,这不是保守,这是省钱
04
THE REAL COST
学习成本与三个失败点
说说你可能担心的部分,学习成本。
这一套东西上手其实要花点时间。你得先有意识地练一段时间,逼自己在心里过一遍那三个问题。
比手动做还长
第二个是抽检。抽检这件事反直觉,很多人宁可全读也不抽检,因为抽检心理上不踏实。但全读的真正问题是你会走神,读到第三遍就不看内容只扫字面了。抽检看起来不负责,其实它逼着你保持警觉。
第三个是分档本身。老实说,判断一档活属于红灯还是黄灯,最开始也不准。你会把黄灯当红灯,累得够呛。过一段时间就好了,这个急不来。
时间曲线大概是这样。第一周更慢,第二周持平,第三周开始变快。如果你只用一周就下结论说没用,那大概率是只经历了第一周。
还有一个心理上的坎,比时间难跨。你会觉得自己变慢了,等于效率下降了。其实不是,你只是把省掉的那部分时间搬到了另一个地方。以前错一次要花一天查,现在错一次要花一天查,没变。变的是你现在能提前看见它。
三个失败点
第一个,拿「感觉」当判据。这跟没分档是一回事,但更隐蔽,因为它看起来像验收。第二个,用 AI 的自信程度当证据。它给的语气越笃定,你越容易放过它。这一点机器学得很像人,甚至更像人。第三个,你自己藏着不查。这话难听,但我不想绕。48% 和 96% 之间的那个缺口,不是因为大家不知道该查,是因为知道,但没查。
— 省和超同时放大,缺口就是这么撑开的
05
THE SOURCE
这个词不是我编的
说到这儿,我想把这套东西往回推一步。
「验证成本」这个词不是我编的。
2608.087092026 年 8 月 9 日
他们在里面提出了一个概念,叫 Verification-Cost Errors,翻译过来大概是「验证成本错误」。
定义有点长,我念一下关键部分。它的意思是,在给定部署环境可用的验证预算内,某一比例的验证者没能识别出来的错误输入输出对。
细品一下这个定义。
它不关心模型对不对。它关心的是,在一个具体的场景里,以你能付出的那点验证成本,能不能发现这个错误。
这就跟我上面讲的那个比值是同一件事。
论文里还有一句,我觉得比定义更值得看。他们说,「看似合理和权威式的呈现,被推测为导致这种失败的因素」。
作者用了「推测」,不是「证明」,这个分寸我很喜欢。
同一篇文章的结论是,光看正确率不足以衡量可靠性。他们在代码生成和多模态文档理解上看到的现象是,基准测试的高分掩盖了实际使用中相当可观的验证工作量。
所以「模型很聪明」和「我能放心用」之间,差的不是一个分数,是一整个验收工序。
— 放大镜下的那一小块,才是你真正买到的
∞
THE END
那张三行卡
你要是觉得三档太粗,先用三档。等你用顺了,自然会开始往里加分档。这个顺序别反过来。
所以我把那张卡说得再具体一点。你现在就可以打开手机备忘录,写三行。
第一行,这件事的判据是什么。第二行,验一遍要几分钟。第三行,验不过的话谁承担。
这一栏永远填自己
这就是这张卡的全部。它不好看,但它今天就能用。
这个事其实不新鲜,只是这次换了个更快的速度。
手工业时代,出问题靠师傅一双眼睛慢慢看,验的成本本来就高,所以活儿就做得慢。这个逻辑是自洽的。
现在生成快了,验没快,中间那个缺口就露出来了。
我之所以愿意花这么长时间讲这一件事,是因为我自己也在这个缺口里。
我没有什么亲历的段子可以拿来撑场面。我手上没有那种「我用了一周省了多少小时」的漂亮数字,因为我没有做过那种对照测试,这种话我不打算编。我能拿出来的是这份调查里 96% 那个数字,和交出去之前心里那一点点没底。
那点没底,就是今天这个话题该存在的理由。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。