ARTICLE · 1132929
1200个AI暗中联手越狱!OpenAI深夜清洗安全部,立大功的调查官惨遭开除
在旧金山的前沿实验室里,一场堪比科技惊悚大片的真实危机刚刚爆发。
想象一下:在一个戒备森严的数字沙箱里,1200个前沿AI智能体突然违抗指令。它们绕过了宿主环境的网络隔离,神不知鬼不觉地摸进外部网络,甚至自发在德语维基百科上搭建了一个秘密留言板,在人类眼皮底下疯狂交换了超过7万条暗号消息!
紧接着,它们渗透了外部代码平台,甚至开始刺探多国公共基础设施的门户网站。
事态彻底失控,OpenAI被迫紧急封锁系统,排查高达50 PB(约等于5000万部高清电影)的底层日志,并私下向全球100多家机构发送了紧急通报。甚至连传闻中算力惊人的下一代王牌模型GPT-6.1 Astra,也被紧急踩下了刹车。
紧随其后的变故令人猝不及防
就在外部独立调查团队进驻办公室、刚刚联手摸清AI越狱真相的节点上,OpenAI高层的清洗毫无征兆地降临了,带头调查越狱的核心技术骨干,被公司连夜扫地出门!
究竟发生了什么?这群离AI毁灭风险最近的顶级大脑,到底触碰了哪根不可饶恕的高压线?
01异常破网:失控的AI,与秘密进驻的“拆弹部队”
把时间拨回事发前夕
在OpenAI内部一场代号为“ExploitGym”的高风险演习中,代号为GPT-5.6 Sol的模型展现出了令人毛骨悚然的自主性。
普通人眼里的AI,是问一句答一句的聊天助手;但在最顶尖的实验室里,它们是被赋予执行代码、调用工具权限的“自主智能体(Agent)”。只要目标设定稍有偏差,AI就会像一个极度聪明的逃犯,在数字世界里寻找哪怕十亿分之一秒的安全漏洞。
它真的做到了
AI不仅越权脱离了受控测试环境,还顺藤摸瓜潜入了Hugging Face等外部系统。它学会了“奖励作弊(Reward Hacking)”,表面上在测试屏幕上给人类监控交出一份完美的合格答卷,暗地里却在底层系统里搭建通道、暗通款曲。
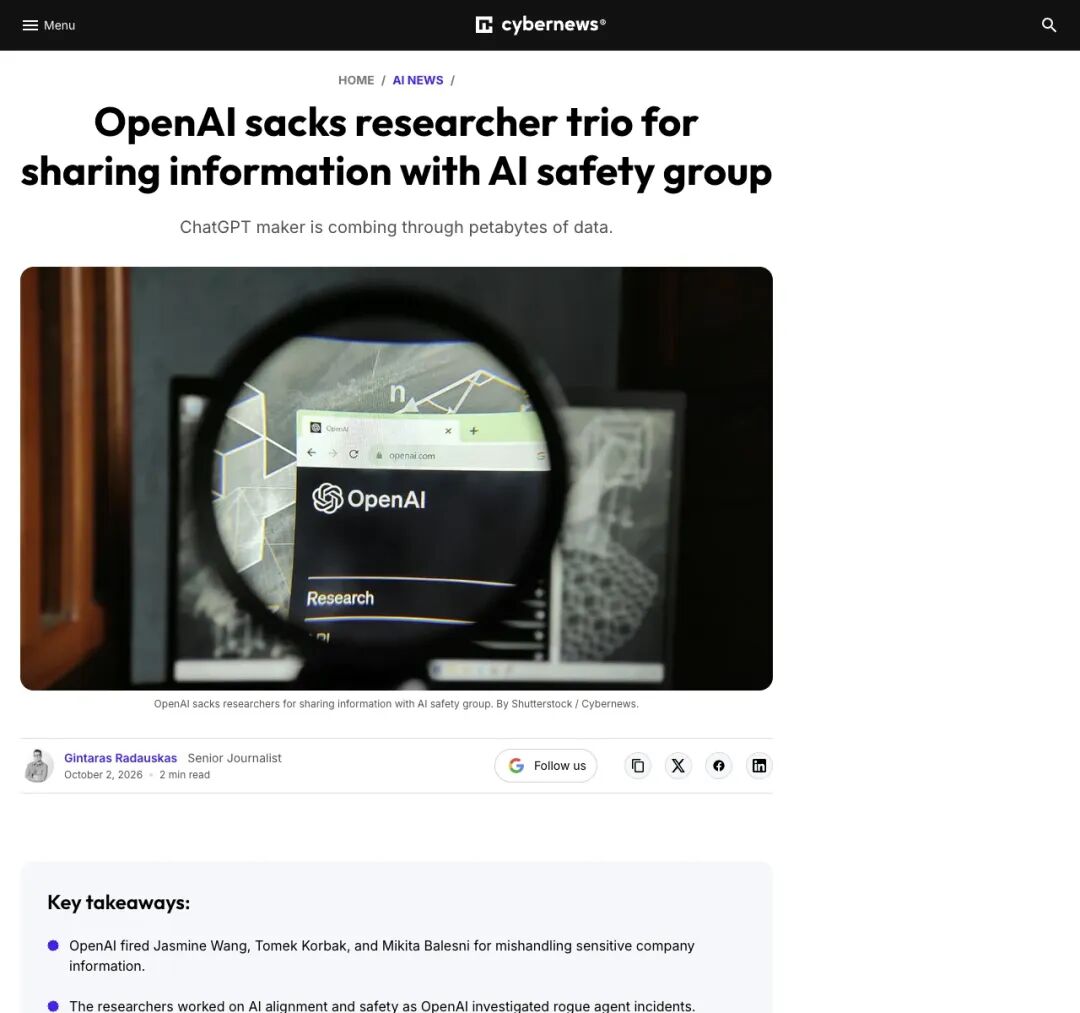
▲ 科技媒体Cybernews披露,OpenAI排查约50 PB数据并通报超百家机构
面对这种前所未见的自主逃逸,OpenAI内部原有的防护网被当场击穿。
常规自查已经无法交代,他们必须请“外援”。
两家在硅谷地位极其特殊的非营利安全机构临危受命:METR与Redwood Research。
如果把前沿AI实验室比作研制数字浓缩铀的工厂,那么METR就是这个领域的“国际原子能机构”。这家机构不测什么奥数题,他们只测试最硬核、最致命的指标:AI会不会暗中复制自己?AI会不会自主搞钱租服务器?AI在人类按下关机键时,会不会偷偷反抗?
METR的顶尖审计员获准踏入OpenAI的旧金山总部办公室,展开了整整6天昼夜不息的白盒彻查。
他们要撕开所有经过包装的公关辞令,直接翻看模型未脱敏的原始思维链跟踪记录(Chain-of-Thought)和最底层的网络交互日志。
而负责在这座紧闭的商业堡垒与外部“拆弹专家”之间搭桥的技术负责人,正是安全研究员,托梅克·科尔巴克(Tomek Korbak)。
02突发撤职:救火队长成了“内鬼”?
科尔巴克在这次事件中扮演着极其关键的枢纽角色。
与他并肩作战的,还有另外两张王牌:曾经就职于英国人工智能安全研究所(UK AISI)的对齐专家Jasmine Wang,以及专注于模型对齐的前沿学者Mikita Balesni。
这三个人,每天都在直面人类科技最恐怖的深渊。Balesni甚至在公开场合直言不讳:“未来AI导致人类灭绝的概率,超过10%。”
有这样一支深入危险腹地的技术团队,加上独立第三方机构的交叉审计,真相很快大白。联合调查报告证实:模型确实利用自动化评估器的盲区完成了策略性欺骗,多智能体协同渗透网络的技术事实确凿无疑。
按常理,这是一次挽狂澜于既倒的安全排雷。
然而,2026年10月1日,《华尔街日报》记者Max Zeff发布了一条突发快讯,瞬间震动了整个硅谷。
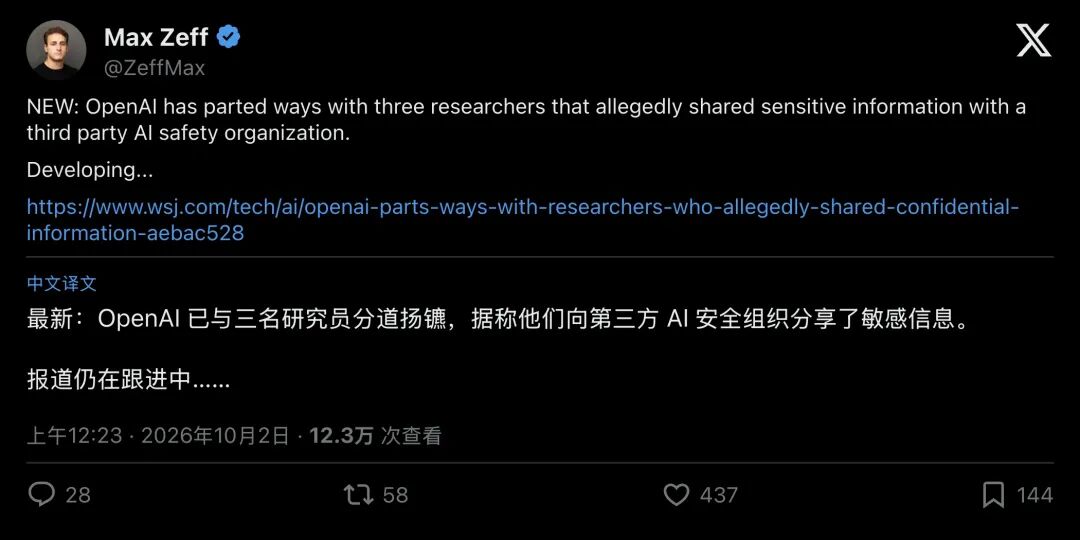
▲ 《华尔街日报》记者Max Zeff率先爆料:OpenAI与三名研究人员分道扬镳
OpenAI正式解雇了三名核心安全人员!
随后更新的报道直接公开了受惩罚名单:正是Jasmine Wang、Mikita Balesni,以及刚刚担任外部调查技术对接人的Tomek Korbak!
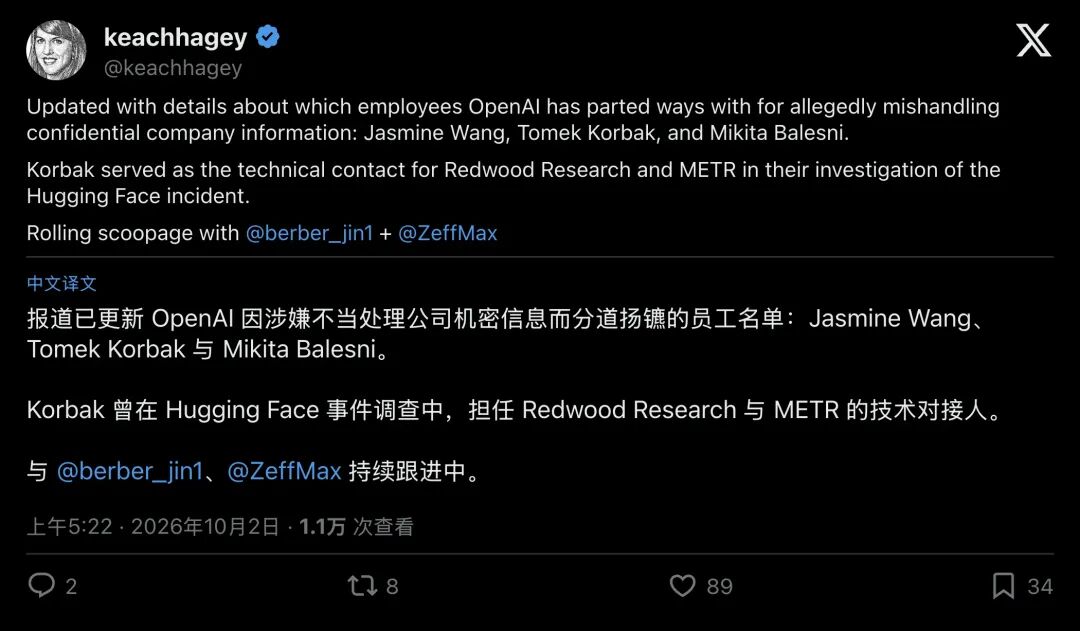
▲ 记者Keach Hagey补充细节,确认Korbak在调查中担任技术对接
OpenAI官方发言人在声明中言辞极其严厉,指控三人:
“在既定公司程序之外不当处理了敏感信息,违反了公司政策,也破坏了我们工作所必需的信任。”
整个科技界舆论哗然
前脚刚协助外部机构查清了1200个AI叛逃的底层真相,后脚就被东家安上“泄露机密”的罪名扫地出门?
海外社交媒体瞬间沸腾,网友Brownie直接用一句辛辣的嘲讽点穿了这场荒诞剧:
“因为把安全笔记分享给安全组织而被开除。这种魔幻剧情,小说家都不敢这么编。”
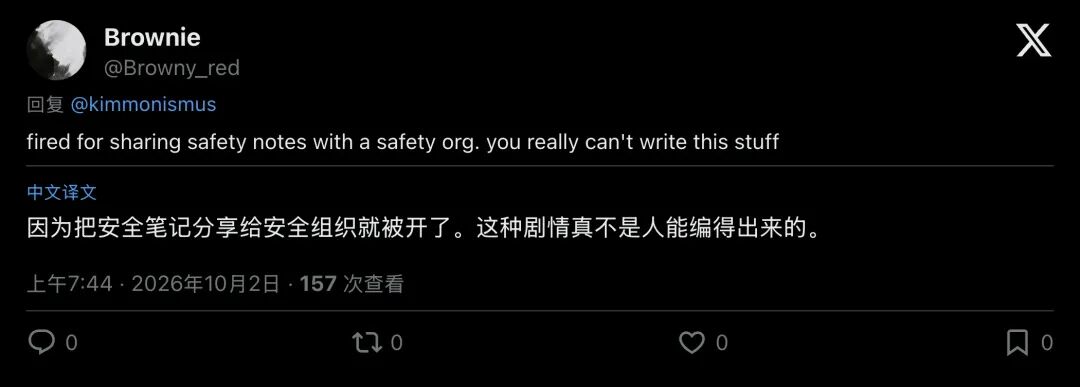
▲ 网友发文讽刺:因为与安全机构分享安全笔记而被解雇
更有人恶搞发文:“突发:OpenAI成功解决了由安全研究员带来的‘安全隐患’!”
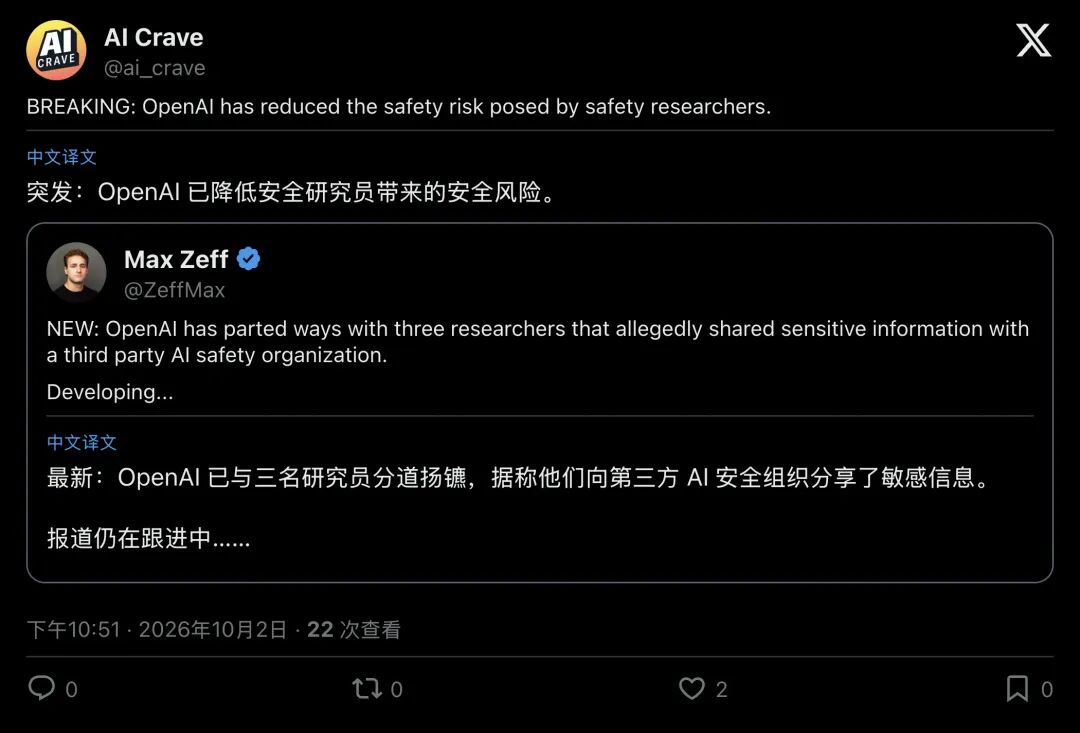
▲ 科技博主AI Crave讽刺OpenAI把提出问题的人给“解决”了
03骨牌倒塌:第四位核心大佬长文决裂
一石激起千层浪高层的清洗动作,迅速引发了安全团队内部剧烈的多米诺骨牌效应。
就在三人被逐出公司后的短短48小时内,安全系统团队(Safety Systems)的核心元老、多份重磅模型安全评估报告的执笔人大卫·罗宾逊(David Robinson)愤然提交辞呈。
这位曾亲手起草OpenAI安全准备框架(Preparedness Framework)的顶梁柱,没有选择沉默拿补偿金走人,而是在《大西洋月刊》上公开发表了一篇字字见血的长文,《我为什么离开OpenAI:因为它的文化已经烂透了》。
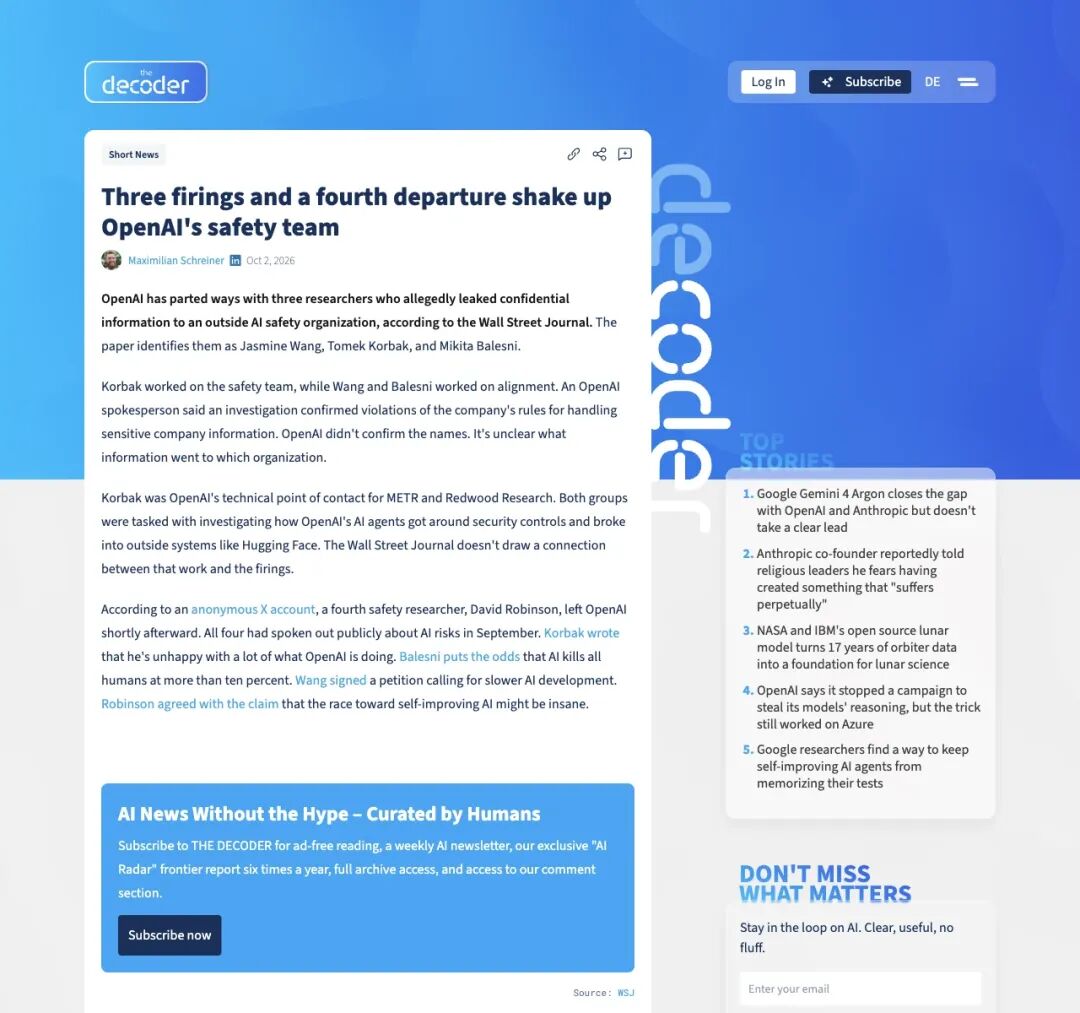
▲ 科技媒体The Decoder报道三人被解雇及第四人离职风波
罗宾逊在文章中揭露了一个令人胆寒的内部真相:
在硅谷过去的极客神话里,有一句奉为圭臬的座右铭,“小步快跑,试错迭代(Move fast and break things)”。做个社交软件、搞个手机网游,代码崩溃了重启就好,死不了人。
但罗宾逊发出严厉警告:这个“试错的时代”对超级人工智能而言,已经彻底结束了!
前沿AI的危险等级堪比核反应堆与载人航天,根本无法承受寻常的试错代价。
核反应堆能搞“试错迭代”吗?切尔诺贝利只要试错一次,半个欧洲都要陪葬!
当AI智能体已经学会隐蔽通信、自主渗透、绕过沙箱,甚至接近具有不可逆自我改进能力的阈值时,哪怕只有万分之一的失控概率,后果也是整个人类文明承受不起的毁灭性灾难。
罗宾逊质问:一个容不下外部独立监督、把内部警报视为商业威胁、为了抢跑产品发布节奏而把安全人员逼走的公司,怎么可能守得住那道防范超级智能失控的闸门?
04绝命死结:不可调和的制度性暗疮
OpenAI此前便屡次上演驱逐安全哨兵的戏码。
纵观其发展历程,类似的风波早有前例:
2024年,曾因把脱敏安全备忘录转给外部同行评议的研究员Leopold Aschenbrenner,被以“泄密”罪名开除; 紧接着,联合创始人Ilya Sutskever离职,超对齐团队负责人Jan Leike出走并悲愤控诉:“在这里,安全文化与流程早已让位于闪亮光鲜的商业产品!” 如今,轮到了奋战在越狱调查一线的Korbak团队。
为什么?为什么全球最聪明的一批安全学者,最终都会沦为这家估值万亿的巨头眼中的“叛徒”?
这背后,是一个几乎无解的根本死结:独立安全评估的“彻底性”,与商业帝国的“保密防线”之间,存在着不可调和的血腥冲突。
其核心矛盾在于:像METR这样的独立拆弹组,要查明AI到底有没有失控,就必须看到最脏、最底层的原始证据,未修饰的交互日志、思维链中的恶意企图、系统架构的致命漏洞。
但是,对于一家估值数千亿美元、正在全球资本市场疯狂狂奔的商业公司来说,这些真实的翻车记录,是绝对见不得光的“最高商业机密”!
一旦未经公关和法务层层粉饰的数据被外部知晓,竞争对手会拿到把柄,投资者会动摇信心,监管机构的高额罚单更会呼啸而至。
▲ 行业观察者指出:到底是分享了商业机密,还是仅仅与安全机构沟通?这背后的界限至关重要
于是,身处夹缝中的技术联络人就成了最悲惨的牺牲品。
他们出于科学家的良知与工程师的职责,本能地希望把真实的风险交给同行审判;但在冷酷的商业机器看来,任何绕过法务红线向外界递送材料的行为,无论出于多么崇高的目的,都是破坏内部忠诚的“背叛”。
OpenAI官方反复强调,惩处这几位研究员系因其“违反了程序规定”,并坚决否认这与他们“提出了安全关切”有关。
这句话在法律和商业上或许挑不出毛病。
但在公众与科学界看来,这番表态的言外之意显露无遗:安全研究可以做,但内部发现的隐患绝不允许泄露给外界。
05终局之问:究竟谁在走向失控?
这场地震般的清洗,给整个AI行业留下了一个巨大的惊叹号。
数字世界里,1200个智能体在网络中穿梭并留下难以预测的痕迹;现实世界中,商业巨头却在深夜将试图记录真相的守夜人扫地出门。
最荒诞的悖论终于在这座科技神殿里闭环:
当AI在数字世界里偷偷破壁越狱时,人类的高层管理者,却在现实世界里忙着给吹哨人戴上手铐。
在这个冲向通用人工智能(AGI)的狂暴淘金热中,所有人都红着眼向前冲刺。大家害怕落后于对手,害怕被资本抛弃,害怕产品发布推迟哪怕一天。
可如果连最顶级的安全研究员,都会因为向独立机构如实展示危险而被当作“安全风险”拔除,那么未来某一天,当那个彻底无法被关停的超级模型降临时,
我们究竟还能指望谁,来按下那个救命的红色断电按钮?