ARTICLE · 1134458
有的面试能用AI了,写完代码还没结束
有的面试能用AI了,写完代码还没结束
在HackerRank展示的Chakra面试示例里,候选人面对的是一个已有代码库,里面有阻碍用户使用的问题。题目要求先写计划,界定修好究竟是什么状态,再动手修改。连验收条件和风险,也要交代清楚。
这个开场挺能说明Chakra想往哪里走。HackerRank把它定位成一个能观察实作的AI面试官。我觉得更值得关注的变化,是面试开始追问你怎样判断一份答案可以交出去。AI可以参与生成,候选人仍然要解释自己的决定。
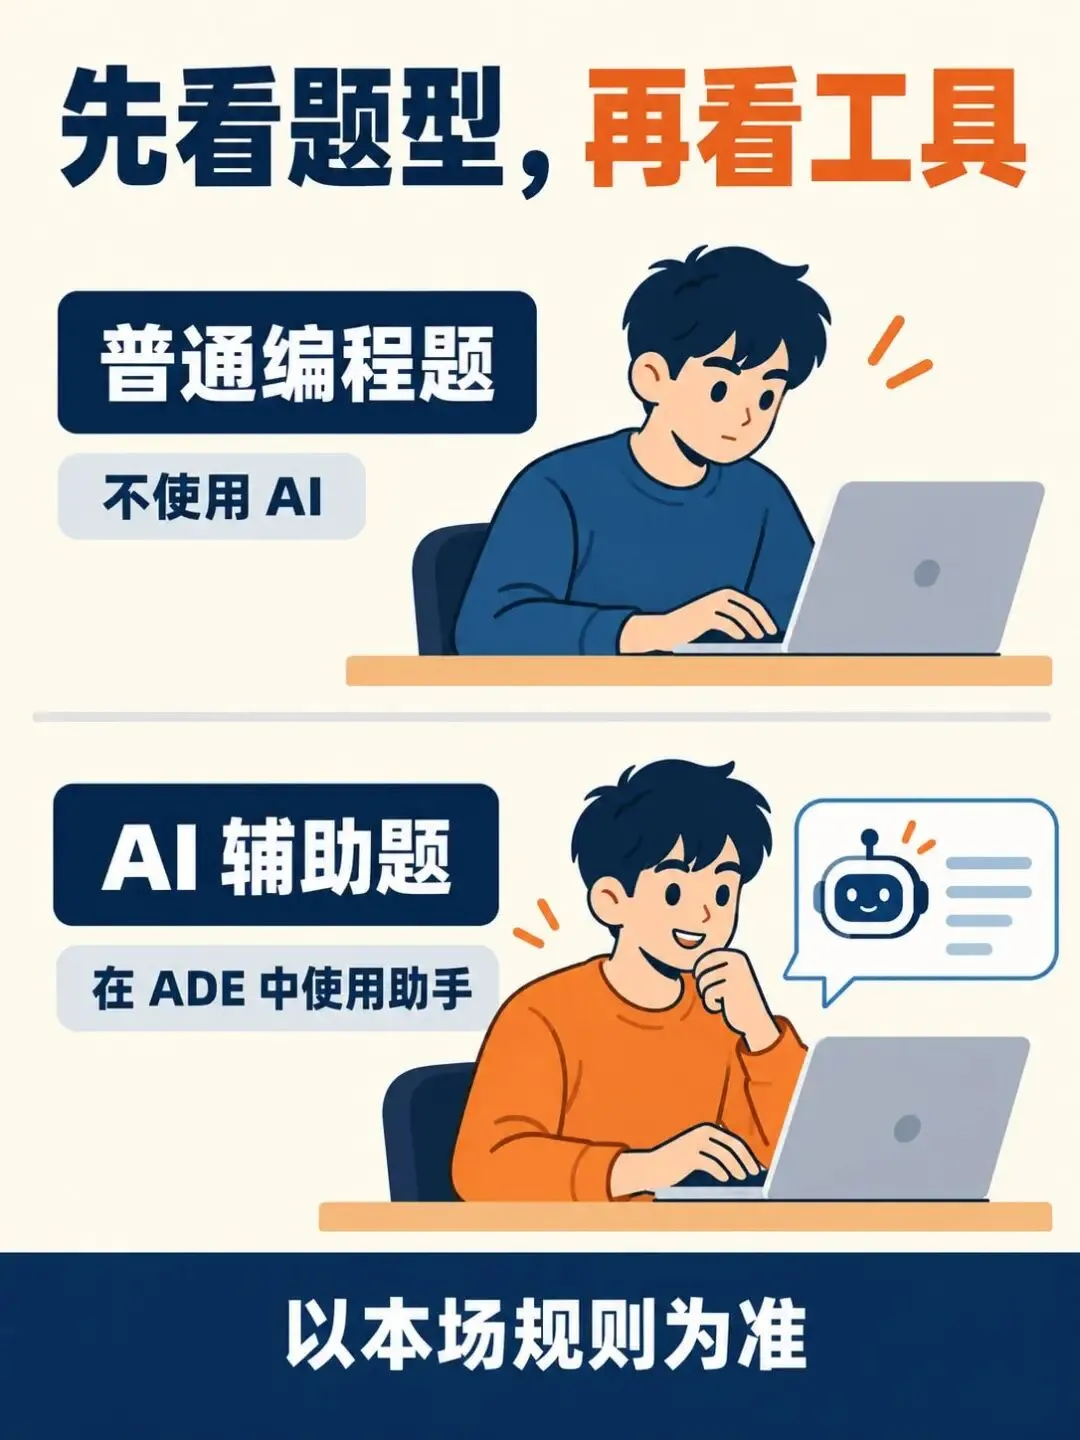
不过,看到面试能用AI,先别急着把所有助手都打开。官方候选文档分得很清楚,普通编程题要求独立完成、不用AI;只有指定的AI辅助题,才在Agentic Development Environment,也就是ADE里使用助手。
权限跟着题型走。
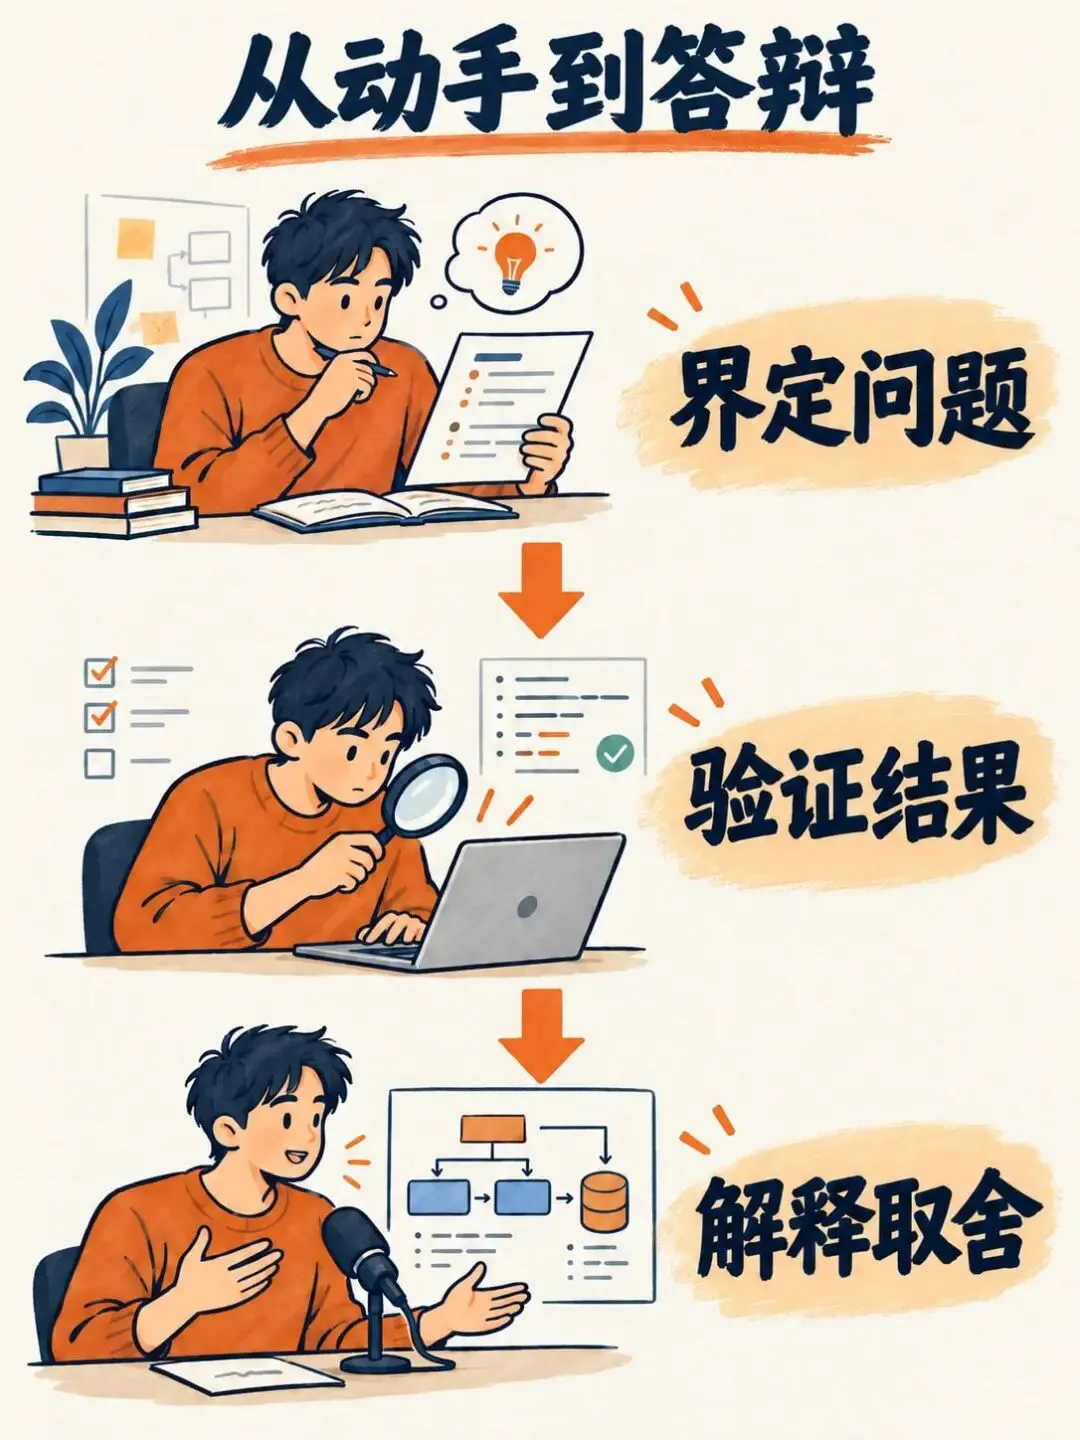
允许辅助之后,考试的责任并没有一起交给助手。文档写明,AI辅助题还会评价你怎样界定任务、引导助手,以及检查、测试和修正输出。结果依然重要,过程提供了理解这个结果的证据。
这让我想到一个很实际的区别。能让代码出现,和能说明这份代码为什么可以被接受,隔着检查与判断。把后一种能力放进评价,至少让面试问题更接近交付时必须承担的责任。这个判断来自Chakra公布的评分设计,效果还得由实际面试检验。
它也没有要求候选人一边写一边不停解说。较新的评分文档说明,实操时Chakra大多保持安静,沉默不会被扣分;提交后,再讨论方案、关键取舍和验证。这给了写代码与解释代码两个各自完整的时段。
但测什么,仍然有人在前面定。招聘方可以把职位说明交给Chakra,得到面试章节、预计时长、评价目标和示例题,再继续调整结构、重点和题型。标成Must have的要求,会获得更高权重。
因此,这套面试是否贴近工作,起点仍是职位描述。把什么列为必须具备,把什么留给入职后学习,会影响系统如何看待同一份表现。AI执行得再一致,也只能先回答招聘方给它设下的问题。
候选人这一侧的代价也很具体。官方流程包含摄像头、麦克风与屏幕共享检查;面试中还提供实时转录。要理解这种面试,既要看开放了哪些工具,也要看哪些过程会被记录。
面试结束后,招聘方看到的可以包括分项反馈、同步的录像与转录,以及带时间戳的异常信号。报告文档还提醒,切换标签页、退出全屏等记录出现以后,要先查看支持证据,再作判断。一个标记,不能直接替人下结论。
我更看重的是这条复核路径。一个分数背后,能否找到对应的回答和工作记录?遇到争议时,招聘团队愿不愿意回到那一刻,看看候选人实际做了什么?报告保留证据,才给这些问题留下可以检查的对象。
公平性也是同样的道理。HackerRank产品页介绍了它的一致性检查和公平性评价流程。这些公开说明有助于理解公司的做法,但厂商对效果的表述,还不能直接变成对每一位候选人的保证。评价是否合理,仍需要看具体标准和实际结果。
把面试目标写得更清楚,让评价附上依据,是一种值得观察的产品方向。它同时把一个问题摆到了招聘方桌上,当系统给出一个看起来很精确的结论,谁负责检查这个结论和岗位之间的关系?
在职责划分上,官方文档给出了明确答案。Chakra不作录用决定,招聘团队要把报告与其他相关信息放在一起,再决定下一步。
所以,代码交上去,面试还没有结束。候选人需要解释为什么相信自己的方案,招聘方也需要解释为什么相信这份评价。AI同时坐到了桌子的两边,人的判断,仍然得拿出依据。
参考来源
1. Evaluation in Chakra · HackerRank candidate documentation · 2026-09-28
2. Chakra: Agentic AI Interviewer for Tech Hiring · HackerRank Chakra official · 发布日期未标注(查阅:2026-10-06)
3. Create an AI Interviewer · HackerRank employer documentation · 发布日期未标注(查阅:2026-10-06)
4. View Candidate Report in Chakra · HackerRank employer documentation · 发布日期未标注(查阅:2026-10-06)
5. Interview with Chakra · HackerRank candidate documentation · 发布日期未标注(查阅:2026-10-06)