ARTICLE · 1135314
财务自动化,不只是把数字填进Excel
月底最后一天,财务人员打开十几个 Excel 文件:导出明细、清洗字段、核对部门、调整科目、汇总金额,再把结果一格一格填进既定模板。
表终于做完了,但新的问题随之而来:
这笔数字从哪里来?为什么归到这个科目?使用了哪一版规则?如果下个月再做一次,能不能得到同样的结果?如果审计人员追问,除了最终那张表,还能不能提供一条完整、清晰、可复核的过程记录?
这正是财务自动化真正需要解决的问题。
简单地把人工复制粘贴换成程序,把报表生产过程变成一条稳定的证据链:数据有来源,规则有口径,结果可复核,流程能复跑。
本文介绍一套适用于财务报表、管理报表和审计底稿的三层架构:
第一层,数据治理;第二层,标准数据交付;第三层,模板无损写入。
在这套架构中,KNIME负责全量数据加工和规则口径,JSON负责传递写入指令,宏只负责按模板既定行列写数。
一、先把数据治理好,报表才有统一口径
很多报表问题,表面上发生在最后的填表环节,根源却在更早的地方:原始数据不统一,主数据没有关联,业务规则依赖个人经验。
同一类费用,在不同部门可能使用不同名称;同一个人,在不同文件中可能出现不同写法;项目、成本中心和会计科目之间,也可能缺少稳定的对应关系。
如果这些问题没有在源头解决,后面再精细的 Excel 模板,也只能把不一致的结果“排版得更整齐”。
因此,第一层要做的不是填表,而是全量数据治理。
在这个环节中,KNIME读取原始业务明细和各类配置数据,通过清洗、关联、规则判断和汇总,把原始记录转换为标准数据。例如,一笔费用经过治理后,可以明确对应到:标准姓名、标准部门、成本中心、标准费用类型、会计科目、预警阈值、发票要求以及处理状态。
重要的是,规则不再藏在某个人的操作习惯里,而是通过员工主数据、费用类型映射、项目主数据等配置表达出来。这样,什么是标准部门、什么情况下需要预警、哪些记录不能进入正式报表,都可以被查看、讨论、修改和复核。
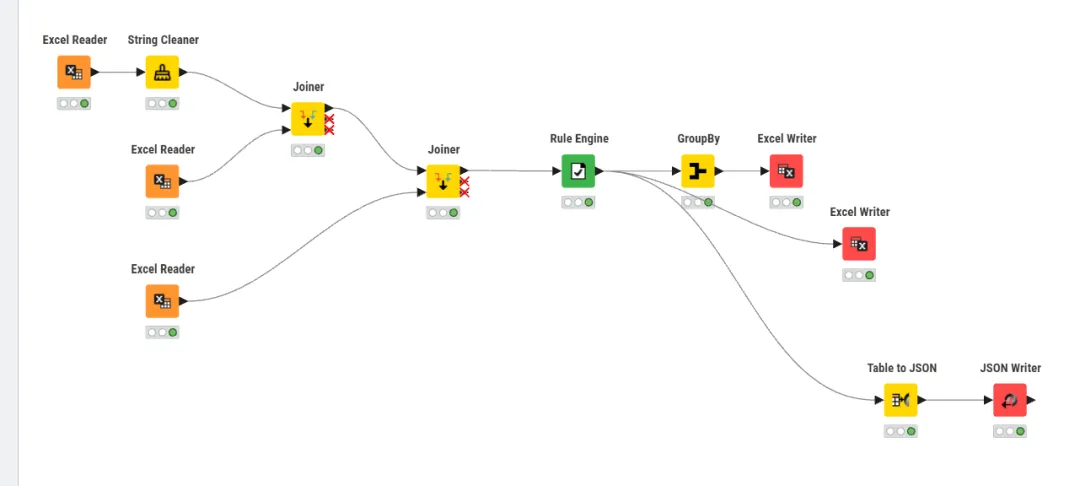
图:KNIME工作流示意——从多源 Excel 读取、清洗和关联,到规则判断、汇总输出,再分别生成 Excel 结果和 JSON 交付文件。
从图中可以看到,KNIME工作流大致分为四个动作:
读取与清洗:读取原始明细及主数据,统一文本和字段格式; 关联与标准化:通过 Joiner 将业务数据与人员、费用类型、项目等配置关联; 规则计算与汇总:通过 Rule Engine 执行规则判断,再按部门、项目或费用类型进行汇总; 结果输出:一方面输出治理明细和管理汇总,另一方面生成后续模板写入所需的 JSON 文件。
这里有一个关键边界:KNIME输出的 Excel 是治理结果和汇总结果,并不是最终的模板填表。数据加工与模板展示被有意分开,后续写入模板时,就不需要再重复解释业务规则。
二、让 JSON 成为数据与模板之间的“交接单”
为什么不让宏直接打开所有原始文件,自己清洗、自己判断、自己汇总,再把数据填入模板?
因为这样做看似省事,实际上会把所有逻辑集中到一个地方:宏既要懂业务规则,又要处理数据,又要控制单元格。时间一长,代码难以维护,规则难以复核,模板一变,整个流程就可能失效。
更稳妥的方式是把职责拆开:
KNIME负责判断和加工,JSON负责交付,宏负责执行写入。
经过 KNIME 治理后的标准数据,被转换成结构化 JSON。JSON携带本批次需要写入的标准字段、数据值、目标工作表、起始位置以及必要的写入信息。
这样,数据从治理环节交付到模板环节时,边界是清楚的。宏不需要重新判断“这笔费用属于什么科目”,只需要按照 JSON 中的指令,把已经确认好的结果交给模板。
这也让整个链路变得容易追踪:
原始数据 → KNIME治理结果 → JSON标准交付 → 模板写入结果
当报表出现差异时,可以判断问题发生在数据、规则、交付还是写入,而不必在一份复杂的 Excel 文件中反复排查。
三、模板无损写入,保护的不只是格式
财务报表、管理报表和审计底稿,通常都不是一张普通的数据表。它们包含固定行列、预设公式、合并单元格、格式要求、打印区域、勾稽关系和复核标识。
所以,自动化写入的目标不是“生成一个新的 Excel”,而是:在不改变模板设计意图的前提下,把标准数据准确写入指定位置。
这就是第三层——模板无损写入。
宏只做:读取 JSON,按照预先约定的工作表、字段顺序和行列位置写入数据。它不重新清洗数据,不重新判断业务规则,也不临时改变报表口径。
所谓“无损”,至少包括三个方面:
不破坏模板的行列结构、合并区域和固定布局; 不覆盖原有公式,不改变报表中的计算和勾稽逻辑; 不破坏日期、金额、边框、字体、打印区域等既有格式。
宏的职责越单一,越容易测试;模板的边界越清楚,越适合重复使用。对于按月编制的报表、集团多单位报表和周期性审计底稿,这一点尤其重要。
四、三层架构,最后形成一条可复跑的流程
实际运行时,这套流程并不复杂:
首先,保留当期原始数据和配置文件;其次,在 KNIME 中完成全量治理,输出治理明细和必要的管理汇总;然后,将需要进入模板的数据整理为 JSON;最后,打开既定模板运行宏,按指定行列完成写入。
完成后,再对几个关键结果进行核对:治理明细与汇总金额是否一致,JSON记录数与模板写入行数是否一致,异常数据是否被正确拦截,最终报表是否保留了原有公式和格式。
整个过程中,原始输入、规则配置、治理结果、JSON文件、模板输出和执行结果都可以按批次归档。下个月只要更换期间数据,沿用相同的流程和相应版本的配置,就能够稳定复跑。
这里的“复跑”并不是机械地重复操作,而是在输入、规则和模板明确的情况下,让同一套流程得到可解释、可验证的结果。
五、从审计视角看,价值在于“能追溯,也能解释”
对审计人员而言,自动化最有价值的地方,不是报表生成得有多快,而是结果是否能够被完整解释。
一张报表中的金额,可以追溯到具体明细;具体明细可以追溯到原始文件;标准部门、费用类型和会计科目,可以追溯到对应的主数据和规则配置。必要时,还可以进一步查看这条记录何时进入 JSON,最终写入了模板的哪个位置。
这条链路解决了审计工作中常见的三个问题:
第一,数从哪里来。报表不再是一个孤立结果,而是能够回到原始数据和治理明细。
第二,为什么这样归类。分类和科目不再依赖口头解释,而是有明确的映射和规则依据。
第三,下个月能不能重做。通过批次、规则版本和模板版本管理,同一套流程可以按月、按单位、按模板稳定运行。
因此,财务自动化并不是把财务人员和审计人员排除在流程之外,而是让大家把精力从重复搬运,转向规则确认、异常判断和结果复核。
结语:报表只是结果,证据链才是能力
好的财务自动化,不是做出一张看起来正确的表,而是建立一套经得起追问的生产流程:
数据从哪里来,能够说明; 规则为什么这样定,能够解释; 结果如何写入,能够追踪; 模板是否被改变,能够验证; 下个月能不能重做,能够复现。
把报表制作拆成三层,正是为了让不同工具各司其职:
KNIME负责全量数据治理和规则口径,JSON负责标准数据交付,宏负责按模板既定行列无损写入。
当财务报表、管理报表和审计底稿都能沿着同一条链路稳定生成,Excel就不再只是一个填数工具,而会成为一条可追溯、可复核、可复跑的数字化证据链。
这是财务自动化真正值得建设的方向。
你所在的企业,报表制作中最耗时、最容易返工的环节是什么?
是数据清洗、口径统一、跨表汇总,还是模板填报与底稿复核?欢迎在评论区交流财务自动化与审计数字化的实践经验。