ARTICLE · 1135646
AI研发工程化第4讲|10万行之外:AI重构大单体的绞杀者模式
AI研发工程化第4讲|10万行之外:AI重构大单体的绞杀者模式
关注「Comqx」公众号,并设为「星标」,第一时间获取更多 AI 工程化落地文章。 |
AI研发工程化系列 全系列导航
温馨提示本文约 2800 字,预计阅读 10 分钟。微信公众号阅读可能存在代码排版不佳等问题,建议点击文末阅读原文查看。 |
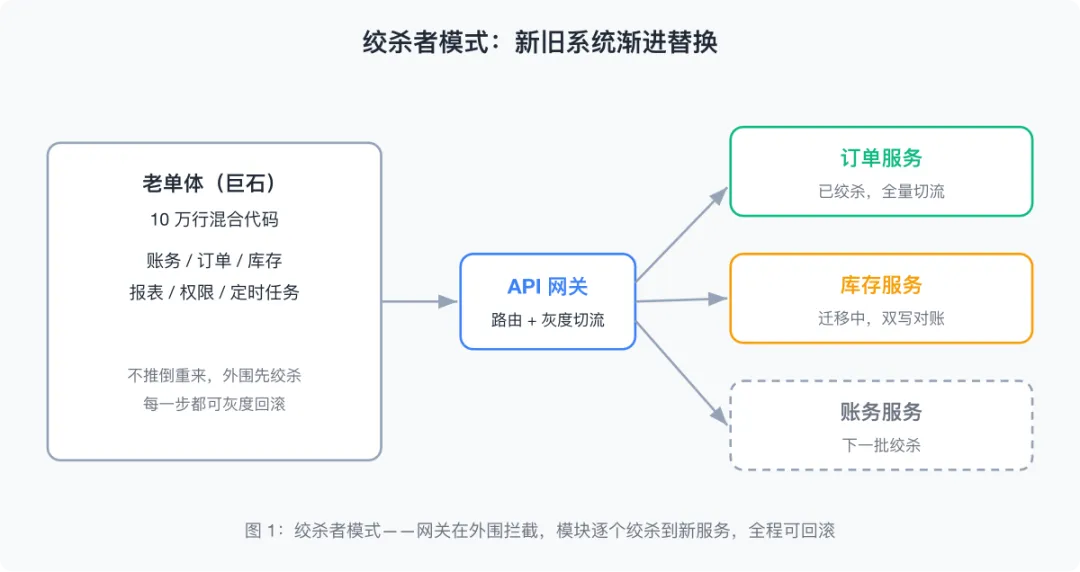
把那个 500 行、SQL 和业务逻辑揉在一起的 Service 整个喂给 AI,让它重构成微服务——它给你吐出一个能编译、但处处埋雷的怪物。这一讲讲的是怎么让 AI 安全碰老代码。结论先放这:先定拆分边界,再让 AI 动手;全程绞杀者模式,单次 PR 不超过 500 行。
一、边界划定:什么时候必须先拆
先说一个硬数字:主流 AI 编程工具的有效上下文约 10 万 Token,摊到 Java 代码就是 5-10 万行。模块超过这个体量,AI 开始丢上下文、重复生成同名类、把你上一版的改动覆盖掉——这不是模型笨,是它真的看不全。
bash # 先量一下你手上单个业务模块的代码量级find src/main/java/com/example/order -name "*.java" | xargs wc -l | tail -1
判断标准一句话:单个模块超过 5 万行,或改一个需求要动 3 个以上模块,就先拆再让 AI 碰;5000 行以内的服务直接让 AI 改,别过度设计。
什么时候别动?两种情况。一是纯新增功能——新业务别硬塞进老单体里绞,直接起新服务,边界天然干净。二是覆盖率接近 0 的大泥坑——先补冒烟测试再谈重构,不然 AI 改完你都不知道改对没有。
我本来以为把整个 500 行 Service 喂给 AI 它能一次重构成微服务,实测它交出的版本编译通过、单测也绿,却把 @Transactional 注解弄丢了——转账链路从强一致退成最终一致,线下对账差点出事。从那以后我定了条死规矩:拆分边界必须人来定,AI 只负责在划好的边界里干活。
二、绞杀者模式与拆分维度
大爆炸重写是重构里最贵的死法:新旧两套并行写两年,上线那天发现新系统连边角 case 都没覆盖。绞杀者模式(Strangler Fig)反过来——老系统不动,在外围套一层 API 网关,新功能写在新服务里,老功能一个模块一个模块地绞杀过来,流量通过网关逐步切。
四步走:识别核心模块 → 抽成独立服务 → 网关建路由 → 灰度迁移。原则就四个:渐进、可回滚、AI 辅助、测试先行,切流出问题就网关切回老系统。
拆哪里?三个维度,按优先级排:
| 拆分维度 | 怎么切 | 什么时候用 |
|---|---|---|
| 按领域(DDD) | 核心域/支撑域/通用域分开,订单、账务各自成服务 | 业务边界清晰,钱相关链路优先 |
| 按功能 | 先把改动最频繁、痛点最大的模块抽出去 | 边界模糊,先跑起来再说 |
| 按团队 | 康威定律,一个服务一个团队 own 到底 | 多团队协作,避免互相踩 |
我的建议:先按领域切出核心域,支撑域和通用域最后再说。别让 AI 自己决定拆哪里——它照包结构切出来的,多半是历史乱炖的复制粘贴。多人并行重构时,每个任务一个独立 worktree,互不污染:
bash # 每个重构任务一个独立 worktree,改完测试通过再合回主干git worktree add ../refactor-order-svc order-svccd ../refactor-order-svc
三、三个拿来即用的交付物
下面三样复制走就能跑:javax→jakarta 迁移脚本、Clean Arch 四层骨架、CI 质量门禁。
3.1 javax→jakarta 批量迁移脚本
老系统要上 Spring Boot 3.x,第一道坎就是 javax.* 全包名换 jakarta.*。手动改几百个 import 必漏,下面这个脚本在 src 上跑一遍,改完自动扫残留:
python #!/usr/bin/env python3# migrate_jakarta.py —— Spring Boot 2.x 工程 javax.* 包名批量迁移到 jakarta.*import os, sys# javax 到 jakarta 的包名映射表(Spring Boot 3 / Jakarta EE 9+ 强制)PKG_MAP = [("javax.persistence", "jakarta.persistence"),("javax.servlet", "jakarta.servlet"),("javax.validation", "jakarta.validation"),("javax.transaction", "jakarta.transaction"),("javax.annotation.security", "jakarta.annotation.security"),("javax.ws.rs", "jakarta.ws.rs"),("javax.xml.bind", "jakarta.xml.bind"),("javax.annotation.PostConstruct", "jakarta.annotation.PostConstruct"),("javax.annotation.PreDestroy", "jakarta.annotation.PreDestroy"),("javax.annotation.Resource", "jakarta.annotation.Resource"),]# 这几个属于 JDK 本身,绝不能替换SKIP = ("javax.annotation.processing", "javax.annotation.Generated")def migrate_file(path):# 逐行替换 import 与全限定类名,命中映射表才改with open(path, encoding="utf-8") as f:lines = f.readlines()changed, out = 0, []for line in lines:new = lineif "javax." in line:for old, new_pkg in PKG_MAP:if old in new and not any(s in new for s in SKIP):new = new.replace(old, new_pkg)if new != line:changed += 1out.append(new)if changed:with open(path, "w", encoding="utf-8") as f:f.writelines(out)return changeddef main(root):total = 0for dirpath, _, files in os.walk(root):for name in files:if name.endswith(".java"):total += migrate_file(os.path.join(dirpath, name))# 校验:全仓再扫一遍,列出漏网的可迁移 javax 引用leftover = []for dirpath, _, files in os.walk(root):for name in files:if name.endswith(".java"):p = os.path.join(dirpath, name)with open(p, encoding="utf-8") as f:for i, line in enumerate(f, 1):if "javax." in line and any(o in line for o, _ in PKG_MAP):leftover.append(f"{p}:{i}: {line.strip()}")print(f"替换行数: {total}")for l in leftover[:20]:print(" 残留: " + l)print("校验通过:无残留" if not leftover else "上面残留请人工确认")if __name__ == "__main__":# 用法: python3 migrate_jakarta.py ./src/main/javamain(sys.argv[1] if len(sys.argv) > 1 else "./src/main/java")
跑出来大概长这样:
plaintext 替换行数: 128校验通过:无残留
迁移前后对比:
java // 迁移前 → 迁移后import javax.persistence.Entity; // → jakarta.persistence.Entityimport javax.servlet.http.HttpServletRequest; // → jakarta.servlet.http.HttpServletRequestimport javax.validation.constraints.NotBlank; // → jakarta.validation.constraints.NotBlank
脚本只改 import,pom.xml 的父版本和 starter 要跟着升:
html <!-- pom.xml:父工程升到 Spring Boot 3.x,3.x 强制 Jakarta EE 9+ --><parent><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-parent</artifactId><version>3.2.5</version></parent><!-- starter 自带 jakarta.* 依赖,不用再手动引 javax 包 -->
3.2 Clean Architecture 四层最小骨架
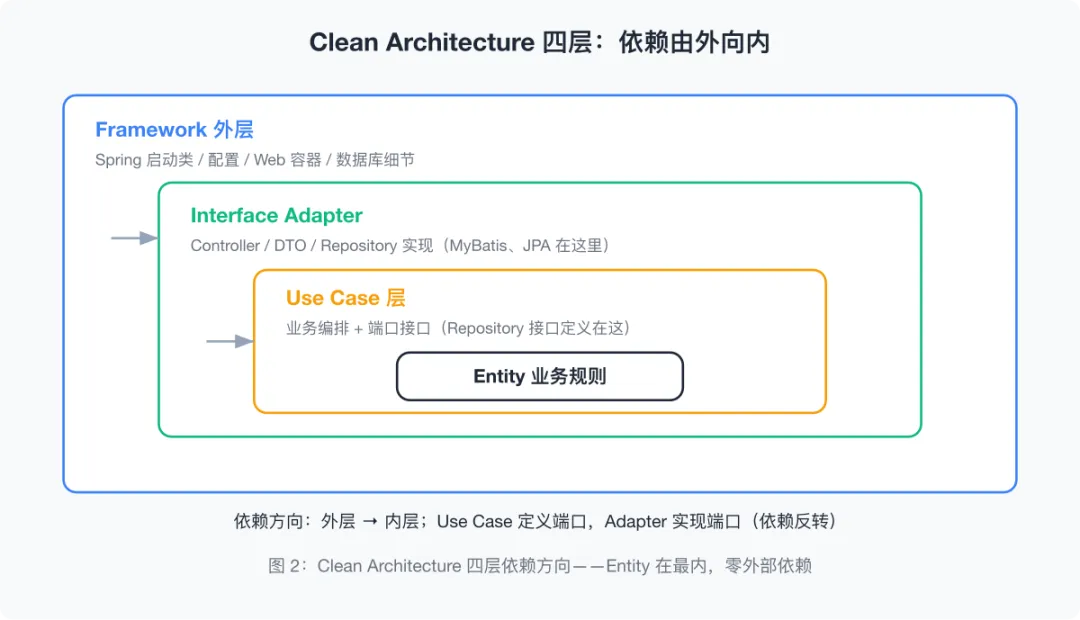
拆出来的新服务别又写成 Controller→Service→DAO 三层饼——那只是把大泥坑复制了一遍。按四层分,依赖单向由外向内:
plaintext src/main/java/com/example/credit/├── entity/ # 最内层:业务实体与规则,零外部依赖│ └── CreditScore.java├── usecase/ # 业务编排,定义端口接口│ ├── CreditScoreService.java│ └── CreditScoreRepository.java # 接口,实现在外层├── adapter/ # 接口适配:Controller、Repository 实现│ ├── web/CreditScoreController.java│ └── persistence/CreditScoreRepositoryImpl.java└── framework/ # 最外层:启动类、配置、框架细节└── CreditApplication.java
关键在 CreditScoreRepository 这个接口:定义在 Use Case 层,实现在 Adapter 层。业务用例只依赖它,将来换数据库、换 ORM 都不用改。
java // usecase/CreditScoreRepository.java —— 端口接口,定义在业务层public interface CreditScoreRepository {CreditScore findById(Long supplierId);}// adapter/persistence/CreditScoreRepositoryImpl.java —— 外层实现端口@Repositorypublic class CreditScoreRepositoryImpl implements CreditScoreRepository {// MyBatis/JPA 细节全封在这里,内层完全不知道数据库存在}// entity/CreditScore.java —— 最内层,纯业务规则,不引任何框架包public class CreditScore {private Long supplierId;private int score;// 分级规则写在实体里,Use Case 只做编排public String level() { return score >= 80 ? "A" : "B"; }}// adapter/web/CreditScoreController.java —— 最外层适配 HTTP@RestController@RequestMapping("/api/v1/credit")public class CreditScoreController {private final CreditScoreService service; // 只注入用例,不认识 Repository 实现@GetMapping("/{id}")public CreditScore get(@PathVariable Long id) { return service.load(id); }}
四、测试分层与安全红线
重构不是改代码好看,是改完行为不变。测试金字塔 70/20/10:70% 单元测试(纯 JUnit,不碰数据库),20% 集成测试(Testcontainers 起真 Postgres),10% 端到端。
全量回归几千条跑半小时,重构推不动。四件套叠用:精准测试(AST 代码血缘把 5000 条用例裁到 50 条)、Pact 契约测试(上下游各管各的)、流量回放(录生产请求重放对比)、容器化并行执行。回归从按天压到按分钟。
质量红线三条写进 CI 不商量:行覆盖率 ≥80%、重复率 <5%、圈复杂度 <15;再加流程红线:单次 PR ≤500 行,不跳测试、不删日志、不绕权限。下面这段门禁直接复制进仓库:
yaml # .github/workflows/refactor-gate.yml —— 重构质量门禁name: refactor-gateon: [pull_request]jobs:gate:runs-on: ubuntu-lateststeps:- uses: actions/checkout@v4with: { fetch-depth: 0 } # 浅克隆取不到 PR base,必须全量拉才能 diff- uses: actions/setup-java@v4with: { java-version: '21', distribution: 'temurin' }- name: 单测 + JaCoCo 覆盖率(行覆盖率红线 80%)run: mvn -B verify- name: 单 PR 变更行数红线(>500 行直接拒绝)run: |CHANGED=$(git diff --numstat origin/${{ github.base_ref }}...HEAD \| awk '{add+=$1; del+=$2} END {print add+del}')echo "本次变更行数: $CHANGED"[ "$CHANGED" -le 500 ] || { echo "超过单次 PR 500 行红线"; exit 1; }
圈复杂度用 checkstyle 卡死,超 15 不让合:
html <!-- checkstyle.xml:圈复杂度门禁,挂进 Maven checkstyle 插件 --><module name="CyclomaticComplexity"><property name="max" value="15"/></module>
覆盖率 80% 不是 mvn verify 默认就查的,pom 里挂这个 jacoco rule 才生效:
html <!-- pom.xml:行覆盖率低于 80% 构建失败 --><plugin><groupId>org.jacoco</groupId><artifactId>jacoco-maven-plugin</artifactId><executions><execution><goals><goal>check</goal></goals><configuration><rules><rule><element>BUNDLE</element><limits><limit><counter>LINE</counter><minimum>0.80</minimum></limit></limits></rule></rules></configuration></execution></executions></plugin>
五、常见坑
三个坑最常见,直接点出来。
一是迁移后编译报错,处理顺序别乱。 先 mvn dependency:tree | grep javax 看哪些旧 starter 没升,再按报错包名补 jakarta 依赖,最后才动业务代码。一上来全量改 pom,依赖冲突能让你怀疑人生。
二是拆分时把依赖一起拆走。 抽订单服务时,别把公共枚举、工具类整个搬走——老单体里还有二十处在用。先抽成独立 jar 两边都引,再谈迁移。
三是覆盖率数字被 mock 撑高。 把依赖全 mock 掉,行覆盖率轻松 90%,但关键路径一次真数据库都没打过。我的做法:行覆盖率看总数,分支覆盖率盯关键 Service,再用 20% 集成测试打底。
还有一句大实话:离线隔离的客户现场、边角报表逻辑,AI 覆盖不了,老实人工测。
写在最后
明确推荐:老系统要接 AI 重构,从绞杀者模式起步,别碰大爆炸重写;先按领域划好核心域边界,再让 AI 在边界内干活;把 500 行 PR 和覆盖率红线焊进 CI。 慢就是快,三个月回头看,比赌上全部的重写稳得多。
重构讲完了,下一个问题是 AI 本身:网上那些 Agent Demo 很酷,一到生产不是烧穿 Token 就是越权点按钮。第 5 讲讲生产级 Agent 的六要素——缺了守栏,你的 Agent 就是个玩具。
你手上那个老单体,现在最想先绞杀哪个模块?评论区说说,我挑一个典型的边界问题在下讲开头拆。
引用来源
- Spring Boot 3.0 Migration Guide — Spring 官方 — official — https://github.com/spring-projects/spring-boot/wiki/Spring-Boot-3.0-Migration-Guide
- The Clean Architecture — Robert C. Martin — blog — https://blog.cleancoder.com/uncle-bob/2012/08/13/the-clean-architecture.html
- Testcontainers 官方文档 — AtomicJar — official — https://testcontainers.com/
- Pact 契约测试官方文档 — Pact Foundation — official — https://pact.io/
- JaCoCo 官方文档 — JaCoCo — official — https://www.jacoco.org/
本系列基于 AI 系统架构与研发工程化方法论整理,结合一线落地经验展开。