ARTICLE · 1137223
AI Agent 学习笔记 01:现代 Agent = LLM + 上下文 + 工具
系列第 1 篇|个人入门笔记,按自己的原文草稿和理解由AI重写,方便复习。
目录
1. 我先记住的等式 2. 工具:Agent 的手脚 3. 一次工具调用是怎么转起来的 4. LLM:Agent 的大脑 5. 三种学习机制,我怎么区分 6. 上下文:Agent 的眼睛 7. ReAct 循环、轨迹,以及那条关键事实 参考链接
1. 我先记住的等式
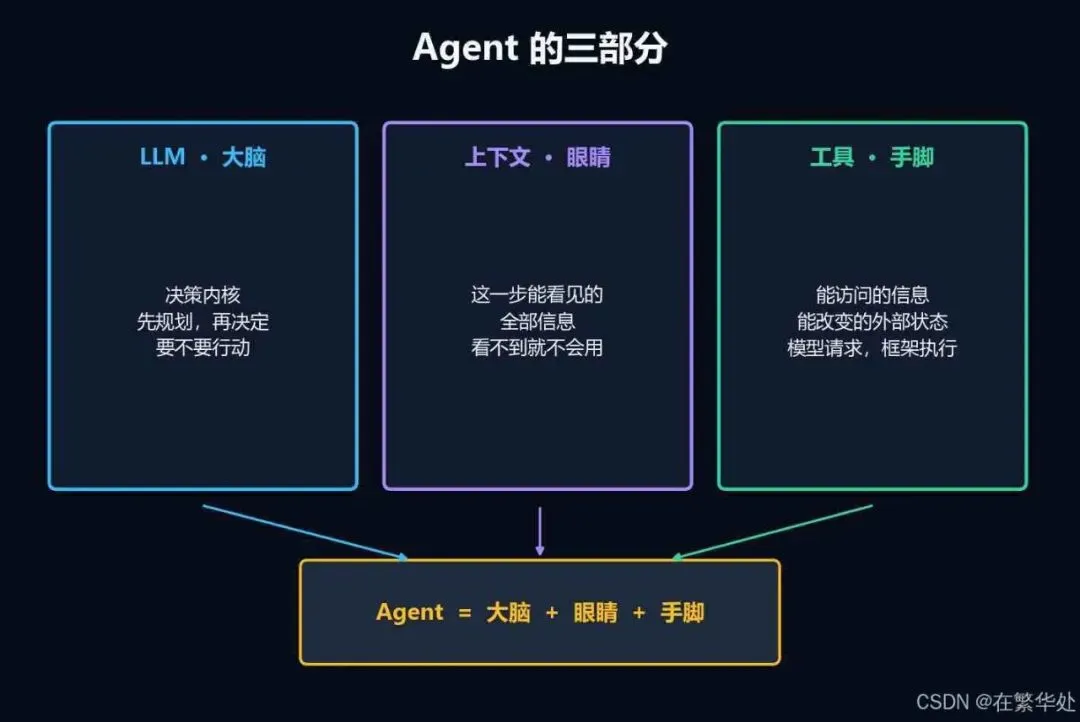
这张表我用来挡两种常见误解。
第一种:把提示词写得很长,就叫 Agent。提示词只是上下文里的一块静态说明。没有工具、没有「看结果再决定」的循环,它仍然是一次生成。
第二种:接了一堆 API,就叫 Agent。脚本也能调 API。差别在于:是谁决定这一步调不调、调哪个、参数是什么。 这个决定权在模型,不在外面那层 if/else。
实践补充:Anthropic 在《Building effective agents》里把生产里常见的 Agent 概括成「在循环中根据环境反馈使用工具的 LLM」。和上面这句等式是同一件事,只是他们更强调:先把这个循环做简单、做透明,再考虑多 Agent。原文:Building effective agents。
2. 工具:Agent 的手脚
我把笔记里的工具分成五类。前三类是模型可以主动选择的动作,后两类更像「信息怎么进来、怎么回去」。
事件触发容易和「工具调用」混在一起。我的区分是:邮件到了、时间到了,这是外部把一条新消息推进上下文;模型看到之后,再决定要不要调用感知工具或执行工具。触发器本身通常不是模型填参数去「调用」的那个函数。
设计工具时,尽量保持通用
笔记里有一句我反复提醒自己:为 Agent 设计工具时,应尽量保持工具的通用性。
专用工具看起来省事,比如单独做一个 rename_readme_to_backup。下次要改的是另一个文件、另一种改名规则,这个工具就废了。通用工具是 read_file、search、write_file、run_command 这种可组合的动作。专用流程放进提示词或外部知识库,不要焊死在工具名上。
实践补充:同一篇文章的附录把工具文档比作 Agent 和计算机之间的界面。描述要写清用途、参数、边界和例子,让模型不容易用错。绝对路径优于「当前目录下的相对路径」,因为模型会忘了自己已经换过目录。这不是我原文里的句子,是我后来对照官方工程文章补上的判断。
3. 一次工具调用是怎么转起来的
工具不是模型「自己执行」的。模型只能产出结构化的调用请求。执行发生在模型外面,结果再写回上下文。我笔记里的四步是:
在上下文里告诉模型有哪些工具可用,包括名称、用途和参数。 模型自己判断要不要调用、调用哪个、传什么参数。 框架执行工具,把结果追加进上下文。 模型据此决定下一步。这个循环就是后面 ReAct 的基础。
工具定义我习惯写成下面这种结构。名称要短,描述要写「什么时候用、什么时候不用」。
{"name": "lookup_city_weather","description": "查询指定城市的当日天气。仅当用户在问天气,且上下文里还没有当日结果时使用。","parameters": {"type": "object","properties": {"city": {"type": "string","description": "城市名,例如上海。不要传国家或经纬度。"}},"required": ["city"]}}
下面这段不是生产框架,只用来把四步画成能跑的形状。model_step 在真实系统里是一次 LLM 调用;这里用规则假装模型,避免把笔记写成某个厂商 SDK 的教程。
TOOLS = {"lookup_city_weather": lambda city: f"{city}:多云,22°C",}def model_step(context: list[dict]) -> dict:"""教学替身:真实系统中这一步是一次 LLM 调用。"""asked = any("天气" in m.get("content", "") for m in context)already = any(m.get("role") == "tool" for m in context)if asked and not already:return {"reasoning": "没有当日数据,先调用查询工具。","content": "","tool_calls": [{"name": "lookup_city_weather","arguments": {"city": "上海"},}],}return {"reasoning": "工具结果已在上下文中,可以回答。","content": "上海今天多云,大约 22°C。","tool_calls": [],}
循环本身和「谁来执行工具」分开。run_turn 只负责把请求发出去、把结果写回,并在没有调用或步数用尽时停下来。
# 接上一段:TOOLS 与 model_step 已定义def run_turn(user_text: str, max_steps: int = 4) -> str:context = [{"role": "system", "content": "没有实时数据时必须调用工具。"},{"role": "user", "content": user_text},]for _ in range(max_steps):step = model_step(context)context.append({"role": "assistant","content": step["content"],"tool_calls": step["tool_calls"],})if not step["tool_calls"]:return step["content"]for call in step["tool_calls"]:result = TOOLS[call["name"]](**call["arguments"])context.append({"role": "tool", "name": call["name"], "content": result})return "达到步数上限,停止并说明未完成。"
我用这段代码记住三件容易说反的事:
模型输出的是请求,不是天气本身。 工具结果是一条新消息,不是改写用户原话。 必须有步数上限。否则模型可以一直「再查一次」。
4. LLM:Agent 的大脑
LLM 是 Agent 的决策内核。和其他自动化相比,它独特的地方是内部思考:在真正行动之前,先规划、先推演,再决定要不要动手。
笔记里我把一次模型回复拆成最多三块,后面讲上下文时还会再见到它们:
- 思考过程(reasoning)
:内部推演,用来保持连贯,也让决策可以被人看懂。 - 文本内容(content)
:给用户的话。 - 工具调用请求(tool_calls)
:这一步打算采取的行动。
三块可以只出现其中一部分。只思考不调用,是在计划;只调用不说话,是在动手;三者都空,通常是这一轮失败了,不该假装它「已经做完」。
模型即 Agent:当模型本身成为产品
笔记里我写过两个短句:模型即 Agent,以及 方向认同,节奏务实。
我的理解是:当一个模型产品自己就能看上下文、选工具、把结果接回来,Agent 就不再只是「模型外面再包一层状态机」。方向我认同。节奏上我故意放慢——先把单循环、工具描述和停止条件做稳,再谈多 Agent 分工。框架能少写就少写。看不懂底层消息是怎么拼起来的,后面一定排不了错。
5. 三种学习机制,我怎么区分
Agent 会「变好」,不代表每次都在改模型权重。我把笔记里的三种学习并排放:
三者不是互斥的。后训练决定模型「默认会不会用工具」;上下文学习决定「这一次照着哪条轨迹做」;外部化学习决定「查不到的知识不必塞进参数,也不必塞满窗口」。
我现在的优先级是:能外部化的流程先写成工具和说明,不要指望靠一次后训练记住我的目录结构。目录会变,工具描述可以改。
6. 上下文:Agent 的眼睛
上下文不是「聊天记录」的别名。它是模型在这个决策点能看到的全部信息。我笔记里的组成是:
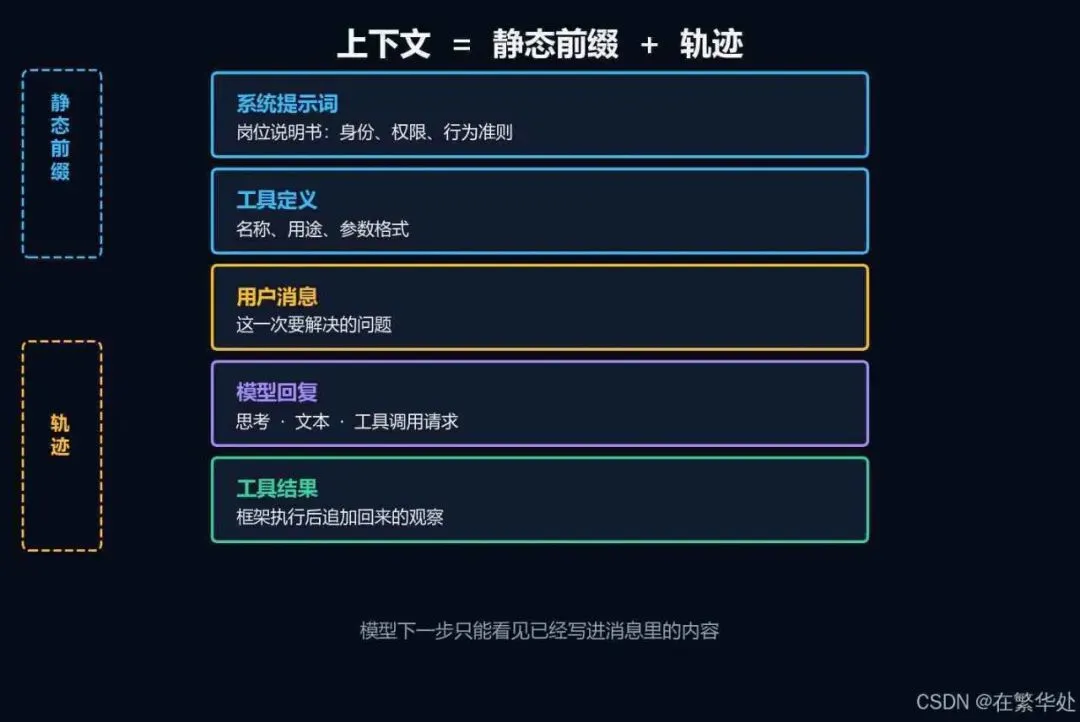
前两块我称为静态前缀:岗位说明书 + 工具清单。后面三块会随任务增长,那就是下一节的轨迹。
实践补充:上下文窗口是有限的。Anthropic 后来把这件事叫作 context engineering:在每一步放进「最小的一组高信号信息」,而不是把能找到的材料全塞进去。工具的价值之一,就是不必事先把整个资料库放进眼睛里,用到再取。原文:Effective context engineering for AI agents。
所以「眼睛」不是越大越好。塞进无关邮件、过期工具结果、重复的系统说明,模型仍可能看见,但决策会被噪声带着走。
7. ReAct 循环、轨迹,以及那条关键事实
ReAct 不是又一个聊天格式。它是把「先想一句,再做一个动作,再看环境返回什么」交错起来的循环。名字来自 Yao 等人 2022 年的论文 ReAct: Synergizing Reasoning and Acting in Language Models。论文页:arxiv.org/abs/2210.03629,项目页:react-lm.github.io。
论文里的核心观察我用自己的话记:只推理,容易把不知道的事实说成知道;只行动,有了观察也组织不成下一步。交错之后,推理负责改计划、处理异常,行动负责从外部把新信息拿回来。
他们报告的对比(我只引用论文摘要里的数字,不自行加戏):在 ALFWorld 和 WebShop 上,一两条例子的 ReAct,比模仿学习或强化学习方法的成功率分别高出 34 和 10 个百分点。问答和事实验证任务上,它通过和简单的 Wikipedia 接口交互,减轻只靠链式推理时的幻觉和错误传递。
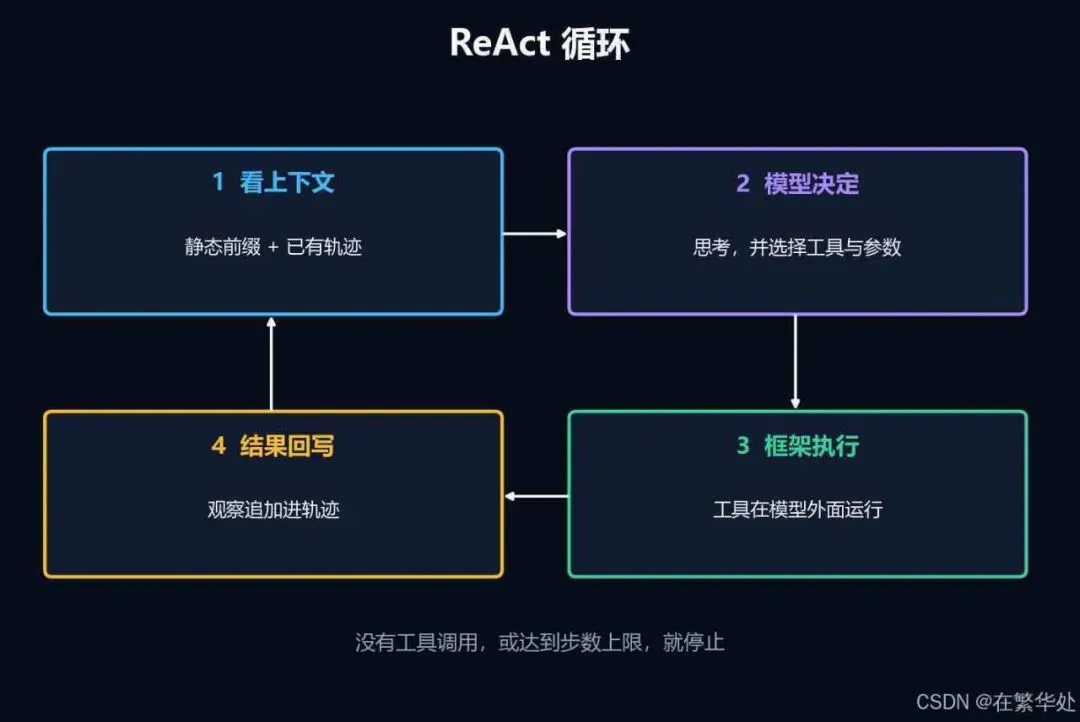
轨迹
轨迹是 Agent 执行任务时不断积累的消息历史:用户消息、模型回复(含思考和工具调用)、工具执行结果。
关键事实:Agent 的上下文 = 静态前缀 + 轨迹。
静态前缀回答「你是谁、你能用什么」。轨迹回答「到目前为止发生了什么」。模型下一步的判断,只能基于这两者,不能基于你以为它「应该记得」、但没有写进消息里的东西。
一轮成功的天气查询,轨迹长这样:
user: 上海今天天气怎么样?assistant: reasoning=先查询assistant: tool_calls=lookup_city_weather(上海)tool: 上海:多云,22°Cassistant: content=上海今天多云,大约 22°C。stop: 没有新的工具调用,循环结束
排错时我只看这条轨迹,不问「模型聪不聪明」。常见断点就四个:工具没写进前缀、模型没发出调用、框架没把结果追加回去、结果追加了但描述和真实返回对不上。
参考链接
ReAct: Synergizing Reasoning and Acting in Language Models ReAct 项目页 Building effective agents Effective context engineering for AI agents