ARTICLE · 1137248
AI 超节点四家对决(上):NVIDIA、AMD、阿里云、华为各自给出了什么答案
本篇是上篇。下篇《横向对比、下一代展望,以及如何读懂厂商数字》为独立一篇。
两篇合计约 2 万字,可各自独立阅读。
NVIDIA、AMD、阿里云、华为,四家都在做同一件事——把尽可能多的加速器塞进"一个能被软件当作单台机器使用的域"。但他们对"域"的定义、边界和实现路径,分歧比共识大得多。
本文基于截至 2026 年 10 月的公开材料,逐项核对四家的芯片规格、整机规格、互连拓扑与交付状态。全文的关键数字都标注了证据等级,查无来源的数字会被明确标出而不是略过。
引言:一个机柜,到底是一台机器还是一组设备?
过去二十年,服务器形态的争论基本围绕"多核还是多机"展开。到了 AI 时代,这个问题换了个问法:72 张 GPU 装进同一个机柜,它们是一台机器,还是一组碰巧住得很近的设备?
答案不在机柜里,在软件能看到什么。调度器要能把这 72 张卡当成一个可切分的资源池;通信库要能在这个池子里做 all-to-all 而不掉进慢路径;故障域管理要承认这个池子是一个整体。这些条件同时满足时,超节点才成立——否则它只是一台"密度很高的服务器"。
NVIDIA 把这件事讲得最直白。在其官方参考架构里,GB200 NVL72 的 9 个 NVLink 交换托盘被描述为负责"全部 72 张 GPU 之间的全网状连接"(full-mesh connectivity between all 72 GPUs),每张 B200 有 18 条 NVLink 5 链路,"与 18 颗交换芯片各有一条专用链路"。到 Vera Rubin 一代,官方博客的措辞是"5000 根线缆构成的 NVLink 脊组成单一 all-to-all 拓扑,任意 GPU 都能以一致的延迟和带宽与任意其他 GPU 通信"。
这句话里的关键词是"单一"和"一致"。超节点的价值不在于把卡堆密,而在于让通信拓扑对软件透明。
但四家对"域该多大、用什么代价换"的答案完全不同,而这正是本文要拆开的地方。
为什么现在写这篇
2026 年恰好是四家都拿出机架级答案的一年。NVIDIA Vera Rubin NVL72 于 1 月 CES 发布、Q1 投产;AMD Helios 于 7 月 23 日 Advancing AI 正式发布并进入 full production;阿里云磐久 AL128 已规模部署;华为 Atlas 950 SuperPoD 规划 Q4。
同时,这个领域的口径混乱程度已经到了会写错文章的地步。光是核对公开材料,本文就查出 6 处厂商内部自相矛盾、4 个被广泛传播的错误数字、3 处系统性口径陷阱——其中有几个流传极广,连行业分析文章都在照抄。
更值得写的是:四家的路线正在收敛到同一个方向,但收敛的过程里藏着一个与"交换层级"和"收敛比"有关的反直觉事实。留到第 1 章展开。
先交代三个口径问题,否则后面的数字会算错
口径问题一:NVIDIA 的 NVL144 和 NVL72 是同一台机器。
144 个 die 装在 72 个封装里,所以两个数字都对。NVIDIA 高管在 CES 沟通会上明确表示这次改名"并不意味着系统规模变化"。
任何拿"NVL144 单柜 600kW"做论据的材料都是过期错误——NVL144 已更名 NVL72,实测功耗是 188/228 kW(下文有来源);600 kW 只出现在一个已被取消的过渡方案语境里。
口径问题二:单柜卡数 ≠ 单域卡数。
阿里云磐久 AL128 的单柜支持 128–144 张 GPU。但这个数字很容易被误读为"阿里的 scale-up 域有 128 卡"。实际上,按阿里云 2025 年 11 月的官方技术长文,AL128 的机柜里划分了上下两个 ScaleUp 域,每域一组 AL64,即每域 64–72 卡。
这个区别在第 4 章会变得很关键——因为它直接决定了 AL144 那句"域规模 2×"是怎么算出来的。
口径问题三:四家的产品都必须分"单柜"与"多柜"两层来比。
这一条最容易被忽略,却最容易导致错位比较。详见 1.3 节。
证据等级说明
本文用一个五级体系标注每个关键数字的来源可靠性,后文表格中会直接标出:
| A | ||
| B | ||
| C | ||
| D | ||
| E |
A 与 B 的区别值得强调:厂商规格表和官方技术长文(A)经过产品与法律流程,发布会幻灯片(B)没有。而发布会口径(B)常被误当作实测引用,这是本领域最常见的引用错误之一。
第 1 章 对比的尺子:六个维度、两个概念、两个层级
在比规格之前,先立尺子。否则就会陷入"谁的单卡算力高"这种既没有答案、也没有意义的争论。
1.1 六个维度
维度一:计算芯片。加速器的制程、HBM 容量与带宽、低精度算力(注意 dense/sparse 口径)、TDP。这一维度最容易被营销数字污染,处理方式见第 8 章。
维度二:主控 CPU。核数、内存通道、与加速器的配比,以及在 Agentic 负载里的角色。这一维度常被忽略,但它是"超节点是计算平台还是完整计算机"的分水岭——华为是唯一把 CPU 直接拉进 scale-up 域的一家。
维度三:Scale-up 互连。这是本文的主战场——协议、单卡带宽、域规模、交换芯片、无收敛还是有余量、铜光分段。
维度四:Scale-out 网络与网卡/DPU。速率、协议栈、卸载能力、收敛比是多少。
维度五:整机与工程。单柜卡数、功耗、供电架构、液冷方式、可维护性、机械精度。
维度六:软件与生态。通信库、内存语义、开放程度、迁移成本。
这六个维度构成了本文后面的所有对比表——每一张都在回答其中一项或几项。
1.2 先把两个概念定义清楚:scale-up 与 scale-out
这两个词被用得很滥。很多文章把它们简化成"柜内 vs 柜外""快 vs 慢",或者更常见的一种——"铜 vs 光"。前两个不准确,第三个是错的。
正确的理解方式是四个正交的设计轴(这是本领域目前较完整的分析框架):
| ① 物理介质 | ||
| ② 传输协议 | ||
| ③ 通信拓扑 | ||
| ④ 上层软件 |
这四个轴相互正交——介质不等于协议,协议不等于拓扑。最容易搞混的两组是:
• 介质 ≠ 域类型:scale-up 域既可以用铜也可以用光(详见 1.2.1 的警示)。 • 协议 ≠ 拓扑:华为的 CM384 与 UB-Mesh 用同一套 UB 协议,拓扑却完全相反(前者交换式全对全,后者 nD-FullMesh 直连)——把拓扑特征安到协议头上,是这批公开材料里最高频的事实错误,连论文都犯过。
那么 scale-up 与 scale-out 的区分落在哪个轴上?
落在②(协议语义)+ ③(拓扑与距离)+ 端点集合这三件事上,不在①(介质)上。综合 UALink 联盟规范、OCP(SUE / ESUN)文档、NVIDIA 官方参考架构与华为、阿里的官方论文,业界区分可以收敛到三条判据。这三条里既没有"介质",也没有"收敛比"——后者的说明见 1.2.2 节末尾。
1.2.1 三条真判据
| Scale-up 域 | Scale-out 域 | |
|---|---|---|
| ① 通信语义 | 内存语义 | 消息语义 |
| ② 拓扑与电可达距离 | 单跳或少跳直连 | 多层 Clos / fat-tree |
| ③ 域规模与带宽比 |
三条判据里,内存语义是最硬的一条,也是四家来源最一致的:
• UALink 白皮书:scale-up 是"机架内域,加速器、CPU 与内存池需要带内存语义的紧耦合通信",支持 read / write / atomic,57 位地址空间。 • OCP SUE:scale-up 要"在 XPU 之间搬运内存事务",需求表里列的是 one-sided operations / memory load-store-atomics / shared memory (PGAS)。 • 华为官方给了最清晰的二分:UB 的 API 分两套——「memory-semantic API,load/store 同步」与「message-semantic API,URMA 异步」。 • 阿里官方:ScaleOut 层用 RDMA / RoCE,而 ScaleUp 域搬的是 GPU 内存数据。
⚠️ 一个必须避免的误读:判据二说的是"距离",不是"铜还是光"。
很容易顺手写成"scale-up 用铜、scale-out 用光"——这是错的。介质(铜 / 光)与 scale-up / scale-out 是两个正交的设计轴。
scale-up 域本来就在大规模用光,而且这已是行业共识:
• NVIDIA NVL576官方原文:把 8 个机柜组合成单一 576-GPU NVLink 域,用的是 "copper and direct optical connections"——铜与直连光并用。 • 华为 UB:板内铜 + 跨柜光(CM384 单超节点用了 6,912 个光模块);Atlas 950 的柜间更是全光 Clos。 • 阿里 AL144:用二级 SNPO 光互连扩展的正是 ScaleUp 域。 • 最直接的证据是那个标准化组织的名字:2026 年 3 月由 AMD、Broadcom、Meta、Microsoft、NVIDIA、OpenAI 联合成立的 OCI MSA,全称就是 "Optical Scale-up Consortium"(光 scale-up 联盟)——目标正是让 XPU 与 scale-up 交换机通过一层公共光 PHY 解耦。 正确的说法是:判据二约束的是电信号的可达距离(铜在 200G/lane 量级下约 2–4 米,光可达几十米乃至更远)。在这个距离之内,用铜还是用光是一个成本与稳定性的工程取舍;超出这个距离,光是唯一选择。它决定的是"域能延伸多远",而不是"这个域属于哪一类"。
阿里 2024 年 UPN512 白皮书给过一组生产数据佐证这个取舍:月化链路抖动比例,铜缆为 1× 基线,去 DSP 的 LPO 光模块约 2×,传统带 DSP 的 FRO 光模块约 6×。这解释了为什么 NVL72 要在机柜内用铜 cartridge 把 72 张 GPU 压进一个域——在铜够得着的距离内,光没有性价比;也解释了为什么一旦跨柜就必须上光。
所以本文 1.3 节的"单柜 / 多柜"是机械边界,不是介质边界。单柜内通常用铜(距离短、铜更划算),跨柜必须用光(铜够不着)——但这是距离推导出的结果,不是"因为单柜是 scale-up 所以用铜"。
顺带一个更有意思的推论:正因为光是"延伸域"的手段,所以四家往多柜走时全部上了光,而不是把光留给 scale-out。这不是巧合——光是多柜 scale-up 能够成立的前提条件,而不是 scale-out 的标志。本文第 7 章会回到这一点。
1.2.2 一个可用的速判
三条判据里,内存语义是最容易一眼看出的:
问一句"加速器之间能不能直接 load/store 对方的内存"——能,就是 scale-up;只能 put/get 消息,就是 scale-out。
至于跳数、距离、收敛比,都是在这个分类之后才需要关心的设计参数。
关于"收敛比"的一个提醒:另一个常被拿来区分的指标是无收敛 / 有收敛。它也不成立——两侧都有反例(华为 UB-Mesh 的 scale-up 域明示"逐层收敛",而阿里 HPN 的 scale-out Tier-1 是 1.067:1;OCP SUE 的需求表里根本没有这一项)。
收敛比的正确位置是"逐层设计参数",本文会在用到它的地方分别展开:第 4.6 节(阿里 HPN 的逐层数字)、第 5.4.2 节(华为两代相反的选择),以及下篇第 6 章表 8的四家横向对照。
1.3 再把机柜分成两类:单柜与多柜
四家的产品线都要分两层看:
| 单柜 | 72 GPU | 72 GPU | 128–144 GPU(2 个域) | 64 NPU |
| 多柜 | 576 GPU 单域 | 官方未给数字 | 10,368 卡 | Atlas 950 SuperPoD 8,192 NPU 单域 |
为什么必须分开比?三个理由:
第一,机械与电气的边界就在这里。单柜内的互连通常用铜——距离在两米以内,正交连接器直连,不需要光模块。一旦跨柜,距离超出铜的可达范围,必须上光。这是距离约束,不是"scale-up 必须用铜"(详见 1.2.1 节的警示)。
第二,单柜的域规模有一个硬上限。NVIDIA NVL72 的 72 卡,就是它的铜脊架构在一个机柜内的物理极限。要更大,只有两条路:换更宽的机柜(阿里选双宽),或者跨柜(华为选跨柜)。
第三,也是最容易被混淆的:单柜卡数和单域卡数不是一回事。AL128 单柜 128–144 卡,但它是两个64–72 卡的域。
所以后面的所有对比表,都按这两层分开列。
1.4 三层交换结构
| Scale-up 域 | 多柜:576–10,368 卡 | ||
| Scale-out 域 | |||
| 跨数据中心(DCN) |
三层之间的带宽落差是数量级的。NVIDIA 官方博客给过一个对比:VR NVL72 的 NVLink 域内聚合带宽是 260 TB/s量级,而跨出域之后的 InfiniBand / 以太网单卡带宽是 GB/s 量级——中间差了大约三个数量级。
这个落差意味着:模型并行组一旦被切到域外,吞吐损失会以数量级计。所以"域边界画在哪里"比"链路跑多快"更能决定实际性能。
1.5 看四家的统一框架:三个必答问题
四家都在往多柜走,但走法各不相同。要把它们放在同一张桌上比,需要先立三个问题——这三个问题也是后面四章的统一分析框架。
问题一:跨柜之后,它还是不是一个 scale-up 域?
按 1.2 节的判据,要看三件事:跨柜后还有没有内存语义(能不能直接 load/store 远端内存)?距离是否还在设计包线内(UALink 的铜缆 <4 米显然不够跨柜,所以必须上光——这不是简单的加个光模块,而是协议层的重新设计)?端点集合是否仍然单一且已知?
问题二:它在哪些层级留了余量(收敛比)?
这一问不是分类判据(见 1.2.2 节末尾),但它是四家多柜拓展中最值得横向对比的工程参数。要问的是:在哪一层留了多少余量?这个余量是给谁的——给突发流量、给故障冗余、还是给多租户隔离?
问题三:用什么互连方案,为什么?
四种可能:私有协议走铜、私有协议走光、以太网派生协议、自研协议 + 自研光层——每一种的锁定程度完全不同。而厂商选择背后的理由通常有三类:延迟(单级 / 两级交换之争)、成本(光模块与交换芯片的 BOM)、生态(是否愿意被单一供应商锁定)。
这三个问题的答案分别落在两处:
• 1.6 节回答"域能做多大、靠什么做到"——这是全文的核心问题,也决定了问题一与问题三; • 下篇第 6 章的表 8回答"各自留了多少余量"——那张表的稀疏程度本身就是结论:四家里只有阿里公布了逐层的准确数字,AMD 完全空白。
1.6 scale-up 域能有多大,靠什么实现
这是全文的核心问题。四家的所有技术选择——用什么协议、做几级交换、哪一段上铜哪一段上光、拓扑怎么摆——最终都是对这一个问题的不同回答。
1.6.1 先明确一点:这个答案只能在 scale-up 域里找
一个很自然的想法是:域不够大,就把集群做大。但 scale-out 域有自己的规模上限,而且这个上限有明确的官方依据:
| 1,016 GPU | ||
| 576 GPU / SU 非阻塞 | 16 SU = 9,216 GPU 时出现核心层交换机 → 三级 | |
| 8,192 GPU | ||
| 1,024 xPU | ||
| 24,000 GPU = 三层 Clos,聚合层收敛比 1:7 |
两级 Clos 覆盖千卡级;万卡级普遍进入三层 Clos。这意味着**"把集群做大"替代不了"把域做大"**——域内与域外之间的带宽落差是数量级的(第 1.4 节已述),集群铺得再大也改变不了这一点。
一个需要谨慎处理的例外:阿里云的 HPN 在 2024 年论文里被描述为"双平面、两层设计,单 pod 最多互联 15,000 张 GPU"。这看起来支持"两级到万卡",但要注意两点:这是 HPN 的原始版本,不是 HPN 8.0;且它与 NVIDIA、Meta 的公开设计点直接冲突。
同样叫"两级",不同厂商的承载规模差了 3 倍以上——这说明"层级数"不是可比的度量,radix(交换芯片端口密度)与平面数才是。
1.6.2 域规模的阶梯:每一级都要跨过一道坎
scale-up 域不是连续长大的,而是一级一级跳上去的。每一级台阶都对应一个必须被解决的新问题:
| 8 卡 | ||
| 64–72 卡 | 引入交换芯片 | |
| 144 卡 | 双宽机柜 + 正交背板 | |
| 384 卡 | 必须跨柜 → 必须上光 → 必须两级交换 | |
| 576 卡 | ||
| 1,024 卡 | ||
| 8,192 卡 | ||
| 10,368 卡 | 二级 SNPO 光互连 |
这张表里有一条清晰的分界线:72–144 卡。
• 这条线以下,是"机柜内的工程问题"——怎么把铜缆、交换芯片、供电和散热塞进一个柜子。域规模和机柜边界基本重合。 • 这条线以上,是"跨机柜的系统问题"——怎么用光把多个柜子焊成一个域,并且让软件仍然认为它是一台机器。
所以域的每一次跃升,背后都是一次具体的技术突破:72 卡靠交换芯片,144 卡靠双宽正交背板,384 卡以上靠光 + 多级交换。
1.6.3 四家的实现方式:同一道题,四种答案
既然跨越条件各不相同,四家选出的组合也不一样:
| NVIDIA | 576 GPU | 两层 all-to-all NVLink | |
| AMD | 未公布 | ||
| 阿里云 | 10,368 卡 | ||
| 华为 | 8,192 NPU |
四家的起点是相同的——单柜产品柜内都是单级交换:
• 阿里云 AL128:官方技术长文原文——"单级交换拓扑","64 到 72 张 GPU 可以在单级交换拓扑下以非阻塞全网状模式连接"。它对两级的评价也很直接:"两级交换拓扑会增加延迟,因此意义不大。" • NVIDIA NVL72:官方描述是"单一 all-to-all 拓扑",72 张 GPU 经 NVSwitch 单跳全互连。 • AMD Helios:官方 solution brief 写的是"单跳、多平面 fabric"。
但一旦跨柜,这条通则就守不住了:
| 两级 | ||
| 两级 | ||
| 华为 | 多级 |
前三个厂商的路径是"先把单柜做到单级交换,再往两级扩";华为跳过了这个阶段,第一代 CM384 就把 scale-up 域做成了跨机柜的两级。
于是全文的主轴可以压成一句话:真正的分水岭不是"单级还是两级",而是"你愿意用多少延迟预算换多大的域"。后面四章,就是四家对这个问题的四个回答。
一个分类法覆盖不到的玩家:严格说,"单级交换 / 两级交换"这个二分法并不普适。Google TPU 的 ICI 用的是 3D torus 直接网络 + 光路交换(OCS)重构拓扑——TPU v4 论文的措辞是"用户可以选择 twisted 3D torus 拓扑"、"OCS 像一块插线板一样跳过故障单元"。它根本没有交换机层级的概念。
所以当有人问"TPU 是几级交换"时,这个问法本身就不成立——它不在本文这条轴上。本文聚焦四家,不展开 TPU。
第 2 章 NVIDIA Vera Rubin NVL72:把"域"做成产品
2.1 代际定位:从 GB200 到 VR200,每代解决什么
NVIDIA 的机架级产品线走到第三代,每一代的命题都不一样:
• GB200 NVL72(2024):证明"机柜即域"这个形态可行。72 张 Blackwell + 36 颗 Grace,130 TB/s 聚合 NVLink 带宽。 • GB300 NVL72(2025):把推理性能与显存容量推上去,为 reasoning 负载做准备。 • Vera Rubin NVL72(2026):官方定位是"面向 Agentic AI 的机架级超级计算机",同时服务四条 scaling law——预训练、后训练、测试时扩展、Agentic 扩展。
这个演进里最值得注意的是负载假设的变化。NVIDIA 在官方技术博客里给出的逻辑是:Agentic 系统会规划任务、调用工具、执行代码、在多个 agent 之间协调,这些交互会产生大量 reasoning token、撑大 KV cache,并且需要基于 CPU 的沙箱环境来验证结果。需求因此同时压在 GPU、CPU、scale-up 域、scale-out 网络和存储上。
这个判断解释了为什么 VR200 这一代不只是"换更强的 GPU",而是变成了五种机架组成一个 POD。
2.2 域能做多大
先把本章的答案给出来。这正是第 1.6 节提出的那个问题:域能做多大,靠什么做到。
| 单柜 | 72 卡 | |
| POD 级 | 1,152 卡 | |
| 多柜单域 | 576 卡 |
NVIDIA 的路径是先把单柜做满,再往多柜扩——72 卡是铜脊架构在一个机柜内的物理极限,跨到 8 个机柜就必须上两层交换。怎么做到的见 2.3 节,下一代路线见 2.7 节。
2.3 靠什么实现:单级全互连
这是理解 NVIDIA 路线的核心。
72 张 GPU 通过 9 个 NVLink 交换托盘构成单一的 all-to-all 域,任意两张 GPU 之间都是单跳。官方博客的措辞是:5000 根线缆构成的 NVLink 脊组成"单一 all-to-all 拓扑",任意 GPU 都能以一致的延迟和带宽与任意其他 GPU 通信。
这个"一致性"是单级交换的本质优势——没有跨级跳数差异,没有多级交换的拥塞与延迟抖动。代价是交换芯片的端口数限制了域的上限:72 卡已经是这套铜脊架构在单机柜内的物理极限。
NVIDIA 自己也知道这个上限。官方博客写明,路线图"支持 scale-up 域规模扩展到 1152 GPU"。而实现方式就藏在下文 2.7 节的 NVL576 里。
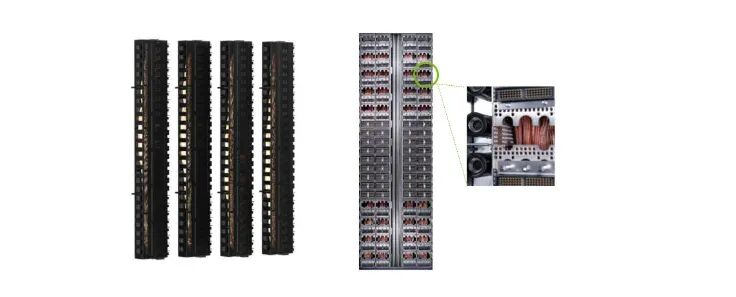
图 4:第三代 MGX 机架的铜脊背板。它由最多 4 个预集成、预验证的铜缆模块组成,可配置为 NVLink(NVL 机架)或 Spectrum-X 以太网 / Groq 3 LPU 直连(ETL 机架)。(图片来源:NVIDIA 开发者博客)
2.4 芯片级规格
Rubin GPU(A 级,官方架构博客)
| 50 PFLOPS sparse / 35 PFLOPS dense | |
| 制程 | NVIDIA 未公布 |
| TDP | NVIDIA 未公布 |
⚠️ 要注意的是:Rubin 的制程与 TDP,NVIDIA 官方从未给出数字。流传的"TSMC N3P、TDP 约 2300W"属于供应链推测,不是官方规格。
⚠️ 另一个更重要的口径问题:NVIDIA 官方写"50 PFLOPS NVFP4",没有标注这是 dense 还是 sparse。这个缺失在后面与 AMD 对比时会变成一个大坑,详见 2.6 节。
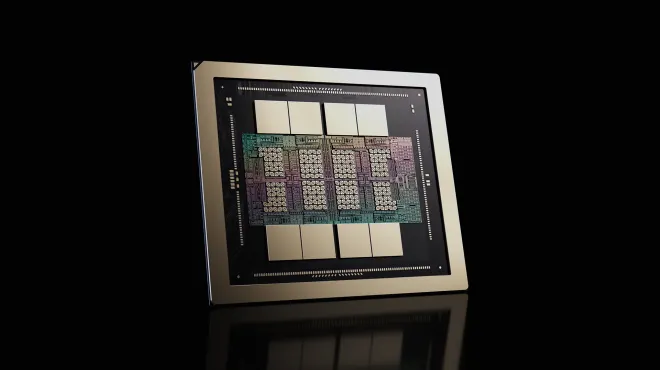
图 1:NVIDIA Rubin GPU。Rubin 由两颗 reticle-limited die 通过 NV-HBI 封装而成,总计 3360 亿晶体管、224 个 SM。(图片来源:NVIDIA 开发者博客)
Vera CPU(A 级,官方产品页)
| 88 颗自研 Olympus 核 | ||
| 176 | ||
互连与网络芯片(A 级)
| NVLink 6 | 3,000 GB/s(216 TB/s 聚合) 3.6 TB/s(260 TB/s 聚合)官方博客口径 ⚠️ |
| ConnectX-9 SuperNIC | |
| BlueField-4 DPU | |
| Spectrum-6 ASIC |
⚠️ NVLink 6 的带宽,NVIDIA 自己两个官方口径打架。官方规格表写 3,000 GB/s per GPU(对应 216 TB/s 聚合),官方博客写 3.6 TB/s per GPU(对应 260 TB/s 聚合)。同一家公司的两个官方页面,差了 20%。
本文的处理方式:两个都列出,并指出官方未解释差异。这本身就是很好的方法论素材——如果连官方规格表与官方博客都能不一致,那么任何"单一权威数字"的说法都要打折扣。
2.5 整机与工程
整机规格
官方规格表(A 级)
| 72 × Rubin GPU + 36 × Vera CPU | |
| 3,600 PFLOPS sparse / 2,520 PFLOPS dense | |
| 20.7 TB,1,400 TB/s | |
| 45 °C |
OEM 数据表(A 级,Pegatron RA4803-72N3)
这一份数据表的价值在于它给出了NVIDIA 官方未公布的整机柜功耗:
| 9 个 | |
| 功耗 | Max Q = 188 kW / Max P = 228 kW |
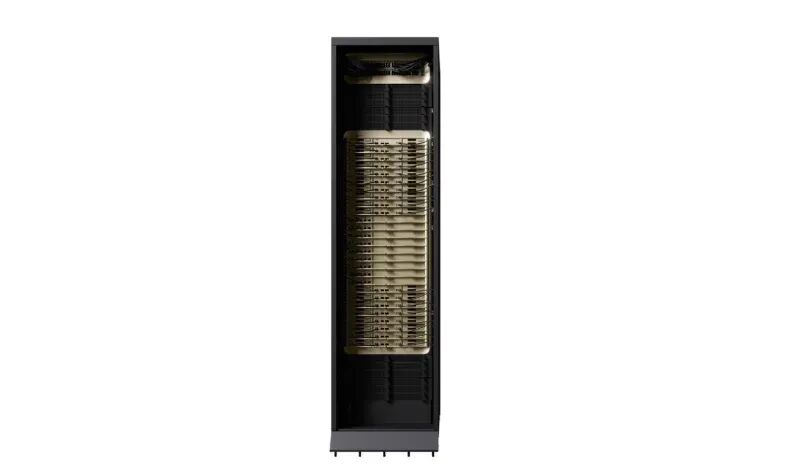
图 2:NVIDIA Vera Rubin NVL72 机架。72 张 Rubin GPU 与 36 颗 Vera CPU 通过第六代 NVLink 铜脊连接为单一域。(图片来源:NVIDIA 开发者博客)
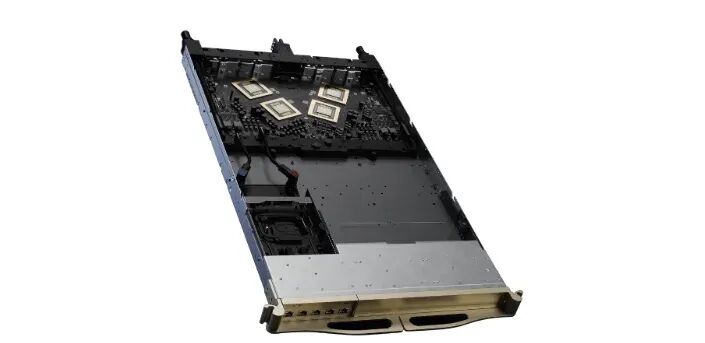
图 3:Vera Rubin 的 NVLink 交换托盘。每个托盘含 4 颗 NVLink 6 交换芯片,整机 9 个托盘负责 72 张 GPU 的全互连。(图片来源:NVIDIA 开发者博客)
工程:把"可维护性"当成一等公民
第三代 MGX 机架有三点值得单独说:
无缆、无管、无风扇托盘。计算托盘与 NVLink 交换托盘都采用 PCB 连接,不做线缆跳接,单宽 19 英寸设计简化了运输与物流。
Intelligent Power Smoothing(智能功率平滑)。AI 负载会产生大幅功率波动,MGX 的做法是用电容做机架级储能:负载突增时由电容补、负载骤降时电容充电,电网取电始终平稳。VR NVL72 这一代做到 400 J/GPU 的机架级储能(前代 6 倍),并让 GPU 持续监控电容荷电状态——官方给出的效果是峰值电流需求降低最多 25%。
45°C 温水液冷。官方称这一设计可在同一电力预算内容纳最多多出 10% 的 NVL72 机架。
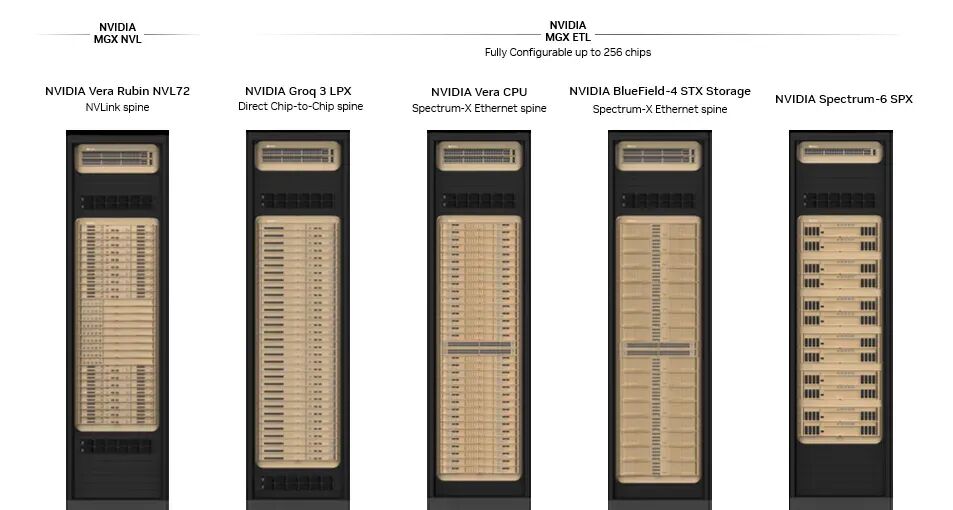
图 5:Vera Rubin POD 的五种机架级系统。从左到右依次承担不同的角色——计算、低延迟推理、CPU 沙箱、上下文存储、东西向网络。(图片来源:NVIDIA 开发者博客)
2.6 POD 视角:从"一台机器"到"一个工厂"
VR200 这一代最明显的思路变化,是 NVIDIA 不再只卖一个机柜,而是卖五机架组成的一个 POD。
| Vera Rubin NVL72 | ||
| Groq 3 LPX | ||
| Vera CPU 机架 | ||
| BlueField-4 STX | ||
| Spectrum-6 SPX |
整个 POD 的规格:40 个机架、1.2 quadrillions 晶体管、近 20,000 个 NVIDIA die、1,152 张 Rubin GPU、60 exaflops、10 PB/s 总 scale-up 带宽。
这个 10 PB/s 值得停一下——它意味着 POD 内的 1152 张 GPU 全部被纳入了同一个高速域。而 1152,正是官方博客里"scale-up 域路线图支持到 1152 GPU"的由来。
2.7 下一代与裂缝
Vera Rubin Ultra NVL576(2027,官方口径)
NVIDIA 官方博客原文:
"NVIDIA Vera Rubin Ultra introduces a new two-layer all-to-all NVLink topologythat will enable developers to scale-up to 576 GPUs. Vera Rubin Ultra NVL576 will combine eight separate MGX NVL racks, each with 72 Rubin Ultra GPUs, all in a single 576-GPU NVLink domainwith copper and direct optical connections."
三个要点:两层(two-layer)、8 机柜、铜 + 直连光。官方还提到 NVL1152用类似的直连光做 rack-to-rack scale-up,并展示了内部原型机 Polyphe(基于 GB200 的多机架 NVL576 scale-up 原型)。
这句话的重要性在于:NVIDIA 自己承认单级交换撑不到 576 卡。机柜内 72 卡是单级,跨到 8 个机柜就必须上两级。这与第 1 章的论点完全吻合。
Kyber NVL144:NVIDIA 对"144 卡"的答案,每机架 NVLink 域翻倍至 144、可扩至 NVL1152、面向 Feynman 世代。
这里有个状态争议必须并陈:
• SemiAnalysis 经 CNBC 报道:Kyber 因 PCB 中板可制造性问题延期逾 12 个月至 2028;相关细节为 78 层正交中板、M9 级覆铜板 + 石英布;NVL576 也可能延期或仅小规模生产;NVL72×2 背靠背过渡方案因云厂商反对被取消。 • NVIDIA 官方回应(黄仁勋在摩根士丹利闭门路演):Rubin Ultra 仍按原计划 2027 年量产交付;Kyber 机柜方案确实在升级、被更先进的可扩展架构取代,属架构优化而非延期;"四芯改双芯、性能与显存减半"的说法"未获官方证实,且与实际进展不符"。
两边都写,读者自己判断。这是"厂商路线图 vs 供应链现实"最典型的案例。
⚠️ 另外两个必须标注为传说的数字:
1. "Kyber PCB 中板线宽线距 25µm"——查无来源。已核实的只有 78 层、M9 级覆铜板 + 石英布。这个数字流传很广,但没有任何一手来源。 2. Rubin Ultra 单柜功耗 600 kW vs 660 kW:DataCenterDynamics 报 600 kW,TrendForce 报 660 kW,两个口径冲突。
本章结论
NVIDIA 卖的是确定性最强的 72 卡域:单级交换保证延迟一致,NVLink 6 + CUDA/NCCL/NVSHMEM 全栈协同保证软件体验,MGX 第三代保证可维护性。
代价有三:生态绑定(NVLink 是私有闭环)、域上限(单机柜 72 卡,要更大就得上两级)、代际节奏风险(Kyber 的争议说明先进封装的制造极限正在成为路线图的约束)。
但有一点必须承认:在"让软件相信这是一台机器"这件事上,NVIDIA 仍然是四家里做得最彻底的。
第 3 章 AMD Helios:用开放标准打闭环
3.1 定位:从 8 卡服务器到机架级系统
Helios 对 AMD 来说是一次形态跃迁,而不只是产品迭代。
在此之前,AMD 的 Instinct 平台是8 卡服务器级产品——MI355X 的官方脚注明确写着"8xGPU AMD Instinct MI355X platform",AMD 从未定义过机架级的 scale-up fabric。Helios 是 AMD 第一个 rack-scale 设计:72 张 MI455X 组成单一 scale-up 域 + 单一 load/store 域。
它的底座是开放标准:
• 机架形态用 OCP Open Rack Wide(ORW)双宽规范,源自 Meta 在 OCP 2025 提交的设计。AMD 的原话是"完全基于 ORW 开放标准构建"。 • scale-up 用 UALoE(UALink over Ethernet),scale-out 用 UEC 对齐的以太网。
发布时间线:2025 年 6 月预览,2025 年 10 月 14 日向 OCP 提交参考设计,2026 年 7 月 23 日(Advancing AI 2026)正式发布并进入 full production,出货自 2026 Q3 末开始。
3.2 域能做多大
先把本章的答案给出来。
| 单柜 | 72 卡 | |
| 多柜单域 | 官方未公布 |
AMD 是四家里唯一没有公布多机柜架构细节的一家:没有类似 NVIDIA SuperPOD 那样的分层参考架构,没有拓扑图,没有交换芯片型号,也没有收敛比。官方对跨柜的唯一表述是一句 "scales across racks using UALink-over-Ethernet"。
怎么做到的见 3.3 节;这同时也是 3.7 节列出的第一个裂缝。
3.3 靠什么实现:开放标准下的混合实现
这是本章最值得展开的部分,因为它揭示了一个与宣传口径不完全一致的现实。
官方口径:UALoE over Ethernet,单跳、多平面 fabric(single-switch-hop, multi-plane fabric);每 switch 托盘 2 颗 512-lane 200G ASIC,每 ASIC 216 条 UALoE(x2) 活跃链路,每托盘 21.6 TB/s 双向,6 个托盘合计 260 TB/s。
实际硅片:第三方架构拆解显示,Helios 的 scale-up 交换用的是 Broadcom Tomahawk 6(BCM78910)——512 lane @ 200Gbps,每 ASIC 432 lane 活跃。
为什么?因为原生 UALink 交换芯片没有及时到位。
这个事实很重要:"教科书式的纯 UALink pod"目前并不存在。真实产品是"UALink 事务语义 + Ethernet 派生 fabric + Broadcom 交换芯片 + AMD GPU"拼起来的一台机器。
AMD 的官方文档里其实也留了余地:它同时使用 UALink、UAL over Ethernet 和"标准以太网 scale-up 交换"三种表述。对买方而言,规范名称没有"72 张 GPU 能否被通信库、runtime 和调度器当成一个稳定的 scale-up 域"重要。
⚠️ 顺带一个存疑项:ServeTheHome 拆解给出"每 GPU 36 条 UALoE 链路(对 12 颗 switch ASIC 各 3 条)"的数字,但 AMD 官方 brief 只写了"单跳、多平面"和"每机柜 6 个 switch 托盘",没有给出 36/12 这组数字——它来自第三方拆解,不是官方口径。
3.4 芯片级规格
Instinct MI455X(A 级,官方产品页与 datasheet)
| TSMC 2nm + 3nm | |
| MXFP4 算力 | 40.3 PFLOPS(dense) |
| HBM4 | 432 GB,12 stacks,23.3 TB/s |
| TDP | AMD 未公布 |
⚠️ 两个口径问题必须注意:
第一,MI455X 的 TDP,AMD 官方产品页与 datasheet 都没有这个字段。网上流传的各种 TDP 数字都没有官方来源。
第二,型号命名。AMD 官方文件里不存在 "MI450X" 这个型号。2025 年 10 月到 2026 年 3 月的官方公告一律用 "MI450 Series",2026 年 7 月上市的名称是 MI455X。MI400 系列包含 MI455X(前沿 AI)与 MI430X(主权 AI / HPC)。
EPYC "Venice"(第 6 代 EPYC 9006)(A 级)
网络芯片(A 级)
| Pensando Vulcano | ||
| Pensando Salina |
⚠️ 这里有一个代号纠错要提醒:网上常见"Salina 是自研 scale-up 交换芯片"的说法,是错的。Salina 是 400G DPU,Pollara 400 是上一代 400G AI NIC。Helios 里没有 AMD 自研的交换芯片(原因见 3.4)。
3.5 整机规格
| 72 × MI455X + 18 × EPYC Venice(96 核/颗) | |
| 18 × 1OU "1P:4G" | |
| 6 个 | |
| 2.9 EFLOPS OCP MXFP4(dense) | |
| 31 TB | |
| 260 TB/s | |
| 43 TB/s | |
| 225–245 kW | |
功耗参考设计由 AMD 与 Schneider Electric 联合发布:单柜最高 246 kW,模块化可扩至 10.4 MW集群,液冷带走机架内约 84%的热量,满载 PUE 最低约 1.12。
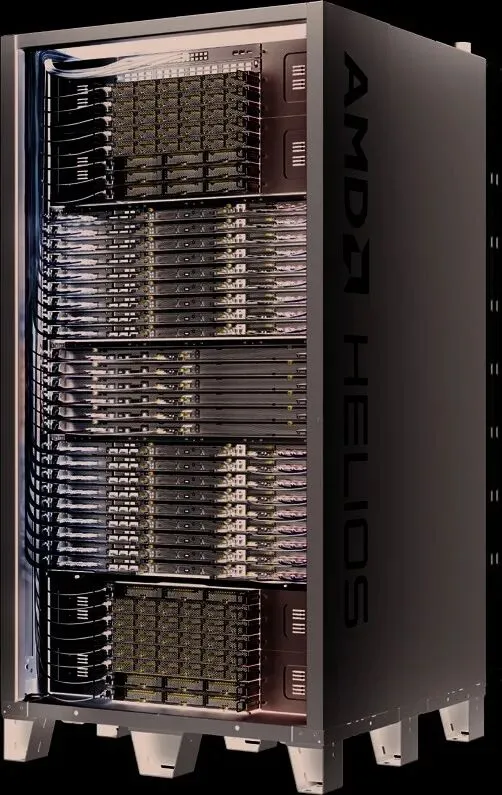
图 6:AMD Helios 机架正面。18 个 1OU 计算托盘加 6 个 switch 托盘,全液冷、背面快插。(图片来源:AMD Instinct Helios blueprint)
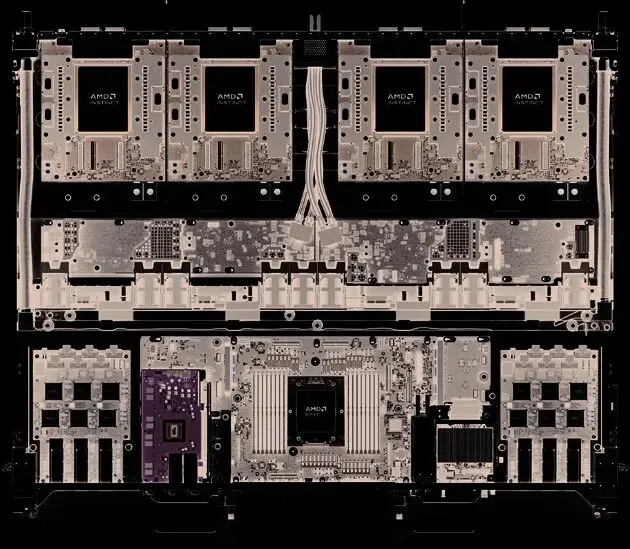
图 7:Helios 计算托盘。每托盘 1 颗 EPYC Venice + 4 颗 MI455X,采用 OCP ORW 双宽形态。(图片来源:AMD Instinct Helios blueprint)
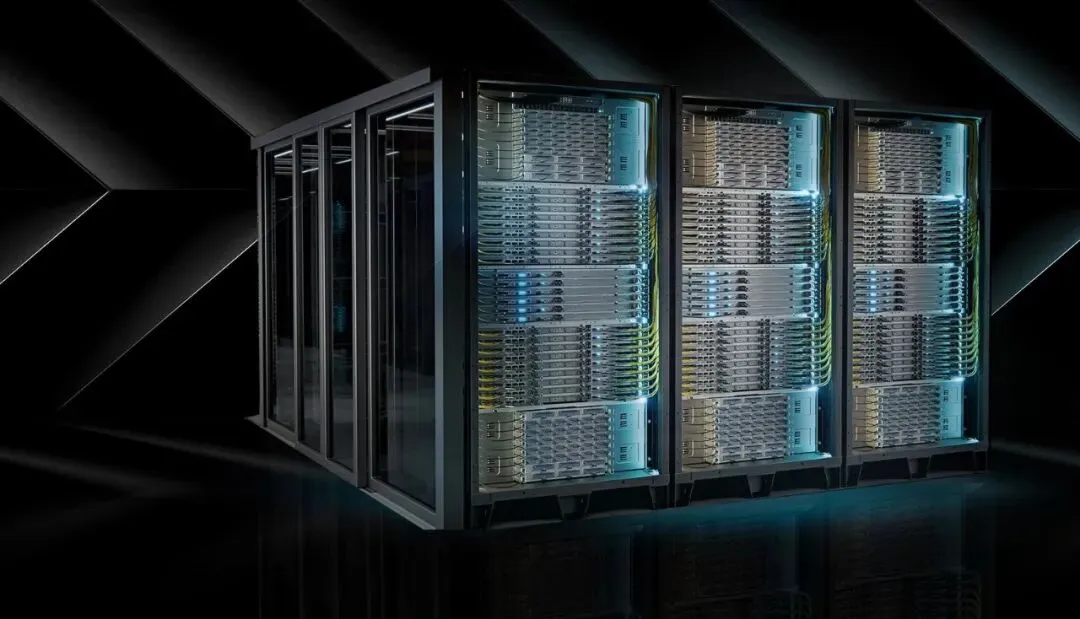
图 8:Helios 机架的数据中心部署形态。(图片来源:AMD Instinct Helios blueprint)
3.6 客户与生态
AMD 这一代的客户名单是四家里最"豪华"的:
| OpenAI | ||
| Meta | ||
| Microsoft | ||
| Oracle / OCI | ||
| Anthropic | ||
| TCS / HyperVault | ||
| HPE | ||
| Celestica | ||
| Schneider Electric |
注意 HPE 的 Vultr 订单细节:交换托盘用的是 Juniper QFX5252,不是 AMD 自研芯片。这与 3.3 节的判断一致。
3.7 裂缝
第一,TDP 未公布。MI455X 的板卡功耗,AMD 官方从未给出。这在四家里比较特殊(NVIDIA Rubin、阿里真武同样未公布,但华为 Atlas 950 的单柜功耗是公开的)。
第二,AMD 官网自己两个数字打架。Helios 产品页的计算托盘段落仍保留着 2025 年的旧文案"每 GPU 19.6 TB/s",而规格表与 datasheet 写的是 23.3 TB/s(与蓝图里的 1.67 PB/s 聚合带宽一致)。以 23.3 TB/s 为准。
第三,也是最关键的:AMD 是四家里唯一没有官方 800V 高压直流表态的厂商,也没有公开 2027–2028 的单柜功耗目标。在一个单柜功耗已经冲到 246 kW、下一代目标普遍指向 MW 级的行业里,这个空白值得注意。
第四,口径不可直接比。AMD 官方对比表宣称"FP4 峰值 +15% vs NVIDIA Vera Rubin NVL72",但仔细看脚注:AMD 用的是 OCP MXFP4 dense,而 NVIDIA 对外宣传的 NVL72 是 3.6 EFLOPS NVFP4 sparse。dense 对 sparse 相比,这个 +15% 不能当实测结论。(AMD 的另一份材料确实是拿 MXFP4 dense 对 NVFP4 dense 比,但对外宣传时的口径混淆是真实存在的。)
本章结论
AMD 赌的是**"够用的域 + 开放的采购与运维"**。72 卡单级单跳域与 NVIDIA 持平(260 TB/s vs 216–260 TB/s),HBM 容量 31 TB 明显领先(NVIDIA 20.7 TB),客户名单覆盖了几乎所有头部 AI 公司。
但开放路线有一个尚未兑现的部分:scale-up 交换芯片目前是买来的(Broadcom Tomahawk 6),原生 UALink 交换芯片何时到位、是否自研,AMD 至今没有给出时间点。这让"开放"在现阶段更像是一种集成策略,而不是芯片策略。
成败取决于两件事:UALoE 的软件栈能否被云厂商真正消费,以及原生 UALink 交换芯片能否按时到位。
第 4 章 阿里云磐久 AL128:单级交换的最后一位坚定信徒
4.1 定位:从"整机"到"系统"
磐久 AL128 是阿里云在 2025 年云栖大会发布的一代超节点服务器(磐久 AI Infra 2.0),2026 年 5 月上阿里云百炼平台,目前已规模部署。
它的官方定位有一句话很值得注意:"相较传统架构,磐久 AL128 的架构可以在同等 AI 算力下将推理性能提升 50%。"
这句话的措辞是"架构"而不是"芯片"。阿里云在这份技术长文里,把整个论证建立在互连方式的重构上,而不是单卡性能上。这个立场贯穿全篇。
AL128 在本文中的特殊价值:四家里,只有阿里云公开了一份接近论文级别的 scale-up 互连架构文档(2025-11-14,官方英文博客)。这份文档让外部第一次能看清一个中国厂商的机柜级 scale-up 拓扑到底怎么搭、SerDes 怎么分配、为什么不做两级交换。
换句话说:如果要理解"超节点"这类产品的工程细节,AL128 是四家里透明度最高的样本。
4.2 域能做多大
先把本章的答案给出来。
| 单柜 | 128–144 卡,但分成两个域 | 已规模部署 |
| 多柜单域 | 10,368 卡 |
这里有一个必须分清的口径:AL128 单柜 128–144 卡,很容易被读成"一个 128 卡的域"。实际上按官方技术长文,机柜里划分了上下两个 ScaleUp 域,每域一组 AL64。所以论单域规模,它和 NVL72、Helios 是同一档(64–72 卡)。
阿里是四家里唯一"单柜有两个域"的——这个设计选择直接决定了它后面的路线(见 4.8 节)。怎么做到的见 4.3 节。
4.3 靠什么实现:单级交换的官方拓扑与论证
Scale-up 架构:一份罕见的官方拓扑文档
这是本章的核心,也是本文最重要的技术细节之一。
拓扑结构(官方原文)
机柜前视图的左上部分是第一个 ScaleUp 域,包含 64 到 72 张 GPU,由前部 16 到 17 个 GPU 节点(每节点 4 张 GPU)和后部 8 个 ALink Switch 节点组成。上下两个 ScaleUp 域各一组 AL64。
在单级交换拓扑下,一个域内的 64–72 张 GPU 可以以非阻塞全网状模式连接。
SerDes 分配(官方原文)
• 每张 GPU 最多预留 128 条高速互连 SerDes • 单 GPU 最大互连带宽 14 Tbit/s 到 28 Tbit/s • GPU 与 ALink Switch 芯片使用 112 Gbit/s 或 224 Gbit/sSerDes • ALink Switch 芯片支持 64 端口 / 128 端口两档
跨域连接:上下两个 AL64 域支持跨域连接,但按单级交换原则,需要 128 端口的 ALink Switch 芯片。
协议:非以太网的私有 ALink 协议,基于 GPU 原生内存语义,使用 flit、LLC、基于信用的流控(CBFC)等技术。官方同时声明兼容 UALink 开放标准,以及业界主流 GPU 的原生内存语义协议(NVLink、xLink、UB、xCN)。
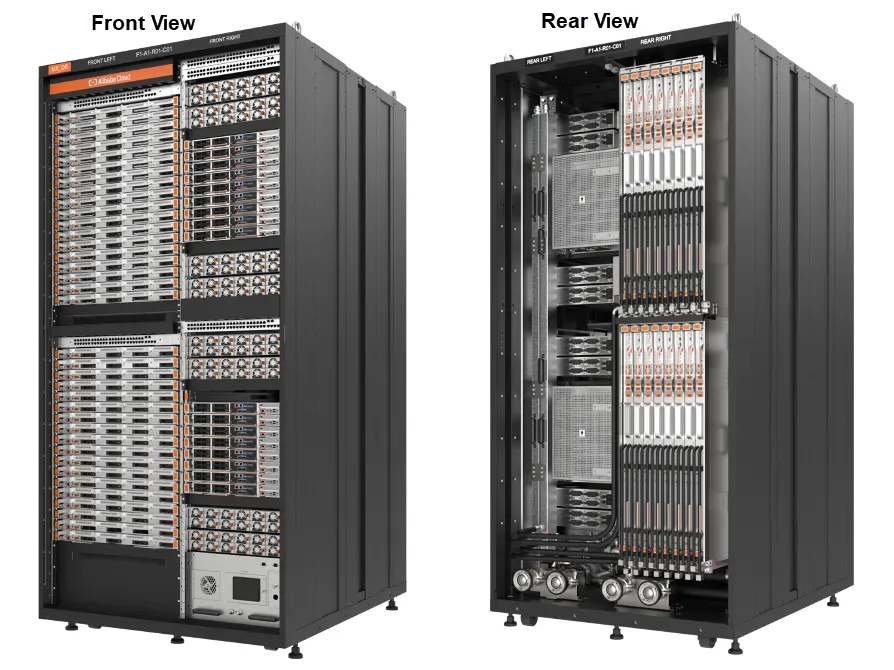
图 9:磐久 AL128 超节点服务器的前视图与后视图。GPU 节点与 ALink Switch 节点以正交互连架构部署在左侧,CPU 节点与供电节点在右侧。(图片来源:阿里云官方博客)
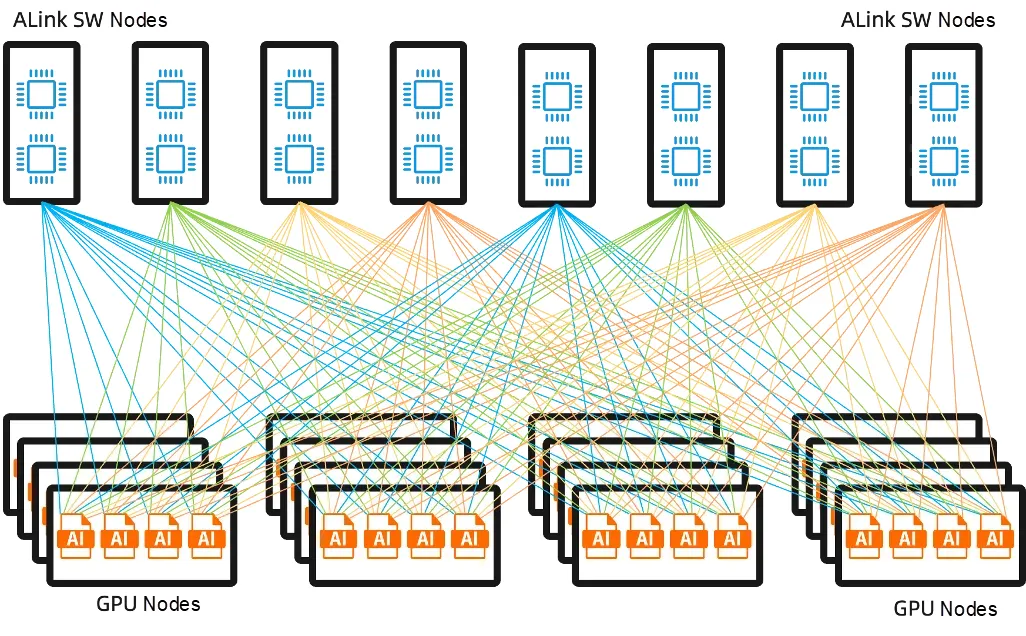
图 10:磐久 AL128 的 ScaleUp 互连拓扑。上方 8 个 ALink Switch 节点(每节点 1–2 颗 ALink Switch 芯片,64 端口规格),下方 16 个 GPU 节点(每节点 4 张 GPU,合计 64 张),通过正交连接器实现非阻塞全网状互连。(图片来源:阿里云官方博客)
这张图值得仔细看。它展示的是教科书式的单级全互连:8 个交换节点在顶部,16 个 GPU 节点在底部,每个 GPU 的 ScaleUp 端口 0 和 8 接到 ALink Switch 0 节点、端口 1 和 9 接到 Switch 1 节点,依此类推。任意两张 GPU 之间都是一跳。
为什么阿里是单级交换最坚定的信徒
这是本章最有价值的部分。阿里云在这份官方文档里,用词之直接,在厂商材料里相当罕见:
"ScaleUp interconnection uses the single-stage switching topologyto maintain extremely low latency. The two-stage switching topology increases latency and therefore is of little significance."
翻译:"ScaleUp 互连使用单级交换拓扑以维持极低延迟。两级交换拓扑会增加延迟,因此意义不大。"
紧接着还有一句:
"Each ScaleUp domain with 128 GPUs is the most cost-effective choice at present."
阿里不仅选择了单级交换,还明确论证了两级交换"意义不大"。它给出的理由是延迟——单跳保证固定延迟,两级引入排队与抖动。
更值得注意的是阿里对以太网路线的批评。官方原文点名 UEC、SUE、ETH+ 这几条"面向 ScaleUp 的以太网路线",说它们:
"……已经放弃了以太网帧格式,甚至修改了以太网前导码……虽然仍被宣传为以太网,但它们与标准以太网协议不兼容,也缺乏 IP 地址的概念。本质上,它们已经不再是以太网协议了。"
这是本文四家对比里最直接的一次观点冲突:AMD 与 Broadcom 主推的正是 SUE(Scale Up Ethernet)这条路线,阿里直接在官方文档里否定了它的"以太网"身份。
无论读者是否同意阿里的判断,这段话的价值在于它揭示了一个真实的技术分歧:"用以太网做 scale-up"到底是在复用以太网生态,还是在借以太网之名行私有协议之实?这个问题在第 6 章会比较四家的协议选择时再次出现。
4.4 芯片级规格
真武 M890(B 级,官方峰会)
| 144 GB | |
| 800 GB/s | |
| 未公布 | TFLOPS、HBM 代次与带宽、制程 |
ICN Switch 1.0(B 级):最高 25.6 Tbps聚合带宽,实现 64 个加速器的全带宽互联。
软件栈:T-Head SAIL™(平头哥自研软件栈)。
⚠️ 这里出现本文第一个"结构性空白":阿里云从未公布真武 M890 / V900 的 TFLOPS、HBM 代次与容量规格、制程节点。NVIDIA 公布了 50 PFLOPS NVFP4(虽然没标 dense/sparse),AMD 公布了 40.3 PFLOPS MXFP4 dense,而阿里这颗芯片的算力数字是完全缺失的。
这不是"查不到",而是"从未公布"。后续对比表里阿里这一列的大量空白,反映的是原始材料的公开程度,而不是数据缺失。
4.5 整机规格
| 128–144 张真武 M890 | |
| 两个,每域 64–72 卡 | |
| 350 kW | |
| 500 kW | |
"双宽机柜 + 350 kW"这个组合是理解 AL128 的起点。它比 NVIDIA 的 48U 单宽机架和 AMD 的 ORW 双宽机架都要激进——在 2025 年,350 kW 已经接近当时机柜供电的现实上限。
4.6 Scale-out 架构
三层互连架构:Layer 1 = 超节点内 ScaleUp 域;Layer 2 = 超节点间 ScaleOut 网络;Layer 3 = 超节点与数据中心之间的 DCN。
阿里的 Scale-out 网络有明确的收敛比数字——这一点四家里最透明
AL128 的 ScaleOut 层没有公布收敛比,但阿里的 HPN 网络有一篇 SIGCOMM 2024 论文,给出了逐层的准确数字。这是本文能找到的、四家里唯一一组一手收敛比数据:
| Tier-1 | 1.067 : 1 | |
| 前端网络 | 1 : 1 | |
| Aggregation-Core | 15 : 1 | |
| 15,000 GPU / pod |
这组数字非常有价值,原因有两个:
第一,它证明了收敛比是"逐层设计"的。同一张网里,Tier-1 几乎无收敛(1.067:1),而一路往上到 Aggregation-Core 就变成了 15:1。"这张网是几比几"这个问题本身就没有答案——必须问"哪一层"。
第二,它说明"无收敛"并不是 scale-up 的专利。阿里的 Tier-1 是 scale-out 层,却做到了 1.067:1;而华为的 UB-Mesh 是 scale-up 层,却明确做成了逐层收敛(见 5.4.2 节)。两个方向的反例同时存在。
⚠️ 一个必须注明的适用性限制:这组数字来自 HPN 的原始论文(2024),不是 HPN 8.0。HPN 8.0(2025 云栖发布,800G / 1.6T、十万卡级)的收敛比未公布——媒体报道明确写"这个最新版本的细节很少"。
⚠️ 阿里官方文档还有一个前瞻性判断值得注意:它提出未来可能演变为两层架构(ScaleUp + 高带宽 DCN),并直接追问:"当 DCN 网卡带宽从 400 Gbit/s 提升到 1.6 Tbit/s 之后,超节点的跨域流量是否还需要一个独立的 ScaleOut 网络?"
这个问题的答案,其实就是第 7 章里 AL144 的论证逻辑。
⚠️ 关于来源等级:阿里 AL128 的互连架构细节(单级交换、SerDes 分配、拓扑)来自阿里云英文博客(alibabacloud.com/blog/602665)。该页面属于社区投稿(Community)栏目,严格说不是产品规格文档,但它是四家里唯一一份公开到该颗粒度的 scale-up 架构说明。引用时建议注明这一点。
4.7 内存墙的解法:CXL 内存池
阿里的方案是 CXL 3.1 内存池化 + 冷热分级:延迟数百 ns(接近访问本地 DDR)、容量 10 TB 级。在 KV cache 命中的场景下,相比基于 RDMA 的 KV cache 内存池(MoonCake),官方自测 TTFT 降低 82.7%、吞吐提升 4.79 倍。
数字是自测口径,但方向值得注意:当 HBM 装不下 KV cache 时,"把 KV 沉到近内存层"比"通过网络搬运 KV"要有效得多。华为在 CM384 里用 EMS 内存池解决的是同一个问题(见第 5 章)——四家里有两家给出了同一诊断、不同药方。
4.8 裂缝:一年后,阿里推翻了自己的结论
这是全文最有价值的发现之一。
阿里云在 2025 年 11 月的官方技术长文里写下了"两级交换拓扑会增加延迟,因此意义不大",并预判光互连的引入条件是:ScaleUp 域达到 256 卡、SerDes 速率到 448 Gbit/s、且光互连端到端成本与铜缆可比。
然而在 2026 年 9 月的云栖大会上,阿里发布的 AL144 做了完全相反的事:用二级 SNPO 光互连 + ALink Switch,把 ScaleUp 域从 144 卡扩展到 288 / 1024 / 10368 卡。
从"两级交换意义不大"到"二级光互连扩至万卡",中间只隔了 10 个月。
这个反转值得追问:什么变了?
三个可能的解释:
1. 负载压力超预期。MoE 万亿参数模型的 Expert Parallel、长上下文的 KV cache、Agentic 多智能体的内存语义互访——这三类负载对域规模的诉求,可能在 2025 年底之后显著上升了。阿里在 AL144 的发布材料里明确把这三类负载列为驱动力。 2. 单级交换的端口预算到顶了。AL128 的 ALink Switch 只有 64/128 端口两档,128 端口是跨两个 AL64 域做单级交换的上限。再往上扩,单级交换在工程上不可行。 3. 光互连改变了成本曲线。阿里原本预判要等 SerDes 到 448G、光成本与铜可比才上光,但 SNPO(近封装光互连)的成熟可能把这个时间点提前了。
无论哪个解释成立,这个反转本身就是本文核心论点最有力的证据:
当"域边界"成为软件性能的决定因素时,工程上"最经济"的解会被负载需求强行推翻。阿里 AL128 是单级交换路线最完整、论证最充分的实现,但它只维持了一年。
本章结论
磐久 AL128 是**"单级交换 + 私有协议 + 极致低延迟"路线最完整的教科书**:官方文档级别地公开了 SerDes 分配、交换节点布局、FRU 粒度、甚至对竞争路线的批评。
它的价值在于提供了一个可以对照的极值点:如果单级交换是答案,AL128 就是这个答案的最优解——64–72 卡域、非阻塞全网状、14–28 Tbit/s 单卡带宽、分钟级维护。
但这条路线在一年内被阿里自己的下一代推翻了。而推翻它的理由,恰恰是第 1 章里那个判断的另一面:单级交换撑不起超节点。
第 5 章 华为 Atlas 950:跳过"单柜做密",直接做超节点
5.1 定位:四家里唯一"scale-up 域 = 超节点"的路线
前三家的路径都是一样的:先把单个机柜做到极致(NVL72 / Helios / AL128 都是 64–144 卡的单柜域),等单柜做不下去了,再往两级交换、往多机柜扩。
华为走的不是这条路。
从第一代 CloudMatrix384 开始,华为的 scale-up 域就是跨机柜的:384 张昇腾 NPU + 192 颗鲲鹏 CPU,分布在 16 个机柜里(12 个计算柜 + 4 个通信柜),在软件看来是一个可以互相 P2P 访问的统一域。
到 Atlas 950 SuperPoD,这个思路被推到 8,192 张 NPU / 160 个机柜。
所以本文的第 1 章那个判断在华为身上表现得最彻底:华为从来没有"机柜级 scale-up 域"这个概念,它的域从一开始就是超节点级的。这就是为什么在四家对比表里,华为的"机柜级"那一栏是空的。
代价也是明确的:
• 华为官方从未公布 910B / 910C 的 TFLOPS 与 HBM 规格,950 系列的公开程度也不如 NVIDIA / AMD • 更关键的是能效:第三方分析(SemiAnalysis)对 CM384 与 GB200 NVL72 的对比显示,CM384 的系统算力约为 GB200 的 2 倍、内存容量 3.6 倍、内存带宽 2.1 倍,但功耗是 4.1 倍——每 FLOP 的功耗差约 2.5 倍
这是一种典型的"用规模和互连换单芯片差距"的策略,而它的物理代价就是功耗。
本章的证据来源需要先交代清楚:华为的公开程度在两代之间差别很大。Atlas 950有官方彩页、NPU 架构白皮书与 MWC 发布稿,硬件规格(域规模、功耗、芯片精度表、互联带宽)相对完整;但互连拓扑与软件栈的内部结构,公开到论文级别的只有 CM384 一代(arXiv 2506.12708)。
所以本章的读法是:凡涉及"域有多大、功耗多少、芯片多强",用的是 Atlas 950 的一手材料;凡涉及"内部怎么组织"(拓扑层级、平面划分、内存池),除非另有说明,证据来自 CM384。两代之间哪些延续、哪些变化,会在相应小节单独标注。
5.2 域能做多大:超节点级(8,192 NPU)
以下数据来自华为官方《昇腾 AI 基础硬件彩页》(2026 H2 版),这是本文找到的唯一一份官方规格表级别的华为超节点材料。
Atlas 950 SuperPoD(1024-NPU 单元口径)
| 1024 × 昇腾 950DT | |
| 256 × 鲲鹏 950 | |
| AI 算力 | 2 EFLOPS @ mxFP4 0.5 EFLOPS @ FP16 / BF16 |
| NPU 互联带宽 | 1024 × 1.68 TB/s |
整集群规模:华为 MWC Barcelona 2026 官方新闻稿明确:"Atlas 950 SuperPoD 由 UnifiedBus 提供互连,每机柜集成 64 颗 NPU,可扩展至 8,192 颗 NPU。"即 8,192 = 128 个计算柜 × 64 NPU;按 1024-NPU 单元线性外推得 8 EFLOPS FP8 / 16 EFLOPS mxFP4,与发布会口径一致。
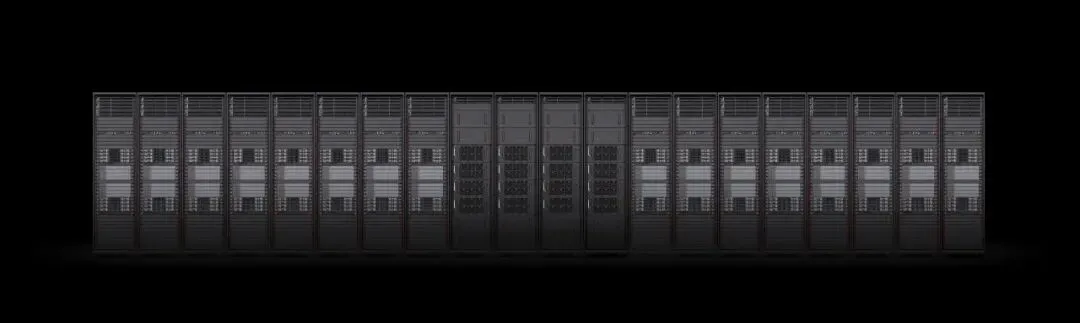
图 11:Atlas 950 SuperPoD 的机柜列。注意中间 4 个外形不同的机柜——那是独立的交换/通信机柜,与计算柜分开部署。(图片来源:华为《昇腾 AI 基础硬件彩页》2026 H2)
5.3 域能做多大:单柜级(64 NPU)
| 44OU | ||
| 64 × 昇腾 950DT | ||
| 16 × 鲲鹏 950 | ||
| AI 算力 | 128.4 PFLOPS @ mxFP4 35.0 PFLOPS @ FP16/BF16 (另有 114.1 / 58.8 / 31.1 一组口径)⚠️ | |
| NPU 互联带宽 | 64 × 1.68 TB/s | |
| 功耗 | 100 kW | |
| 拓扑 | Full Mesh / CLOS |
这张表里有两个数字非常值得注意。
第一,单卡互联带宽 1.68 TB/s,约为 NVIDIA 的一半。NVL72 单 GPU 是 3.0–3.6 TB/s(官方两个口径),Helios 是 3.6 TB/s,而 Atlas 950 的 NPU 是 1.68 TB/s。这意味着华为的 scale-up 域规模优势,部分是用单卡链路带宽减半换来的——它靠更多节点、更多光链路来补单链路差距。
第二,单柜功耗 100 kW,是四家里最低的。这与"华为功耗高"的印象相反。原因是这个 100 kW 只对应 64 颗 NPU + 16 颗 CPU;AL128 的 350 kW 对应 128–144 张卡,NVL72 的 228 kW 对应 72 张卡 + 36 颗 CPU。
换成"每 kW 能带来多少算力"再比一次(不同精度口径不可直接比,只做量级参考):Atlas 950 单柜约 1.28 PFLOPS/kW(128.4 PFLOPS mxFP4 / 100 kW);NVL72 约 15.8 PFLOPS/kW(3,600 PFLOPS NVFP4 sparse / 228 kW)。
⚠️ 这个对比不能直接下结论:NVIDIA 的口径是 sparse,华为的是 mxFP4,两者不可比。但它至少说明——华为在单机柜密度上并不占优,它的优势在"域能做到多大"。
5.4 靠什么实现:柜内电背板 Clos + 柜间全光
这是华为与前三家分歧最大的地方,需要分两代来讲,因为华为两代的拓扑哲学是相反的。
5.4.1 CloudMatrix384:L1 + L2 两级交换
CM384 的拓扑在论文(arXiv 2506.12708)里写得很清楚:
L1(板级):每个节点 12 个处理器(8 颗 NPU + 4 颗鲲鹏 CPU)通过 UB 链路连接到板载交换芯片,在节点内形成单级 UB 平面。每个 NPU 配置最多 392 GB/s 单向 UB 带宽。
L2(机架级):每个板载 UB 交换芯片再连接到超节点 fabric 的下一级。这些通信机柜承载第二级(L2)UB 交换机。L2 被划分为 7 个独立子平面,每个子平面 16 颗芯片 × 48 端口;7 颗 L1 与 7 个子平面一对一映射,每颗 L1 用 16 条链路扇出到本子平面内的全部 16 颗 L2。
关键特性:L2 无带宽收敛(non-blocking)。论文明确写"网络被设计为非阻塞的,L2 交换层没有带宽超订"。
铜光分界:NPU 到同板 L1 是板内铜互连;L1 的输出侧才转成光链路,跨机柜到 L2。
规模:384 卡 = 48 节点 × 8 NPU;16 个机柜 = 12 个计算柜(每柜 32 NPU)+ 4 个通信柜。
这是一个教科书式的两级 Clos。而且它比 NVIDIA NVL576 早了一年多。
5.4.2 Atlas 950:论文拓扑 vs 产品拓扑
Atlas 950 的拓扑需要分两个层面来讲,因为华为官方彩页、UB-Mesh 论文和第三方现场拆解给出的图景并不完全一致。
层面一:UB-Mesh 论文里的拓扑(arXiv 2503.20377)
论文提出的是 nD-FullMesh 递归直连拓扑:板级 1D 全连接 → 机架内 2D FullMesh(8 板 × 8 NPU = 64 卡)→ 跨机架 4D,UB-Mesh-Pod = 4D-FullMesh,16 机架 / 1024 NPU;Pod 之上改用对称 Clos(高 radix 的 HRS Pod 交换机,UB x512),可扩至 8K NPU。
⚠️ 一个与 CM384 相反、且很容易写错的关键差异:UB-Mesh 是逐层收敛的。
论文原文写 nD-FullMesh "可提供 tier-over-tier oversubscribed 带宽"(逐层收敛),并明确拿它与 "a non-oversubscribed Clos network"(非收敛 Clos 网络)做对比——代价是"性能损失控制在 7% 以内",收益是高基数交换机用量减少 98%、光模块减少 93%。
所以华为这两代的收敛策略是相反的:
• CM384(UB 1.0,已量产):明确非阻塞——"L2 交换层没有带宽超订",节点到 L2 的聚合上行带宽与节点内 UB 容量精确匹配 • UB-Mesh / Atlas 950(UB 2.0):明确逐层收敛,用 7% 以内的性能让步换取 98% 的交换机削减 这本身就是"收敛比是设计参数、不是定义判据"最好的例证——同一家公司的同一个 scale-up 域,两代之间可以自由选择收敛或不收敛。这两代的收敛特性不能混为一谈。
论文给出的对比数据很有冲击力:相对传统 Clos,高基数交换机减少 98%、光模块减少 93%,网络基础设施成本占比从 67% 降到 20%,成本效率 2.04×,可用性提升 7.2%。
⚠️ 但论文明确是"研究/PoC 拓扑",华为官方 950 白皮书把它作为可选项引用("为超节点提供 UB-Mesh 以及基于光交换的组网技术")。
层面二:产品上的实际拓扑(第三方现场拆解)
LightCounting 在 2026 年 7 月给出的现场拆解是:
| 刀片内 | ||
| 单柜内 | 正交电背板做 Clos | 否(无光模块) |
| 系统级 | 是 |
这个拆解与官方彩页的"Full Mesh / CLOS"表述可以对齐:柜内 CLOS + 系统级 CLOS。但它与 UB-Mesh 论文的"柜内 2D FullMesh"不同——说明产品实际没有采用论文里的递归直连方案。
所以准确的描述是:Atlas 950 的柜内是电背板 Clos(免光模块),柜间是全光 Clos;而 UB-Mesh 的 nD-FullMesh 是华为论文提出的研究方案,不等同于 Atlas 950 的已交付形态。
光互连的具体形态(第三方拆解 + 官方口径):
• 1024 卡配置实测 4,096 个 800G 光模块,平均每 NPU 4 个 800G OSFP(由 CM384 的"8 × 400G/NPU"演进为"2 × 800G/NPU") • 满配 8,192 卡用**"3 万多个光模块"** • 业界首个采用 LPO(线性直驱可插拔光模块)的超节点,基于华为 100G VCSEL • 跨柜全光互联 + 2+2 光路保护;链路层重传(LLR)、降 Lane 不断业务 • 官方称 8,192 卡范围内光互连 MTBF > 6,000 小时,线性度 > 90%
跨柜时延:官方口径 RTT 2.1 μs,现场口径约 3 μs。
5.4.3 UB 2.0 的带宽口径
这里有一组必须分清的数字,否则很容易被"16 PB/s"这类宣传数字带偏:
| 芯片级峰值 | 2016 GB/s 双向 | |
| 产品级 | 1.68 TB/s / 卡双向 | |
| 1024 卡聚合 | 1.72 PB/s 双向 | |
| 8192 卡宣传值 | 16 PB/s |
⚠️ "16 PB/s"的本质是"单卡芯片级带宽 × 卡数"的聚合理论值,双向,既不是 bisection 带宽,也不等于交换机侧容量。如果按产品级 1.68 TB/s 计算,8,192 卡应该是 13.76 PB/s。
这是本文第 8 章"如何读懂厂商数字"的又一个案例:聚合带宽的分母与口径必须追问。
5.4.4 与 CM384 的拓扑差异
| 交换式全对全 | 柜内电背板 Clos + 柜间全光 Clos | |
| 1.68 TB/s 双向 | ||
| 256 TB | ||
| UB 1.0 | UB 2.0 |
两代之间,单卡 UB 带宽提升约 8.6 倍——这是 Atlas 950 性能宣称的主要来源之一。
5.4.5 两代拓扑的区别:一个高频事实错误
⚠️ 把 UB-Mesh 的"递归直连、省光、免交换"特征安到已量产的 CM384 头上,是本领域最高频的事实错误。
CM384 是交换式全对全(L1 板载交换 + L2 机架级交换);UB-Mesh / Atlas 950 才是递归直连(板内/跨板/机架间 full-mesh + Pod 间 Clos)。已有学术论文(arXiv:2603.03731)因为混淆这两者被点名批评。
两者都是华为的,但拓扑哲学相反——这是本领域最高频的事实错误之一,必须严格分开。
5.4.6 交换柜:柜间全光的硬件形态
Atlas 950 的官方彩页里有一份独立的交换机柜规格,这是四家里唯一把"交换柜"作为独立产品列出的:
| 4 × 512 × 800 Gbps | |
| 21 kW | |
这个配置说明了一件事:Atlas 950 的柜间 scale-up 是全光的,单柜最多 512 个 800G 光端口。128 个计算柜之间的 scale-up 互连,就是靠这些交换柜完成的。
这也解释了为什么华为要实现 8,192 NPU 的单域——它需要大量的光端口,而光端口是独立成柜的。
5.5 芯片级规格
昇腾 950DT(A 级,官方《昇腾 950 NPU 架构白皮书》)
这是一份难得的官方芯片级文档——华为首次较完整地公布了芯片精度峰值表:
官方白皮书给出的核心规格(按不同 bin 分档):950DT 的 Cube-only 峰值算力为 1946 / 1730 / 1513 TFLOPS(MXFP4)与 973 / 865 / 756 TFLOPS(FP8 族);片上内存 144 / 96 GB @ 4 TB/s;UB 带宽 2016 GB/s 双向(18 Port × 112 Gbps);UBoE / PCIe 复用 2 端口,PCIe 5.0 x16。950PR 的对应档位低一档,片上内存 128 / 112 GB。
三档数字是同一颗芯片的不同 bin。
🔑 这份白皮书解开了一个关键口径问题——8 EFLOPS 到底是怎么来的:
• 8192 × 973 TFLOPS(950DT 最高 bin 的 Cube-only FP8 峰值)= 7.97 ≈ 8 EFLOPS • 8192 × 1946 TFLOPS(Cube-only MXFP4 峰值)= 15.94 ≈ 16 EFLOPS • 1024 卡口径同样吻合:1024 × 973 = 0.996 ≈ 1 EFLOPS;1024 × 1946 = 1.99 ≈ 2 EFLOPS
所以"8 EFLOPS FP8 / 16 EFLOPS FP4"的本质是"单芯片精度峰值 × 卡数"的累加,属于 dense 峰值口径,既不是稀疏值,也不是实测值。而华为官方从未使用 dense/sparse 字样——彩页脚注只写"理论算力值,实测可能存在 1% 误差"。
所以它的准确表述是"厂商公布的芯片峰值累加口径",而不是"8 EFLOPS FP8(dense)"。
⚠️ 三个"未公布":制程节点、die size、晶体管数、单芯片 TDP —— 华为从未公布。HBM 供应商与代数同样未公布(只写"高速片上内存")。
⚠️ 一个命名提醒:HiBL 1.0 / HiZQ 2.0 这两个名字只出现在发布会 keynote 与媒体报道里(HiZQ 2.0 = 144 GB / 4 TB/s),官方白皮书与产品彩页都没有使用,只写"高速片上内存"。引用时应标注来源是发布会口径。
昇腾 950PR(A 级):128 / 112 GB 片上内存,1.6 / 1.4 TB/s;对应板卡 Atlas 350 为 112 GB / 1.4 TB/s / ≤600 W,官方称单卡算力为 NVIDIA H20 的 2.87 倍。
鲲鹏 950(A 级,官方服务器彩页):96 核(另有 64 核型号),2.3 GHz 基准 + Turbo,SMT2 物理双线程;96C/192T 与 192C/384T 两个型号,2026 Q1 发布;2U2P 最多 24 个 DDR5 插槽(RDIMM ≤7200 MT/s / MRDIMM ≤8800 MT/s),最大 3 TB。
Atlas 850E(A 级,官方彩页):14U 风冷形态,8 × 950DT + 2 CPU,14.27 PFLOPS mxFP4,8 × 96 GB HBM @ 4 TB/s,NPU 互联 8 × 1.68 TB/s(UBoE),3.0 kW,支持从 8 卡平滑扩展到 1,024 NPU。
它说明华为并不是只会做"大而全"——同时提供了一条从 8 卡风冷起步、扩展到千卡的路径。这对客户的实际部署很重要。
一个曾经看起来很矛盾、现在解开了的数字:950DT 的片上内存有两个版本。
华为官方《昇腾 950 NPU 架构白皮书》给出的 950DT 片上内存规格是 "144 / 96 GB,4 TB/s"——这是同一颗芯片的两个 SKU。
• Atlas 950 超节点用的是 96 GB 版本(产品彩页明确写 64 × 96 GB)。按此计算,8,192 卡的总片上内存是 786 TB。 • 而发布会口径的"总内存 1,152 TB"反推是 144 GB × 8,192(= 1,179,648 GB ≈ 1,152 TiB)。 两个数字都能成立,但指向不同的产品配置。准确的写法是两个口径都给出:"官方公布满配内存 1,152 TB(2025 年规划口径),而 2026 年产品彩页的配置为 96 GB/卡"。
另外,白皮书里 950DT 的精度峰值表是按 Cube 算力 / Vector 算力 / Cube+Vector 总算力三栏分别列的,没有 dense/sparse 标注,也没有绑定峰值时钟与功耗。这一点在第 8 章会再次用到。
5.6 软件视角:CM384 的三平面与内存池
CM384 的论文给出了一个比硬件拓扑更有价值的软件架构视角——三张平面:
| UB plane | |
| RDMA plane | |
| VPC plane |
把 RDMA 平面专门留给"Prefill→Decode 的 KV 交接",是一个很聪明的设计:KV 流量平均占用不高,但突发时是大块传输,如果和 EP 的 all-to-all 挤在同一条链路上,会直接推高 decode 的 P99 延迟。用独立平面隔离,比在同一张网上做 QoS 更有效。
EMS(Elastic Memory Service)内存池:由 32 个鲲鹏节点(20 个 decode + 12 个 prefill)的 DRAM 构成,把 CPU 挂载的 DRAM 组织成可被全部 NPU 访问的分布式内存池——KV cache、模型权重块、checkpoint 都可以放进去。
实测效果(论文自测):90% token 复用率下,TTFT 降低 1,505 ms(59%);吞吐提升 2.28×;UB 路径比 VPC 路径高 1.52×。
这与阿里 AL128 用 CXL 内存池解决的是同一个问题(见 4.7 节),但技术路径不同:阿里用 CXL 3.1 做近内存层,华为用 UB 把自己的 DRAM 池化。
这套架构适用于 Atlas 950 吗?
必须分清:上面这些证据全部来自 CM384(Atlas 900 A3)的论文,不能直接外推到 Atlas 950。
| UB 平面 | ||
| RDMA 平面 | ||
| VPC 平面 | ||
| EMS 内存池 |
能确认的是"设计思想"的延续,不能确认的是"实现结构"的照搬。
按流量语义拆分平面这件事——把突发大块的 KV 交接与高频细碎的 EP all-to-all 隔离开——在 Atlas 950 上大概率仍然成立,因为它要解决的问题(decode 阶段的 P99 尾延迟)在两代之间没有变。但"是否还是三张平面、VPC 是否仍由 Qingtian DPU 承载",公开材料不足以回答。
这也是本章整体的证据分布特征:硬件规格(域规模、功耗、芯片参数)有 Atlas 950 的官方彩页与白皮书支撑;而互连与软件的内部结构,公开到论文级别的只有 CM384 一代。Atlas 950 的白皮书与彩页给的是结果(8,192 卡、1.72 PB/s、256 TB 统一编址),不是结构。
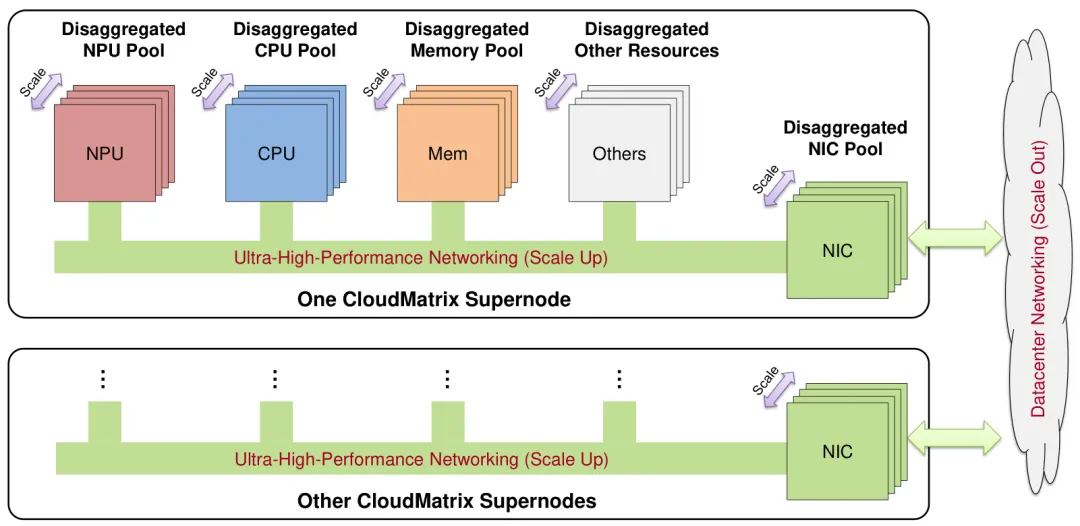
图 12:CloudMatrix 的架构愿景。NPU、CPU、内存、NIC 被解耦成独立资源池,通过超高性能网络(Scale Up)连接成一个超节点;超节点之间再通过数据中心网络(Scale Out)互联。(图片来源:Huawei, Serving Large Language Models on Huawei CloudMatrix384, arXiv 2506.12708, Figure 1)
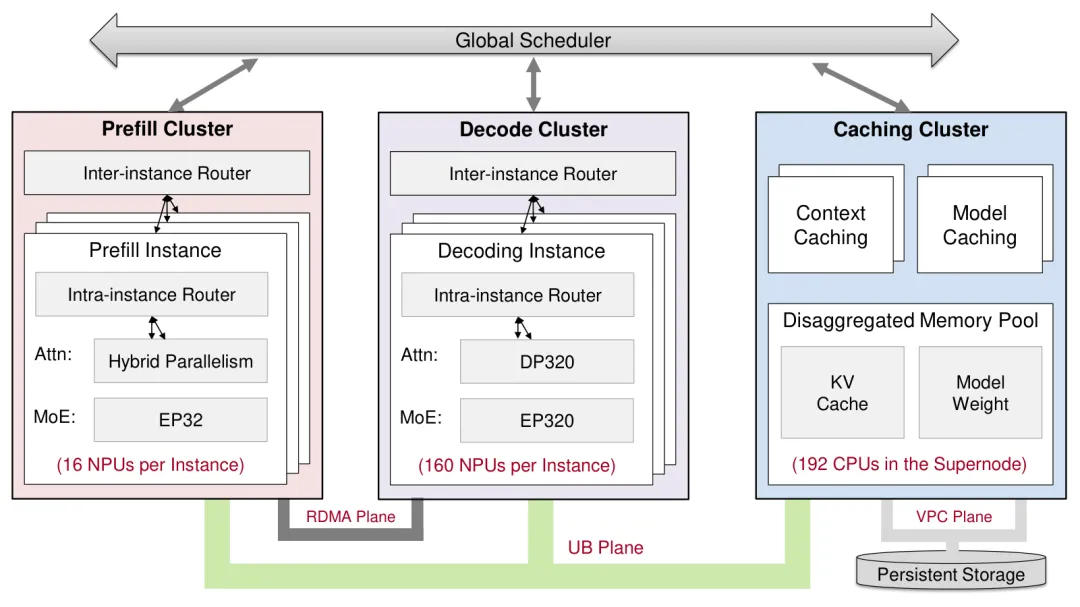
图 13:CloudMatrix384 的服务架构。(图片来源:同论文)
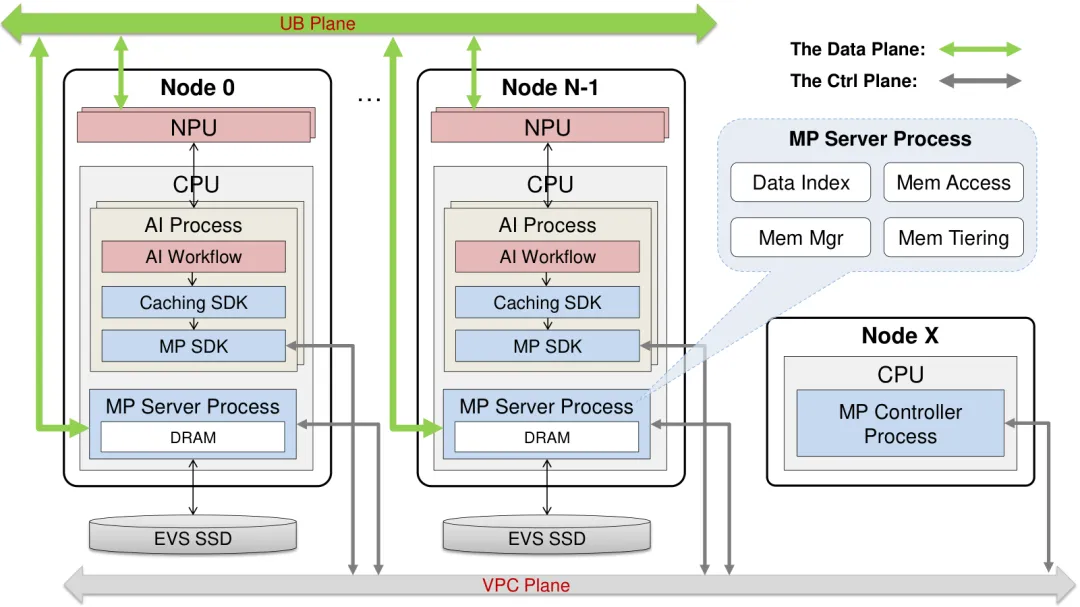
图 14:CloudMatrix 的内存池部署形态。(图片来源:同论文)
5.7 软件与生态
华为在开放策略上的动作比外界印象中更积极:CANN 已分层开源(算子库、加速库、图引擎、编程语言);支持 PyTorch、vLLM、SGLang、Triton 等主流开源项目;UB 2.0 规范以 BSD-2-Clause 开源;贡献 openEuler 社区(2025 年 12 月底发布首个面向超节点的 OS 版本)。
但要注意一个关键区别:CANN 开源的是框架层,不是指令集或互连协议层。UB 2.0 规范开源了,但硬件实现(交换芯片、SerDes)仍是自研。
这与 AMD 的"开放"路线有一个根本差异:AMD 的 UALoE 用的是买来的 Broadcom 交换芯片,理论上任何厂商都能采购同样的硅;华为的 UB 交换芯片是自研的,规范开源但硅不外卖。
⚠️ 一个容易被忽略的事实:UB 2.0 规范在 GitHub 上开源(BSD-2-Clause),内容包括基础规范、固件规范、使能 OS 参考设计、管理运维架构、SuperPoD 架构白皮书等十余份文档。但截至本文写作时,该仓库的星标数为个位数。
"规范开源"与"形成生态"是两件事。UALink 的背后是 AMD、Broadcom、Google、Intel、Meta、Microsoft 等一批公司;UB 的开源仓库目前基本只有华为自己在维护。这个差距不会写在规格表里,但它决定了三五年后谁能拿到多供应商的互连芯片。
另一条与"开放"相关的差异:华为的 UB 2.0 规范、白皮书与 keynote 全文均未提及 UALink 或 OCP SUE。华为走的是自研协议路线(通过 UBoE 复用以太网交换机),并称要"推动产业界形成 NPO 标准"。
对比一下四家的协议站位:
| 华为 | UB / 灵衢 |
四家里只有华为完全没有对齐任何第三方 scale-up 标准。这是一个客观事实,不涉及优劣判断——但它对采购方的锁定风险是实质性的。
5.8 裂缝
第一,910B / 910C 的规格从未公布。华为官方从未给出这两代芯片的 TFLOPS 与 HBM 数字。CM384 的总功耗也没有官方数字——那 4.1× 的功耗对比来自第三方分析,不是华为口径。
第二,950DT 的 HBM 容量存在官方与发布会两个口径(96 GB vs 反推的 144 GiB),见 5.5 节的警示。
第二,Atlas 950 是 2026 Q4 的规划产品。目前能交付的华为超节点是 CM384(384 NPU,16 机柜),已量产超过 300 套、20 多家客户。
第三,也是最值得注意的一点:华为的发布会从未直接对比 GB200 NVL72。
HC2025 keynote 里用来对标的对象是 NVIDIA "NVL144"(华为称其 2026 下半年上市)与 "NVL576"(2027 上市)。华为给出的对比是:Atlas 950 相对 NVL144"NPU 数 56.8×、算力 6.7×、内存 15×、互联带宽 62×"。
问题在于:
• NVL144 当时尚未上市,后来还被 NVIDIA 更名为 NVL72(见第 1 章口径问题一); • 华为从未在任何官方材料中对比 GB200 NVL72,也未对比 Vera Rubin NVL72。所有"NVL72 vs 华为"的对比都来自媒体。
拿自己已量产的 8192 卡集群,去对比对手一款"还没发货、且后来改了名字"的单机柜产品,这个 62× 的带宽倍数就很容易理解了——分母是 0.26 PB/s(单机柜口径),分子是 16 PB/s(160 机柜口径)。两者根本不是同一个层级的东西。
这正是本文第 1 章强调"机柜级 / 超节点级必须分开比"的现实理由。引用华为的对比数据时,这一点需要特别标注。
第四,800V 供电在 Atlas 950 上没有官方依据。Atlas 950 的规格里只有三相 380V AC与 HVDC 336V / 240V DC。800V 只出现在券商对华为 AIDC"3+1"战略(UPS → UPS+SideCar → 800V HVDC → 800V SST)的解读中,与 Atlas 950 没有官方绑定关系。
第五,CUDA 到 CANN 的迁移成本,没有任何量化的公开数据。这是所有国产算力路线的共同问题,但对读者来说,它往往比峰值算力更能决定实际可用性。
一个第三方实测评述值得单独引用:SemiAnalysis 的 InferenceX 在 2026 年 6 月指出,DeepSeek V4 的 Day-0 在 Ascend 950DT上"能跑且经过优化",是当年仅有的两个 Day-0 可用栈之一(CANN 与 CUDA)——这比峰值算力更能说明软件成熟度。
但同一篇文章也明确表示,H200 / B200 与昇腾的 apples-to-apples 同口径对比"将在后续文章中发布"。换句话说:截至本文写作时,华为与 NVIDIA 之间不存在任何第三方同口径实测对比。双方的所有倍数宣称都应视为厂商口径。
本章结论
华为是四家里路线最不一样、也最容易被误解的一家。
它的核心选择是:不在单机柜密度上竞争,直接把 scale-up 域做成跨机柜的超节点。
这个选择带来了三个可验证的结果:
1. 域规模的领先是真实的:CM384 的 384 卡单域在 2025 年就已量产,Atlas 950 把同一路线推到 8,192 NPU(2026 Q4)。而对手的对应产品——NVIDIA NVL576(576 卡)要等 2027、阿里 AL144(10,368 卡)要等 2028。 2. 单卡链路带宽的劣势也是真实的:Atlas 950 的 1.68 TB/s vs NVIDIA 的 3.0–3.6 TB/s,约为一半。华为靠节点数量与光端口数量来补。 3. 功耗代价是真实的:CM384 相对 GB200 NVL72 约 4.1× 的系统功耗(第三方分析口径),这是"用规模换单芯片差距"的物理账单。 4. 但证据分布是不均匀的:硬件规格两代都公开得比较完整,互连与软件的内部结构只有 CM384 有论文级材料(见 5.6 节末的对照表)——这一点在评估华为方案时需要计入。
用一句话概括华为的路线:它是最早相信"超节点的价值在于域,而不在于柜"的厂商,并且为此付出了功耗与单卡性能的代价。
下篇预告
上篇分别讲完了四家各自的机柜级与超节点级方案。下篇做三件上篇没做的事:
1. 横向对比——把四家放进同一批表格,按单柜与多柜两个层级逐维度对齐; 2. 下一代展望——四家在 2027–2028 的域规模、光互连与供电路线; 3. 如何读懂厂商数字——十类口径陷阱,包括同一家公司两个官方页面差 20%、四个查无来源的数字、两个被混淆的正交设计轴,以及一次因抓取截断导致的误判。
如果你只想知道「哪家更强」,下篇的对比表与方法论比上篇的规格罗列更有用。
附录:参考来源(按证据等级)
A 级|厂商官方规格 / OEM 数据表 / 论文
• NVIDIA Vera Rubin NVL72 官方产品页与规格表;NVIDIA NVLink 官方产品页("non-blocking compute fabric") • NVIDIA DGX SuperPOD with DGX GB200 / H100 参考架构(SU 内非阻塞、存储以太网 5:3 / 约 4:3) • Pegatron RA4803-72N3 OEM 数据表(VR NVL72 整机柜功耗与尺寸) • NVIDIA Rubin GPU 架构官方博客 • AMD Instinct MI455X 官方产品页与 datasheet;AMD Helios 官方页与 blueprint PDF;AMD EPYC 9006 产品页 • 阿里云磐久 AL128 互连架构技术长文(alibabacloud.com/blog/602665,社区投稿栏目) • Alibaba HPN: A Data Center Network for Large Language Model Training(ACM SIGCOMM 2024)— Tier-1 1.067:1 / Aggregation-Core 15:1 / 前端 1:1 • 华为《昇腾 950 NPU 架构白皮书》;Atlas 950 SuperPoD 液冷超节点彩页 V2.1;互联网大模型推理彩页 26H2;鲲鹏 950 服务器彩页 • Serving Large Language Models on Huawei CloudMatrix384(arXiv 2506.12708) • UB-Mesh: a Hierarchically Localized nD-FullMesh Datacenter Network Architecture(arXiv 2503.20377)
B 级|厂商官方博客 / 新闻稿 / 发布会
• NVIDIA Vera Rubin POD: Seven Chips, Five Rack-Scale Systems(开发者博客) • NVIDIA 800 V HVDC 架构博客;NVIDIA NVLink scale-up 网络博客 • NVIDIA Rubin 平台 CES 2026 新闻稿 • AMD Helios blueprint 与 OCP 设计博客;AMD AI Networking 博客 • 阿里云 2026 云栖大会全栈 AI 路线图;2026-05 全栈 AI 升级公告 • 华为 HC2025 keynote;MWC 2026 Atlas 950 发布稿;HC2026 Peerium 发布稿
C 级|联盟规范与行业标准
• OCP《Open Cluster Designs Aligned AI Training Fabric》参考架构(2026-04) • OCP Open Rack Wide(ORW)Base Spec v1.0.1;OCP Scale Up Ethernet(SUE)v1.0.0 • UALink 1.0 规范与 2026 白皮书 • Ultra Ethernet Consortium 1.0 • JEDEC HBM4(JESD270-4) • UB 2.0 规范(BSD-2-Clause,GitHub codehubcloud/UnifiedBus)
D 级|第三方分析与媒体
• ServeTheHome:AMD Helios 架构深度拆解 • LightCounting:Atlas 950 SuperPoD 现场拆解(2026-07) • SemiAnalysis:CM384 分析、Kyber 延期报告、InferenceX 实测 • CNBC / DigitalToday:Kyber 延期报道 • SDxCentral:阿里云 HPN 8.0、AMD Helios • StorageReview:MI455X 与 Helios 完整规格 • OCP《Vision OpenSIP for AI Systems》(含四家横向对比表)
本文所有规格数据截至 2026 年 10 月。文中标注"未公布"的项,均为厂商从未公开披露,而非本文未能查到。标注 ⚠️ 的数字存在来源冲突或口径存疑,已在正文中说明。