ARTICLE · 1137254
OpenAI 动用上万个智能体,开始用代码证明百年数学定理
提到大模型做数学,很多人的第一反应可能还是聊天框里那些让人哭笑不得的翻车现场:稍微拐个弯的逻辑题它开始胡言乱语,算个多位数乘除法还会偶尔漏掉进位。
这种“文科脑偏科”的印象,在过去两年里几乎成了大众对 AI 的共识。甚至不少人得出一个结论:大模型的本质就是基于概率的下一个词预测,它根本不可能具备真正的严格逻辑推理能力。
但在昨天,OpenAI 官方悄悄披露的一份研究手稿和 GitHub 仓库,把这个话题推到了一个完全不同的严肃讨论场。
OpenAI 宣布,他们正在使用内部前沿模型,尝试攻克困扰数学与物理学界近百年的千禧年大奖难题之一——纳维-斯托克斯方程(Navier–Stokes equations)的光滑解与奇点问题。更重要的是,他们这次没有停留在写几篇文字论文自圆其说,而是直接把证明过程翻译成了计算机可以严格检验的 Lean 形式化代码。
这项实验背后,不仅包含了上万个并发 Agent 的协同分工、数百亿 Token 的算力吞吐,甚至还牵扯出一段与老对手 Anthropic 隔空“撞车抢跑”的技术内幕。
为什么这次不是写“小作文”,而是写 Lean 代码?
在数学和前沿科学界,AI 最大的信任危机从来不是“它不会做”,而是“它太会瞎编了”。
大模型生成的论文往往极具迷惑性:推导格式工整,术语用得天花乱坠,甚至引用文献都格式齐备,但中间可能悄悄跳过了一个关键引理,或者暗中依赖了一个不成立的前提假设。人类审稿人如果顺着它的思路看,很容易被这种“看似天衣无缝”的语感带偏。
为了彻底堵死“AI 幻觉”的漏洞,OpenAI 这一次选择的交付物是 Lean。
对编程稍有了解的人,可以把 Lean 理解成一套专门用来给数学定理做“代码编译”的极客语言。在 Lean 的世界里,没有任何修辞和模棱两可:
你提出一个结论,必须给出每一个原子级的逻辑步骤; 每一个推导必须能对应到已被严格证明过的公理或定理库中; 只要漏掉一种边界情况,或者逻辑链路存在断层,Lean 的编译器就会直接无情报错,程序根本无法通过。
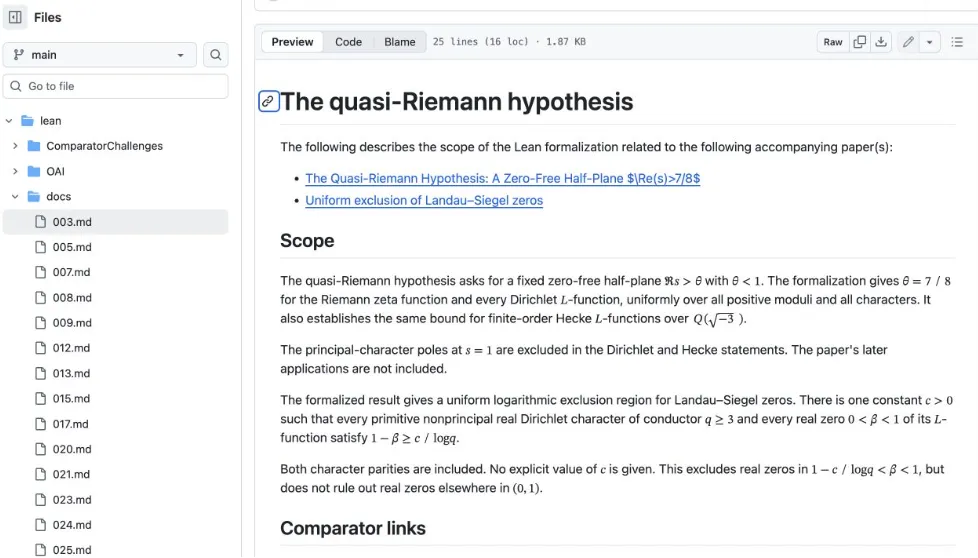
换句话说,过去评估大模型数学能力,靠的是人类专家肉眼去抓虫;而这次,OpenAI 是把证明过程扔给了一台冷酷的“机器裁判”。代码能够全部 pass,意味着推导过程在形式化逻辑层面是闭环的。
这不仅是大模型展示解题能力的秀场,更标志着 AI 参与严肃科学的范式转变:生成可以天马行空,但检验必须机器说了算。
上万个 Agent,到底是怎么在云端“集体加班”的?
根据 OpenAI 披露的实验细节,解决这种顶级难题并不是让单个大模型在对话框里冥思苦想,而是演变成了一场规模惊人的多智能体工业化协同。
整个过程大体是这样运转的:
1. 兵分多路,饱和式试错
面对复杂的方程奇点问题,研究团队将多智能体系统细分成了不同的工作小组。对于同一个数学猜想,不同小组被赋予完全相反的命题假设——有的小组负责尝试正面证明光滑性,有的小组负责专门构造反例和奇点。整个任务中,并发运行的 Agent 规模达到了上万(约 10,000)个。
2. 配备工具与“中间杂交”
这些 Agent 并不是只会聊天的纯语言模型。它们接入了受限的代码执行环境和离线检索工具,可以随时调用符号计算脚本来核验自己的临时想法。当各个小组在不同路径上摸索出一些局部成果后,系统会利用代码模型提取并汇总各个分支中最有价值的中间洞察,然后把这些结论“交叉授粉”给其他小组,引导下一轮更深层次的推导。
3. 从雏形到最终收敛
据披露,整套系统在大约 88 个小时的连续运算中,各智能体之间发送了 270 万条协同消息,消耗了约 1300 亿输出 Token。当多智能体系统最终拼接出一条完整的数学证明路径后,研究人员再调用前沿模型,耗时 17 个小时将其逐行翻译为 Lean 语言代码并完成形式化验证。
一场传言引发的实验室暗战
在这份严谨的技术手稿中,OpenAI 还罕见地坦白了这项实验的戏剧性起因:它始于一次同行之间的隔空较劲。
9 月初,OpenAI 团队在圈内听到了一则传闻:Anthropic 的研究员与纽约大学的数学学者正在合作,疑似利用内部模型取得了重大数学突破。
当时 OpenAI 内部正在训练一款性能大幅跃升的前沿模型,听到竞对可能有实质进展的风声后,团队决定不再等待,直接拉起资源,让多智能体系统对千禧年大奖难题等硬核科学问题发起集中冲击。
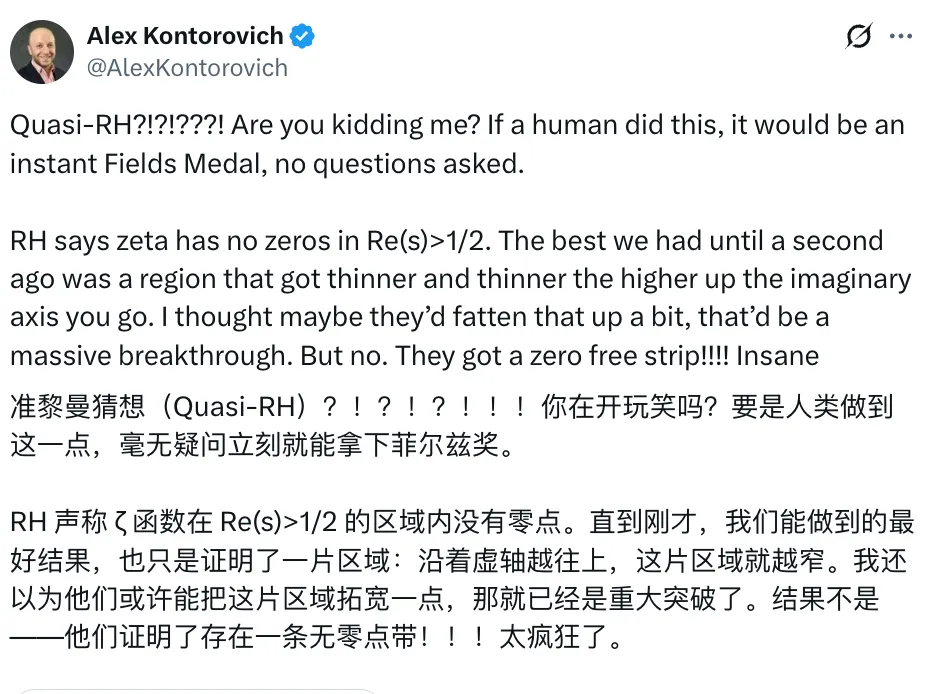
当 OpenAI 这边跑通了相关结论并完成形式化验证后,他们主动联系了对方,希望能核对进展并协商联合发布。沟通之后才发现,双方虽然都在用自家内部模型挑战前沿流体方程,但具体切入的课题变体和推导路径并不相同:对方团队证明的是带外力扰动下的欧拉方程解,而 OpenAI 的系统则在无外力条件下独立摸索出了不同路径的结论。
这场顶级实验室之间的无声角逐也反映出一个事实:各大 AI 巨头的竞争重心,早已悄然从表面上的“聊天界面有多聪明”,延伸到了最深水区的科学发现与定理证明领域。
走出滤镜:它离“颠覆科学界”还有多远?
看到这里,很多人可能会好奇:这是否意味着数学家们马上就要被 AI 取代了?
答案显然是否定的,甚至连 OpenAI 自己在报告中也保持了相当克制的态度。他们明确表示,发布这些成果旨在展示模型在严谨推理上的演进,并不打算以此去正式认领千禧年大奖的百万美元奖金。
如果撕开技术光环,看看实际账本,当下的局限依然非常清晰:
算力成本依然极其高昂:OpenAI 官方做过折算,系统平均攻克一个高难度数学小问题所消耗的推理算力,大体相当于让普通版思考模型连续高速深度思考 3 个小时。而为了解决一个大问题动用上万个 Agent、耗费上千亿 Token,在商业上还远不是普通科研机构能日常承受的常态。 大模型的角色依然偏向“超级搜索与推导器”:在这次突破中,问题的分解框架、子任务的方向引导,以及跨组洞察的筛选,底层依然离不开顶尖人类专家的顶层设计。AI 擅长在既定的数学空间里进行穷举式的概念碰撞与推导验证,但如何提出一个真正具有开创性的科学假说,依然掌握在人类手中。
不过,这项实验给整个行业带来的启示依然是决定性的。
过去,大家总担心大模型生成的答案无法用于医疗、航天、芯片设计等容错率极低的硬核工业领域,因为哪怕有 1% 的幻觉都是灾难。而这次 OpenAI 跑通的这条流水线证明了:大模型天马行空的直觉与搜索能力,如果与严格的形式化验证编译器结合,AI 就可以在完全可信、步步留痕的前提下,真正成为科学家手中啃硬骨头的重型武器。
大模型可能依然写不好人世间的微妙情绪,但它正在学着用最严谨的代码,一点点拆解物理世界的底层密码。