ARTICLE · 1138486
诺奖刷屏别只看热闹:这3个顶刊级AI预测工具,你实验室今晚就能免费跑起来
诺贝尔奖揭晓的这几天,朋友圈全被刷屏了。
从计算生物学、蛋白质结构预测到从头设计,新闻稿里全是「颠覆生命科学」「重构药物研发范式」。
很多在实验台前配试剂的师弟师妹跑来问我: 「师兄,新闻吹得这么神,但这跟我有什么关系?我们组连两张像样的显卡都没有,买商业软件还要走三个月审批。这是不是只有大算力实验室才玩得起的游戏?」
完全想偏了。
真正成熟的诺奖级技术,最大红利恰恰是把门槛砸平。
顶尖开源社区和机构早就把这些顶刊算法包装成了免费网页版:不用配环境,不用买服务器,甚至不用你写一行代码。输入氨基酸序列或者分子名,点个提交,去走廊接杯咖啡的功夫,结果就在屏幕上转动了。
上篇我们解决了 SCI 投稿语言润色与降 AI 味。这篇把目光拉回实验台:盘点 3 个真正能嵌入你日常湿实验、今晚就能免费跑起来的顶刊级 AI 预测工具。
先看一张时间账(估算,基于课题组开展定点突变与配体结合初筛的实操推算):
| 今晚就能验证,不花经费 |
读完这篇,你不用懂神经网络的反向传播。你能带走的是三个书签链接、清晰的输入格式,以及一套明天就能指导你下移液枪的预判逻辑。
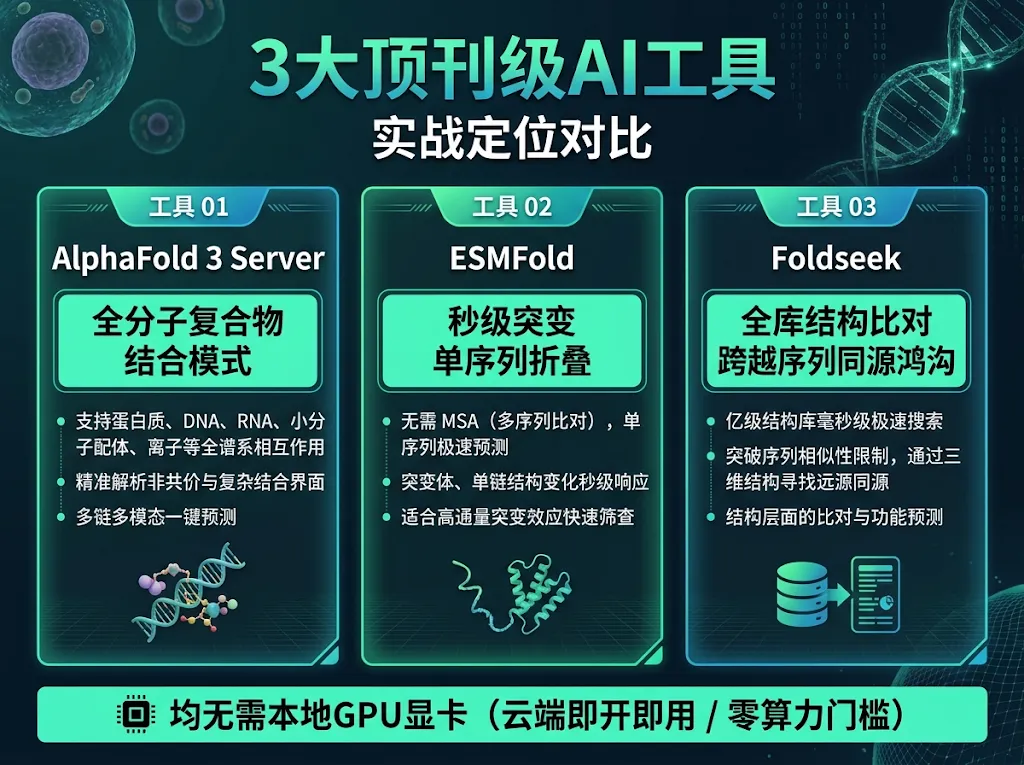
一、工具 1:AlphaFold 3 Server——连核酸与小分子一起算
两年前 AlphaFold2 出来的时候,湿实验人最常抱怨一件事:「我研究的是受体和小分子激动剂,它只给我单体蛋白,有什么用?」
今年完全变了。DeepMind 推出的 AlphaFold Server(以及开源社区跟进的 Boltz-1),把预测范围拓展到了蛋白质 + DNA/RNA + 配体小分子 + 常见翻译后修饰。
1. 实验室今晚怎么用?
打开网页,注册一个普通账号。每天有免费预测额度(通常为 10–20 次任务,对日常科研完全够用)。
你只需要提供: - 蛋白质序列(FASTA 格式复制进去) - 想要验证的配体小分子(输入小分子名称,或者 PubChem 上的 SMILES 字符串) - 如果研究转录因子,把目标启动子 DNA 双链序列粘进去
点击 Run,后台云端集群自动调度计算。
2. 看结果只盯两张图
出图后不要只看那个花花绿绿的三维卡通图。重点看两组质控指标: - pLDDT(局部置信度):从 0 到 100。大于 70 才是可靠折叠区;蓝色的区域很硬很可信,橙色和红色的区域通常是固有无序区(IDR),别在这些松散的地方强行编结合故事。 - PAE 图(预测对齐误差):深绿色的方块代表两个结构域相对位置很确定;如果蛋白和配体之间的交叉区域一片惨白,说明 AI 自己也拿不准它们到底能不能抱在一起,千万别当成阳性证据写进论文。
3. 避坑提醒
小分子柔性很大,Server 预测的是局部能量低洼点。它可以告诉你「大概率卡在哪个口袋」,但绝不能代替分子对接的亲和力实测(如 SPR 或 ITC)。拿它指导突变位点设计(比如把口袋里的色氨酸突变成丙氨酸看结合是否丢失),才是正途。
二、工具 2:ESMFold——5 秒钟出图的突变初筛神器
AlphaFold 准是准,但有一个死穴:慢。
因为它必须去几百 G 的基因组数据库里跑同源序列比对(MSA)。如果你手里有 30 个点突变株,想看哪个突变会破坏空间结构,排队能把人急疯。
Meta 开源并由开源社区维护的 ESMFold(基于大语言模型 ESM-2/3)走的是另一条路:纯靠注意力机制理解氨基酸上下文,不查同源比对,单序列直接吐出三维坐标。
1. 实验室今晚怎么用?
不用在服务器里配复杂的 PyTorch 环境。
直接打开 HuggingFace 上的 ESMFold 在线 Demo 页面,或者使用公共 Web API: 把你的突变后序列粘进去,按下 Enter。
5 秒钟。结构直接在网页窗口里渲染完毕。
2. 怎么指导定点突变?
我们在做酶工程或蛋白稳定性改造时,常犯一个错误:凭肉眼觉得某个位点空间大,随便换了个大侧链氨基酸,结果表达纯化出来全是不溶的死沉淀与包涵体,白白折腾一两周。
千万别凭直觉瞎碰。
用 ESMFold 跑突变预判: - 先跑野生型,保存 PDB 结构; - 再把突变位点序列跑一遍; - 在 PyMOL 或网页端将两个结构叠合(Align)。
如果突变导致周围原本紧密的 $\alpha$-螺旋断裂,或者破坏了深埋在内部的疏水核心,立刻停手,别花钱订引物和做转化。这 5 秒钟能帮你省下一整周无效的纯化实验。
三、工具 3:Foldseek——结构维度的超光速 BLAST
这是欧洲生物信息学研究所(EBI)团队开发的开源神器。每个做克隆和基因挖掘的实验室都该把它放在书签第一位。
做课题时常遇到这种尴尬: 从环境中筛到了一个表型明显的菌株,测序拉出一个未知蛋白。兴冲冲拿去 NCBI 跑 BLASTp,结果全部匹配项的 Identity(一致度)都低于 20%,E-value 惨不忍睹。序列比对告诉你:未命名假设蛋白(Hypothetical protein)。
线索断了?没有。
自然界中,结构的保守性远远高于氨基酸序列的保守性。两个蛋白可能序列只有 15% 相似,三维构象却几乎一模一样。
1. 实验室今晚怎么用?
第一步:用前面的 ESMFold 或 AlphaFold 预测出这个未知蛋白的三维 PDB 文件(几秒到几分钟); 第二步:打开 Foldseek 官方网页服务器(search.foldseek.com); 第三步:把 PDB 文件拖进网页,数据库勾选 PDB100 和 AlphaFold/UniProt50,点击 Search。
通常 3 到 5 秒之内,结果返回。
2. 它能给你带来什么突破?
它能瞬间从 AlphaFold 数据库的两亿多个预测结构里,捞出跟你的蛋白在三维折叠上吻合的已知结构。
很多时候你会惊讶地发现:虽然序列面目全非,但它完美的对齐了一类已报道的核酸水解酶或糖基转移酶,连催化三联体的三个关键残基在三维空间里的相对距离都完全一致。
原本卡死几个月的“未知蛋白”,当天下午就能锁定生化反应底物方向。
四、工具梯队与实操入口一览
三款工具均具备零成本上手条件,按需选用:
| AlphaFold Server | ||||
| ESMFold Web | ||||
| Foldseek Web |
不需要申请 GPU 机器,实验室普通台式机甚至手机浏览器都能直接开跑。
五、什么时候千万别信这些预测?
既然工具这么快,是不是以后不用做湿实验了?
错了。预测越容易,越容易把人带进沟里。必须死守三条防线:
- 预测结构不是冷冻电镜(Cryo-EM)或晶体真实的生理证据。
审稿人可以接受你用 AI 模型来提出假说和设计突变,但绝不会允许你把一个没有实验验证的预测模型当作「机理解析」的最终结论。 - 警惕构象变化(Conformational Change)。
真实的酶和受体处于不断抖动的动态平衡中(开闭状态、别构效应)。AI 预测给出的通常只是热力学单一体快照,不能体现结合前后的动态构象漂移。 - 低置信度区域别硬掰故事。
如果在 AlphaFold 结果里看到 pLDDT 小于 50 的橙红色面条状区域,那大概率是柔性无序尾巴。别在这些区域大做文章,更不要根据那里的松散构象去推测所谓的活性中心。
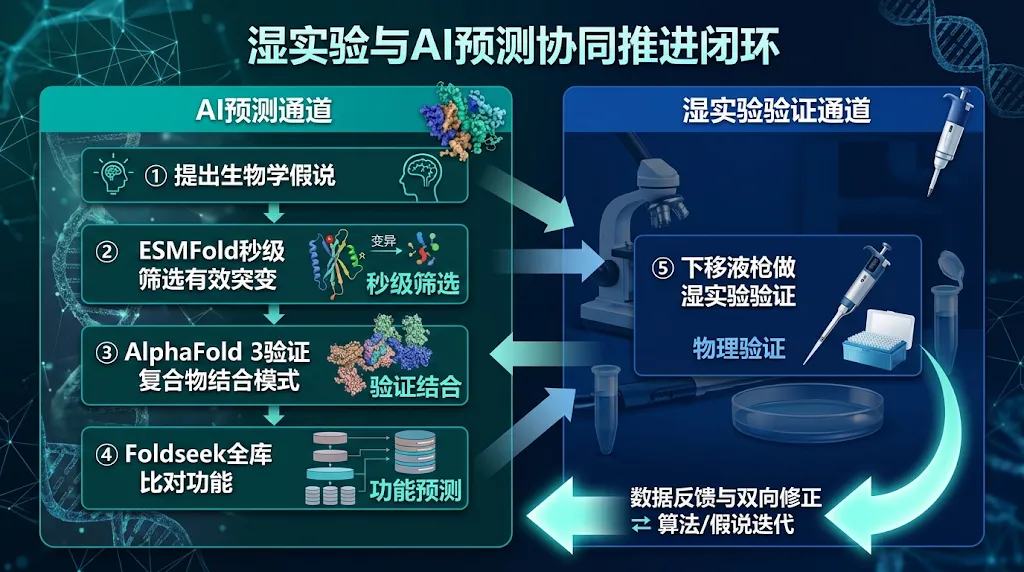
AI 负责在动手前把盲目摸索的范围从 360 度缩小到 15 度;剩下的 15 度,移液枪和凝胶成像仪说了算。
结尾
诺奖周的大新闻落幕了。吹捧和焦虑留给科技媒体;工具和方法留给今晚的实验室。
今天就能做的动作: 把你目前课题里卡住的一个未知蛋白或某个准备做定点突变的序列找出来。打开 Foldseek 或 ESMFold 网页版,把序列粘进去跑一次。看看 5 秒钟弹出来的三维折叠,能不能给你明天的实验设计提供一个新角度。
三个可带走的要点: 1. 诺奖级结构生物学红利已经降维成网页端工具,普通湿实验团队零算力即可调用; 2. 记住三件套:ESMFold 筛突变速度最快,AlphaFold Server 算结合复合物最全,Foldseek 破译未知蛋白最准; 3. 预测永远是假说的起点,绝非论文的最终证据;先用算法排除低级错误,再上实验台求真。
📱 关注「AI科研效率实验室」
每周分享 AI 提升科研效率的实用工具、方法教程和提效实战
每一篇都是你明天就能用上的方法
👆 点击上方蓝字或搜索「AI科研效率实验室」
长期关注,解锁AI时代的科研新姿势