ARTICLE · 1141091
大模型正在快速改变软件开发,但在真正写代码之前,它往往需要先回答一个更基础的问题:代码在哪里?
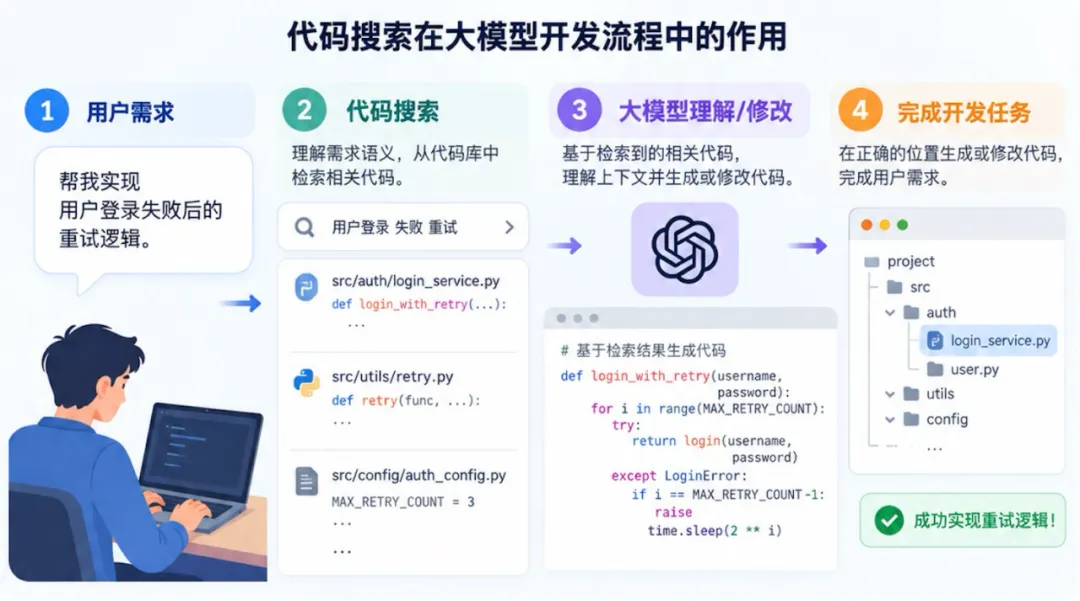
大模型正在快速改变软件开发,但在真正写代码之前,它往往需要先回答一个更基础的问题:代码在哪里?
过去,开发者面对一个陌生项目,往往需要自己搜索函数、阅读文档、追踪调用链,再找到可以复用或修改的代码。今天,这些工作正在越来越多地交给大模型和代码智能体。
当开发者说一句“帮我实现用户登录失败后的重试逻辑”,智能体并不能凭空开始写代码。它首先要知道:登录逻辑在哪个模块?项目里有没有已经实现的重试机制?应该调用哪个内部接口?有没有类似代码可以复用?
所以,代码智能体看起来是在“生成代码”,背后却越来越依赖另一项基础能力——代码搜索(Code Search)。
如果说代码生成决定了智能体“会不会写”,那么代码搜索很大程度上决定了它“能不能找到正确的地方写”。
01
大模型时代,为什么我们反而更需要代码搜索?
软件开发从来都不是从一张白纸开始写代码。
一个成熟的软件项目可能包含几十万甚至数百万行代码。开发者接到一个需求后,真正花费时间的往往不是敲下代码本身,而是理解已有系统:找到相关实现、定位接口、阅读上下文、寻找可复用组件,再判断应该在哪里修改。
代码搜索解决的正是这个问题:给定一个自然语言需求,从庞大的代码库中找到真正相关的代码。
例如,开发者输入:
“找到项目中负责验证用户身份的代码。”
搜索系统需要理解的不是关键词“用户”和“身份”分别出现在哪里,而是这句话背后的语义意图,并从大量函数和代码片段中找出真正负责 authentication 的实现。
这也是为什么,现代代码搜索早已不只是传统的字符串匹配。
随着深度学习的发展,研究者开始使用神经网络分别理解自然语言和程序代码,再把二者映射到同一个语义空间中。开发者输入一句自然语言,模型就可以根据语义相似度,从海量代码中找到最相关的实现。
代码搜索由此从“搜索相同的词”,逐渐变成了“搜索相同的意思”。
而到了代码大模型和智能体时代,这项能力的重要性进一步提升。
因为无论是代码问答、代码生成,还是今天流行的Repository-level Coding Agent ,本质上都面临同一个问题:
模型不可能每次都把整个代码仓库完整读一遍。
它必须先找到与当前任务最相关的代码,再把这些代码交给模型理解和处理。
换句话说,代码搜索正在从一个面向开发者的独立工具,逐渐变成大模型理解大型代码库的一项基础能力。
02
但有意思的是:大模型越来越强,代码搜索的主流技术却长期走着另一条路线
过去几年,代码智能领域经历了一次非常明显的技术变化。
早期的 CodeBERT、GraphCodeBERT、UniXcoder 等模型,大多采用 Encoder 或 Encoder-based 架构 。它们擅长把自然语言和代码编码成向量,因此天然适合代码搜索。
一段自然语言经过模型得到一个向量,一段代码经过模型得到另一个向量,再计算两个向量之间的距离,就可以判断它们是否相关。这种技术路线简单、高效,也因此长期成为 神经代码搜索的重要范式。
但与此同时,另一个变化发生了。
ChatGPT、Llama、CodeLlama、Gemma 等大模型的出现,让Decoder-only Transformer成为了这一轮大模型浪潮最重要的技术架构之一。
这些模型拥有更大的参数规模、更丰富的预训练知识和更强的上下文理解能力。在代码生成、代码解释、程序修复等任务上,它们已经表现出了非常强大的能力。
于是,一个很自然的问题出现了:既然 Decoder-only 大模型已经这么会“写代码”,它是不是也更会“找代码”?
看起来答案似乎应该是肯定的。
更大的模型、更丰富的训练数据、更强的代码理解能力、更长的上下文窗口——这些能力似乎都应该让 Decoder-only LLM 在代码搜索上轻松击败过去的 Encoder 模型。
甚至可以进一步问:Decoder-only LLM,会不会成为代码搜索的“银弹”?
但问题恰恰在于:生成能力强,并不意味着检索能力一定强。
03
会生成代码,和会搜索代码,其实是两件不同的事
代码生成和代码搜索,看起来都要求模型“理解代码”,但它们解决的问题并不相同。
代码生成面对的是:给定一个需求,生成一段可能正确的代码。
而代码搜索面对的是:给定一个需求,从成千上万个候选代码中,把真正相关的代码排到最前面。
前者是生成问题,后者本质上是一个大规模检索与排序问题。
对于代码搜索来说,模型不仅要“看懂”代码,还必须学习一个高质量的语义表示空间:相关的自然语言和代码应该靠得足够近,不相关的代码又必须被准确地区分开。
这恰恰是 Encoder 模型长期擅长的事情。
而 Decoder-only LLM 最初并不是为了这种任务设计的。
于是,大模型时代留下了一个非常有意思的问题:如果把今天最流行的 Decoder-only LLM 真正放到代码搜索任务上,它们到底表现如何?
是参数越多,搜索效果越好?
直接使用就已经足够强,还是必须针对代码搜索进行微调?
不同的微调方式、训练数据和模型规模,又会如何影响最终效果?
更重要的是:我们是不是应该直接用 Decoder-only LLM 替代传统 Encoder 模型?
过去,这些问题缺少系统性的答案。
04
于是,我们真的把这件事系统地测了一遍
围绕这个问题,我们团队开展了一项大规模实证研究:
Are Decoder-Only Large Language Models the Silver Bullet for Code Search?
该研究已发表于软件工程领域国际权威期刊 IEEE Transactions on Software Engineering(TSE)。
我们没有简单选择一两个大模型跑一次实验,而是围绕 Decoder-only LLM 到底适不适合代码搜索 进行了系统研究。
在最新版本的研究中,我们评估了11 个 Decoder-only 大语言模型,并从 Zero-shot、Fine-tuning、模型规模以及训练数据组成等多个维度分析它们在代码搜索任务上的表现。
实验首先回答了一个最直接的问题:
Decoder-only LLM 到底能不能做好代码搜索?
答案是:可以,而且经过正确微调之后,可以非常强。
实验中,经过微调的 Decoder-only 模型展现出了显著的竞争力。其中 CodeGemma 在 CoSQA+ benchmark 上,相比 UniXcoder 获得了40.4% 的 MAP 提升。
这意味着,Decoder-only LLM 不仅可以生成代码,也完全有潜力成为强大的代码检索模型。但真正有意思的地方还在后面。
大模型,并不是越大越好。
我们的实验发现,模型规模与代码搜索性能之间并不存在简单的单调关系。
直觉上,一个 13B、几十亿甚至更大参数的模型,应该比更小的模型拥有更好的代码理解能力,因此搜索效果也应该更强。
但实际结果并非如此。
在代码搜索任务上,中等规模模型在一些设置下反而能够超过更大的模型。
这说明代码搜索并不是简单的“大力出奇迹”。
对于检索任务而言,模型如何形成代码表示、如何进行任务适配,可能比单纯增加参数量更加重要。
05
甚至连“训练数据越多越好”,也不一定成立
另一个非常值得注意的发现来自训练数据。
通常我们会认为:既然要训练代码模型,那么加入更多编程语言、更多代码数据,模型应该学得更好。
实验结果告诉我们,这件事要复杂得多。
我们的研究发现,多语言训练数据能够提升模型的泛化能力,但训练数据的组成非常关键。某些情况下,少量来自特定语言的数据反而可能成为噪声,对最终效果产生干扰。
换句话说:决定代码搜索效果的,不只是“有多少数据”,更是“模型究竟看到了什么数据”。
这对于实际构建代码搜索系统尤其重要。
过去优化模型,很容易陷入两个直觉:
模型不够好?——换更大的。
效果还不够?——加更多数据。
但我们的实验说明,对于 Decoder-only LLM 的代码搜索能力而言,这两个答案都不一定成立。
选什么模型、模型多大、如何微调、用什么数据训练,这些因素需要被一起考虑。
06
所以,Decoder-only LLM 是代码搜索的“银弹”吗?
答案可能比简单的“Yes”更有意思。
我们的研究表明,Decoder-only LLM 确实拥有非常强的代码搜索潜力。经过适当的任务适配,它能够超越具有代表性的 Encoder-based 方法。
但与此同时,它并不是一个“只要换成大模型,一切问题自然解决”的银弹。
模型规模并非越大越好,训练数据并非越多越好,不同模型经过微调后的收益也并不完全一致。
真正重要的,是如何把大模型强大的代码理解能力,转化成稳定而有效的代码检索能力。
而这个问题在代码智能体时代正在变得越来越重要。
未来的 Coding Agent 不仅需要生成下一行代码,还需要面对越来越庞大的 Repository,理解越来越复杂的工程上下文。
当代码库大到无法一次放进上下文窗口时,Agent 首先必须决定:我到底应该看哪些代码?
从这个角度来看,Code Search 可能并不是大模型时代一个已经“过时”的传统任务。
恰恰相反。
当模型越来越会写代码,“如何让模型先找到正确的代码”,正在成为下一阶段代码智能系统必须解决的问题。
而我们希望通过这项工作回答其中一个最基础的问题:今天最强大的 Decoder-only LLM,究竟应该怎样被用于代码搜索?
来自团队论文:
Are Decoder-Only Large Language Models the Silver Bullet for Code Search?
Yuxuan Chen, Mingwei Liu, Guangsheng Ou, Anji Li, Dekun Dai, Yanlin Wang, Zibin Zheng
IEEE Transactions on Software Engineering (TSE), 2026
论文围绕 Decoder-only LLM 在代码搜索中的能力进行了系统性研究,并进一步分析了模型选择、Fine-tuning、训练数据和模型规模等因素对代码搜索性能的影响。相关实验代码与数据也已公开。
论文:https://arxiv.org/abs/2410.22240
中山大学
人工智能研究院智能软件研究中心
共建校企协同创新生态
中山大学人工智能研究院智能软件研究中心团队长期深耕企业数智化、行业智能体、数据治理等方向的理论研究与产业实践。
团队始终致力于打通学术研究与产业应用之间的壁垒,持续依托各类产业交流活动倾听市场一线声音,将前沿研究成果结合行业实际场景进行打磨。后续,团队也将继续联合行业协会举办常态化闭门交流活动,持续搭建校企沟通桥梁,探索多元形式的产学研协同模式,助力广大企业把握智能化发展机遇,实现高质量转型升级。
若企业有志于探索数智化升级新思路,期待开展校企技术交流,欢迎保持沟通。
产学研合作
企业如在AI智能体有需求梳理、应用开发、项目落地等需求,可通过项目合作、联合攻关等形式与中山大学人工智能研究院智能软件研究中心合作,具体合作欢迎联系林老师沟通交流。
林老师电话:15986852262(微信同号)
——咨询联系问卷——
(填写问卷,我们会有专人尽快与您联系)
(关注视频号,了解更多产学研动态)