ARTICLE · 1141162
科学家们认为AI 最先交出成绩单的地方,是金融
他是 Lin William Cong,南洋理工大学校长讲席教授、南洋商学院副院长。他的开场白只有两句:AI for Science 已经拿下了两项诺贝尔奖;AI for Social Science,还是一大片没人开垦的地。
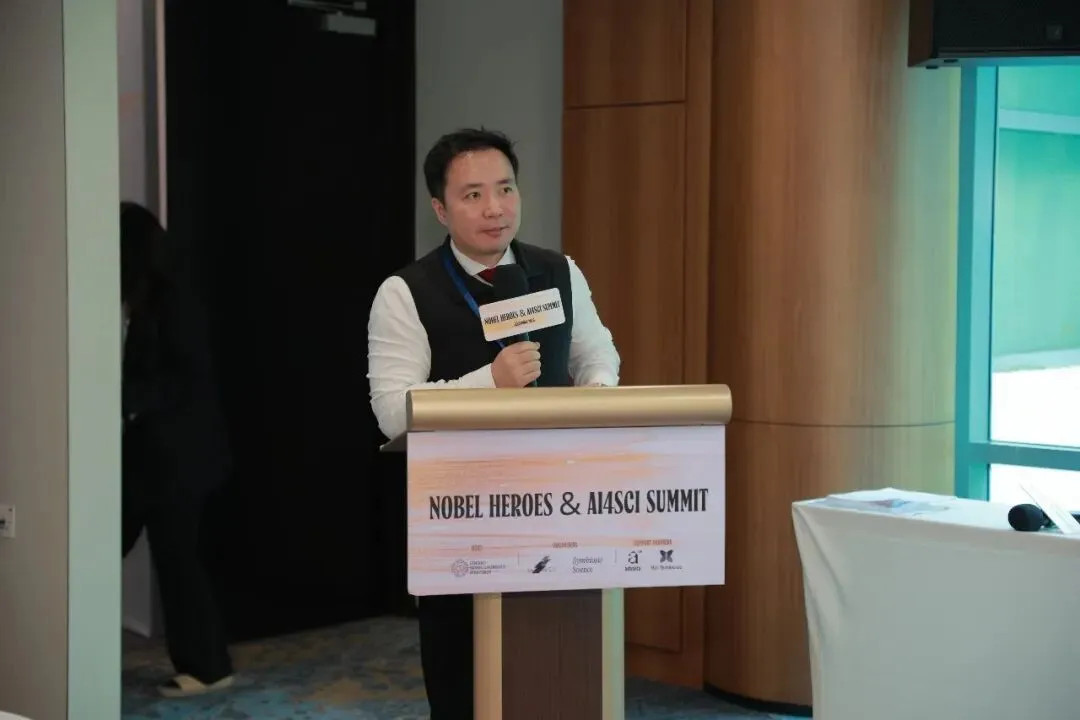
· 南洋理工大学校长讲席教授Lin William Cong
然后他在屏幕上放出了一个数字:夏普比率,2 以上。
在华尔街,这个数字的意思是:这套策略,比绝大多数对冲基金都好。
这是我们共生科学参与组织的 Nobel Heroes & AI4SCI Summit Singapore 2026 第一天下午的主旨演讲。那一整天,五位诺奖得主在台上反复讨论同一个问题:AI 到底有没有做出过真正的科学发现。上午的结论偏悲观,晚上的结论有分歧,但有一点大家心照不宣:在自然科学里,AI 还没有一张大家都认的成绩单。
Cong 这场演讲,恰好从另一头补上了这个问题。在一个领域里,AI 的成绩单不仅有,而且每天都在被重新打分。那个领域是金融。
说「重新打分」不是比喻。科学发现要等同行复核,有时要等十年;一个投资策略好不好,市场明天开盘就会告诉你。
把时间往回拨到 1952 年。芝加哥大学的博士生 Harry Markowitz,在《金融学期刊》上发表了一篇论文,题目就叫《投资组合选择》。他第一次用数学把「收益」和「风险」放在同一张图上,画出了一条后来被叫做「有效前沿」的曲线:在给定的风险下,你最多能拿到多少收益。38 年后,这篇论文让他拿到了 1990 年的诺贝尔经济学奖。
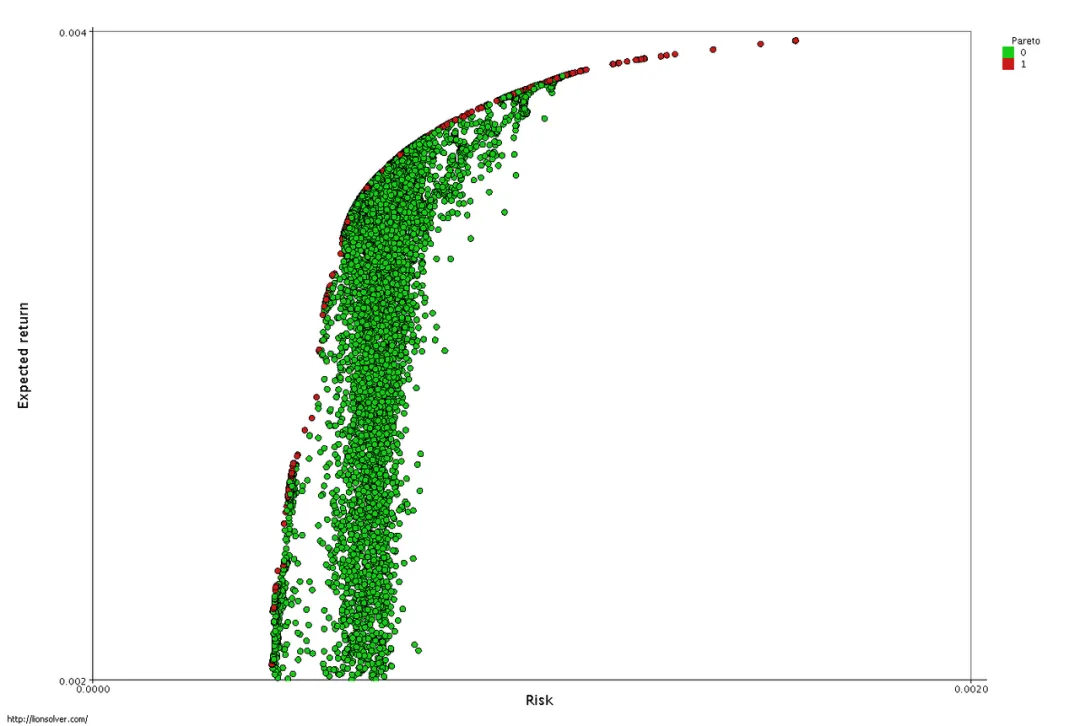
Markowitz 投资组合选择问题的有效前沿示意:横轴是风险,纵轴是预期收益,红点连成的上沿就是「有效前沿」
从那时起,金融就是一门「可以打分」的学科。七十多年后,AI 走进这门学科,第一件事也是被打分。
AI 在金融里比在自然科学里更早交出成绩单,不是因为金融更简单,而是因为金融有一张现成的、公开的、每天更新的考卷:样本外收益。这张考卷暴露了三件 AI for Science 还没机会知道的事:成绩会在公开以后掉下来;小模型可以考出大模型的分数;最难的部分不是预测,而是模拟「人」。
对正在往 AI for Science 砸钱的人来说,金融这份成绩单最有价值的地方,不是那个夏普比率 2,而是它附带的那几行小字。
先把这个分数讲清楚。夏普比率衡量的是「每承担一份风险,换来多少超额收益」。数字越高,说明收益越稳、越不靠运气。Cong 在台上给的参照是:一家好的对冲基金,在样本内能做到 1.1 到 1.2,就已经算不错了。
他展示的模型叫 AlphaPortfolio,2018 到 2019 年开发,他称之为第一个非语言类的生成式 AI 投资大模型,有 300 万个参数。做法和今天的大模型很像:用 Transformer 这类序列架构,从每家公司过去两年的盈利增长、董事会构成、员工人数等时间序列里提取信息;再用注意力机制去看不同资产之间的关系;最后用强化学习,以试错的方式去训练,训练的目标直接就是「让投资组合的夏普比率最高」。
这篇论文最新的公开版本,是今年 5 月的美国国家经济研究局(NBER)工作论文,作者是 Cong、Ke Tang 和 Jingyuan Wang。摘要里写的结果是:在美国股票上,样本外夏普比率高于 2,按月调仓、经风险调整后的超额收益超过 13%,在不同市场环境和经济约束下都稳健。Cong 在台上补充,剔除最小的 10% 股票等检验之后,结论依然成立。
他还说了一句很少有人会在台上说的话:这篇论文花了六七年才发表。
这个细节值得多看一眼。一个在 2019 年就跑出来的结果,学术界用了六七年去审它、质疑它、要求补充检验。和自然科学里一篇「AI 发现了 220 万种新材料」的论文相比,金融学界对一个高分策略的默认态度,是先不信。
夏普比率像是赛车成绩里的「平均圈速除以翻车次数」。跑得快不难,难的是又快又不翻车。2 的意思是,这辆车比大多数职业车队都开得稳。
Cong 在台上主动讲了一件对自己不太有利的事:模型公开以后,又积累了五年真实的样本外数据,夏普比率下降了,但仍然跑赢大多数模型。
下降了多少,他没有在台上给具体数字,我也不替他补。但「公开以后会下降」这件事,金融学界早就有人量过。
2016 年,David McLean 和 Jeffrey Pontiff 在《金融学期刊》上发表了一篇被反复引用的论文,题目很直接:《学术研究会摧毁股票收益的可预测性吗?》。他们找了 97 个被学术论文证明能预测股票收益的变量,追踪它们在论文之外的表现。结果是:在原论文的样本期之外,收益平均低了 26%;论文发表之后,收益平均低了 58%。
他们的解释是,26% 那部分,大致可以算作原来研究里的「数据挖掘」水分;而从 26% 到 58% 多出来的那一截,来自读了论文去交易的人。一个规律一旦被公开,就会被市场上的钱吃掉。
同一年,杜克大学的 Campbell Harvey 等人在《金融研究评论》上做了另一件事:把学术文献里声称能预测股票收益的「因子」数了一遍,一共 316 个。他们的结论是,考虑到半个世纪以来大家都在同一批数据里找规律,传统的统计门槛定得太低了,新因子的 t 值至少要过 3.0,而不是过去的 2.0,才能被当成真发现。
把这两篇放在一起看,金融的成绩单其实有三栏:样本内的分数,样本外的分数,公开以后的分数。大多数漂亮的结果,在第二栏打个折,在第三栏再打个折。AlphaPortfolio 的价值,不在于第一栏的 2,而在于它敢把第三栏也拿出来给人看。
而 AI for Science 到今天为止,大多数公司拿出来的,还只有第一栏。
就像一家网红餐厅,开业第一个月排长队,第二年人少了一半。真正的好店,不是第一个月最火的那家,是第三年还有人排队的那家。金融学者早就习惯了等到第三年再下结论。
整场演讲里,我觉得对「钱」最有冲击力的,不是那个 2,而是 Cong 接下来说的一句:这个思路并不依赖深度学习,也不依赖大算力。
他的团队后来做了一种叫「面板树」(P-Trees)的方法。在台上,他说它只用了大约 100 个参数的回归树,在问题设定得当的时候,就能达到 300 万参数模型的表现。这项研究去年 5 月已经发表在《金融经济学期刊》上,论文题目很应景:《在面板树上生长有效前沿》,也就是把 1952 年 Markowitz 那条曲线,再往外推一点。论文摘要里的说法是,这种稀疏的结构,能做到接近那些「过参数化的大模型」才能达到的样本外夏普比率。
还有一个好处,是看得懂。面板树会让数据自己说出来:哪些资产天然会被归为一类,由哪些因子定价,在什么样的市场状态下成立。而不是由人事先按「行业」「国家」把它们分好组。
为什么这件事和钱有关?因为过去一年,AI for Science 赛道上最大的几笔融资,讲的几乎都是「规模」的故事:更大的模型、更多的算力、更多由机器人实验室生成的数据。比如做自主实验室的 Periodic Labs,据报道估值不到八个月就从 13 亿美元谈到了 75 亿。金融的经验提供了一个反例:在一个有严格成绩单的领域里,规模不是唯一的路,有时候想清楚问题,比加参数更值钱。
这不是说大模型没用,而是说「越大越好」在有考卷的地方是可以被检验的;在没有考卷的地方,它只能被相信。
一个老会计拿着一张写满规则的小卡片,和一台装满了几百万条规则的电脑比算账,结果差不多。区别是,老会计能告诉你他为什么这么算。
选股只是开始。Cong 介绍的第二个项目叫 AlphaManager,2020 到 2021 年做的,对象从股票换成了公司本身。
他的说法是,CEO 和 CFO 每天面对的是一个高维度、动态的决策问题:发股票还是回购债券,投研发还是留现金,开新工厂、裁员,还是去买 ChatGPT 的 API;做完决定,还要根据市场反馈不断调整。在经济学的语言里,这是一个「带学习的动态随机控制问题」。
团队用美国上市公司的数据,搭了一个「企业环境模拟器」。按他在台上给的数字,在测试样本里,它能解释或预测下一季度企业经营结果 30% 到 40% 的差异;而其他公司金融模型,在样本内通常只有 10% 到 12%。如果给模拟器一个目标,比如「让未来两年市值增长最大」,按 AI 给出的策略去做,在测试样本里比这些公司的历史表现高出大约 10%。
这里面藏着一个很现实的产品方向,他自己点了出来:这套方法能看出哪些管理动作真正重要,哪些公司更「可管理」,进而为高管薪酬设计提供参考。用他的话说,高管不应该因为自己影响不了的事情拿报酬。
这句话,会让很多董事会的薪酬委员会坐立不安。一个能把「市场大涨」和「CEO 做对了」分开的模型,本身就是一个可以卖钱的东西。
就像足球教练的成绩,不能只看赢了几场,还要看是不是靠对手太弱。如果有一个模型能算出「换个普通教练会赢几场」,那教练的奖金就有了新的算法。
演讲的后半段,Cong 讲的是他认为的下一步:「我们正从语言模型走向智能体模型,再到世界模型,我认为下一步是经济世界模型。」
他引用了诺贝尔物理学奖得主默里·盖尔曼的一句话:想象一下,如果原子和分子都有自己的思想,物理学会有多难。经济世界模型要模拟的,就是这样一个「原子有思想」的世界。他举的例子是银行挤兑:一个简单的世界模型永远模拟不出挤兑,因为挤兑的前提是每个人都相信别人会去取钱。要模拟它,就得把「人怎么想别人怎么想」也放进去。
他介绍,团队已经做了几个这样的模型:模拟去中心化金融和链上交易,推演 FTX、Terra-Luna 崩盘,以及假设 Tether、Circle 出问题时金融系统会怎样;模拟粤港澳大湾区香港、深圳、广州居民的「经济人格」和金融决策;模拟新加坡七个区的租房和劳动力市场。最后这个例子,新加坡人会很熟悉:2023 年 4 月,新加坡把外国人买房的额外买方印花税从 30% 提高到 60%,他们模拟的就是这类政策出台后,人们在哪里工作、在哪里租房的选择会怎么变。
真正说明「谁会为这个付钱」的,是他最后提到的两件事。团队最近已经和新加坡政府、警察部队合作防范诈骗,模拟冒充政府人员的视频,以及普通人看到这些视频后的反应;也在和新加坡金融管理局、新加坡银行公会交流 AI 韧性,模拟针对银行和 IT 系统的各种攻击会造成什么整体后果。
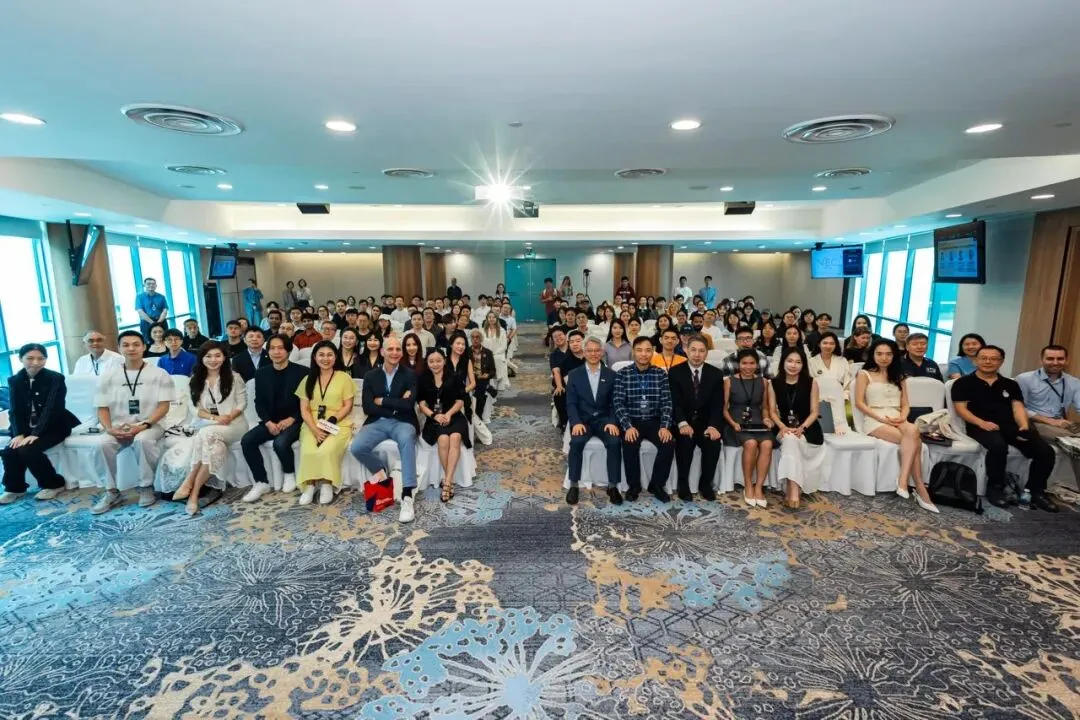
10 月 5 日,Nobel Heroes & AI4SCI Summit Singapore 2026 来宾合影
换句话说,经济世界模型的第一批客户,不是对冲基金,而是需要在政策出台之前、在危机发生之前看一眼「如果这样,会怎样」的人:央行、金融监管机构、警察。这和 AI for Science 的买家结构很不一样。AI for Science 的钱,主要来自风投和大公司,押的是「发现」以后的回报;经济世界模型的钱,来自需要「避免坏事」的公共机构,买的是推演能力本身。
后一种生意不性感,估值也不会一年涨六倍。但它有一个前一种生意没有的东西:客户清楚自己在买什么。
天气预报不能让你发财,但每个城市都离不开它。经济世界模型想做的,是金融系统的天气预报:不告诉你哪只股票会涨,只告诉你明天会不会有暴雨。
这个话题,最容易被讲歪成两种样子。
第一种:「AI 炒股已经能稳赚了。」不对。论文里的夏普比率是在历史数据上回测出来的,再稳健的检验也不等于一只真实运作的基金;而且按 McLean 和 Pontiff 的研究,一个规律被公开以后,收益平均会少掉一半以上。Cong 自己也说,公开五年后,分数下降了。读论文去照着买股票,恰恰是最典型的「吃掉规律」的那批人。
第二种:「金融 AI 不算科学,没什么可学的。」也不对。金融学是少数几个能对 AI 做长期、公开、可重复检验的学科,它积累的方法,比如样本外检验、发表后衰减、多重检验门槛,正是 AI for Science 目前最缺的东西。把它当成「炒股技巧」,就错过了它真正的价值。
两种说法,一个高估了金融 AI 的赚钱能力,一个低估了它的方法论价值。它真正值得被借鉴的,不是分数,而是打分的方式。
第一刀,最致命:这篇文章引用的成绩单,几乎全部来自 Cong 本人:他的论文、他在台上的讲述。夏普比率 2 是论文回测,不是一只真实基金的业绩;「公开五年后仍跑赢大多数模型」是他的口头说法,没有给出具体数字。我说金融有「公开的考卷」,但这一份考卷,阅卷人目前主要还是考生自己。
第二刀:AlphaManager 的「30% 到 40%」「高出约 10%」,都是在测试样本里的数字,是模拟器里的反事实推演。现实中没有一家公司真的按 AI 的建议运营了两年,所以「按 AI 决策会更好」,目前只是一个模型内部的结论。
第三刀:拿金融和自然科学的「成绩单」做比较,本身就不公平。股票收益每天都有,数据是现成的;一种新材料要合成、表征、做成器件,一轮验证可能就是好几年。不是自然科学界不想要考卷,是它的考卷天然更慢、更贵。
第四刀:「100 个参数做到 300 万参数的效果」,前提是「问题设定得当」。这个前提本身就需要大量专业判断,换句话说,那 300 万个参数省下的工作,可能是被金融学者几十年的经验提前做掉了。小模型赢,未必能推广到一个还没有这几十年积累的新领域。
第五刀:文中的现场内容来自我们团队自己的快讯稿,Cong 教授是峰会请来的演讲嘉宾。我挑了一场对「AI 能交成绩单」最有利的演讲来写,同一天还有很多场在讲 AI 的局限,这个选择本身就有倾向。
反过来说,我坚持的部分只有一条:金融学早就有一套检验「漂亮结果」的方法,包括样本外检验、发表后衰减、更高的统计门槛,而且有学者愿意把自己模型掉分的那部分也拿出来讲。正在往 AI for Science 投钱的人,最该借的不是金融 AI 的模型,而是这套打分的习惯。这一条,上面五条都反驳不掉。
回到那天下午的报告厅。Cong 讲完经济世界模型,最后的总结很学术:端到端优化、可解释模型、群体异质性、智能体模拟和环境模拟结合。
他开场那句话,我后来想了很久:AI for Science 已经拿下了两项诺贝尔奖,AI for Social Science 还是一片空地。可是从成绩单的角度看,也许正好相反:拿了诺奖的那一边,还在等它的第一张公认的考卷;没拿奖的这一边,已经被市场打了好几年分。
如果 AI for Science 接下来学会了金融那套打分方式,把样本外、公开后、多重检验都写进自己的成绩单,那今天砸进去的钱,会更容易分清楚哪些是真本事。如果没有,它可能要用自己的方式,再交一遍金融学几十年前就交过的学费。
— James
本文仅为信息分享,不构成任何投资建议。文中提及的策略与模型均为学术研究结果,不代表真实投资业绩。文中数据来自公开文献与峰会现场记录,如有更新以官方信息为准。
给做 AI for Science 的创业者:除了样本内的漂亮结果,也试着把「公开以后会怎样」「换一批数据会怎样」写进你的成绩单;敢拿出掉分那一栏的团队,反而更容易被认真对待。
给投这条赛道的投资人:看到一个「AI 发现了很多」的数字时,问三个问题:样本外呢?别人复核过吗?这个结果公开以后还剩多少?金融学用了半个世纪才养成这个习惯。
给普通读者:任何一篇「AI 选股夏普比率 2」的论文,都不是买入理由;学术研究里能写出来的规律,往往正是最先被市场吃掉的那一批。
Nobel Heroes & AI4SCI Summit Singapore 2026 是由林道诺贝尔奖得主大会基金会作为主持机构,共生科学(Symbiosis Science)与 Laureates City Holdings Limited 共同主办。
Markowitz《投资组合选择》发表于《金融学期刊》1952 年,1990 年获诺贝尔经济学奖:公开文献与诺贝尔奖官方资料。2024 年诺贝尔物理学奖与化学奖均颁给 AI 相关工作:诺贝尔奖官方。AlphaPortfolio 美股样本外夏普比率高于 2、月度调仓风险调整后超额收益超过 13%、注意力网络与强化学习架构:Cong、Tang、Wang,NBER 工作论文 35195(2026 年 5 月)。面板树以稀疏结构达到接近过参数化大模型的样本外夏普比率:Cong、Feng、He、He,《金融经济学期刊》第 167 卷(2025 年 5 月)。97 个预测变量样本外收益低 26%、发表后低 58%:McLean、Pontiff,《金融学期刊》2016。梳理 316 个因子、建议 t 值门槛提高到 3.0:Harvey、Liu、Zhu,《金融研究评论》2016 年第 29 卷第 1 期。新加坡 2023 年 4 月 27 日起外国人额外买方印花税由 30% 提高至 60%:新加坡金融管理局、财政部、国家发展部联合公告。
Lin William Cong 在南洋理工大学的职务(校长讲席教授、南洋商学院副院长、GIFTS 院长):峰会嘉宾资料;公开检索结果多为其此前在康奈尔大学的职务。Periodic Labs 估值从约 13 亿美元谈到 75 亿美元:福布斯 2026 年 5 月报道,截至发稿未见交割。
AlphaPortfolio 2018 至 2019 年开发、300 万参数、「首个非语言类生成式 AI 投资金融大模型」、对冲基金样本内夏普 1.1 至 1.2、剔除最小 10% 资产后仍成立、论文历时六七年发表、公开后五年样本外夏普下降但仍跑赢大多数模型;面板树约 100 个参数可达 300 万参数模型表现;AlphaManager 的 30% 至 40% 与 10% 至 12% 对比、约 10% 的市值增长差异、高管薪酬观点;经济世界模型的各项应用、与新加坡政府和警察部队合作防诈骗、与新加坡金融管理局及银行公会交流 AI 韧性;银行挤兑例子与盖尔曼引语:均来自共生科学团队 10 月 5 日现场快讯,为现场演讲的中文整理,非逐字稿。
「金融成绩单有三栏」「AI for Science 大多只有第一栏」「规模在有考卷的地方可以被检验、在没有考卷的地方只能被相信」「经济世界模型的第一批客户是监管者」「客户清楚自己在买什么」等判断,两种误读的总结、五条泼冷水与「我坚持的只有一条」、三句话,均为作者判断,非信源直接陈述。
欢迎加入讨论群