ARTICLE · 1141171
这款8万Star的开源神器,让PDF文献秒变结构化Markdown(python脚本示例)
发布时间:2026-10-08 17:53:18 最近访问:2026-10-08 17:53:18
这款8万Star的开源神器,让PDF文献秒变结构化Markdown(python脚本示例)
一、MinerU是什么?
MinerU是由上海人工智能实验室OpenDataLab团队开源的智能文档解析工具,目前已获得超过8万GitHub Star,在科研文献解析、AI-Ready数据生产等场景中被广泛使用。它支持PDF、DOCX、PPTX、XLSX、图片、网页等多种格式,能够将复杂的文档转化为结构化的Markdown/JSON,公式能转LaTeX、表格能转HTML,完美保留版面结构。说人话就是:不管你的文档排版多复杂,MinerU都能帮你把它变成干干净净、机器可读的Markdown。
二、为什么选择MinerU?
我们来看看它解决的那些痛点:
- •
复杂公式:论文中的数学公式,MinerU能精准提取为LaTeX格式,不用再手敲了
- •
跨页表格:遇到跨了好几页的大表格,MinerU能自动合并,保持结构完整
- •
多栏排版:双栏论文自动按人类阅读顺序输出,页眉页脚也会自动去除
- •
扫描件OCR:图片型PDF、手写体、多语言文档,支持109种语言识别
- •
多语言支持:中文、英文、日文等70余种语言都能识别
三、三种使用方式,总有一款适合你
方式一:网页版,零门槛
打开官网 mineru.net,直接拖拽文件上传,选择解析模式即可。适合偶尔用、不想折腾环境的同学。
方式二:API调用,自动化处理
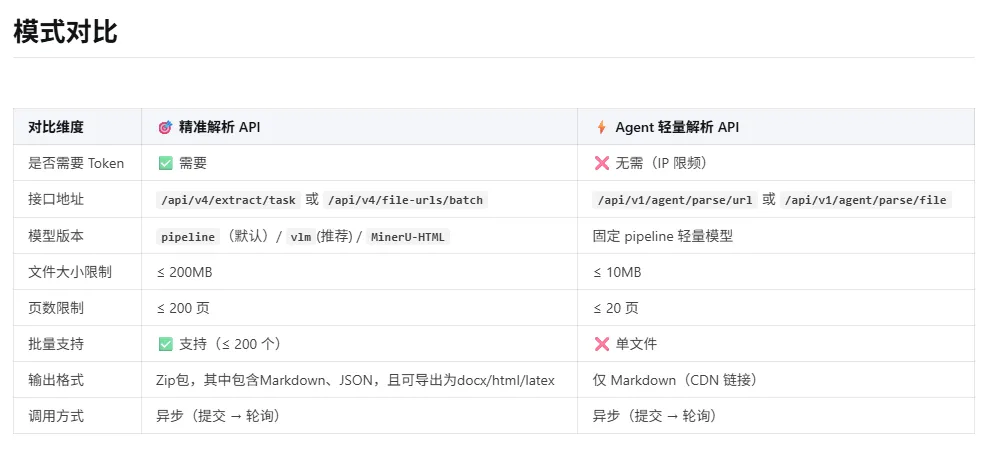
MinerU提供两种API模式,满足不同场景需求:
精准解析API(推荐):
Agent轻量解析API:
Token申请地址:https://mineru.net/apiManage/token
方式三:Python脚本,一键批量处理
以测试为例:
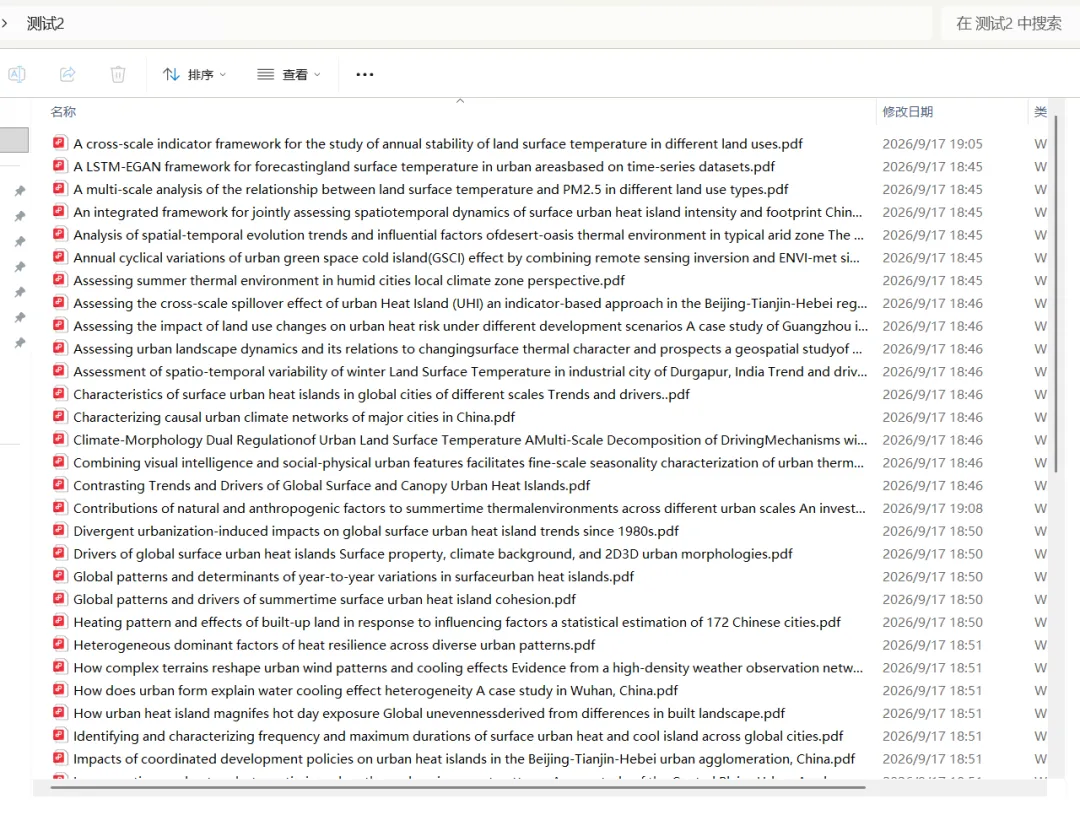
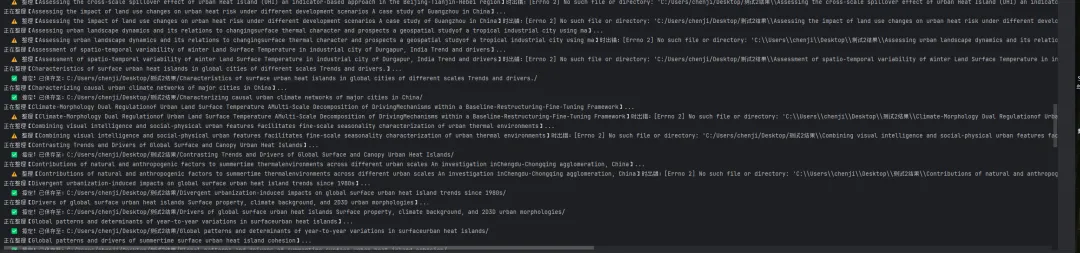
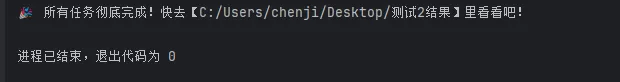
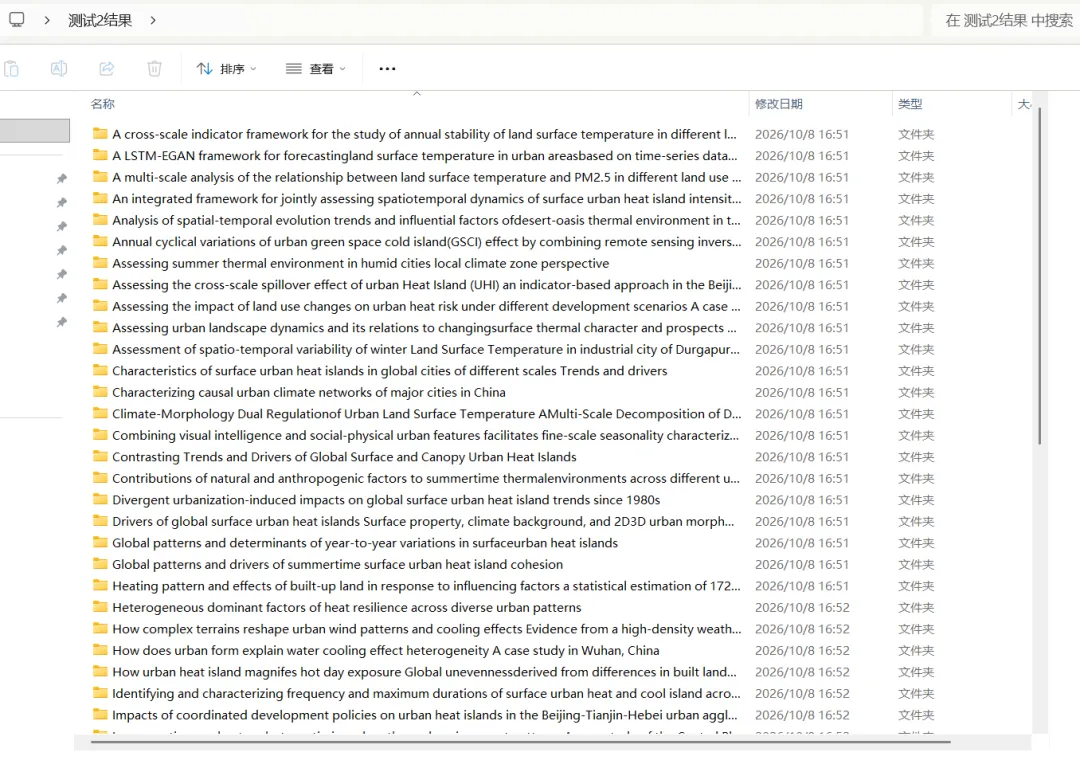
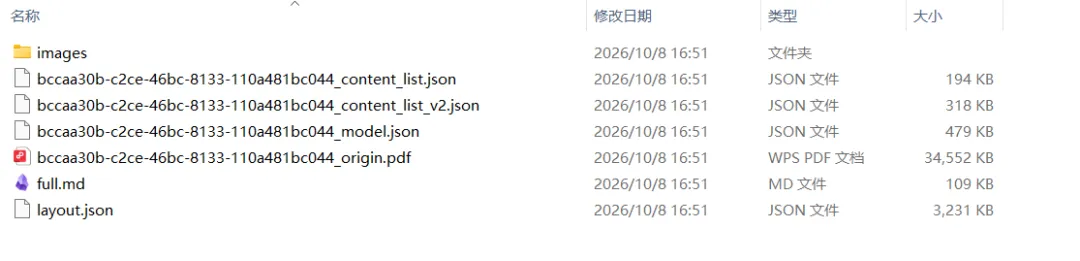
准备了50篇论文,放在同一个文件夹中python代码如下:(填token,修改输入路径,修改输出路径)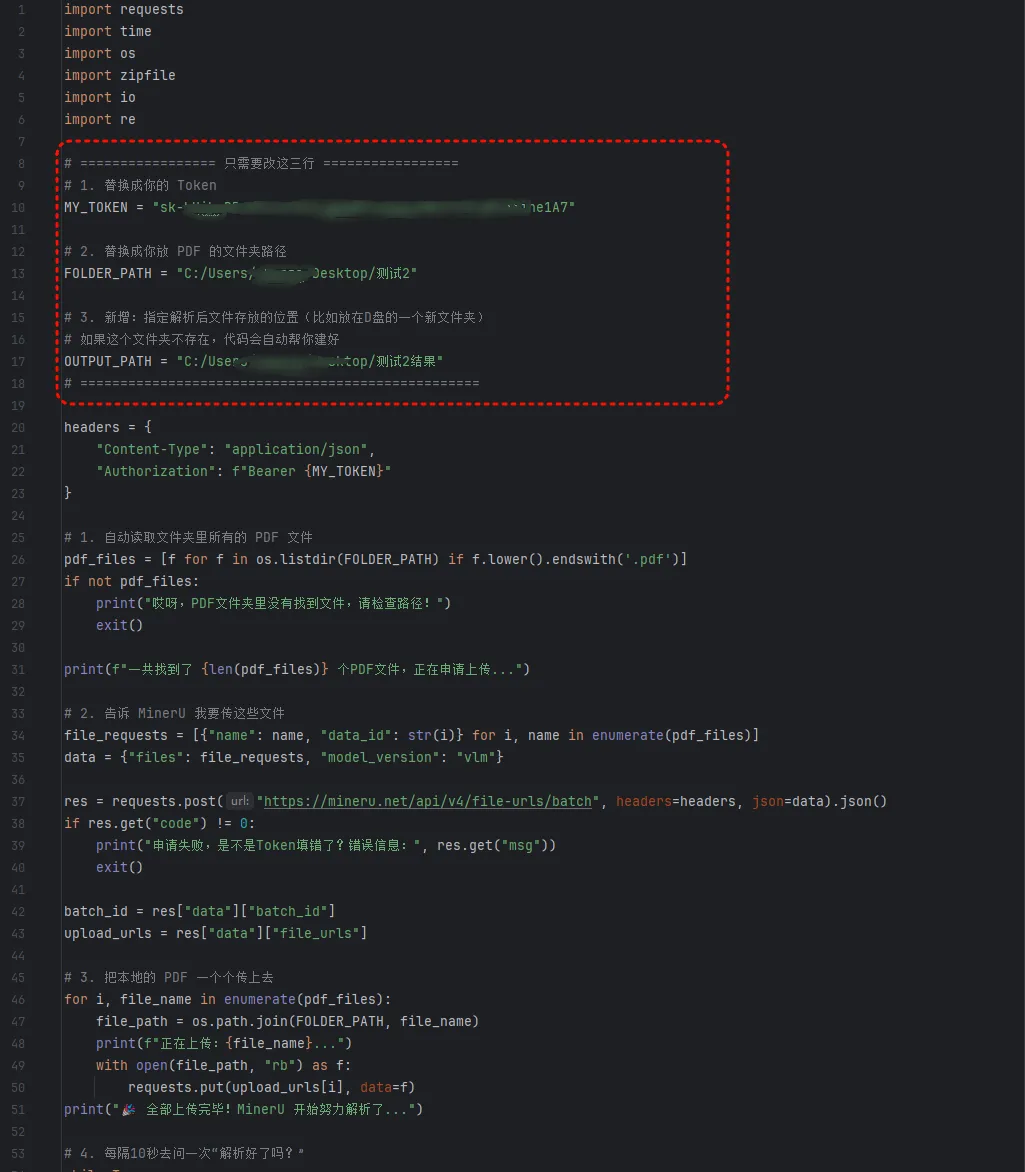 import requestsimport timeimport osimport zipfileimport ioimport re# ================= 只需要改这三行 =================# 1. 替换成你的 TokenMY_TOKEN = ""# 2. 替换成你放 PDF 的文件夹路径FOLDER_PATH = ""# 3. 新增:指定解析后文件存放的位置(比如放在D盘的一个新文件夹)# 如果这个文件夹不存在,代码会自动帮你建好OUTPUT_PATH = ""# ==================================================headers = {"Content-Type": "application/json","Authorization": f"Bearer {MY_TOKEN}"}# 1. 自动读取文件夹里所有的 PDF 文件pdf_files = [f for f in os.listdir(FOLDER_PATH) if f.lower().endswith('.pdf')]if not pdf_files:print("哎呀,PDF文件夹里没有找到文件,请检查路径!")exit()print(f"一共找到了 {len(pdf_files)} 个PDF文件,正在申请上传...")# 2. 告诉 MinerU 我要传这些文件file_requests = [{"name": name, "data_id": str(i)} for i, name in enumerate(pdf_files)]data = {"files": file_requests, "model_version": "vlm"}res = requests.post("https://mineru.net/api/v4/file-urls/batch", headers=headers, json=data).json()if res.get("code") != 0:print("申请失败,是不是Token填错了?错误信息:", res.get("msg"))exit()batch_id = res["data"]["batch_id"]upload_urls = res["data"]["file_urls"]# 3. 把本地的 PDF 一个个传上去for i, file_name in enumerate(pdf_files): file_path = os.path.join(FOLDER_PATH, file_name)print(f"正在上传:{file_name}...")with open(file_path, "rb") as f: requests.put(upload_urls[i], data=f)print("🎉 全部上传完毕!MinerU 开始努力解析了...")# 4. 每隔10秒去问一次“解析好了吗?”while True: time.sleep(10)print("⏳ 还在解析中,请耐心等待...") check_res = requests.get(f"https://mineru.net/api/v4/extract-results/batch/{batch_id}", headers=headers).json()if check_res.get("code") == 0: results = check_res["data"]["extract_result"] all_done = all(item["state"] in ["done", "failed"] for item in results)if all_done:print("\n✅ 全部解析完成!开始整理文件...")# 创建你指定的输出文件夹(如果不存在就自动建)os.makedirs(OUTPUT_PATH, exist_ok=True)for item in results:if item["state"] == "done":# 获取论文标题(去掉.pdf后缀)original_name = item['file_name'] paper_title = original_name[:-4] if original_name.lower().endswith('.pdf') else original_name# 清理标题中 Windows 不允许的字符safe_title = re.sub(r'[\\/*?:"<>|]', "_", paper_title)print(f"正在整理【{safe_title}】...")# 在你的指定目录下,为该论文创建专属小文件夹paper_folder = os.path.join(OUTPUT_PATH, safe_title) os.makedirs(paper_folder, exist_ok=True)# 从云端下载压缩包到内存zip_data = requests.get(item['full_zip_url']).contenttry:with zipfile.ZipFile(io.BytesIO(zip_data)) as zip_ref:# 解压所有文件到专属文件夹zip_ref.extractall(paper_folder)# 找到里面的 md 文件md_files = [f for f in zip_ref.namelist() if f.endswith('.md')]for md_file in md_files: md_content = zip_ref.read(md_file) new_md_path = os.path.join(paper_folder, f"{safe_title}.md")with open(new_md_path, "wb") as f: f.write(md_content)# 删除旧名字的 mdold_md_path = os.path.join(paper_folder, md_file)if os.path.exists(old_md_path) and old_md_path != new_md_path: os.remove(old_md_path)print(f" ✅ 搞定!已保存至:{OUTPUT_PATH}/{safe_title}/")except Exception as e:print(f" ⚠️ 整理【{safe_title}】时出错:{e}")else:print(f"❌ 文件【{item['file_name']}】解析失败: {item.get('err_msg')}")print(f"\n🎉 所有任务彻底完成!快去【{OUTPUT_PATH}】里看看吧!")break在指定的输出路径中,我们可以看到解析后生成的Markdown文件和图片,以及原PDF文件。
点击名片关注,持续更新。如果这篇推文对你有所启发,欢迎点个“赞”和“在看”,也欢迎转发给更多需要的朋友!