ARTICLE · 1142952
Grok 请来 Claude,AI 助手开始比「交付」了
AI 观察 · 2026.10.08
马斯克点名 Claude、Midjourney 和 Suno。更值得关注的是:当助手可以调用不同模型,谁来把一整件事真正做完?
你打开 Grok Bot,交代了一项任务。最后帮你完成其中一部分工作的,可能是 Claude。
这件事,马斯克自己说了。
10 月 7 日,他在 X 上表示,Grok Bot 将按任务使用合适的后端模型,点名 Claude Opus 5.5、Midjourney、Suno,以及其他领先的 API。The Next Web 同日报道了这项表态。[1]
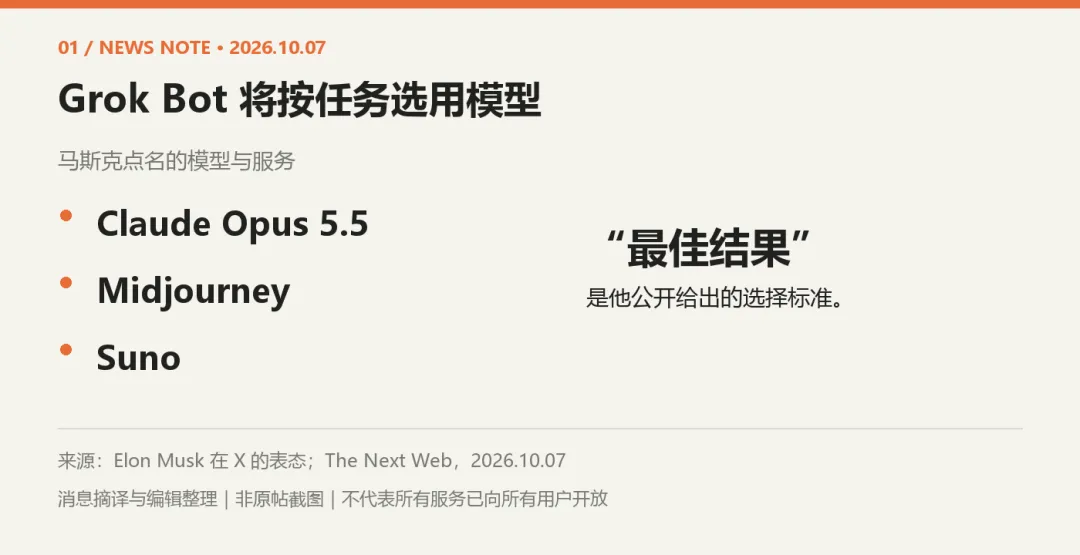
图 1|马斯克公开表态的中文摘译与编辑整理,非原帖截图。
9to5Mac 同日报道称,Grok Bot 已经可以使用 Claude Opus 5.5。这里需要分清:消息针对的是 Grok Bot 智能体产品,不能据此推断 X 上的 Grok 聊天功能也全面换了模型。[2]
竞争对手的模型,成了自己产品里的可用能力。这条新闻很容易被读成一场输赢。
但如果把镜头转向用户,问题会更有意思:模型可以换来换去,究竟是谁负责把你交代的事情做完?
交付了什么,决定用户的体验。
01 /
AI 会得越来越多
人却还在替它收尾
用过多个 AI 工具的人,大概熟悉这样的工作日:一个窗口查资料,一个窗口写文章,另一个窗口做图。每个工具单独看,都很能干。
可一旦要完成一项具体工作,新的麻烦就出现了。
背景要重新解释,资料要来回搬运。正文改了,封面上的说法也得改;数据更新了,摘要和图表还得重新检查。
工具负责生成,你负责衔接。
Grok Bot 选择调用外部模型,为这种分工提供了另一种可能:把不同能力组织在同一个助手里,让用户少做一些中间工作。
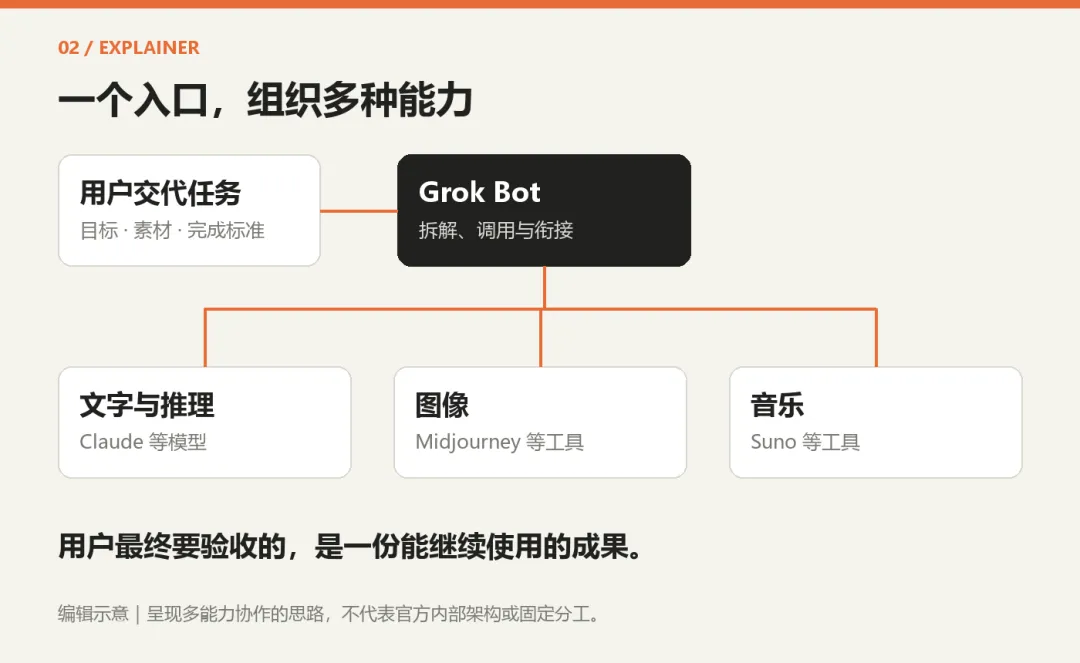
图 2|多能力协作的概念示意,不代表官方内部架构或固定路由规则。
这并不意味着,只要把几个模型接起来,整件事就会自动做好。前一步理解错了,后面的模型也可能沿着错误继续加工。
因此,我更关心的,是模型名单之外的那些细节。
02 /
10 月 7 日的新变化
已经落到文件和操作上
翻看 Grok Bot 的官方更新日志,同一天还有几项不那么热闹、却更接近日常工作的变化。[3]
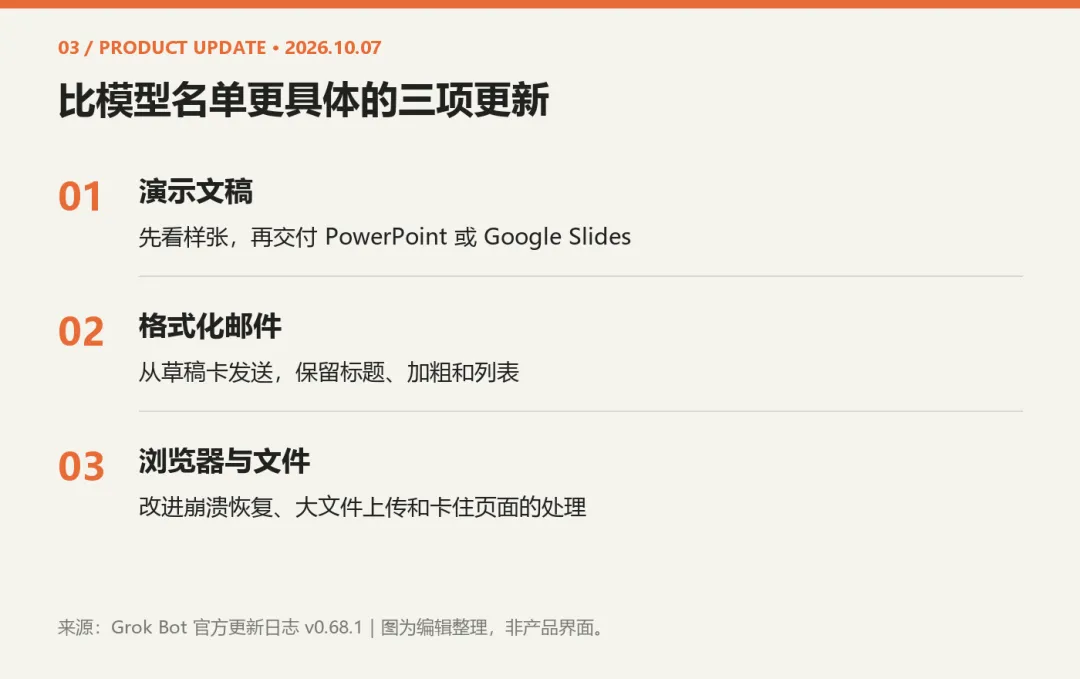
图 3|官方 v0.68.1 更新摘要。功能公告不等于独立实测结果。
例如,制作演示文稿时,可以先给用户看样张,再交付 PowerPoint 文件或 Google Slides;发送邮件时,可以保留标题、加粗和列表。官方还记录了浏览器崩溃恢复、大文件上传及页面卡住后的处理改进。[3]
这些变化的意义,放进工作场景里就容易理解了。
要做演示文稿,只有文字大纲还不够;要发邮件,内容和格式都得对;要处理网页,遇到卡顿之后还得知道怎么继续。
从“回答一个问题”到“完成一项工作”,中间隔着文件、软件和各种意外。
更强的模型能帮助理解和判断。稳定的操作、正确的文件、可恢复的流程,也同样影响交付。
03 /
拿公众号举例
写完,不等于做完
假设你交给 AI 一个任务:把最近一周的行业变化,做成一篇带图、可以发布的公众号文章。
几分钟后,它交来两千字正文和十个链接,看起来已经完成大半。
但你逐一核查后发现:几条消息来自同一次发布,某个测试功能被写成已经全面开放,还有一张图与正文根本不是同一个版本。
这时,“生成文章”已经结束,“准备发布”才刚刚开始。
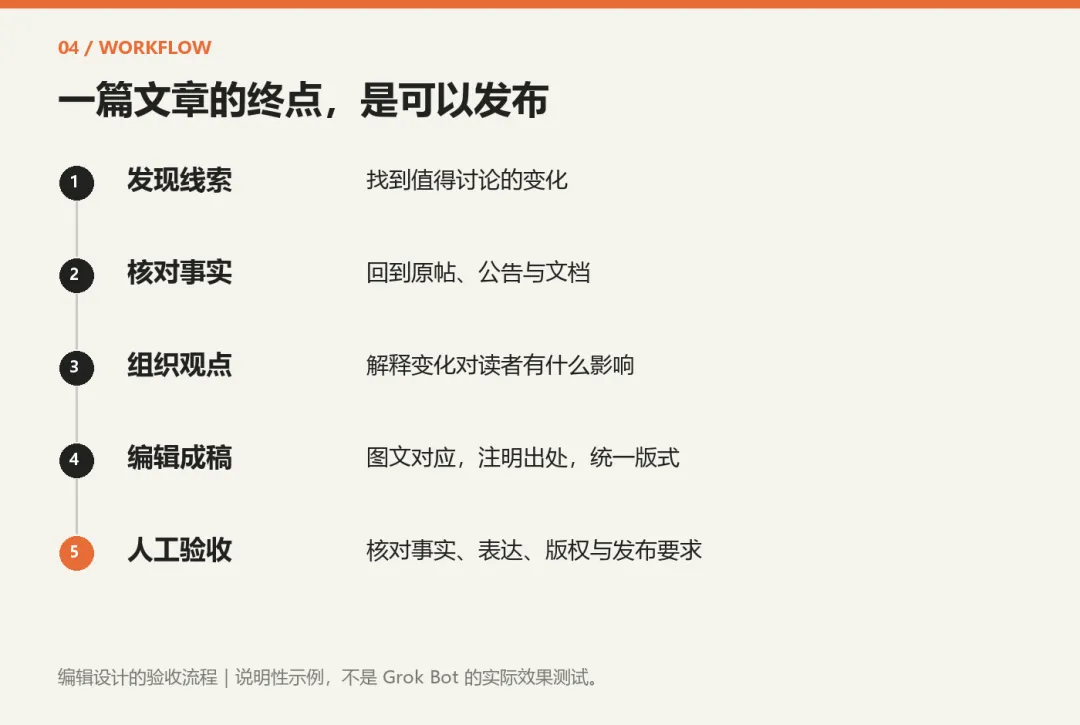
图 4|以公众号为例设计的交付流程。场景为说明性示例。
真正可用的交付,应该让读者看得明白,也让编辑核查得清楚:哪些是已确认的事实,哪些是判断,图片说明了什么,出处在哪里。
如果每个环节还得用户重新做一遍,生成速度再快,也只是把工作换了一个位置。
要看你接手后还剩多少工作。
04 /
选择权交给系统
结果和成本仍要看清
Grok Bot 的官方安全文档写明:模型选择由平台管理,没有面向用户的模型选择菜单;用量分析显示实际处理请求的模型,计费跟随所用模型。[4]
自动选择,可以让用户少研究几个型号。但它究竟划不划算,还得放进完整任务里判断。
复杂分析调用更强的模型,如果能减少核对和返工,可能值得;一个便宜的调用,如果交付后需要整份重做,实际成本未必低。
对个人和小团队来说,可以记一笔更完整的账:
+ 交代需求的时间
+ 核对、修改和重做的时间
这是一个实用的比较方法,不是行业统一公式。它提醒我们,把自己的时间也算进去。
还有一个容易忽略的边界:助手记住你的偏好,不代表它记住的信息永远有效。官方说明也提醒,重要判断应检查当前来源,不能只依赖记忆。[5]
写作风格可以沿用,产品版本和功能范围却需要重新核对。
05 /
以后选 AI 助手
可以少看一张榜单
我的建议是,拿一项你每周都要做的工作,重复试几次。比如做周报、整理客户反馈,或者准备一篇公众号文章。
先写清楚交付要求,再记录三个指标。
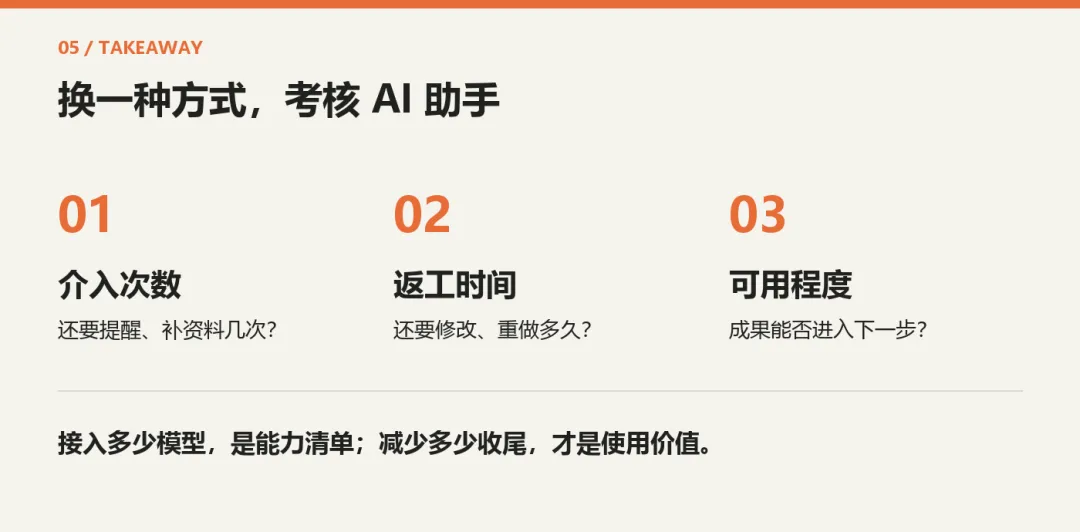
图 5|本文提出的使用评估方法,不属于官方性能测试。
一次惊艳的演示,能说明它有潜力。相似的任务连续交付,才更容易看出它是否稳定。
马斯克点名外部模型,让我们看到一种更开放的产品选择。接下来,值得观察的是,这种选择能否持续转化成用户少操心、少返工的结果。
在我看来,AI 助手之间的竞争,会越来越多地发生在这些细节里:要求改了能否接着做,步骤卡住能否继续,交来的文件能否直接进入下一道流程。
模型名字会不断更新。用户想要的完成标准,往往很朴素。
我能不能真正把它放下?
你最近一次用 AI 工作,是提前收工了,还是又替它改了半天?