ARTICLE · 1143282
人人都能开发自己所需要的软件
一个周末,22天,6.7MB。前苹果Vision Pro设计师用Claude手搓了一款Photoshop替代品。
这不是孤例。就在这几天,GitHub上有一群人正在用AI复刻整个Adobe全家桶。PhotoCraft、Compositor、ArtCraft——这些名字你可能没听过,但它们代表的事情很有意思:写软件这件事,正在从“专业技能”变成“表达能力”。
📌 发生了什么:几个数字先感受一下
一个叫 Compositor 的项目,作者是前苹果Vision Pro设计师Robbie Tilton。他受不了Adobe的订阅制,自己写了一个Mac上的图像编辑器。安装包6.7MB,MIT协议,GitHub上8500多颗星。他自己的机器上,Photoshop占了6455MB。
另一个项目叫 PhotoCraft,由ArtCraft团队开源,用Rust从头“净室实现”了Photoshop。8天冲到20778个Star,支持打开和编辑真实的PSD文件,图层、蒙版、调整图层、笔刷引擎一应俱全。
还有更夸张的。开发者Brandon Thomas用Claude Opus 5.5,一口气复刻了七款Adobe应用:Photoshop、Illustrator、Premiere、Lightroom、After Effects、InDesign、Acrobat Pro。整个套件叫ArtCraft,用Rust和WebAssembly写成,全部开源。
这些项目背后有一个共同的词:Vibe Coding。
🛠️ Vibe Coding:用“说话”来写软件
Vibe Coding的核心逻辑很简单:你用自然语言描述你想要什么,AI来写代码。
“帮我做一个粉丝签到系统”“增加一个巡演地图功能”“做一个留言互动社区”——这些是胡彦斌在开发粉丝社区APP“彦火”时对AI说的话。他一个月就做出来了。
Anthropic在2026年的趋势报告里写得很直白:“任何人都能成为开发者”的时代已经拉开帷幕,程序员的角色正在从“代码编写者”变成“智能体指挥官”。
但也不是没有边界。数据显示,开发者工作中60%会用AI,但能完全交给AI的任务不到20%。人类的判断力——决定做什么、什么重要、什么可以妥协——仍然不可替代。
💡 这对普通人意味着什么
过去你要做一个软件,路径大概是这样的:学编程语言→学框架→学数据库→学部署。每一步都是门槛。
现在的路径变成了:你知道自己想要什么→你能把它说清楚→AI帮你实现。
有一个细节很有意思。一位用Vibe Coding做产品的开发者说,AI生成的软件容易长得差不多,但创作者不同的知识积累、审美和品位,会体现在产品的细腻程度和色彩搭配中,让作品瞬间与众不同。
意思是:技术门槛降低之后,品味和判断力反而成了新的分水岭。
桐乡市档案馆的人已经在用这套方法了。工作人员借助AI自主开发档案工具,构建起“自主开发、经验固化、终端运行”的工作模式。他们管这个叫 “编程全民化”。
⚙️ 你需要的工具其实不多
如果你现在想试试,工具栈比想象中简单:
对话式编程:Claude Code、Cursor、GitHub Copilot
快速原型:v0、Lovable、Bolt——用自然语言生成UI,几分钟出界面
后端与部署:Supabase、Vercel——不用自己搭服务器
一个典型的Vibe Coding工作流是:先在对话工具里描述需求生成UI原型,再用AI写业务逻辑,最后一键部署。
Cursor发布的报告显示,到2026年5月,开发者每周人均编码量翻了一倍以上,单次PR新增代码量同比暴涨2.5倍。一个人能做的事情,正在以肉眼可见的速度膨胀。
🚀 回到那件事本身
PhotoCraft的作者在Reddit上发帖时,语气很平静。他说他们做的事情是 “净室实现” ——完全依据Adobe的公开文档和可观察行为来写代码,没有使用任何专有代码或素材,法律上是干净的独立项目。
这件事的意义不在于“有人做了Photoshop的免费替代品”。真正值得关注的是:一个人或一个小团队,借助AI工具,在几天到几周的时间里,做出了一款之前需要几十人团队、数月甚至数年才能完成的产品。
Adobe的订阅模式会不会被冲击,那是商业问题。但对每一个普通人来说,有一个信号越来越清晰:
如果你有一个“要是有一个软件能帮我做这件事就好了”的念头,现在可能是动手把它做出来的最好时机。
附:我的磁盘应用
此前,我在磁盘清理时开发的软件,已经成为,重复文件清理、文件整理集一身的综合软件。
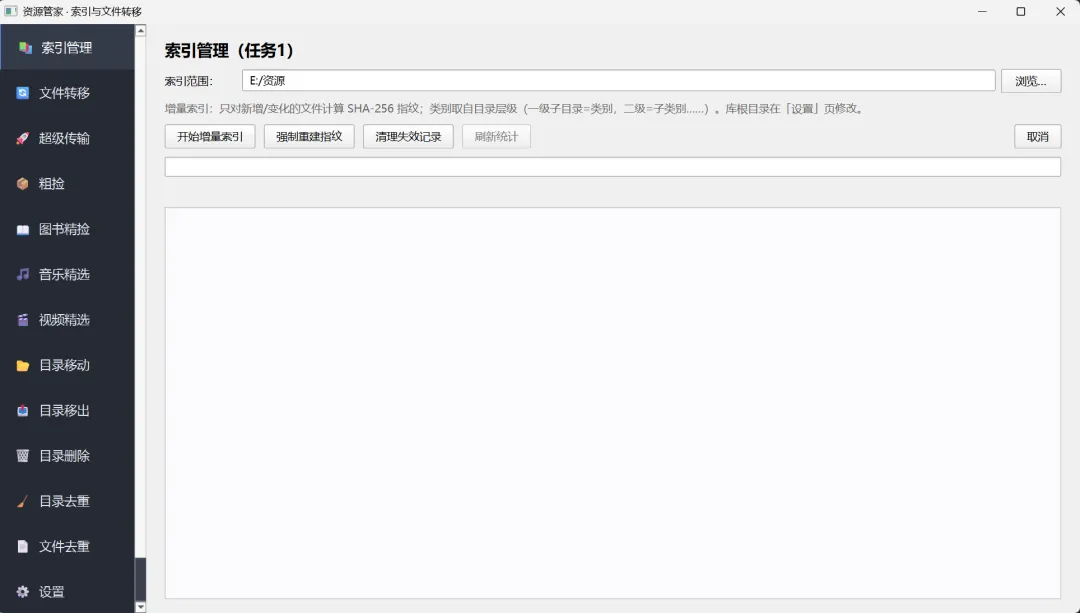
索引管理:对库内所有文件(库可大可小,大则整个磁盘、小则一个目录),计算身份信息--sha 256值,建立文件、位置、特征值(sha256)的数据库。 文件转移:从库外转移文件进库,同时计算身份信息,与数据库进行比对,重复文件不再入库,入库的文件加入索引管理。 粗捡:对库内文件初步分类,初步划分的类别有:book(电子书再按扩展名入 book/txt 等类型子目录)、music、picture、program、video、software、大模型、其他。 目录移动、目录删除、目录移出:库内目录级处理,主要与文件管理不同的是索引变更。 目录去重:列表显示库内重复目录,可选择去除重复的目录(早期,后期库内无重复目录) 文件去重:列表显示库内重复文件,可选择去除重复的文件(早期,后期库内无重复文件) 超级传输:库外目录传入库内,集索引管理、重复目录、文件去除,粗捡为一体。例如下载目录,有各种文件,转入库内,会去掉重复文件,分类传到适合的分类目录,整理好。 图书精捡:建立了图书元数据数据库。对图书类别内的目录、压缩文件、文件,根据书名,检索元数据数据库,取得大类、小类信息,将图书转入它的分类目录,如如《滚雪球》(巴菲特传记)归入“经济/金融”目录。 音乐精捡、视频精捡:建立音乐元数据数据库。对音乐、视频(音乐部分)类别内的目录、压缩文件、文件,根据书名,检索元数据数据库,取得大类、小类信息,将音频或视频转入它的分类目录,如《如愿》(王菲)归入“流行音乐/王菲”目录。 图书终检:对于图书里不能有效分类的,将书名提交给AI(云端),获得图书的元数据。因为初期,有较多的要终检的图书,现在薅GLM 5.3 flash在zcode空闲期免费的羊毛,只能在zcode运行。以后文件少,就正常用AI API,会有gui版本。